On Premise#
On Premise cho phép workspace Enterprise của bạn sử dụng dataset và tài nguyên tính toán trên máy tính Linux, macOS hoặc Windows. Ảnh và video nguồn vẫn nằm trên máy tính của bạn. Việc huấn luyện hoạt động như ở mọi vị trí huấn luyện từ xa: metric được truyền tới Platform và trọng số model sau khi huấn luyện hoàn tất sẽ được tải lên để tải xuống, dự đoán, xuất và triển khai.
Thiết lập chỉ cần một lệnh. Platform tự phát hiện hệ điều hành, điền các vị trí thư mục phù hợp, cài đặt Docker nếu cần và hiển thị tiến trình kết nối theo thời gian thực.
Cách hoạt động#
flowchart LR
    A[Your browser] <-->|Interface, labels, and progress| B[Ultralytics Platform]
    A <-->|Dataset previews| C[Your On Premise computer]
    B <-->|Jobs, metrics, and model weights| C
    C --- D[(Dataset folder)]
    C --- E[(Models folder)]
Ranh giới dữ liệu#
| Dữ liệu | Máy tính On Premise của bạn | Platform và các dịch vụ đám mây |
|---|---|---|
| Pixel của dataset nguồn và dataset phái sinh | Dữ liệu luôn ở máy cục bộ trong quá trình nhập, xem trước và huấn luyện | Không bao giờ được lưu trữ, ghi log hoặc xử lý |
| Lớp, nhãn và chú thích | Nhãn nguồn được đọc trong quá trình nhập | Được lưu làm metadata chuẩn tắc của dataset để bạn có thể gán nhãn trong Platform |
| Huấn luyện model | Lần chạy, checkpoint tốt nhất và các artifact huấn luyện khác được ghi vào thư mục model của bạn | Checkpoint tốt nhất được tải lên để tải xuống, dự đoán, xuất và triển khai; các artifact khác vẫn ở trên máy tính của bạn |
Trọng số model, nhãn, chú thích và metric có thể mã hóa thông tin được học từ ảnh của bạn. Chỉ pixel của dataset mới được bảo đảm nghiêm ngặt là chỉ lưu cục bộ. Dự đoán trên đám mây chỉ xử lý những ảnh bạn gửi riêng cho quy trình làm việc trên đám mây đó; worker không bao giờ chuyển tiếp ảnh từ dataset đã gắn kết của bạn.
Trước khi bắt đầu#
Chọn máy tính có thể truy cập dataset và duy trì hoạt động trong khi Platform sử dụng chúng:
| Tối thiểu | Đề xuất | |
|---|---|---|
| Hệ điều hành | Linux 64-bit, macOS chạy Apple silicon hoặc Windows x86-64 có WSL 2 | Các phiên bản hệ điều hành và Docker hiện tại |
| CPU | 4 lõi | Từ 8 lõi trở lên để huấn luyện trên CPU |
| Bộ nhớ | RAM 8 GB | Từ 16 GB trở lên |
| Lưu trữ | Còn trống 20 GB, cộng thêm dung lượng cho dataset và model của bạn | SSD còn trống ít nhất gấp đôi kích thước dataset đang làm việc |
| Mạng | HTTPS outbound tới Ultralytics Platform và registry container Docker | Kết nối băng thông rộng ổn định để tải image container ban đầu |
GPU không bắt buộc. Mọi máy tính đều có thể nhập dataset và huấn luyện model bằng CPU. GPU NVIDIA tương thích có thể tăng tốc các tác vụ huấn luyện lớn hơn.
Nếu công ty hạn chế lưu lượng outbound, hãy cho phép truy cập HTTPS tới Ultralytics Platform, registry Docker và các nguồn tải gói Python trước khi thiết lập. Worker luôn chủ động kết nối tới Platform, vì vậy không cần cho phép truy cập inbound vào mạng của bạn.
Kết nối máy tính của bạn#
- Mở Ultralytics Platform trên máy tính có thể truy cập dataset của bạn.
- Đi tới
Settings > Integrationsvà chọn On Premise trong danh sách tích hợp. - Kiểm tra đường dẫn được điền sẵn cho Thư mục dataset trên máy này và Thư mục model trên máy này.
- Chọn Tạo lệnh cài đặt.
- Mở terminal được nêu trong hộp thoại, sao chép lệnh, dán vào rồi nhấn Enter.
- Giữ trang Integrations mở cho đến khi chỉ báo tiến trình hiển thị Đã kết nối.
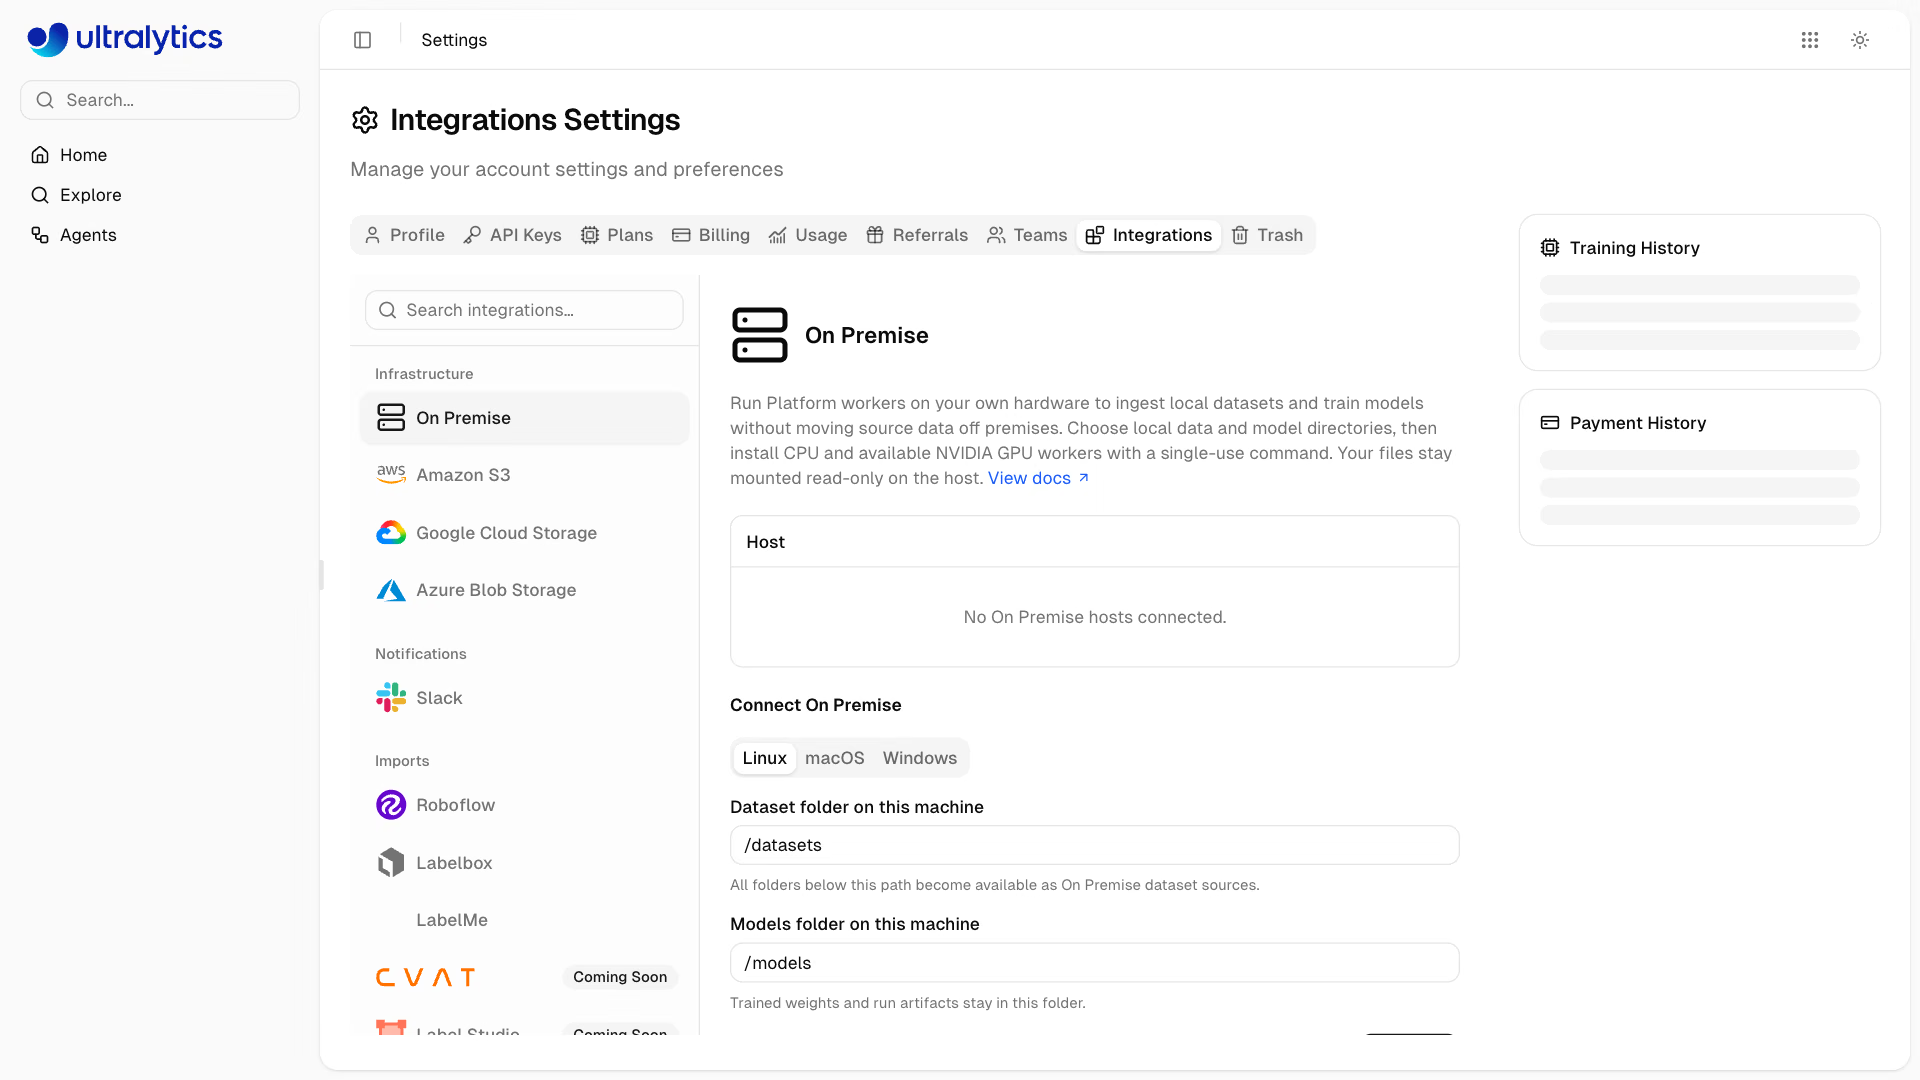
Trang này theo dõi trực tiếp sáu bước thiết lập — chạy lệnh, tải xuống tệp worker, tải xuống image Docker, biên dịch worker, khởi chạy worker và xác nhận kết nối — để bạn theo dõi tiến trình mà không cần đọc terminal. Để kết nối một máy, cần có vai trò editor của workspace và gói Enterprise đang hoạt động; workspace dùng gói khác sẽ thấy nút Yêu cầu bản demo, nút này gửi yêu cầu demo Enterprise thay vì tạo lệnh cài đặt.
Platform điền thư mục và token kết nối dùng một lần trước khi bạn sao chép lệnh. Lệnh được tạo theo định dạng bên dưới:
Mở Terminal và dán:
curl -fsSL 'https://platform.ultralytics.com/api/workers/install?os=linux' \
  | sudo sh -s -- \
    "/datasets" \
    "/models" \
"YOUR_CONNECTION_TOKEN"Platform tự động thêm token kết nối. Token xác nhận máy tính này được phép kết nối với workspace của bạn, hết hạn sau 10 phút và chỉ dùng được một lần. Bạn không cần nhập token riêng. Không chia sẻ lệnh được tạo khi lệnh còn hiệu lực.
Các giá trị mặc định hoạt động mà không cần chỉnh sửa:
| Linux | macOS và Windows | |
|---|---|---|
| Thư mục dataset | /datasets | ~/Ultralytics/datasets |
| Thư mục model | /models | ~/Ultralytics/models |
Lệnh thiết lập tạo các thư mục này, cài đặt và khởi chạy Docker khi cần, đồng thời cấu hình kết nối để tự khởi động lại cùng máy tính. Hệ điều hành có thể yêu cầu bạn phê duyệt cài đặt hoặc khởi động lại trước khi hoàn tất thiết lập.
Image cơ sở Docker#
Trình cài đặt chạy một container và chọn image cơ sở chính thức của Ultralytics phù hợp với máy chủ:
| Máy chủ | Mẫu image cơ sở |
|---|---|
| Apple silicon hoặc Linux ARM64 | ultralytics/ultralytics:latest-arm64 |
| CPU x86-64 | ultralytics/ultralytics:latest-cpu |
| x86-64 có GPU NVIDIA được hỗ trợ | ultralytics/ultralytics:latest |
Quá trình biên dịch worker bổ sung các dependency kết nối và cập nhật gói Ultralytics trong image lên phiên bản mới nhất. Worker phát hiện CUDA trong quá trình thiết lập, vì vậy máy chủ NVIDIA vẫn chỉ chạy một container thay vì các worker CPU và GPU riêng biệt. Các dịch vụ đám mây của Platform xử lý dự đoán và xuất model sau khi checkpoint tốt nhất được tải lên.
Thiết lập CPU không cần gì ngoài quy trình cài đặt có hướng dẫn. Trên Linux, để tăng tốc bằng GPU NVIDIA cần Docker >= 28.2 và NVIDIA Container Toolkit >= 1.18. Platform tự động phát hiện đường dẫn GPU được hỗ trợ trên Linux và Windows, trong khi máy chủ macOS huấn luyện bằng CPU; xem Hướng dẫn bắt đầu nhanh Docker để biết chi tiết thiết lập.
Thêm dataset#
- Đặt dataset vào thư mục dataset đã cấu hình.
- Trong Platform, chọn Dataset mới > On Premise.
- Chọn máy tính đã kết nối.
- Duyệt đến thư mục dataset, chọn tác vụ rồi chọn Tạo.
Platform lập chỉ mục dataset cục bộ và mở dataset trong cùng thư viện được dùng cho dataset đã tải lên và dataset lưu trữ trên đám mây. Bạn có thể xem trước ảnh, kiểm tra nhãn, lọc dataset và gán nhãn mà không cần tải pixel lên.
Dữ liệu được hỗ trợ#
On Premise hỗ trợ các định dạng nhập dữ liệu và tác vụ thị giác máy tính giống như dữ liệu đã tải lên:
- Ảnh và video
- Kho lưu trữ ZIP, TAR, TAR.GZ và TGZ
- NDJSON của Ultralytics và Labelbox, COCO JSON và JSON của LabelMe
- Dataset YOLO và thư mục phân loại
- Các tác vụ phát hiện, phân đoạn, ngữ nghĩa, phân loại, tư thế và hộp giới hạn xoay (OBB)
Platform tự động nhận diện bố cục dataset phổ biến, lớp, nhãn và các phân vùng train/validation/test. Thư mục dataset được gắn kết ở chế độ chỉ đọc, vì vậy Platform không bao giờ thay đổi kích thước, mã hóa lại, chỉnh sửa hoặc xóa tệp nguồn của bạn. Mọi nội dung được tạo ra trong quá trình nhập — kho lưu trữ đã giải nén, tài nguyên NDJSON đã tải xuống và khung hình video — đều được ghi vào volume Docker riêng tư trên cùng máy tính.
Xem trước và gán nhãn#
Khi mở một ảnh, trình duyệt sẽ tải ảnh trực tiếp từ máy tính đã kết nối. Không cần chứng chỉ, hostname, VPN hay cấu hình xem trước.
Chú thích và cách tổ chức dataset được lưu trong workspace Platform của bạn, nhưng các chỉnh sửa trong Platform không bao giờ làm thay đổi ảnh hoặc tệp nhãn nguồn.
Huấn luyện model#
Bắt đầu huấn luyện thông qua hộp thoại huấn luyện thông thường của Platform:
- Mở một project và chọn Model mới.
- Chọn dataset On Premise.
- Chọn model và các thiết lập huấn luyện.
- Bắt đầu huấn luyện.
Platform chạy tác vụ trên máy tính đã kết nối. Tác vụ sử dụng GPU NVIDIA khả dụng hoặc tự động chuyển sang CPU, vì vậy máy Mac có thể huấn luyện một model nhỏ như YOLO26n trên COCO8 mà không cần phần cứng GPU chuyên dụng.
Các tệp huấn luyện được ghi vào thư mục model đã cấu hình trong khi lần chạy đang hoạt động. Gói Ultralytics sử dụng cùng các callback huấn luyện từ xa như trên mọi máy do khách hàng quản lý: tiến trình và metric được truyền tới Platform, checkpoint tốt nhất được tải lên bộ nhớ Platform, và model sau khi hoàn tất có thể sử dụng các quy trình tải xuống, dự đoán, xuất và triển khai hiện có. Các artifact huấn luyện khác vẫn nằm trong thư mục model của bạn. Huấn luyện On Premise không sử dụng credit tính toán của Platform, và Platform không bao giờ gửi tác vụ huấn luyện tới tài nguyên tính toán trên đám mây.
Quản lý kết nối#
Mở Settings > Integrations để xem từng máy tính, hostname và phần cứng, trạng thái trực tuyến của CPU và GPU, cũng như thời điểm máy báo cáo lần gần nhất. Máy tính đã tắt hoặc mất kết nối sẽ hiển thị là Offline cùng thông tin lần cuối được nhìn thấy; dataset trên máy sẽ tạm thời không khả dụng thay vì chuyển sang dùng cloud compute. Worker khởi chạy cùng Docker và tự kết nối lại khi máy tính trực tuyến trở lại; bạn không cần chạy lại lệnh.
Worker tự cập nhật. Mỗi lần container khởi chạy và cứ 10 phút khi ở trạng thái nhàn rỗi, worker tải xuống mọi phiên bản code mới hơn từ Platform rồi khởi động lại để sử dụng phiên bản đó. Worker không khởi động lại khi đang chạy job. Máy tính được kết nối trước khi có tính năng tự cập nhật sẽ bắt đầu cập nhật sau khi bạn chạy một lệnh cài đặt mới trên máy đó một lần.
Chạy lại lệnh cài đặt trên máy tính đã kết nối để thay đổi các thư mục hoặc làm mới Docker image. Máy tính vẫn giữ nguyên host, vì vậy các dataset trên máy tiếp tục hoạt động và không xuất hiện host trùng lặp.
Mỗi máy tính chỉ dùng một workspace. Một máy tính chạy một worker. Chạy lệnh cài đặt từ workspace khác sẽ chuyển máy tính sang workspace đó và ngắt kết nối host khỏi workspace cũ.
Kết nối lại sẽ tạo lệnh cài đặt mới cho host bị ngắt kết nối. Chạy lệnh trên máy tính sẽ phục vụ host đó; các dataset hiện có sẽ hoạt động trở lại mà không cần nhập lại. Host bị ngắt kết nối chỉ còn trong danh sách khi vẫn có dataset hoặc model phụ thuộc vào host đó.
Ngắt kết nối sẽ thu hồi quyền truy cập của host đó ngay lập tức. Các job đang xếp hàng, khởi chạy hoặc chạy và được gắn với host sẽ bị hủy, bao gồm cả quá trình training đang diễn ra; dataset vẫn đang được nhập sẽ thất bại với On Premise host disconnected during ingest. Các dataset đã nhập xong vẫn giữ nguyên class, label và annotation nhưng không thể xem trước hoặc dùng để training cho đến khi bạn kết nối lại. Không có gì bị xóa khỏi máy tính, và các model đã tải lên Platform vẫn khả dụng.
Các giới hạn hiện tại#
- Không quét lại. Dataset được lập chỉ mục một lần khi bạn tạo. Nếu các file nguồn thay đổi sau đó, Platform sẽ không phát hiện; hãy tạo dataset mới để cập nhật các thay đổi.
- Các tính năng cần bản sao trên Platform không khả dụng. Dataset On Premise không hỗ trợ các tính năng cần bản sao hình ảnh do Platform quản lý: tự động gán nhãn, phân tích phân cụm, sao chép dataset và snapshot phiên bản bất biến.
- Training không được chuyển sang nơi khác. Nếu tiến trình worker dừng giữa chừng, lượt chạy sẽ thất bại thay vì khởi động lại ở nơi khác.
- Các file model vẫn nằm trên host. Xóa hoặc chuyển model vào thùng rác trong Platform chỉ xóa model khỏi Platform, không xóa model khỏi thư mục models của bạn — hãy tự dọn thư mục đó khi không còn cần lượt chạy.
Xóa dataset On Premise hoặc từng hình ảnh trong dataset chỉ xóa các tham chiếu và annotation của Platform. File của bạn không bao giờ bị tác động.
Nếu quá trình thiết lập không hoàn tất#
- Docker yêu cầu cấp quyền: Chấp thuận lời nhắc và chờ Docker khởi chạy. Quá trình thiết lập sẽ tự động tiếp tục.
- Windows yêu cầu khởi động lại: Khởi động lại máy tính, quay lại
Settings > Integrationsvà tạo lệnh cài đặt mới. - Lệnh thiết lập đã hết hạn: Tạo lệnh cài đặt mới. Mỗi lệnh chỉ có hiệu lực tạm thời và chỉ dùng được một lần.
- Một máy khác đã kết nối lại host này: Máy tính khác đã chạy lệnh Reconnect cho cùng host trước. Hãy tạo lệnh cài đặt mới cho máy tính này.
- Kết nối vẫn ngoại tuyến: Mở Docker Desktop, chạy lại lệnh vừa tạo và giữ terminal mở cho đến khi có thông báo On Premise đang chạy.
- Không tải được bản xem trước: Mở Platform bằng trình duyệt trên máy tính đã kết nối. Bản xem trước dataset được tải trực tiếp từ máy tính đó.
- Bạn cần log của worker: Trình cài đặt ghi log vào
/opt/ultralytics-workertrên Linux và~/.ultralytics/workertrên macOS và Windows. Chạydocker compose logs -ftừ thư mục đó để theo dõi worker.
Xem thêm Datasets, Gán nhãn và Training.
Câu hỏi thường gặp#
Pixel của dataset không bao giờ rời khỏi máy tính. Pixel được đọc cục bộ để nhập dữ liệu, xem trước và training. Class, label, annotation, metric training và checkpoint tốt nhất được lưu trong Platform để bạn có thể gán nhãn, tải xuống, chạy dự đoán, export và deploy. Xem Ranh giới dữ liệu.
Không. Mọi host đều có thể nhập dataset và training bằng CPU; GPU NVIDIA tương thích trên Linux hoặc Windows sẽ tự động tăng tốc các job lớn hơn. Training On Premise không sử dụng credit compute của Platform.
Dataset trên host sẽ tạm thời không khả dụng và các job đang chạy sẽ thất bại thay vì chuyển sang cloud compute. Dataset đã nhập xong vẫn giữ nguyên class, label và annotation, và hoạt động trở lại khi host kết nối lại.
Dataset được lập chỉ mục một lần khi tạo và không được quét lại. Tạo dataset mới từ thư mục đã cập nhật để áp dụng các thay đổi.
Trình cài đặt ghi log vào
/opt/ultralytics-workertrên Linux và~/.ultralytics/workertrên macOS và Windows. Chạydocker compose logs -ftừ thư mục đó.