知识蒸馏
快速入门#
添加 distill_model 参数,让较大的教师模型指导较小的学生模型进行训练:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")什么是知识蒸馏?#
知识蒸馏将大型、高精度的教师模型中的知识迁移到较小的学生模型中。学生模型会学习模仿教师模型的内部特征表示,通常能比从头训练获得更高的准确率。
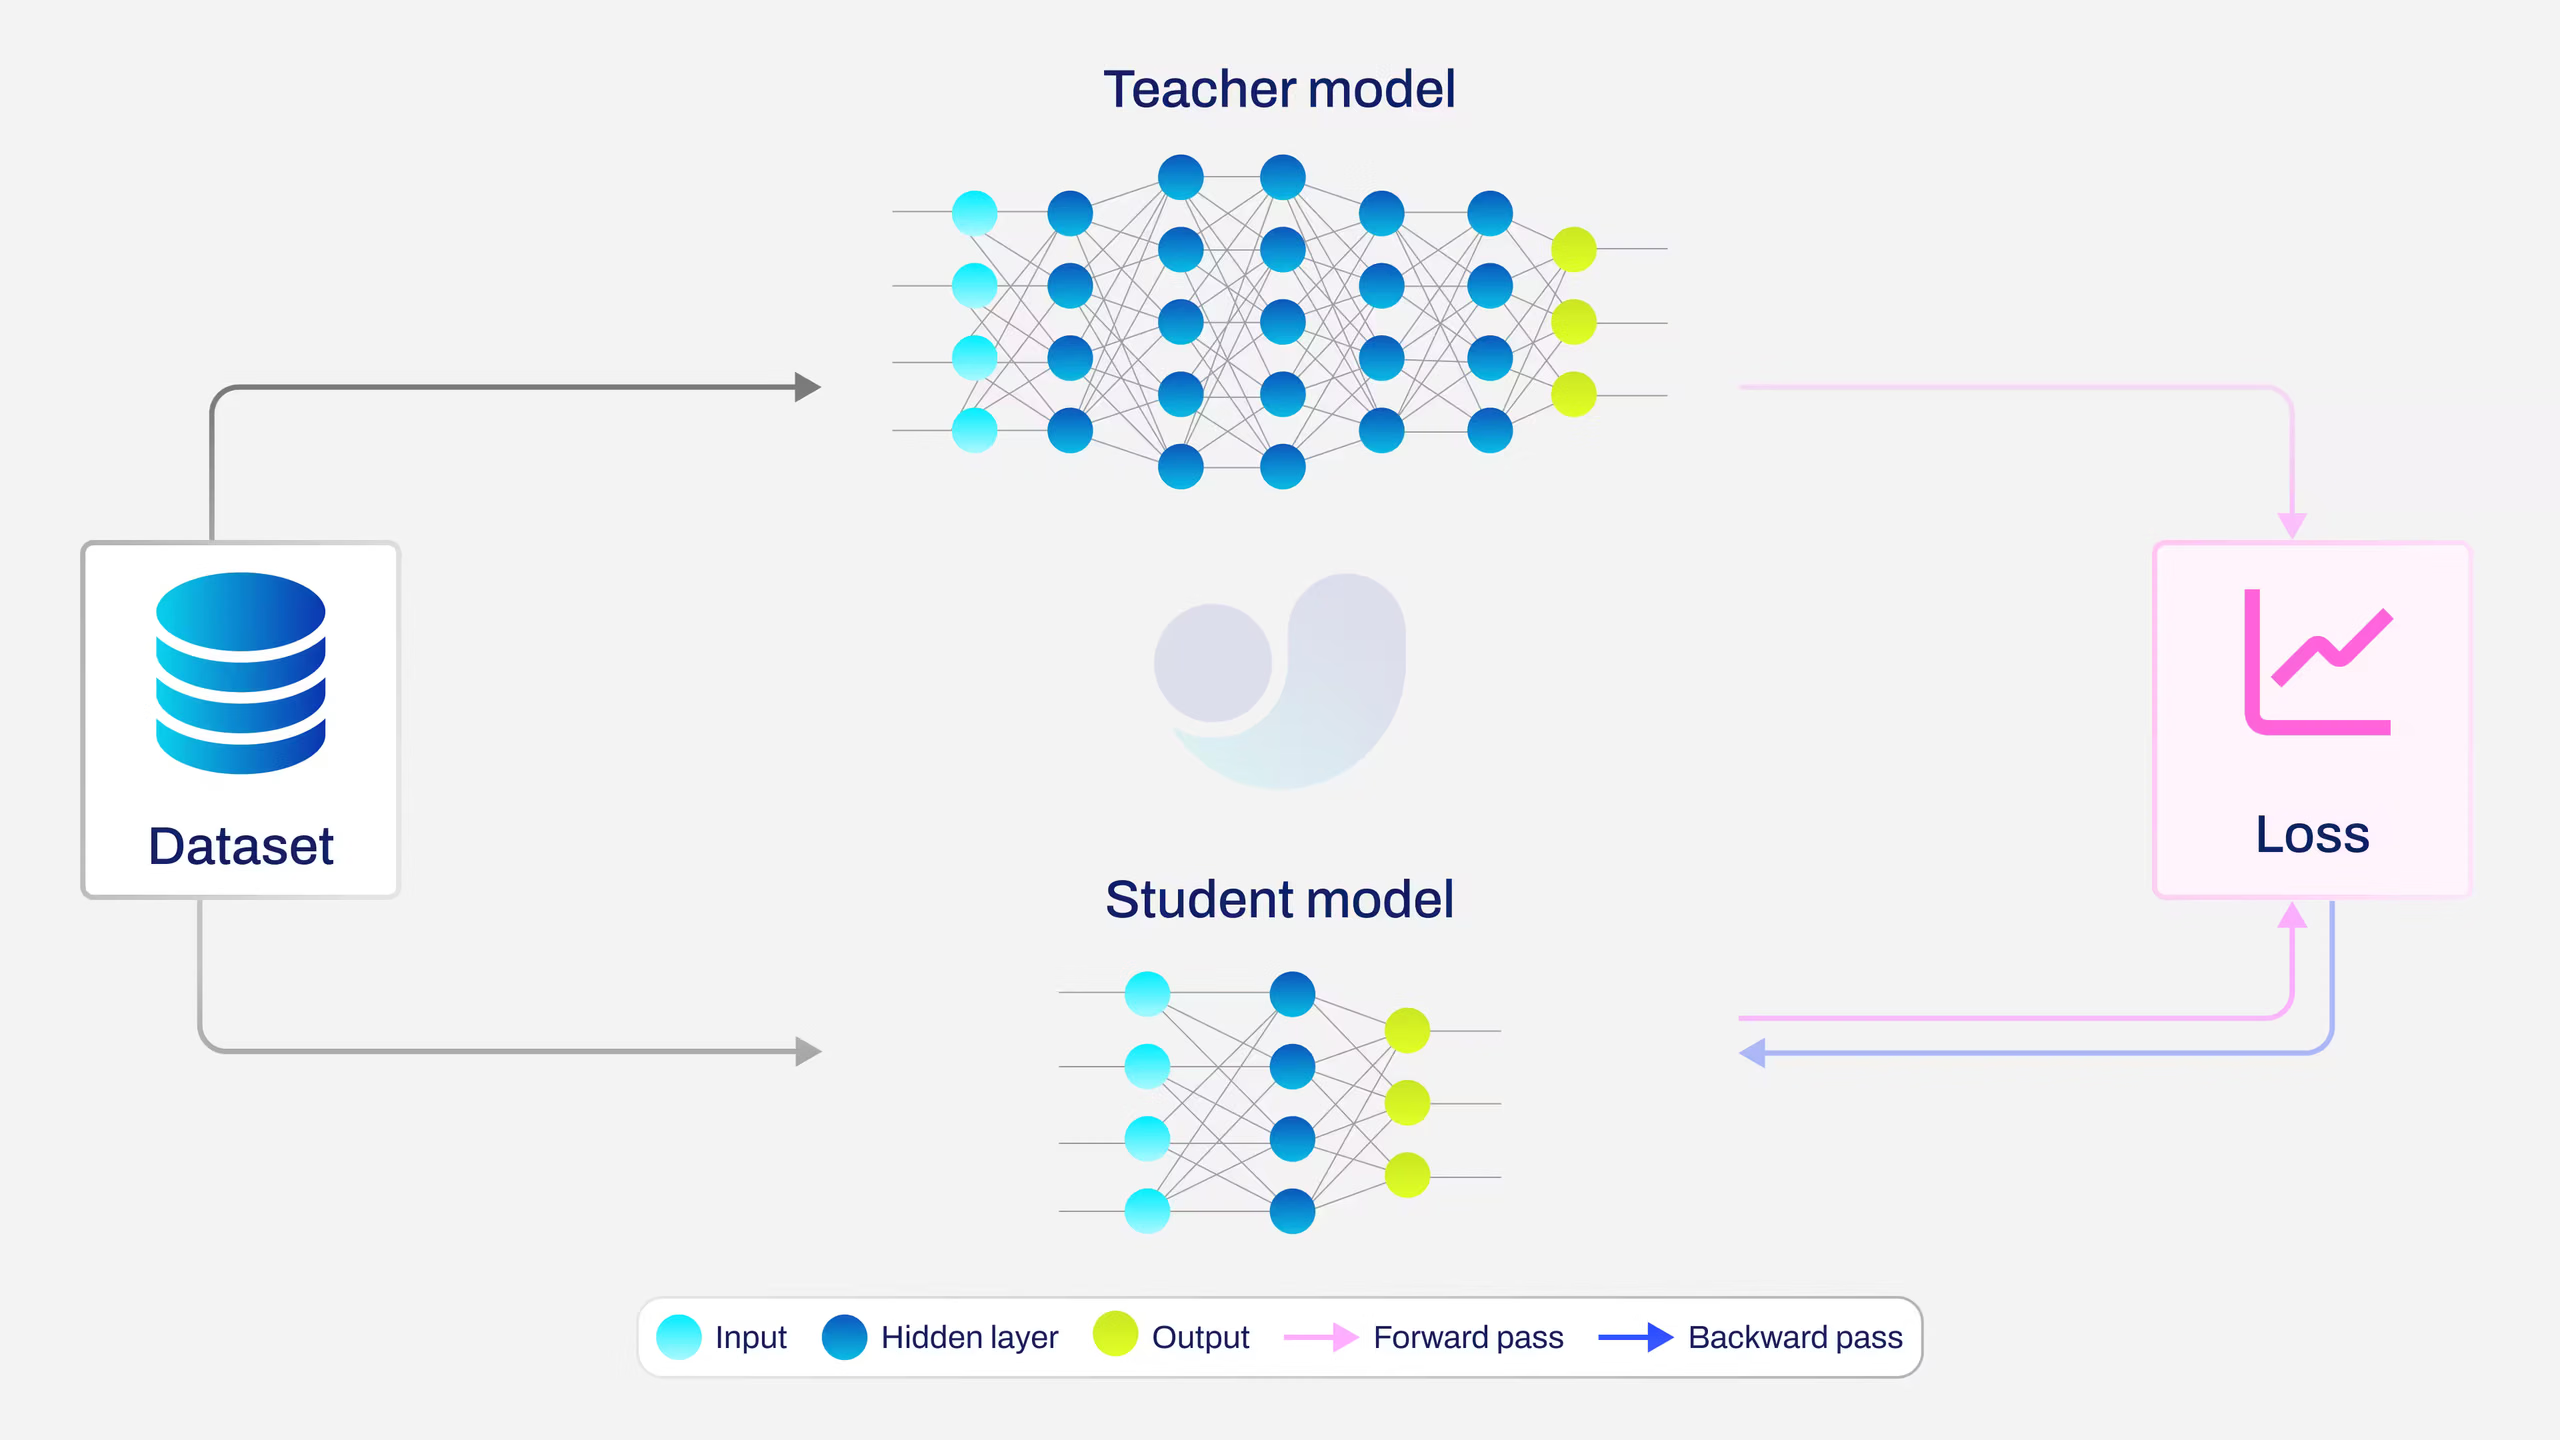
适合使用蒸馏的情况:
- 你需要一个更小、更快、便于部署的模型
- 你有一个使用相同数据训练的高精度教师模型
- 你希望获得比标准训练更高的准确率
知识蒸馏已支持 detect、segment、pose 和 obb 任务。目前只有 detect 任务经过实验验证,确认准确率有所提升。
性能#
在 COCO 数据集上,知识蒸馏可提升整个 YOLO26 系列的学生模型 mAP,且不会增加推理开销。下表将标准 YOLO26 模型(基线)与使用其推荐教师模型进行蒸馏训练的同款模型进行了比较。
| 模型 | 尺寸 (像素) | mAP验证50-95 基线 | mAP验证50-95 蒸馏版 | mAP验证50-95 (e2e) 基线 | mAP验证50-95 (e2e) 蒸馏版 |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- mAP验证 数值基于 COCO val2017 数据集上的单模型、单尺度评估。
使用yolo val detect model=yolo26n-distill.pt data=coco.yaml device=0复现蒸馏结果行;在 e2e 列中添加nms=False。 - e2e 数值使用无 NMS 推理路径(
nms=False);非 e2e 数值使用默认的 NMS 后处理(nms=None)。详情请参阅端到端检测。
前置条件#
开始之前,请确认你满足以下要求:
- 已训练的教师模型:来自与学生模型相同 YOLO 系列的
.pt检查点。 - 任务匹配:教师模型和学生模型应执行相同任务,并且教师模型应使用相关数据进行训练。
- GPU 资源:内存需足以容纳两个模型;教师模型仅执行前向计算,不使用梯度或优化器状态。
推荐的模型配对#
| 学生模型 | 推荐的教师模型 |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
不支持跨系列蒸馏(例如,使用 YOLO11 教师模型搭配 YOLO26 学生模型)。
关键参数#
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
distill_model | str | None | 教师模型文件的路径(例如,yolo26x.pt)。设置此参数即可启用知识蒸馏。 |
dis | float | 6.0 | 蒸馏损失权重。此参数控制蒸馏损失在总训练损失中的占比。 |
工作原理#
- 教师模型在
eval模式下保持冻结,并对每个批次执行推理 - 学生模型使用标准任务损失和蒸馏指导进行训练
- 从向 Detect 系列检测头提供输入的三个颈部层中提取两个模型的特征
- 一个由两个 1×1 卷积和 ReLU 组成的投影器,会将每个学生特征图的通道调整为与教师模型一致
- 分数加权 L2 损失会比较投影后的学生特征与教师特征,并根据教师模型的分类置信度加权
- 蒸馏损失使用
dis权重与标准损失相结合
任务支持#
蒸馏实现会从向模型 Detect 系列检测头提供输入的三个颈部层中提取特征。由于 segment、pose 和 obb 检测头继承自相同的 Detect 架构,因此蒸馏在技术上也兼容这些任务。
分类、语义分割、深度估计和 RT-DETR 不使用兼容的 Detect 系列检测头,因此不受支持。
目前只有 detect 任务经过实验基准测试和验证。你可以对 segment、pose 或 obb 任务运行蒸馏,但这些任务的准确率提升尚未得到验证。
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")训练#
基础训练#
蒸馏训练与标准训练完全相同。提供 distill_model 路径即可启用蒸馏:
from ultralytics import YOLO

# 加载学生模型
student = YOLO("yolo26m.pt")

# 使用较大的教师模型进行知识蒸馏训练
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")调整蒸馏损失权重#
dis 参数(默认值:6.0)用于控制蒸馏损失的占比:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)恢复蒸馏训练#
蒸馏训练支持从检查点恢复。系统会根据检查点中记录的 distill_model 路径自动重新构建教师模型:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)训练输出#
启用蒸馏后,训练日志中会额外显示 dis_loss 列:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
1/80 46.2G 1.566 5.404 0.003249 6.658 231 640导出的模型只包含学生模型权重——文件大小和推理速度与正常训练的学生模型一致。
常见问题#
- 确认教师模型和学生模型来自同一代 YOLO
- 确认
distill_model路径正确且文件可以加载 - 如果损失值很小,尝试增大
dis - 确保教师模型使用相同的数据集训练
添加
distill_model参数即可,其他操作完全相同。训练期间会计算额外的蒸馏损失,但保存的模型仍是标准 YOLO 模型,不会增加额外开销。会。教师模型会为每个批次额外执行一次前向计算,因此时间和内存开销取决于教师模型与学生模型的组合。教师模型在
eval模式下运行,不使用梯度或优化器状态。知识蒸馏支持 detect、segment、pose 和 obb 任务,因为它会蒸馏向 Detect 系列检测头提供输入的三个颈部层中的特征。不支持 classify、semantic、depth 和 RT-DETR。
目前只有 detect 经过实验验证,确认能提升准确率。segment、pose 和 obb 在技术上兼容,但尚未进行基准测试。
教师模型和学生模型必须属于同一个 YOLO 系列(例如 YOLOv8、YOLO11 或 YOLO26)。不支持跨系列蒸馏(例如使用 YOLO11 教师模型和 YOLO26 学生模型)。


评论5
提出问题、分享结果,或帮助其他人。
CharbelMsallem
Cool! If same dataset, can the class mapping or the number of classes differ from parent to student but using the same images and split?
I mean classes of student be a subset of parent classes
 Glenn JocherUltralytics
Same images/splits can be reused, but for the supported distillation path the teacher and student should use the same task and
data.yamlclass configuration (nc,names, and class indices), per the Knowledge Distillation guide. If the student should learn only a subset, create a subset dataset/YAML with labels remapped to contiguous IDs and train or fine-tune a teacher on that same subset/mapping before using it asdistill_model.okat thanks!
andyrey
Very interesting and useful, thank you!