使用 Kaggle 训练 YOLO26 模型指南
如果你正在学习 AI 并开展小型项目,可能暂时无法使用强大的计算资源,而高端硬件又价格不菲。Kaggle 是 Google 旗下的平台,它提供免费的云端环境,让你能够使用 GPU 资源、处理大型数据集,并与多元化的数据科学家和机器学习爱好者社区协作。
Kaggle 是用于训练和试验 Ultralytics YOLO26 模型的实用选择。Kaggle Notebooks 预装了常用的机器学习库和框架。本指南将介绍 Kaggle 的主要功能,并展示如何在该平台上训练 YOLO26 模型。
什么是 Kaggle?#
Kaggle 是一个平台,汇聚了来自世界各地的数据科学家,让他们能够协作、学习,并通过竞赛解决现实世界的数据科学问题。Kaggle 于 2010 年由 Anthony Goldbloom 和 Jeremy Howard 创立,并于 2017 年被 Google 收购。用户可以借助 Kaggle 进行交流、发现和分享数据集、使用 GPU 驱动的笔记本,以及参加数据科学竞赛。该平台服务于经验丰富的专业人士和学习者。
截至 2022 年,Kaggle 拥有超过 1000 万用户,为开发和试验机器学习模型提供了丰富的环境。你无需担心本地计算机的配置或设置,只需要一个 Kaggle 账户和 Web 浏览器。
安装#
在 Kaggle 上开始训练 YOLO26 模型之前,你需要确保笔记本环境已正确配置。请按照以下步骤操作:
启用互联网访问#
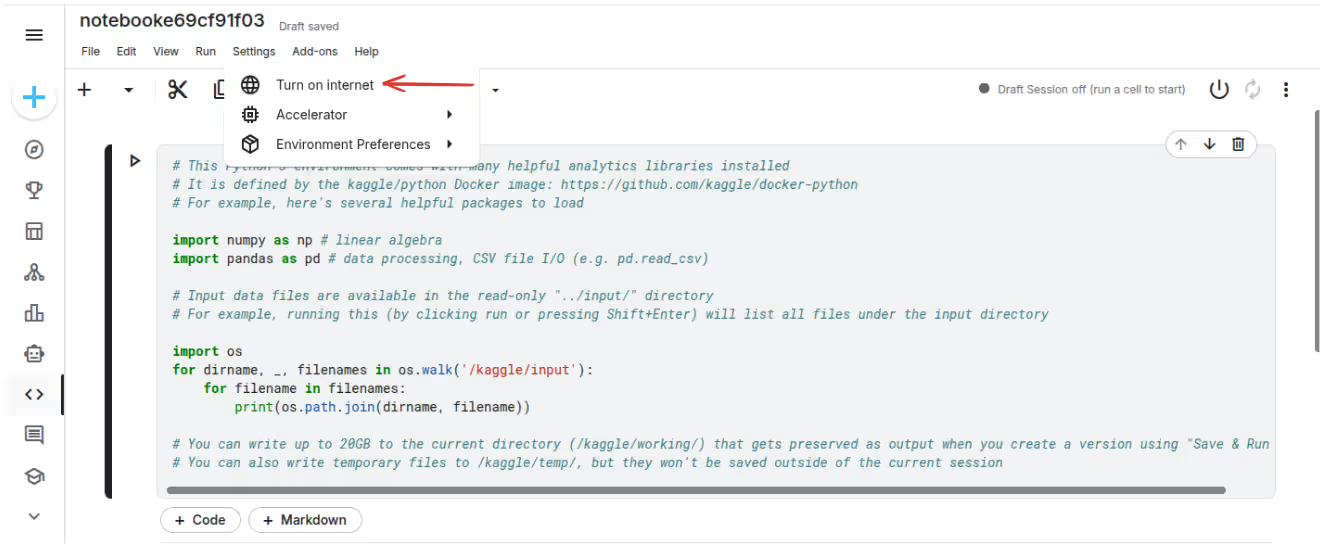
Kaggle 笔记本需要访问互联网才能下载软件包和依赖项。若要在 Kaggle 笔记本中启用互联网:
- 打开你的 Kaggle 笔记本
- 点击笔记本界面右侧的 Settings 面板
- 向下滚动到 Internet 部分
- 将开关切换为 ON,以启用互联网连接
注意:安装 Ultralytics 包以及下载预训练模型或数据集都需要互联网连接。如果未启用互联网,包安装将失败。
安装 Ultralytics#
启用互联网访问后,在笔记本单元格中运行以下命令来安装 Ultralytics 软件包:
!pip install ultralytics如需安装最新开发版本,你可以直接从 GitHub 安装:
!pip install git+https://github.com/ultralytics/ultralytics.git解决依赖项冲突#
安装过程中,你可能会遇到依赖项冲突,尤其是涉及 opencv-python、numpy 或 torch 等软件包时。以下是一些常见解决方法:
方法 1:使用 --upgrade 强制重新安装#
如果你遇到现有软件包冲突,可以强制升级:
!pip install --upgrade --force-reinstall ultralytics方法 2:安装后重启内核#
有时,你需要在安装后重启内核,以解决导入问题:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu常见错误的解决方法#
错误:“No module named 'ultralytics'”
- 解决方法:确保已启用互联网,然后再次运行安装命令
- 安装后重启内核
错误:“ERROR: pip's dependency resolver does not currently take into account...”
- 解决方法:这通常只是警告,可以安全忽略。即使出现此消息,安装通常也会成功
错误:安装后出现“ModuleNotFoundError”
- 解决方法:使用笔记本界面中的重启按钮重启内核
- 在新单元格中重新运行导入语句
验证安装#
安装后,运行以下命令验证 Ultralytics 是否已正确安装:
import ultralytics

ultralytics.checks()
此命令会显示系统信息,并验证所有依赖项是否已正确安装。
使用 Kaggle 训练 YOLO26#
借助 Kaggle 免费提供的 GPU,你可以轻松训练 YOLO26 模型。
首先,打开 Kaggle 上的 Ultralytics YOLO26 教程笔记本。Kaggle 环境预装了 TensorFlow 和 PyTorch 等库,从而简化了环境设置。
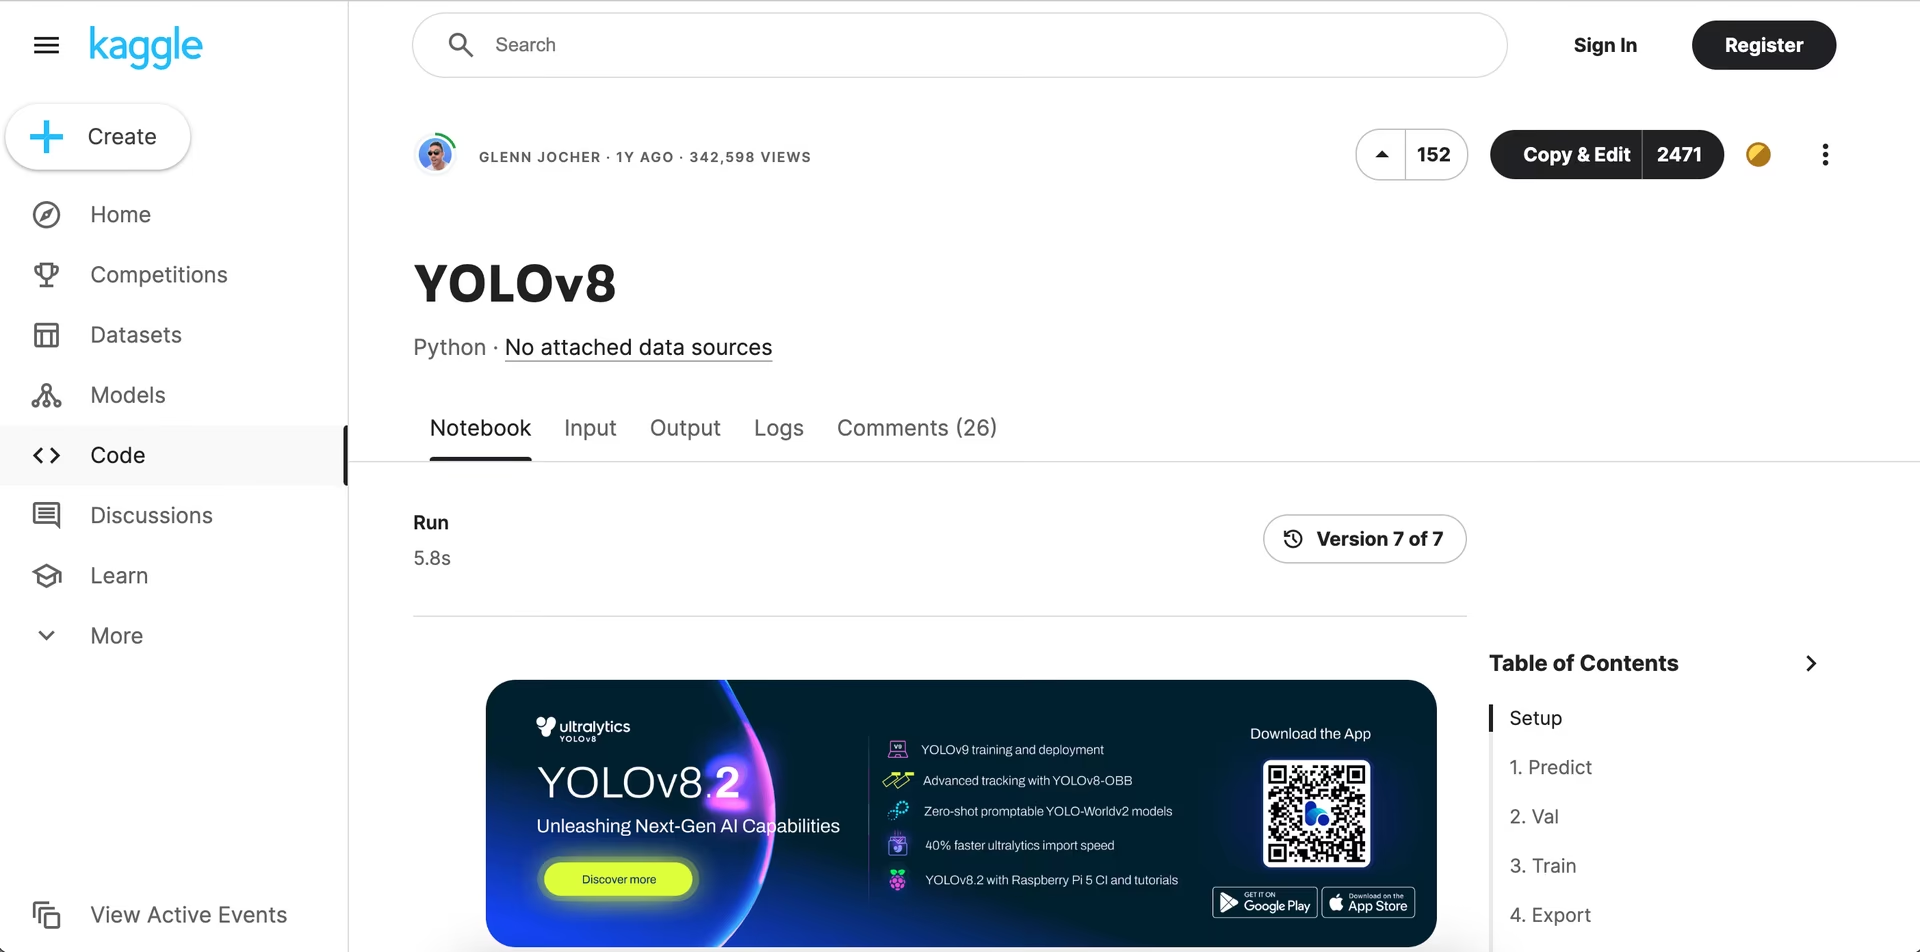
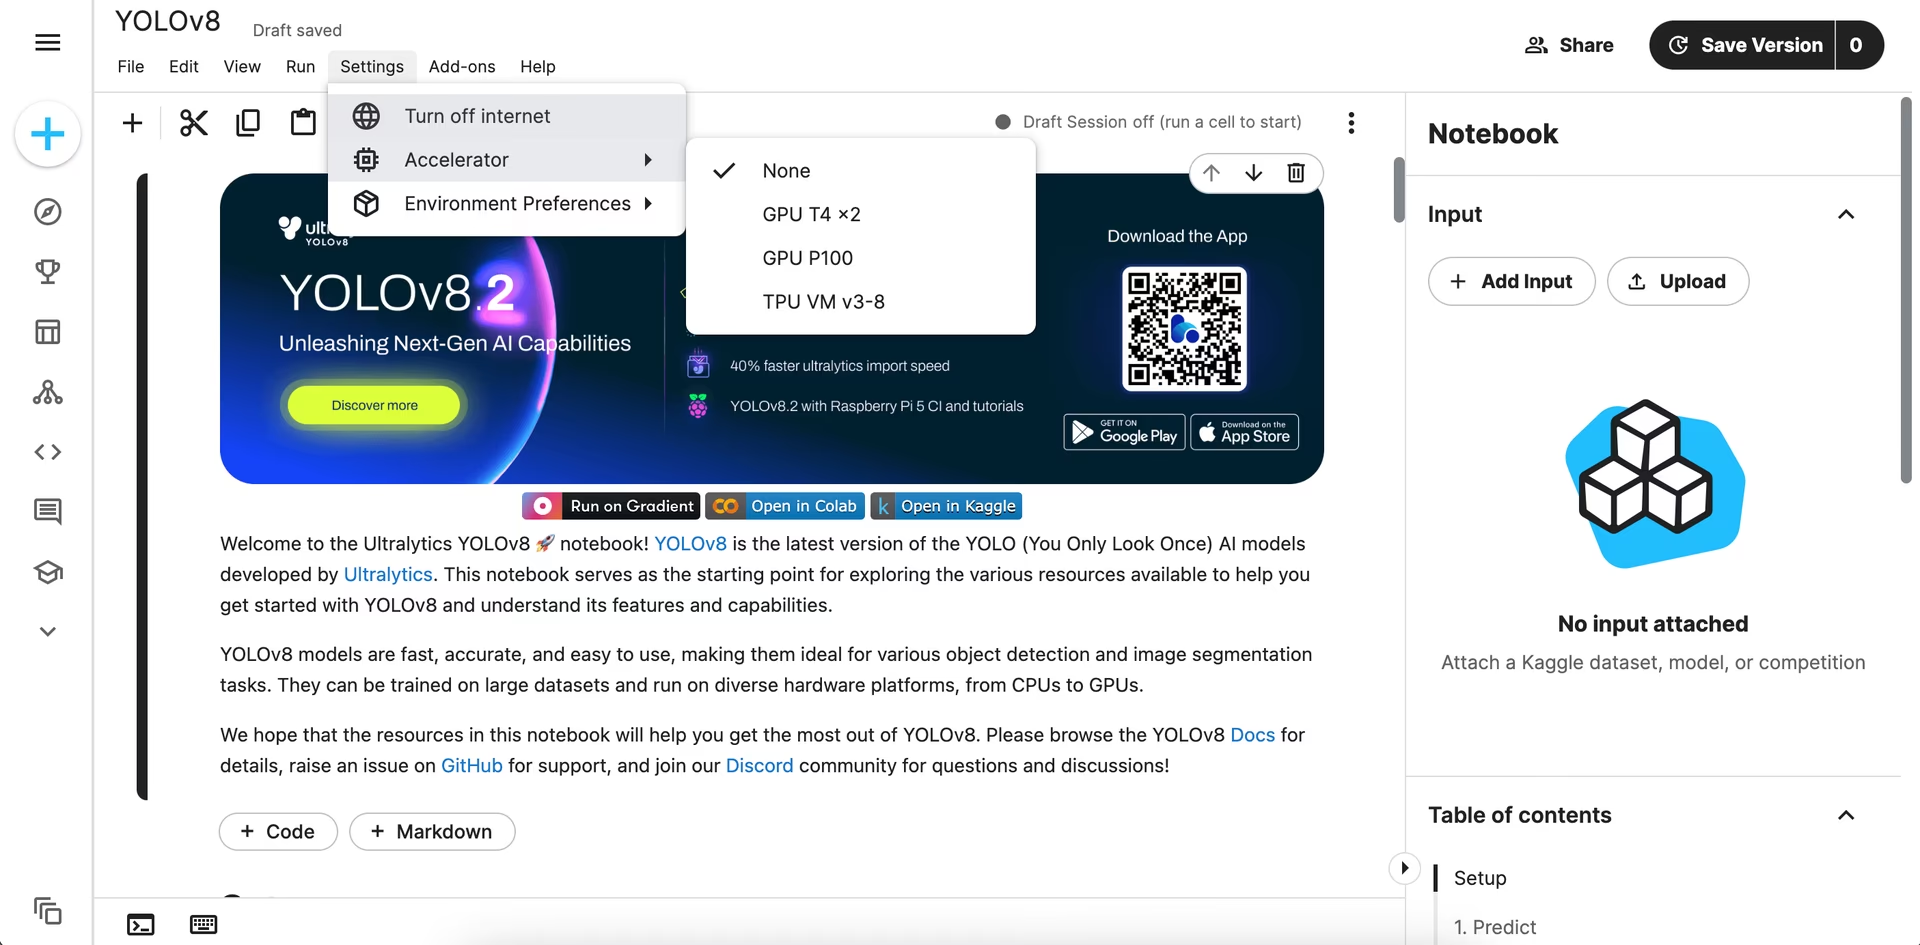
登录 Kaggle 账户后,笔记本会以你自己的可编辑副本打开:在加速器设置中选择 GPU,然后运行笔记本中的单元格,开始训练模型。要详细了解模型训练流程和最佳实践,请参阅我们的 YOLO26 模型训练指南。
使用 Kaggle 时的常见问题#
使用 Kaggle 时,你可能会遇到一些常见问题。以下要点可以帮助你熟悉这个平台:
- GPU 访问权限:在 Kaggle 笔记本中,你可以随时启用 GPU,每周最多可使用 30 小时。Kaggle 提供配备 16GB 内存的 NVIDIA Tesla P100 GPU,也提供 NVIDIA T4 x2 选项。GPU 加速能显著加快模型训练和推理。
- Kaggle Kernels:Kaggle Kernels 是免费的 Jupyter 笔记本服务器,可集成 GPU,让你在云端计算机上执行机器学习操作。你无需依赖自己计算机的 CPU,从而避免系统过载并释放本地资源。
- Kaggle 数据集:Kaggle 数据集可免费下载。不过,你需要查看每个数据集的许可证,了解使用限制。部分数据集可能限制学术出版或商业用途。你可以将数据集直接下载到 Kaggle 笔记本中,也可以通过 Kaggle API 下载到其他位置。
- 保存并提交笔记本:要在 Kaggle 上保存并提交笔记本,请点击“保存版本”。这样会保存笔记本的当前状态。后台内核完成输出文件生成后,你可以在笔记本主页的“输出”选项卡中访问这些文件。
- 协作:Kaggle 支持协作,但多位用户无法同时编辑同一个笔记本。Kaggle 上的协作是异步的,也就是说,用户可以在不同时间共享和使用同一个笔记本。
- 恢复到早期版本:如果需要将笔记本恢复到早期版本,请打开笔记本并点击右上角的三个竖点,然后选择“查看版本”。找到要恢复的版本,点击旁边的“...”菜单,再选择“恢复到此版本”。笔记本恢复后,点击“保存版本”以提交更改。
Kaggle 的主要功能#
以下是 Kaggle 为数据科学和机器学习提供的一些主要功能:
- 数据集:Kaggle 托管了大量涉及各种主题的数据集。你可以在项目中搜索和使用这些数据集,这对于训练和测试 YOLO26 模型尤其方便。
- 竞赛:Kaggle 竞赛让数据科学家和机器学习从业者能够解决现实世界的问题。参加竞赛有助于提升技能、学习新技术,并在社区中获得认可。
- 免费使用 TPU:Kaggle 为支持 TPU 的框架提供免费的 TPU 访问权限。Ultralytics YOLO26 训练使用 Kaggle 的 GPU 或 CPU,而不使用 TPU。
- 与 GitHub 集成:Kaggle 允许你连接 GitHub 仓库,以便上传笔记本并保存工作成果。通过此集成,你可以方便地管理和访问文件。
- 社区与讨论:Kaggle 拥有庞大的数据科学家和机器学习从业者社区。讨论论坛和共享笔记本是学习和排查问题的实用资源。你可以寻求帮助、分享知识并与他人协作。
为什么要在 YOLO26 项目中使用 Kaggle?#
有多个平台可用于训练和评估机器学习模型。以下是使用 Kaggle 开展机器学习项目的一些优势:
- 公开笔记本:你可以将 Kaggle 笔记本设为公开,让其他用户查看、投票、派生副本并讨论你的成果。Kaggle 鼓励协作、反馈和创意分享,帮助你改进 YOLO26 模型。
- 完整的笔记本提交历史:Kaggle 会详细记录笔记本的提交历史。你可以查看和追踪随时间发生的更改,更轻松地了解项目的演进过程,并在需要时恢复到早期版本。
- 控制台访问:Kaggle 提供控制台,让你可以更好地控制环境。借助此功能,你可以直接通过命令行执行各种任务。
- 资源可用性:Kaggle 为每次笔记本编辑会话提供充足资源:CPU 和 GPU 会话可运行 12 小时,TPU 会话可运行 9 小时,并提供 20GB 自动保存磁盘空间。
- 笔记本计划任务:Kaggle 允许你安排笔记本在特定时间运行。你可以自动执行重复任务,无需手动干预,例如定期训练模型。
继续了解 Kaggle#
如果你想进一步了解 Kaggle,以下资源可以为你提供帮助:
- Kaggle Learn:在 Kaggle Learn 上探索各种免费的交互式教程。这些课程通过实践练习讲解数据科学的核心主题。
- Kaggle 入门指南:本指南将介绍 Kaggle 的基础用法,从参加竞赛到创建你的第一个笔记本。
- Kaggle Medium 页面:在 Kaggle 的 Medium 页面上了解教程、更新和社区贡献。
- 使用 Kaggle 集成训练 Ultralytics YOLO 模型:这篇博客文章介绍了如何专门使用 Kaggle 训练 Ultralytics YOLO 模型。
总结#
Kaggle 为 YOLO26 项目提供免费的 GPU 访问权限,用于模型训练和评估,并预装了各类库,方便你快速开始。Ultralytics YOLO26 与 Kaggle 相结合,让你无需昂贵的硬件即可开发、训练和部署计算机视觉模型。
如需了解更多详情,请访问 Kaggle 文档。
常见问题#
在 Kaggle 上安装 Ultralytics YOLO26:
- 启用互联网:打开“设置”面板,将“互联网”开关切换为“开启”。
- 安装软件包:在笔记本单元格中运行
!pip install ultralytics - 验证安装:运行
import ultralytics; ultralytics.checks()进行确认
如果遇到依赖冲突,请尝试运行
!pip install --upgrade --force-reinstall ultralytics,或在安装后重新启动内核。如需详细的故障排查说明,请参阅上文的安装部分。在 Kaggle 上训练 YOLO26 模型很简单。首先,打开 Kaggle 上的 Ultralytics YOLO26 教程笔记本。登录 Kaggle 账户,并在加速器设置中选择 GPU。运行笔记本单元格即可开始训练。有关更详细的步骤,请参阅我们的 YOLO26 模型训练指南。
使用 Kaggle 训练 YOLO26 模型有以下几项优势:
- 免费使用 GPU:每周最多可使用 NVIDIA Tesla P100 或 T4 x2 等 GPU 30 小时。
- 预装库:TensorFlow 和 PyTorch 等库均已预装,简化了环境设置。
- 社区协作:与庞大的数据科学家和机器学习爱好者社区交流。
- 版本控制:管理笔记本的不同版本,并在需要时恢复到之前的版本。
Kaggle 提供多项功能,使其有别于 Google Colab:
- 公开笔记本:与社区分享你的成果,以获取反馈并开展协作。
- 完整历史记录:通过详细的笔记本提交历史追踪更改。
- 资源可用性:每次笔记本会话都能获得充足资源,包括 CPU 和 GPU 会话的 12 小时运行时间。
要恢复到早期版本:
- 打开笔记本并点击右上角的三个竖点。
- 选择“查看版本”。
- 找到要恢复的版本,点击旁边的“...”菜单,然后选择“恢复到此版本”。
- 点击“保存版本”以提交更改。


评论3
提出问题、分享结果,或帮助其他人。
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?