كيفية اختبار نماذج الرؤية الحاسوبية#
مقدمة#
يتحقق اختبار النموذج من أداء النموذج المدرَّب على بيانات واقعية لم يسبق له رؤيتها — مثل الكائنات المتحركة أو ضعيفة الإضاءة أو المحجوبة جزئيًا، بدلًا من معيار مُنتقى بعناية. وبينما يقيس تقييم النموذج المقاييس على مجموعة بيانات موسومة، يتحقق الاختبار من توافق السلوك الذي تعلّمه النموذج مع أهداف تطبيقك قبل النشر. يوضح هذا الدليل كيفية إعداد بيانات الاختبار، واختبار نماذج Ultralytics YOLO26، واكتشاف فرط التكيّف، ونقص التكيّف، وتسرب البيانات.
Watch: How to Test Machine Learning Models | Avoid Data Leakage in Computer Vision 🚀
اختبار النموذج مقابل تقييم النموذج#
اختبار النموذج وتقييمه هما خطوتان متميزتان في مشروع للرؤية الحاسوبية. يقيس التقييم الأداء باستخدام المقاييس على مجموعة بيانات موسومة؛ بينما يتحقق الاختبار من استمرار صلاحية السلوك الذي تعلّمه النموذج في ظروف تشبه ظروف النشر.
لنفترض أنك درّبت نموذج رؤية حاسوبية للتعرّف على القطط والكلاب، وتريد نشره في متجر للحيوانات الأليفة لمراقبة الحيوانات. خلال مرحلة تقييم النموذج، تستخدم مجموعة بيانات موسومة لحساب مقاييس مثل الدقة، والإحكام، والاستدعاء. فعلى سبيل المثال، قد تبلغ دقة النموذج 98% في التمييز بين القطط والكلاب ضمن مجموعة بيانات معينة.
بعد التقييم، تختبر النموذج باستخدام صور من متجر للحيوانات الأليفة لمعرفة مدى جودة تعرّفه على القطط والكلاب في ظروف أكثر تنوعًا وواقعية. وتتحقق من قدرته على وسم القطط والكلاب بشكل صحيح عندما تكون متحركة، أو في ظروف إضاءة مختلفة، أو محجوبة جزئيًا بأشياء مثل الألعاب أو الأثاث. يتحقق اختبار النموذج من تصرّفه كما هو متوقع خارج بيئة التقييم الخاضعة للرقابة.
الاستعداد لاختبار النموذج#
تُقسَّم مجموعات بيانات الرؤية الحاسوبية عادةً إلى مجموعتي تدريب واختبار لمحاكاة الظروف الواقعية: إذ تعلّم بيانات التدريب النموذج، بينما تتحقق بيانات الاختبار من سلوكه على أمثلة لم يسبق له رؤيتها. وتُبقي منصة Ultralytics تنظيم مجموعة البيانات وتعليقها التوضيحي في مكان واحد، مما يساعد عند إنشاء مجموعة اختبار موسومة.
- تمثيل واقعي: ينبغي أن تكون بيانات الاختبار التي لم يسبق للنموذج رؤيتها مشابهةً للبيانات التي سيتعامل معها عند نشره. ويقدّم ذلك صورة واقعية عن قدرات النموذج.
- حجم كافٍ: يجب أن تكون مجموعة بيانات الاختبار كبيرة بما يكفي لتوفير رؤى موثوقة حول مدى جودة أداء النموذج.
كيفية اختبار نموذج YOLO26#
يتضمن اختبار نموذج YOLO26 مدرَّب سيرَي عمل متكاملين: التحقق من صحته على تقسيم اختبار موسوم للحصول على مقاييس كمية، وإجراء التنبؤ على صور جديدة لفحص سلوكه نوعيًا.
التحقق من الصحة على تقسيم اختبار موسوم#
يقارن وضع التحقق من الصحة تنبؤات النموذج بالتسميات المرجعية، ويُبلغ عن الإحكام والاستدعاء وmAP50 وmAP50-95 لنماذج الكشف. كما يحفظ وسائل إيضاح مرئية مثل مصفوفة الالتباس ومنحنى الإحكام والاستدعاء، مما يساعدك على تحديد مجالات معينة قد لا يحقق فيها النموذج أداءً جيدًا.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Validate; add split="test" if your dataset YAML defines a test split
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
افتراضيًا، يُجرى التحقق من الصحة على تقسيم مجموعة البيانات val. ولقياس الأداء على مجموعة اختبار محجوزة، عرّف تقسيمًا test: في YAML الخاص بمجموعة البيانات ومرّر split="test".
إجراء التنبؤ على صور جديدة#
يشغّل وضع التنبؤ النموذج على بيانات جديدة لم يسبق له رؤيتها من دون الحاجة إلى تسميات. ولا ينتج مقاييس أداء، لكن حفظ المخرجات المشروحة يتيح لك مراجعة سلوك النموذج على الصور الواقعية — مثل مجلد كامل من صور الاختبار دفعةً واحدة.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Run predictions on a folder of test images and save annotated results
results = model.predict(source="path/to/test_images", save=True)للتحقق من ملاءمة YOLO26 لتطبيقك قبل الاستثمار في التدريب المخصص، شغّل وضع التنبؤ باستخدام نقطة تحقق مدرَّبة مسبقًا على صورك الخاصة. تكون النماذج مدرَّبة مسبقًا على مجموعات بيانات مثل COCO، لذا تعطي النتائج مؤشرًا سريعًا على مدى جودة أداء النموذج المحتملة في سياقك المحدد.
وضع التحقق من الصحة مقابل وضع التنبؤ#
| الوضع | الغرض | يتطلب تسميات | المخرجات |
|---|---|---|---|
| التحقق من الصحة | قياس الأداء مقارنةً بالحقيقة المرجعية | نعم | الإحكام، والاستدعاء، وmAP50، وmAP50-95، ومصفوفة الالتباس، ومنحنيات PR |
| التنبؤ | فحص سلوك النموذج على بيانات جديدة غير موسومة | لا | صور مشروحة ونتائج تنبؤ، من دون مقاييس |
كيفية تحليل نتائج الاختبار#
بعد الحصول على التنبؤات والمقاييس، تعمّق في تحديد مواضع فشل النموذج وأسبابها:
- الصور المصنَّفة تصنيفًا خاطئًا: حدّد الصور التي صنّفها النموذج تصنيفًا خاطئًا وراجعها لفهم مواضع الخطأ.
- تحليل الأخطاء: أجرِ تحليلًا شاملًا للأخطاء لفهم أنواعها (مثل الإيجابيات الكاذبة مقابل السلبيات الكاذبة) وأسبابها المحتملة.
- التحيز والإنصاف: تحقّق من وجود أي تحيزات في تنبؤات النموذج. وتأكد من أداء النموذج بالمستوى نفسه عبر مجموعات فرعية مختلفة من البيانات، لا سيما إذا كانت تتضمن سمات حساسة مثل العِرق أو النوع الاجتماعي أو العمر.
فرط التكيّف ونقص التكيّف في تعلّم الآلة#
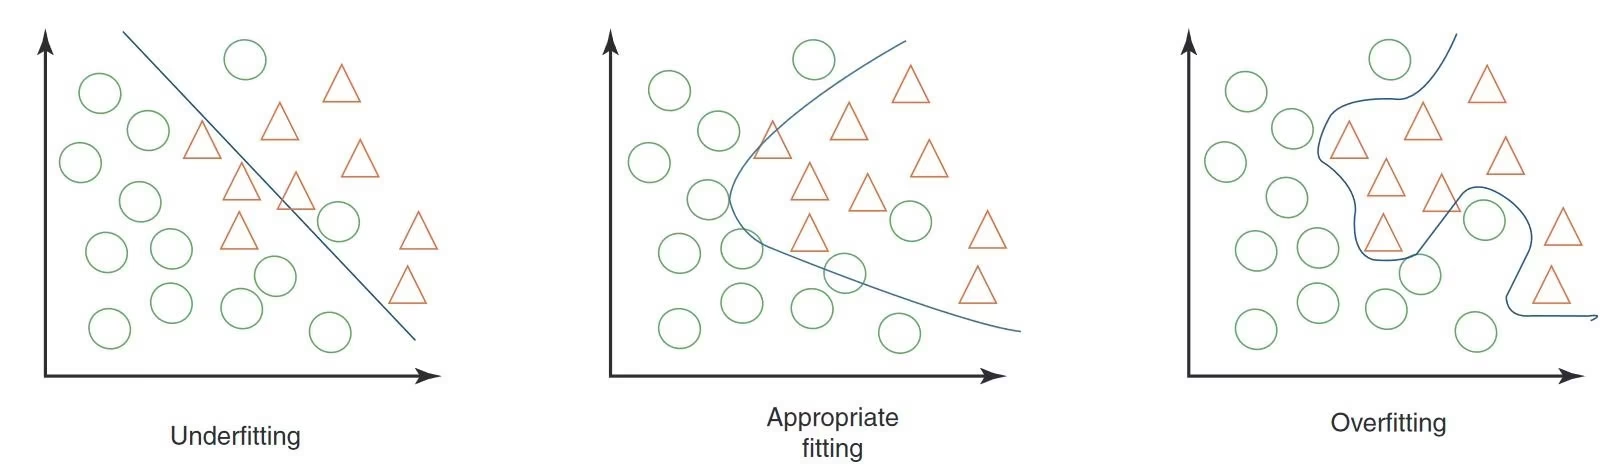
عند اختبار نموذج تعلّم الآلة، لا سيما في الرؤية الحاسوبية، من المهم الانتباه إلى فرط التكيّف ونقص التكيّف. ويمكن أن تؤثر هاتان المشكلتان تأثيرًا كبيرًا في مدى جودة عمل النموذج مع البيانات الجديدة.
| المشكلة | العلامات الشائعة | كيفية معالجتها |
|---|---|---|
| فرط التكيّف | دقة تدريب مرتفعة لكن دقة تحقق منخفضة؛ وحساسية مفرطة تجاه التغييرات الطفيفة أو التفاصيل غير ذات الصلة في الصور | طبّق التنظيم مثل الإسقاط، وزِد حجم مجموعة بيانات التدريب، وبسّط بنية النموذج |
| نقص التكيّف | دقة منخفضة حتى على مجموعة التدريب؛ وفشل متكرر في التعرّف على السمات أو الكائنات الواضحة | استخدم نموذجًا أكثر تعقيدًا، وقدّم سمات أكثر صلة، وزِد عدد العصور التدريبية |
يكمن الأمر الأساسي في إيجاد توازن كي يحقق النموذج أداءً جيدًا على مجموعتي بيانات التدريب والتحقق من الصحة. ويساعد رصد المقاييس بانتظام وفحص التنبؤات بصريًا أثناء الاختبار على اكتشاف انجراف النموذج نحو أي من الطرفين.
تسرب البيانات في الرؤية الحاسوبية وكيفية تجنبه#
يحدث تسرب البيانات عندما تُستخدم معلومات من خارج مجموعة بيانات التدريب عن طريق الخطأ لتدريب النموذج. وقد يبدو النموذج دقيقًا جدًا أثناء التدريب، لكنه لن يحقق أداءً جيدًا على البيانات الجديدة التي لم يسبق له رؤيتها عند حدوث تسرب البيانات.
قد يصعب اكتشاف التسرب، وغالبًا ما ينشأ عن تحيزات خفية في بيانات التدريب:
| نوع التحيز | مظهره |
|---|---|
| تحيز الكاميرا | تُدخل الزوايا والإضاءة والظلال وحركات الكاميرا المختلفة أنماطًا غير مرغوب فيها |
| تحيز التراكبات | تضلل الشعارات أو الطوابع الزمنية أو التراكبات الأخرى في الصور النموذج |
| تحيز الخطوط والكائنات | تُحرّف خطوط أو كائنات محددة تظهر كثيرًا في فئات معينة عملية تعلّم النموذج |
| التحيز المكاني | تؤثر الاختلالات في توزيع المقدمة والخلفية وصناديق الإحاطة ومواقع الكائنات في التدريب |
| تحيز التسميات والمجال | تؤدي التسميات غير الصحيحة أو التحولات في أنواع البيانات إلى التسرب |
كيفية اكتشاف تسرب البيانات وتجنبه#
للعثور على تسرب البيانات، تحقّق مما إذا كانت نتائج النموذج جيدة على نحو مفاجئ، وافحص ما إذا كانت إحدى السمات أهم بكثير من غيرها، وأعد التحقق من أن قرارات النموذج منطقية حدسيًا، وتأكد من تقسيم البيانات بشكل صحيح قبل إجراء أي معالجة.
لمنعه، استخدم مجموعة بيانات متنوعة تضم صورًا أو مقاطع فيديو من كاميرات وبيئات مختلفة، وراجع بياناتك بعناية بحثًا عن التحيزات الخفية — مثل أن تكون جميع العينات الإيجابية ملتقطة في وقت محدد من اليوم. ويجعل تجنب تسرب البيانات نماذج الرؤية الحاسوبية أكثر موثوقية في المواقف الواقعية.
ما الذي يأتي بعد اختبار النموذج#
بعد اختبار النموذج، تعتمد الخطوات التالية على النتائج. فإذا كان أداء النموذج جيدًا، يمكنك نشره في بيئة واقعية. أما إذا لم تكن النتائج مُرضية، فستحتاج إلى إجراء تحسينات. وقد يشمل ذلك تحليل الأخطاء، وجمع مزيد من البيانات، وتحسين جودة البيانات، وضبط المعلمات الفائقة، وإعادة تدريب النموذج.
الخلاصة#
إن اختبار النموذج بصرامة — عبر التحقق من الصحة على تقسيم اختبار محجوز، وإجراء التنبؤ على صور واقعية، والتحقق من فرط التكيّف وتسرب البيانات — هو ما يحوّل النموذج المُقيَّم جيدًا إلى نموذج موثوق. عالج المشكلات التي يكشفها الاختبار قبل النشر، وسيزداد احتمال أداء النموذج كما هو مقصود في بيئة الإنتاج بدرجة كبيرة. وإذا ظهرت أسئلة أثناء ذلك، فاطرحها على المجتمع في مستودع Ultralytics على GitHub أو في خادم Ultralytics على Discord.
الأسئلة الشائعة#
يقيس تقييم النموذج الأداء باستخدام المقاييس على مجموعة بيانات موسومة، بينما يتحقق اختبار النموذج من سلوكه على بيانات جديدة لم يسبق له رؤيتها وتشبه ظروف النشر. وينتج التقييم أرقامًا مثل الإحكام وmAP من مجموعة بيانات خاضعة للرقابة؛ أما الاختبار فيكشف مدى استمرار السلوك المتعلَّم مع اختلاف الإضاءة أو الحركة أو الحجب. راجع اختبار النموذج مقابل تقييم النموذج للاطلاع على مثال تطبيقي.
استخدم وضع التنبؤ ومرّر مسار مجلد بوصفه
source— إذ يشغّل YOLO26 النموذج على كل صورة في المجلد، ويمكنه حفظ النتائج المشروحة لمراجعتها. لا يحسب وضع التنبؤ المقاييس؛ ولقياس الأداء على مجموعة موسومة، استخدم وضع التحقق من الصحة بدلًا منه. ويُعرض سيرَا العمل كلاهما في كيفية اختبار نموذج YOLO26.بالنسبة إلى نماذج الكشف، يُبلغ التحقق من الصحة عن الإحكام والاستدعاء وmAP50 وmAP50-95، ويحفظ مخططات تتضمن مصفوفة الالتباس ومنحنى الإحكام والاستدعاء. وللتحقق من الصحة على تقسيم اختبار مخصص بدلًا من التقسيم الافتراضي
val، عرّفtest:في YAML الخاص بمجموعة البيانات ومرّرsplit="test". راجع دليل مقاييس الأداء لمعرفة كيفية تفسير كل مقياس.بالنسبة إلى فرط التكيّف، طبّق تقنيات التنظيم مثل الإسقاط، أو زِد حجم مجموعة بيانات التدريب، أو بسّط بنية النموذج. وبالنسبة إلى نقص التكيّف، استخدم نموذجًا أكثر تعقيدًا، أو قدّم سمات أكثر صلة، أو درّب النموذج لعدد أكبر من العصور التدريبية. وتُوجز علامات كل مشكلة والإصلاحات المقابلة لها في فرط التكيّف ونقص التكيّف في تعلّم الآلة.
اشتبه في تسرب البيانات عندما يبدو أداء الاختبار جيدًا على نحو مفاجئ، أو تهيمن سمة واحدة على التنبؤات، أو لا تبدو قرارات النموذج منطقية حدسيًا. امنعه باستخدام مجموعات بيانات متنوعة من كاميرات وبيئات مختلفة، ومراجعة البيانات بحثًا عن التحيزات الخفية، والتحقق من إجراء تقسيم التدريب/الاختبار قبل أي معالجة. راجع تسرب البيانات في الرؤية الحاسوبية لمعرفة أنواع التحيز الشائعة.
إذا حققت النتائج أهداف مشروعك، فانشر النموذج؛ وإذا لم تحققها، فحسّنه قبل النشر. وقد يعني ذلك تحليل الأخطاء، وجمع بيانات أكثر تنوعًا، وتحسين جودة البيانات، وضبط المعلمات الفائقة، وإعادة التدريب. كرر الاختبار بعد كل جولة من التغييرات للتأكد من نجاح الإصلاحات.