Ein Leitfaden zur Bereitstellung von YOLO26 auf Amazon SageMaker Endpoints
Amazon-SageMaker-Endpunkte bieten verwaltetes, skalierbares Hosting für Computer-Vision-Modelle wie Ultralytics YOLO26 in produktiven Anwendungen für maschinelles Lernen. Eine erfolgreiche Modellbereitstellung setzt voraus, dass du die Einrichtung, Konfiguration und Bereitstellung sowohl auf Modell- als auch auf AWS-Seite verstehst.
Dieser Leitfaden führt dich Schritt für Schritt durch die Bereitstellung von YOLO26-PyTorch-Modellen auf Amazon SageMaker Endpoints. Du lernst die Grundlagen der Einrichtung deiner AWS-Umgebung, der passenden Konfiguration des Modells und der Verwendung von Werkzeugen wie AWS CloudFormation und dem AWS Cloud Development Kit (CDK) für die Bereitstellung.
Amazon SageMaker#
Amazon SageMaker ist ein Dienst für maschinelles Lernen von Amazon Web Services (AWS), der das Erstellen, Trainieren und Bereitstellen von Modellen des maschinellen Lernens vereinfacht. Er bietet eine breite Palette von Werkzeugen für verschiedene Aspekte von Arbeitsabläufen des maschinellen Lernens. Dazu gehören automatische Funktionen zur Abstimmung von Modellen, Optionen für das Training von Modellen in großem Umfang und einfache Methoden, um Modelle in einer Produktionsumgebung bereitzustellen. SageMaker unterstützt beliebte Frameworks für maschinelles Lernen und bietet so die nötige Flexibilität für vielfältige Projekte. Zu den Funktionen gehören außerdem Datenbeschriftung, Workflow-Verwaltung und Leistungsanalyse.
YOLO26 auf Amazon SageMaker Endpoints bereitstellen#
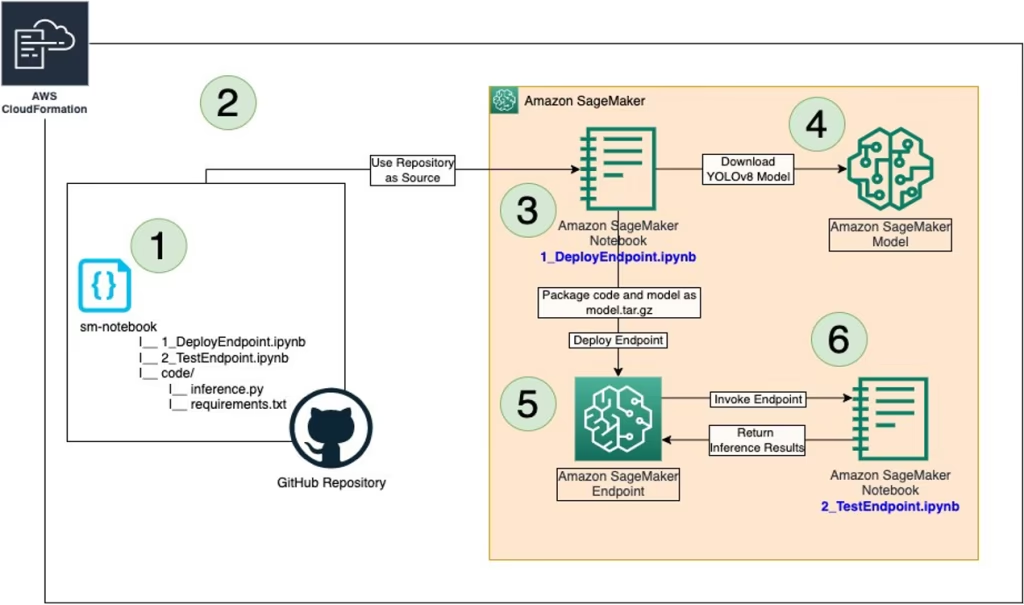
Wenn du YOLO26 auf Amazon SageMaker bereitstellst, kannst du dessen verwaltete Umgebung für die Echtzeitinferenz nutzen und Funktionen wie die automatische Skalierung einsetzen. Sieh dir die folgende AWS-Architektur an.
Schritt 1: Richte deine AWS-Umgebung ein#
Stelle zunächst sicher, dass die folgenden Voraussetzungen erfüllt sind:
-
Ein AWS-Konto: Falls du noch keines hast, erstelle ein AWS-Konto.
-
Konfigurierte IAM-Rollen: Du benötigst eine IAM-Rolle mit den erforderlichen Berechtigungen für Amazon SageMaker, AWS CloudFormation und Amazon S3. Die Richtlinien dieser Rolle müssen den Zugriff auf diese Dienste erlauben.
-
AWS CLI: Falls noch nicht installiert, lade die AWS-Befehlszeilenschnittstelle (CLI) herunter, installiere sie und richte sie mit deinen Kontodaten ein. Folge zur Installation den Anweisungen für AWS CLI.
-
AWS CDK: Falls noch nicht installiert, installiere das AWS Cloud Development Kit (CDK), das zum Erstellen der Bereitstellungsskripte verwendet wird. Folge zur Installation den Anweisungen für AWS CDK.
-
Ausreichendes Servicekontingent: Vergewissere dich, dass du in Amazon SageMaker über ausreichende Kontingente für zwei separate Ressourcen verfügst: eines für
ml.m5.4xlargezur Nutzung mit Endpoints und ein weiteres fürml.m5.4xlargezur Nutzung mit Notebook-Instanzen. Für jede dieser Ressourcen ist mindestens ein Kontingentwert erforderlich. Liegen deine aktuellen Kontingente unter diesem Wert, musst du für jede Ressource eine Erhöhung beantragen. Eine Kontingenterhöhung kannst du gemäß den ausführlichen Anweisungen in der Dokumentation zu AWS Service Quotas beantragen.
Schritt 2: Das YOLO26-SageMaker-Repository klonen#
Als Nächstes klonst du das spezielle AWS-Repository mit den Ressourcen zur Bereitstellung von YOLO26 auf SageMaker. Dieses auf GitHub gehostete Repository enthält die erforderlichen CDK-Skripte und Konfigurationsdateien.
-
GitHub-Repository klonen: Führe den folgenden Befehl in deinem Terminal aus, um das Repository host-yolov8-on-sagemaker-endpoint zu klonen:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git -
Zum geklonten Verzeichnis wechseln: Wechsle in das geklonte Repository:
cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk
Schritt 3: Die CDK-Umgebung einrichten#
Nachdem du den erforderlichen Code bereitgestellt hast, richtest du deine Umgebung für die Bereitstellung mit AWS CDK ein.
-
Eine virtuelle Python-Umgebung erstellen: Dadurch werden deine Python-Umgebung und Abhängigkeiten isoliert. Führe Folgendes aus:
python3 -m venv .venv -
Die virtuelle Umgebung aktivieren:
source .venv/bin/activate -
Abhängigkeiten installieren: Installiere die erforderlichen Python-Abhängigkeiten für das Projekt:
pip3 install -r requirements.txt -
AWS-CDK-Bibliothek aktualisieren: Stelle sicher, dass du die neueste Version der AWS-CDK-Bibliothek verwendest:
pip install --upgrade aws-cdk-lib
Schritt 4: Den AWS-CloudFormation-Stack erstellen#
-
Die CDK-Anwendung synthetisieren: Erzeuge aus deinem CDK-Code eine AWS-CloudFormation-Vorlage:
cdk synth -
Die CDK-Anwendung bootstrappen: Bereite deine AWS-Umgebung für die Bereitstellung mit CDK vor:
cdk bootstrap -
Den Stack bereitstellen: Dadurch werden die erforderlichen AWS-Ressourcen erstellt und dein Modell bereitgestellt:
cdk deploy
Schritt 5: Das YOLO-Modell bereitstellen#
Nachdem du den AWS-CloudFormation-Stack erstellt hast, stellst du als Nächstes YOLO26 bereit.
-
Notebook-Instanz öffnen: Öffne die AWS-Konsole und rufe den Amazon-SageMaker-Dienst auf. Wähle im Dashboard „Notebook-Instances“ aus und suche anschließend die Notebook-Instanz, die von deinem CDK-Bereitstellungsskript erstellt wurde. Öffne die Notebook-Instanz, um auf die Jupyter-Umgebung zuzugreifen.
-
inference.py aufrufen und bearbeiten: Suche nach dem Öffnen der SageMaker-Notebook-Instanz in Jupyter die Datei inference.py. Bearbeite die Funktion output_fn in inference.py wie unten gezeigt und speichere deine Änderungen am Skript. Achte dabei darauf, dass keine Syntaxfehler vorhanden sind.
import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" print("Executing output_fn from inference.py ...") infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() if result.masks is not None: infer["masks"] = result.masks.numpy().data.tolist() if result.keypoints is not None: infer["keypoints"] = result.keypoints.numpy().data.tolist() if result.obb is not None: infer["obb"] = result.obb.numpy().data.tolist() if result.probs is not None: infer["probs"] = result.probs.numpy().data.tolist() return json.dumps(infer) -
Endpunkt mit 1_DeployEndpoint.ipynb bereitstellen: Öffne in der Jupyter-Umgebung das Notebook 1_DeployEndpoint.ipynb im Verzeichnis sm-notebook. Lege im Notebook
model_nameauf einen YOLO26-Checkpoint wieyolo26n.ptfest (standardmäßig wird ein YOLOv8-Modell verwendet). Führe anschließend die Zellen aus, um das Modell herunterzuladen, es mit dem aktualisierten Inferenzcode zu paketieren und in einen Amazon-S3-Bucket hochzuladen. Das Notebook führt dich durch die Erstellung und Bereitstellung eines SageMaker-Endpunkts für das YOLO26-Modell.
Schritt 6: Deine Bereitstellung testen#
Nachdem du dein YOLO26-Modell bereitgestellt hast, solltest du seine Leistung und Funktionsweise unbedingt testen.
-
Test-Notebook öffnen: Suche in derselben Jupyter-Umgebung das Notebook 2_TestEndpoint.ipynb im Verzeichnis sm-notebook und öffne es.
-
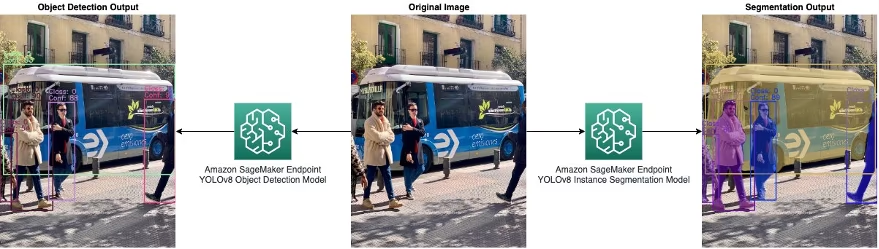
Test-Notebook ausführen: Folge den Anweisungen im Notebook, um den bereitgestellten SageMaker-Endpoint zu testen. Dazu sendest du ein Bild an den Endpoint und führst Inferenzen aus. Anschließend erstellst du wie unten gezeigt ein Diagramm der Ausgabe, um die Leistung und Genauigkeit des Modells zu visualisieren.
- Ressourcen bereinigen: Das Test-Notebook führt dich auch durch die Bereinigung des Endpoints und des gehosteten Modells. Dieser Schritt ist wichtig, um Kosten und Ressourcen effizient zu verwalten, insbesondere wenn du das bereitgestellte Modell nicht sofort verwenden möchtest.
Schritt 7: Überwachung und Verwaltung#
Nach dem Testen sind die kontinuierliche Überwachung und Verwaltung deines bereitgestellten Modells unerlässlich.
-
Mit Amazon CloudWatch überwachen: Überprüfe regelmäßig die Leistung und den Zustand deines SageMaker-Endpoints mit Amazon CloudWatch.
-
Den Endpoint verwalten: Verwende die SageMaker-Konsole für die laufende Verwaltung des Endpoints. Dazu gehören die Skalierung, Aktualisierung oder erneute Bereitstellung des Modells nach Bedarf.
Nach Abschluss dieser Schritte hast du ein YOLO26-Modell auf Amazon-SageMaker-Endpunkten bereitgestellt und getestet. Derselbe Ablauf gilt auch für die Bereitstellung anderer Modelle auf AWS.
Zusammenfassung#
Diese Anleitung hat dich Schritt für Schritt durch die Bereitstellung von YOLO26 auf Amazon-SageMaker-Endpunkten mit AWS CloudFormation und dem AWS Cloud Development Kit (CDK) geführt. Dazu gehören das Klonen des AWS-Beispiel-Repositorys aus dem AWS-Machine-Learning-Blogbeitrag zum Hosting von YOLOv8-PyTorch-Modellen auf Amazon-SageMaker-Endpunkten, das Einrichten der CDK-Umgebung, die Bereitstellung des Modells mit AWS-Diensten und das Testen seiner Leistung auf SageMaker.
Häufig gestellte Fragen#
Gehe wie folgt vor, um das Ultralytics-YOLO26-Modell auf Amazon SageMaker Endpoints bereitzustellen:
- AWS-Umgebung einrichten: Stelle sicher, dass du über ein AWS-Konto und IAM-Rollen mit den erforderlichen Berechtigungen verfügst und die AWS CLI konfiguriert ist. Installiere AWS CDK, falls noch nicht geschehen (siehe die Anleitung zu AWS CDK).
- YOLO26-SageMaker-Repository klonen:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk - CDK-Umgebung einrichten: Erstelle eine virtuelle Python-Umgebung, aktiviere sie, installiere die Abhängigkeiten und aktualisiere die AWS-CDK-Bibliothek.
python3 -m venv .venv source .venv/bin/activate pip3 install -r requirements.txt pip install --upgrade aws-cdk-lib - Mit AWS CDK bereitstellen: Erstelle die CloudFormation-Vorlage und stelle den Stack bereit; initialisiere die Umgebung.
cdk synth
cdk bootstrap
cdk deploy
Für die Bereitstellung von YOLO26 auf Amazon SageMaker benötigst du folgende Voraussetzungen:
- AWS-Konto: Ein aktives AWS-Konto (bei AWS registrieren.)
- IAM-Rollen: Konfigurierte IAM-Rollen mit Berechtigungen für SageMaker, CloudFormation und Amazon S3.
- AWS CLI: Installierte und konfigurierte AWS Command Line Interface (Installationsanleitung für AWS CLI).
- AWS CDK: Installiertes AWS Cloud Development Kit (Einrichtungsanleitung für CDK).
- Servicekontingente: Ausreichende Kontingente für
ml.m5.4xlarge-Instanzen sowohl für Endpoints als auch für Notebooks (Kontingenterhöhung beantragen).
Die Verwendung von Ultralytics YOLO26 auf Amazon SageMaker bietet mehrere Vorteile:
- Skalierbarkeit und Verwaltung: SageMaker bietet eine verwaltete Umgebung mit Funktionen wie automatischer Skalierung, die Echtzeit-Inferenz ermöglicht.
- Integration mit AWS-Diensten: Integriere weitere AWS-Dienste, etwa S3 für die Datenspeicherung, CloudFormation für Infrastruktur als Code und CloudWatch zur Überwachung.
- Einfache Bereitstellung: Vereinfachte Einrichtung mithilfe von AWS-CDK-Skripten und optimierten Bereitstellungsabläufen.
- Leistung: Nutze die verwaltete Infrastruktur von Amazon SageMaker, um Inferenzlasten in großem Umfang auszuführen.
Ja, du kannst die Inferenzlogik für YOLO26 auf Amazon SageMaker anpassen:
-
inference.pyändern: Suche die Funktionoutput_fnin der Dateiinference.pyund passe sie an, um die Ausgabeformate festzulegen.import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() # Füge bei Bedarf weitere Verarbeitungsschritte hinzu return json.dumps(infer) -
Aktualisiertes Modell bereitstellen: Stelle sicher, dass du das Modell mit den bereitgestellten Jupyter-Notebooks (
1_DeployEndpoint.ipynb) erneut bereitstellst, damit diese Änderungen übernommen werden.
Eine Anleitung zur Bereitstellung des geänderten Modells findest du unter ausführliche Schritte.
-
So testest du das bereitgestellte YOLO26-Modell auf Amazon SageMaker:
- Test-Notebook öffnen: Suche das Notebook
2_TestEndpoint.ipynbin der SageMaker-Jupyter-Umgebung. - Notebook ausführen: Befolge die Anweisungen im Notebook, um ein Bild an den Endpoint zu senden, eine Inferenz auszuführen und die Ergebnisse anzuzeigen.
- Ergebnisse visualisieren: Nutze den Plot-Code des Notebooks, um die vorhergesagten Begrenzungsrahmen auf dem Testbild einzuzeichnen.
Eine umfassende Anleitung zum Testen findest du im Testabschnitt.
- Test-Notebook öffnen: Suche das Notebook


Kommentare10
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
 User
I want to upload the YOLOv8 model I trained on my own dataset to Jupyter, and then compress it into a
model.tar.gzfile following the officialdeployendpointsteps. However, when I usetestendpoint, I encounter an error. If I rename my trained model toyolov8, the test succeeds, but it uses the original model from the official website instead of my custom one. How should I modifyinference.pyto ensure it loads my trained model?1 Glenn JocherUltralytics
@lijoe123 to ensure your custom YOLOv8 model is used, modify the
inference.pyto load your model by specifying its path directly. Ensure the model name in your deployment matches your custom model's name. For detailed steps, refer to the Ultralytics documentation on Amazon SageMaker.- User
Thank you for your answer. I had followed the
1_DeployEndpoint.ipynbto delpoy my own model. In the 1.4 Create the SageMaker PyTorchModel, I had set theenv={'TS_MAX_RESPONSE_SIZE':'20000000', 'MY_MODEL': 'my_own_model'}. And in theinference.py:def model_fn(model_dir): print("Executing model_fn from inference.py ...") env = os.environ model = YOLO(os.path.join(model_dir, env['MY_MODEL'])) return modelI think it will be use my own model directly. But it failed, and it occur this problem:
ModelError: An error occurred (ModelError) when calling the InvokeEndpoint operation: Received server error (0)from primary with message "Your invocation timed out while waiting for a response from container primary. Reviewthe latency metrics for each container in Amazon Cloudatch, resolve the issue, and try again.". See https://useast-1. console. aws. aazon. com/cloudwatch/home?region=us-east-1#logEventViewer: group=/aws/sagemaker Endpoints/yolov8-pytorch-2024-09-06-11-33-49-418696 in account 211125332801 for more information.Could you tell me how to modify the
inference.pyto load my own model. Thank you so much. - Glenn JocherUltralytics
To ensure your custom YOLOv8 model is used, verify that the
model_fnininference.pycorrectly points to your model's path. Ensure theMY_MODELenvironment variable matches your model's filename. If issues persist, check CloudWatch logs for detailed error messages. For further guidance, refer to the Ultralytics documentation on Amazon SageMaker.
SJTUPanda
Thanks for your sharing, it's very clear and useful. My own deployment workflow on AWS has already built but the test result is not so satisfying. The performance of detection result of yolo11-xl on AWS is worse than on my own laptop. I not sure if there is some default quantization when it's deployed to the AWS(I did not modified much to host-yolov8-on-sagemaker-endpoint), or do you have some other ideas about which would bring this significant performance differences?
- Glenn JocherUltralytics
@SJTUPanda thank you for your feedback! The performance difference could stem from several factors like hardware disparities (AWS instance vs laptop GPU), inference settings, or environment configurations. First, verify that your SageMaker instance type matches your local hardware capabilities, and ensure identical inference parameters (e.g.,
imgsz,batch). Check our Amazon SageMaker deployment guide for optimization tips and consider profiling both environments withyolo valto isolate bottlenecks. Let us know if specific metrics differ! 🚀 Thanks for your quick reply. The issue is fixed after I comment out resize related code. Although the model is trained with (640,640) and the input image size is (720,440), using the raw images directly as input is better than resized it. I am curious the input images would be auto-resized by the model just as in the training/testing part? And why resized by myself has so much impact on the results? If these part code should be update because yolo version updating?
image_height, image_width, _ = orig_image.shape model_height, model_width = 640, 640 x_ratio = image_width/model_width y_ratio = image_height/model_height # Resize the image as numpy array resized_image = cv2.resize(orig_image, (model_height, model_width)) # Conver the array into jpeg resized_jpeg = cv2.imencode('.jpg', resized_image)[1] # Serialize the jpg using base 64 payload = base64.b64encode(resized_jpeg).decode('utf-8')- Glenn JocherUltralytics
Thank you for sharing your findings! YOLO models do automatically resize inputs to match their training dimensions while preserving aspect ratio with letterboxing. Manual resizing can distort aspect ratios or introduce artifacts, potentially degrading performance. We recommend using the model's native preprocessing by feeding full-size images directly, as this maintains proper scaling and aspect ratio handling. For implementation details, refer to our model deployment best practices regarding input consistency.
NikoXanthidis
Gostaria de saber se esses recursos são pagos.
- Glenn JocherUltralytics
Olá! 👋 Os recursos mencionados para implementar o YOLOv8 no Amazon SageMaker não são pagos por si só. No entanto, o uso do Amazon SageMaker e outros serviços da AWS associados à implementação e execução do modelo podem incorrer em custos conforme o uso. A AWS oferece uma camada gratuita que você pode aproveitar para experimentar alguns serviços sem custo, mas é sempre bom verificar a página de preços do SageMaker para detalhes específicos. Se precisar de ajuda para estimar os custos ou tiver outras dúvidas, estou aqui para ajudar! 🚀