Aprende a exportar un modelo YOLO26 al formato TFLite Edge TPU#
Implementar modelos de visión artificial en dispositivos con poca potencia de cálculo, como sistemas móviles o integrados, puede resultar complicado. El uso de un formato de modelo optimizado para un mayor rendimiento simplifica el proceso. El formato de modelo Edge TPU de TensorFlow Lite, o TFLite Edge TPU, está diseñado para consumir poca energía y ofrecer un alto rendimiento en redes neuronales.
La función de exportación al formato TFLite Edge TPU te permite optimizar tus modelos Ultralytics YOLO26 para obtener inferencias rápidas y de bajo consumo. En esta guía te explicamos cómo convertir tus modelos al formato TFLite Edge TPU para que funcionen mejor en diversos dispositivos móviles y sistemas integrados.
¿Por qué exportar al formato TFLite Edge TPU?#
Exportar modelos a Edge TPU de TensorFlow permite realizar tareas de aprendizaje automático de forma rápida y eficiente. Esta tecnología es adecuada para aplicaciones con limitaciones de energía, recursos informáticos y conectividad. Edge TPU es un acelerador de hardware de Google. Acelera los modelos TensorFlow Lite en dispositivos edge. La imagen siguiente muestra un ejemplo del proceso.
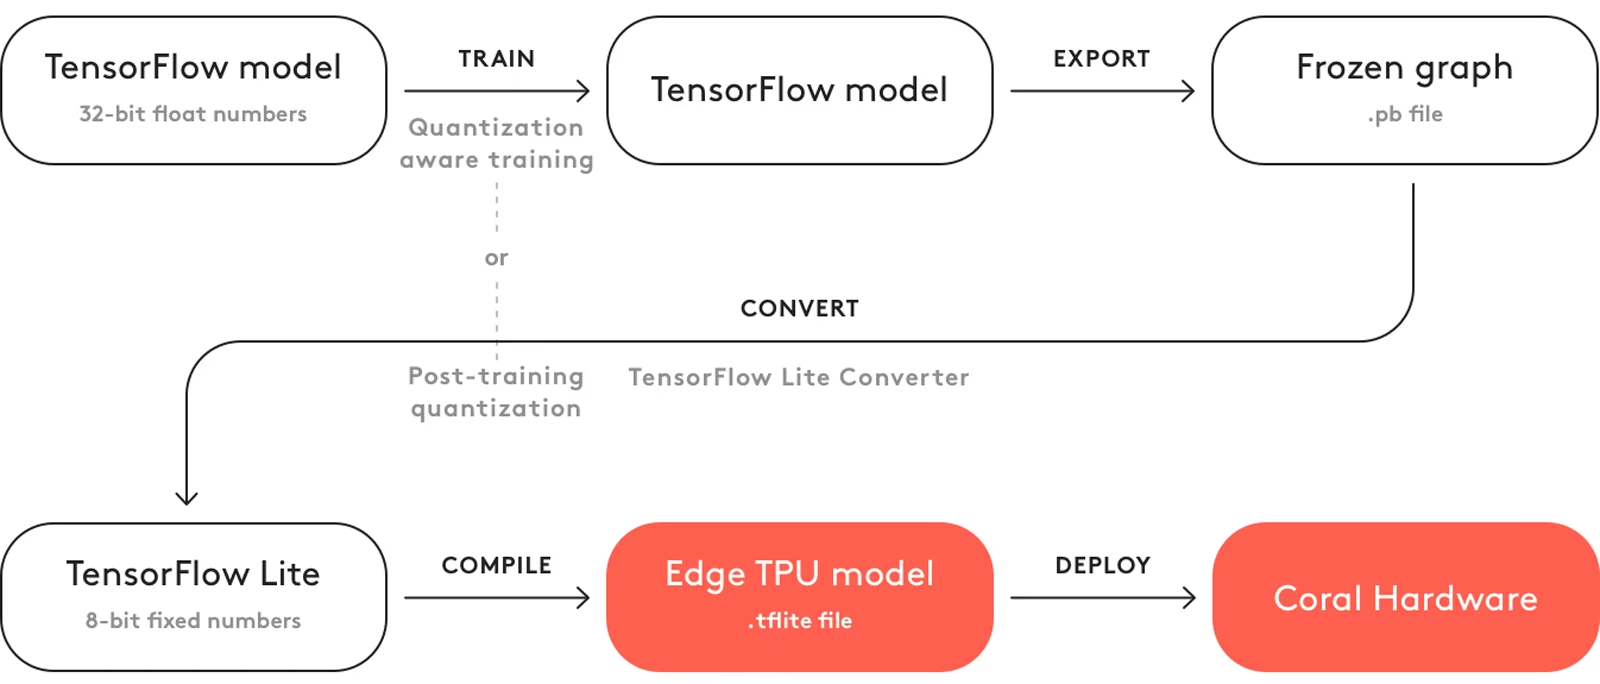
Edge TPU funciona con modelos cuantizados. La cuantización hace que los modelos sean más pequeños y rápidos sin perder mucha precisión. Es ideal para los recursos limitados de la computación edge: reduce la latencia y permite que las aplicaciones respondan rápidamente y procesen los datos localmente, sin depender de la nube. El procesamiento local también mantiene los datos de los usuarios privados y seguros, ya que no se envían a un servidor remoto.
Características principales de TFLite Edge TPU#
Estas son las características principales que hacen de TFLite Edge TPU una excelente opción de formato de modelo para los desarrolladores:
-
Rendimiento optimizado en dispositivos edge: TFLite Edge TPU ofrece un alto rendimiento de redes neuronales mediante la cuantización, la optimización de modelos, la aceleración por hardware y la optimización del compilador. Su arquitectura minimalista contribuye a reducir su tamaño y coste.
-
Alto rendimiento computacional: TFLite Edge TPU combina aceleración de hardware especializada y una ejecución eficiente para lograr un alto rendimiento computacional. Es muy adecuado para implementar modelos de aprendizaje automático con requisitos de rendimiento estrictos en dispositivos periféricos.
-
Cálculos matriciales eficientes: TensorFlow Edge TPU está optimizado para operaciones matriciales, fundamentales para los cálculos de redes neuronales. Esta eficiencia es clave en los modelos de aprendizaje automático, especialmente en aquellos que requieren numerosas multiplicaciones y transformaciones matriciales complejas.
Opciones de implementación con TFLite Edge TPU#
Antes de ver cómo exportar modelos YOLO26 al formato TFLite Edge TPU, veamos dónde se suelen utilizar los modelos TFLite Edge TPU.
TFLite Edge TPU ofrece varias opciones para implementar modelos de aprendizaje automático, entre ellas:
-
Implementación en el dispositivo: Los modelos TensorFlow Edge TPU se pueden implementar directamente en dispositivos móviles e integrados. La implementación en el dispositivo permite ejecutar los modelos directamente en el hardware, sin necesidad de conectarse a la nube, ya sea integrando el modelo en el paquete de la aplicación o descargándolo cuando se necesite.
-
Implementación híbrida: Un enfoque híbrido combina la implementación en el dispositivo y en la nube, y ofrece una solución versátil y escalable para implementar modelos de aprendizaje automático. Entre sus ventajas se incluyen el procesamiento en el dispositivo para obtener respuestas rápidas y la computación en la nube para realizar cálculos más complejos.
Tareas compatibles#
La exportación a Edge TPU es compatible con seis de las siete tareas de Ultralytics. La segmentación semántica solo está disponible con YOLO26, la única familia que incluye esa cabeza. La estimación de profundidad no es compatible porque su modelo INT8 genera un operador v2 EXP que el compilador de Edge TPU no puede analizar.
| Tarea | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detectar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semántica | ❌ | ❌ | ✅ |
| Profundidad | ❌ | ❌ | ❌ |
| Clasificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
El compilador de Edge TPU asigna las operaciones compatibles al acelerador y deja el resto en la CPU, por lo que la compatibilidad con una tarea no significa que todas sus operaciones se ejecuten en la TPU.
Exportar modelos YOLO26 a TFLite Edge TPU#
Puedes ampliar la compatibilidad de los modelos y la flexibilidad de implementación convirtiendo modelos YOLO26 a TensorFlow Edge TPU.
Instalación#
Para instalar el paquete necesario, ejecuta:
# Install the required package for YOLO26
pip install ultralytics
Para obtener instrucciones detalladas y buenas prácticas relacionadas con el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía sobre problemas habituales, donde encontrarás soluciones y consejos.
Uso#
Todos los modelos Ultralytics YOLO26 están diseñados para admitir la exportación desde el primer momento, lo que facilita su integración en el flujo de trabajo de implementación que prefieras. Puedes consultar la lista completa de formatos de exportación y opciones de configuración compatibles para elegir la configuración más adecuada para tu aplicación.
El formato TFLite Edge TPU es compatible con los modos Exportar, Predecir y Validar. La inferencia y la validación se ejecutan en hardware Coral Edge TPU. Exporta tu modelo y, a continuación, carga el modelo exportado para ejecutar inferencias o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato TFLite Edge TPU
model.export(format="edgetpu") # crea 'yolo26n_saved_model/yolo26n_full_integer_quant_edgetpu.tflite'from ultralytics import YOLO
# Carga el modelo TFLite Edge TPU exportado
model = YOLO("yolo26n_saved_model/yolo26n_full_integer_quant_edgetpu.tflite")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo TFLite Edge TPU exportado
model = YOLO("yolo26n_saved_model/yolo26n_full_integer_quant_edgetpu.tflite")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'edgetpu' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | 8/auto | Precisión de cuantización. 8 (INT8) es obligatorio y se activa automáticamente para Edge TPU; comprime el modelo y acelera la inferencia con una pérdida mínima de precisión en dispositivos periféricos. Sustituye a las marcas half/int8, obsoletas. |
opset | int | None | Especifica la versión del conjunto de operaciones de ONNX para el grafo ONNX intermedio. Si no se establece, se utiliza la última versión compatible. |
data | str | None | Ruta al archivo YAML del conjunto de datos, imprescindible para la cuantización; en clasificación, en su lugar se indica un directorio del conjunto de datos o el nombre de un conjunto de datos integrado. Si se omite con quantize=8, Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para la exportación: CPU (device=cpu). |
Asegúrate de utilizar una máquina Linux x86 para exportar a Edge TPU.
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
Implementar modelos YOLO26 TFLite Edge TPU exportados#
Tras exportar correctamente tus modelos Ultralytics YOLO26 al formato TFLite Edge TPU, ya puedes implementarlos. El primer paso recomendado para ejecutar un modelo TFLite Edge TPU es utilizar el método YOLO("model_edgetpu.tflite"), tal como se muestra en el fragmento de código de uso anterior.
Sin embargo, si necesitas instrucciones detalladas para implementar tus modelos TFLite Edge TPU, consulta los siguientes recursos:
-
Coral Edge TPU en una Raspberry Pi con Ultralytics YOLO26: Descubre cómo integrar Coral Edge TPU con Raspberry Pi para mejorar las capacidades de aprendizaje automático.
-
Ejemplos de código: Accede a ejemplos prácticos de implementación de TensorFlow Edge TPU para poner en marcha tus proyectos.
-
Ejecutar inferencias en Edge TPU con Python: Descubre cómo usar la API de Python de TensorFlow Lite para aplicaciones Edge TPU, con indicaciones de configuración y uso.
Resumen#
En esta guía, hemos aprendido a exportar modelos Ultralytics YOLO26 al formato TFLite Edge TPU. Si sigues los pasos anteriores, puedes aumentar la velocidad y la eficiencia de tus aplicaciones de visión artificial.
Para obtener más información sobre el uso, visita el sitio web oficial de Coral Edge TPU.
Además, para obtener más información sobre otras integraciones de Ultralytics YOLO26, visita nuestra página de guías de integración. Allí encontrarás recursos e información útiles.
Preguntas frecuentes#
Para exportar un modelo YOLO26 al formato TFLite Edge TPU, sigue estos pasos:
Usofrom ultralytics import YOLO # Carga un modelo YOLO26 model = YOLO("yolo26n.pt") # Exporta el modelo al formato TFLite Edge TPU model.export(format="edgetpu") # crea 'yolo26n_saved_model/yolo26n_full_integer_quant_edgetpu.tflite' # Carga el modelo TFLite Edge TPU exportado edgetpu_model = YOLO("yolo26n_saved_model/yolo26n_full_integer_quant_edgetpu.tflite") # Ejecutar inferencia results = edgetpu_model("https://ultralytics.com/images/bus.jpg")Para obtener todos los detalles sobre cómo exportar modelos a otros formatos, consulta nuestra guía de exportación.
Exportar modelos YOLO26 a TFLite Edge TPU ofrece varias ventajas:
- Rendimiento optimizado: Consigue un alto rendimiento de las redes neuronales con un consumo mínimo de energía.
- Menor latencia: Procesa los datos localmente con rapidez, sin depender de la nube.
- Mayor privacidad: El procesamiento local mantiene los datos de los usuarios privados y seguros.
Esto hace que sea ideal para aplicaciones de computación en el borde, donde los dispositivos tienen recursos computacionales y de energía limitados. Descubre por qué deberías exportar.
Sí, los modelos TensorFlow Lite Edge TPU se pueden implementar directamente en dispositivos móviles e integrados. Este enfoque permite ejecutar los modelos directamente en el hardware, con inferencias más rápidas y eficientes. Para ver ejemplos de integración, consulta nuestra guía para implementar Coral Edge TPU en Raspberry Pi.
Entre los casos de uso habituales de los modelos TFLite Edge TPU se incluyen:
- Cámaras inteligentes: Mejoran el análisis de imágenes y vídeos en tiempo real.
- Dispositivos IoT: Hacen posible la automatización del hogar inteligente y de la industria.
- Sanidad: Aceleran el diagnóstico y el procesamiento de imágenes médicas.
- Comercio minorista: Mejoran la gestión del inventario y el análisis del comportamiento de los clientes.
Estas aplicaciones se benefician del alto rendimiento y el bajo consumo de energía de los modelos TFLite Edge TPU. Descubre más escenarios de uso.
Si tienes problemas al exportar o implementar modelos TFLite Edge TPU, consulta nuestra guía de problemas habituales para obtener consejos de resolución. Esta guía abarca problemas comunes y sus soluciones para ayudarte a garantizar un funcionamiento correcto. Si necesitas más ayuda, visita nuestro Centro de ayuda.