Jeu de données DOTA avec OBB
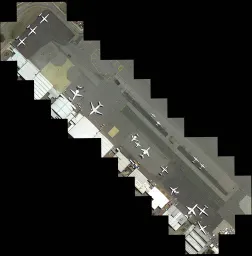
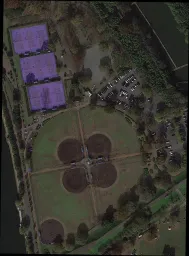
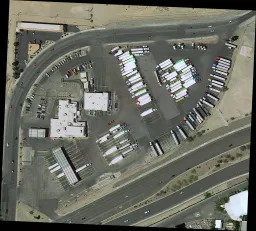
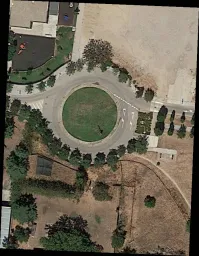
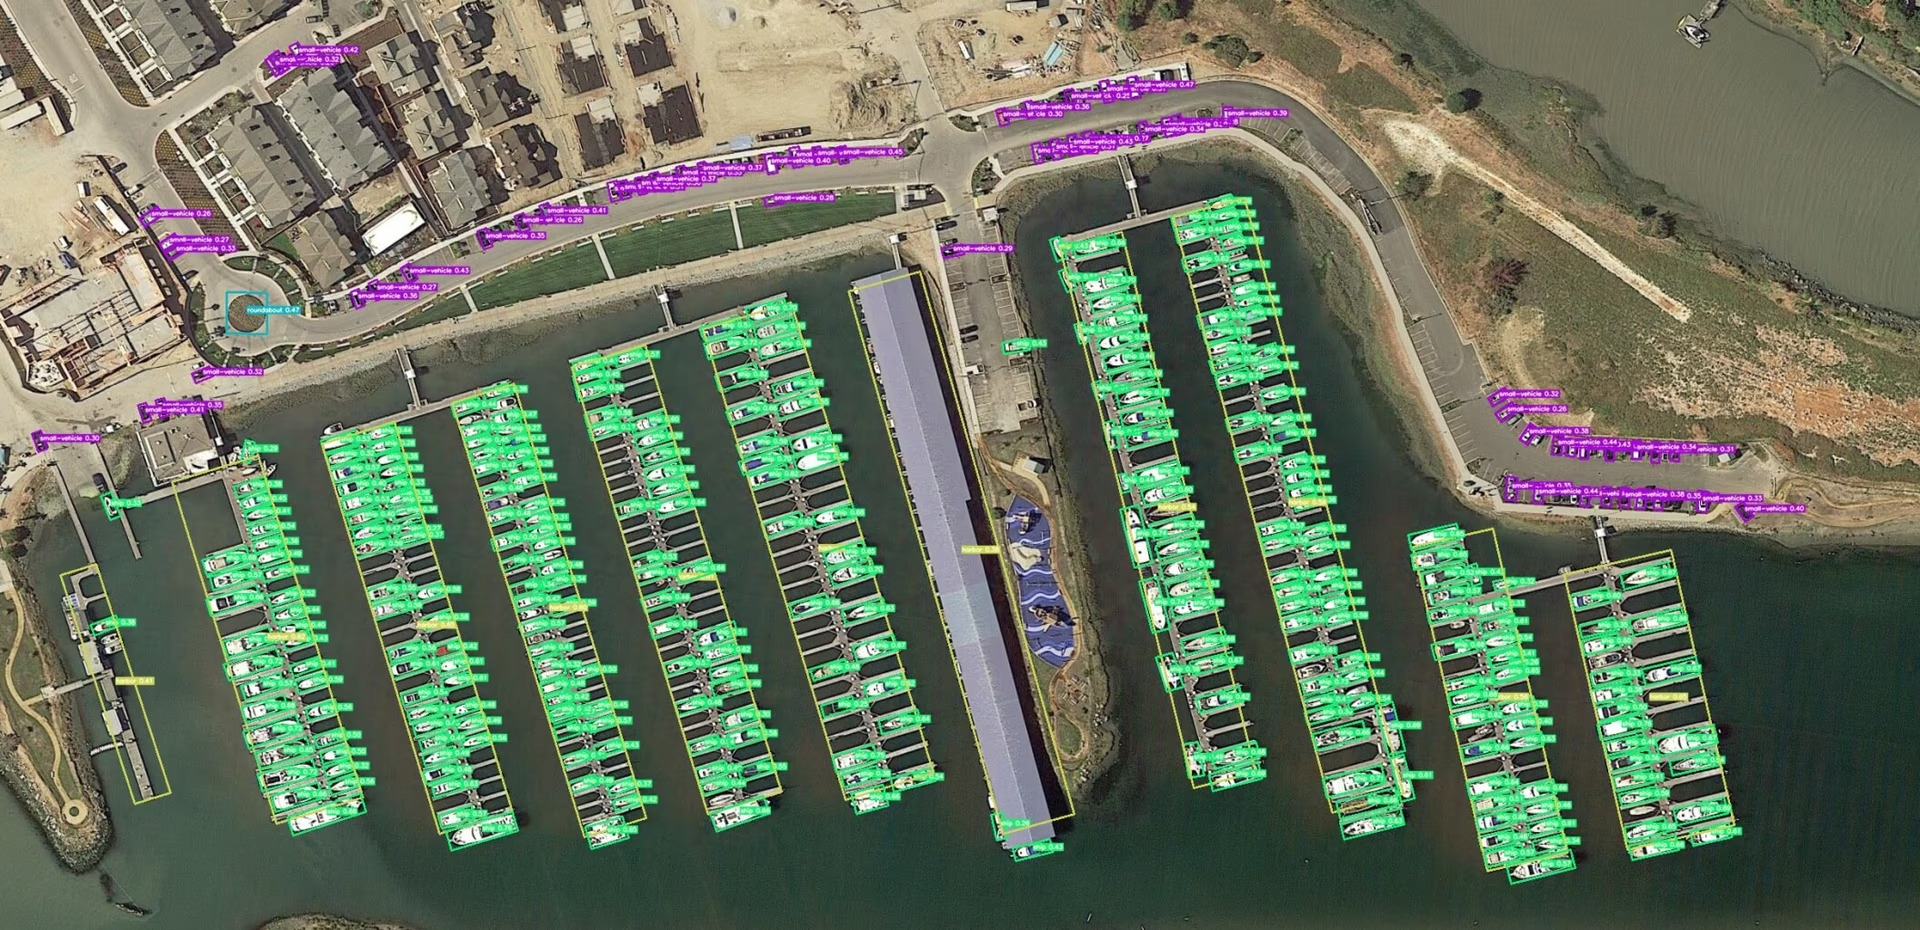
Le jeu de données DOTA est un benchmark à grande échelle pour la détection d'objets dans les images aériennes. Il existe en trois versions (v1.0, v1.5, v2.0) et comprend jusqu'à 1,7 M d'annotations de boîtes englobantes orientées (OBB) réparties sur 18 catégories, capturées par divers capteurs et plateformes aériens.
Explore les jeux de données DOTA v1.5 et DOTA v1.0, hébergés officiellement sur la plateforme Ultralytics, pour prévisualiser leurs annotations orientées, examiner les statistiques et les cloner en vue de l'entraînement.
Fonctionnalités clés#
Regarder : Comment entraîner Ultralytics YOLO sur le jeu de données DOTA pour détecter des boîtes englobantes orientées dans Google Colab
- Collecte réalisée avec divers capteurs et plateformes, avec des images dont la taille varie de 800 × 800 à 20 000 × 20 000 pixels.
- Comprend plus de 1,7 M de boîtes englobantes orientées réparties sur 18 catégories.
- Permet la détection d'objets à plusieurs échelles grâce à la grande diversité des tailles d'objets dans chaque image.
- Les instances sont annotées par des experts à l'aide de quadrilatères arbitraires (8 degrés de liberté), qui représentent des objets de différentes échelles, orientations et formes.
Versions du jeu de données#
DOTA-v1.0#
- Contient 15 catégories courantes.
- Comprend 2 806 images et 188 282 instances.
- Répartition : 1/2 pour l'entraînement (1 411 images), 1/6 pour la validation (458 images) et 1/3 pour le test (937 images).
DOTA-v1.5#
- Comprend les mêmes images que DOTA-v1.0.
- Les très petites instances (moins de 10 pixels) sont également annotées.
- Ajout d'une nouvelle catégorie : « grue porte-conteneurs ».
- Au total, 403 318 instances.
- Publiée pour le DOAI Challenge 2019 sur la détection d'objets dans les images aériennes.
DOTA-v2.0#
- Images issues de Google Earth, du satellite GF-2 et d'autres sources d'images aériennes.
- Contient 18 catégories courantes.
- Comprend 11 268 images et 1 793 658 instances.
- Nouvelles catégories ajoutées : « aéroport » et « héliport ».
- Répartition des images :
- Entraînement : 1 830 images avec 268 627 instances.
- Validation : 593 images avec 81 048 instances.
- Test-dev : 2 792 images avec 353 346 instances.
- Test-challenge : 6 053 images avec 1 090 637 instances.
Structure du jeu de données#
DOTA présente une structure adaptée aux défis de détection d’objets avec OBB :
- Images : Une vaste collection d’images aériennes haute résolution couvrant des terrains et des structures variés.
- Boîtes englobantes orientées : Des annotations sous forme de rectangles pivotés qui encadrent les objets quelle que soit leur orientation, idéales pour détecter des objets comme les avions, les navires et les bâtiments.
Applications#
DOTA sert de benchmark pour entraîner et évaluer des modèles conçus pour l’analyse d’images aériennes. Ses annotations de boîtes englobantes orientées en font un test exigeant pour les modèles de détection d’objets sur des cibles aériennes inclinées et densément regroupées. Le jeu de données est largement utilisé en télédétection, en surveillance et en suivi environnemental.
Fichier YAML du jeu de données#
Un fichier YAML de jeu de données définit les chemins d’accès aux images et aux étiquettes, les noms des classes et d’autres métadonnées importantes. Ultralytics gère des fichiers YAML officiels pour les deux versions les plus utilisées :
Utilise le fichier YAML correspondant à la version que tu as téléchargée, ou crée un fichier YAML personnalisé si tu travailles avec DOTA-v2 ou un autre dérivé. Les deux versions sont téléchargées automatiquement (2 Go) depuis les ressources GitHub d’Ultralytics lors du premier entraînement.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA 1.0 dataset https://captain-whu.github.io/DOTA/index.html for object detection in aerial images by Wuhan University
# Documentation: https://docs.ultralytics.com/datasets/obb/dota-v2
# Example usage: yolo train model=yolov8n-obb.pt data=DOTAv1.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── DOTAv1 ← downloads here (2 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: DOTAv1 # dataset root dir
train: images/train # train images (relative to 'path') 1411 images
val: images/val # val images (relative to 'path') 458 images
test: images/test # test images (optional) 937 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/DOTAv1.zip
Découper les images DOTA#
Les images brutes dépassent souvent les 10 000 pixels de côté ; il est donc recommandé de les découper avant de fournir les données à YOLO. Utilise la fonction d’aide ci-dessous pour découper les images sources en vignettes chevauchantes de 1024 × 1024 à plusieurs échelles, tout en synchronisant les annotations.
from ultralytics.data.split_dota import split_test, split_trainval

# Découper les jeux train et val, avec les étiquettes.
split_trainval(
    data_root="path/to/DOTAv1.0/",
    save_dir="path/to/DOTAv1.0-split/",
    rates=[0.5, 1.0, 1.5],  # multiscale
    gap=500,
)
# Découper le jeu test, sans étiquettes.
split_test(
    data_root="path/to/DOTAv1.0/",
    save_dir="path/to/DOTAv1.0-split/",
    rates=[0.5, 1.0, 1.5],  # multiscale
    gap=500,
)Organise le répertoire de sortie selon la structure YOLO standard (images/train, labels/train, etc.) afin de pouvoir le référencer directement depuis le fichier YAML du jeu de données.
Utilisation#
Pour entraîner un modèle YOLO26n-obb sur le jeu de données DOTA v1, utilise les extraits de code suivants. Consulte toujours la documentation de ton modèle pour obtenir la liste complète des arguments disponibles. Si tu souhaites d’abord expérimenter avec un sous-ensemble plus petit, tu peux utiliser le jeu de données DOTA8, qui ne contient que 8 images pour des tests rapides et peut être parcouru sur Ultralytics Platform.
Toutes les images et les annotations associées du jeu de données DOTAv1 sont réservées à un usage académique ; leur usage commercial est interdit. Ultralytics interprète ces restrictions comme s’appliquant au jeu de données source, et non aux poids de modèles préentraînés ou ajustés. Consulte les conditions de DOTA pour l’usage que tu souhaites en faire.
from ultralytics import YOLO

# Charger un modèle YOLO26n-OBB préentraîné
model = YOLO("yolo26n-obb.pt")

# Entraîner le modèle sur le jeu de données DOTAv1
results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=1024)
Données et annotations d’exemple#
L’exemple ci-dessous montre des scènes et des annotations DOTA typiques :
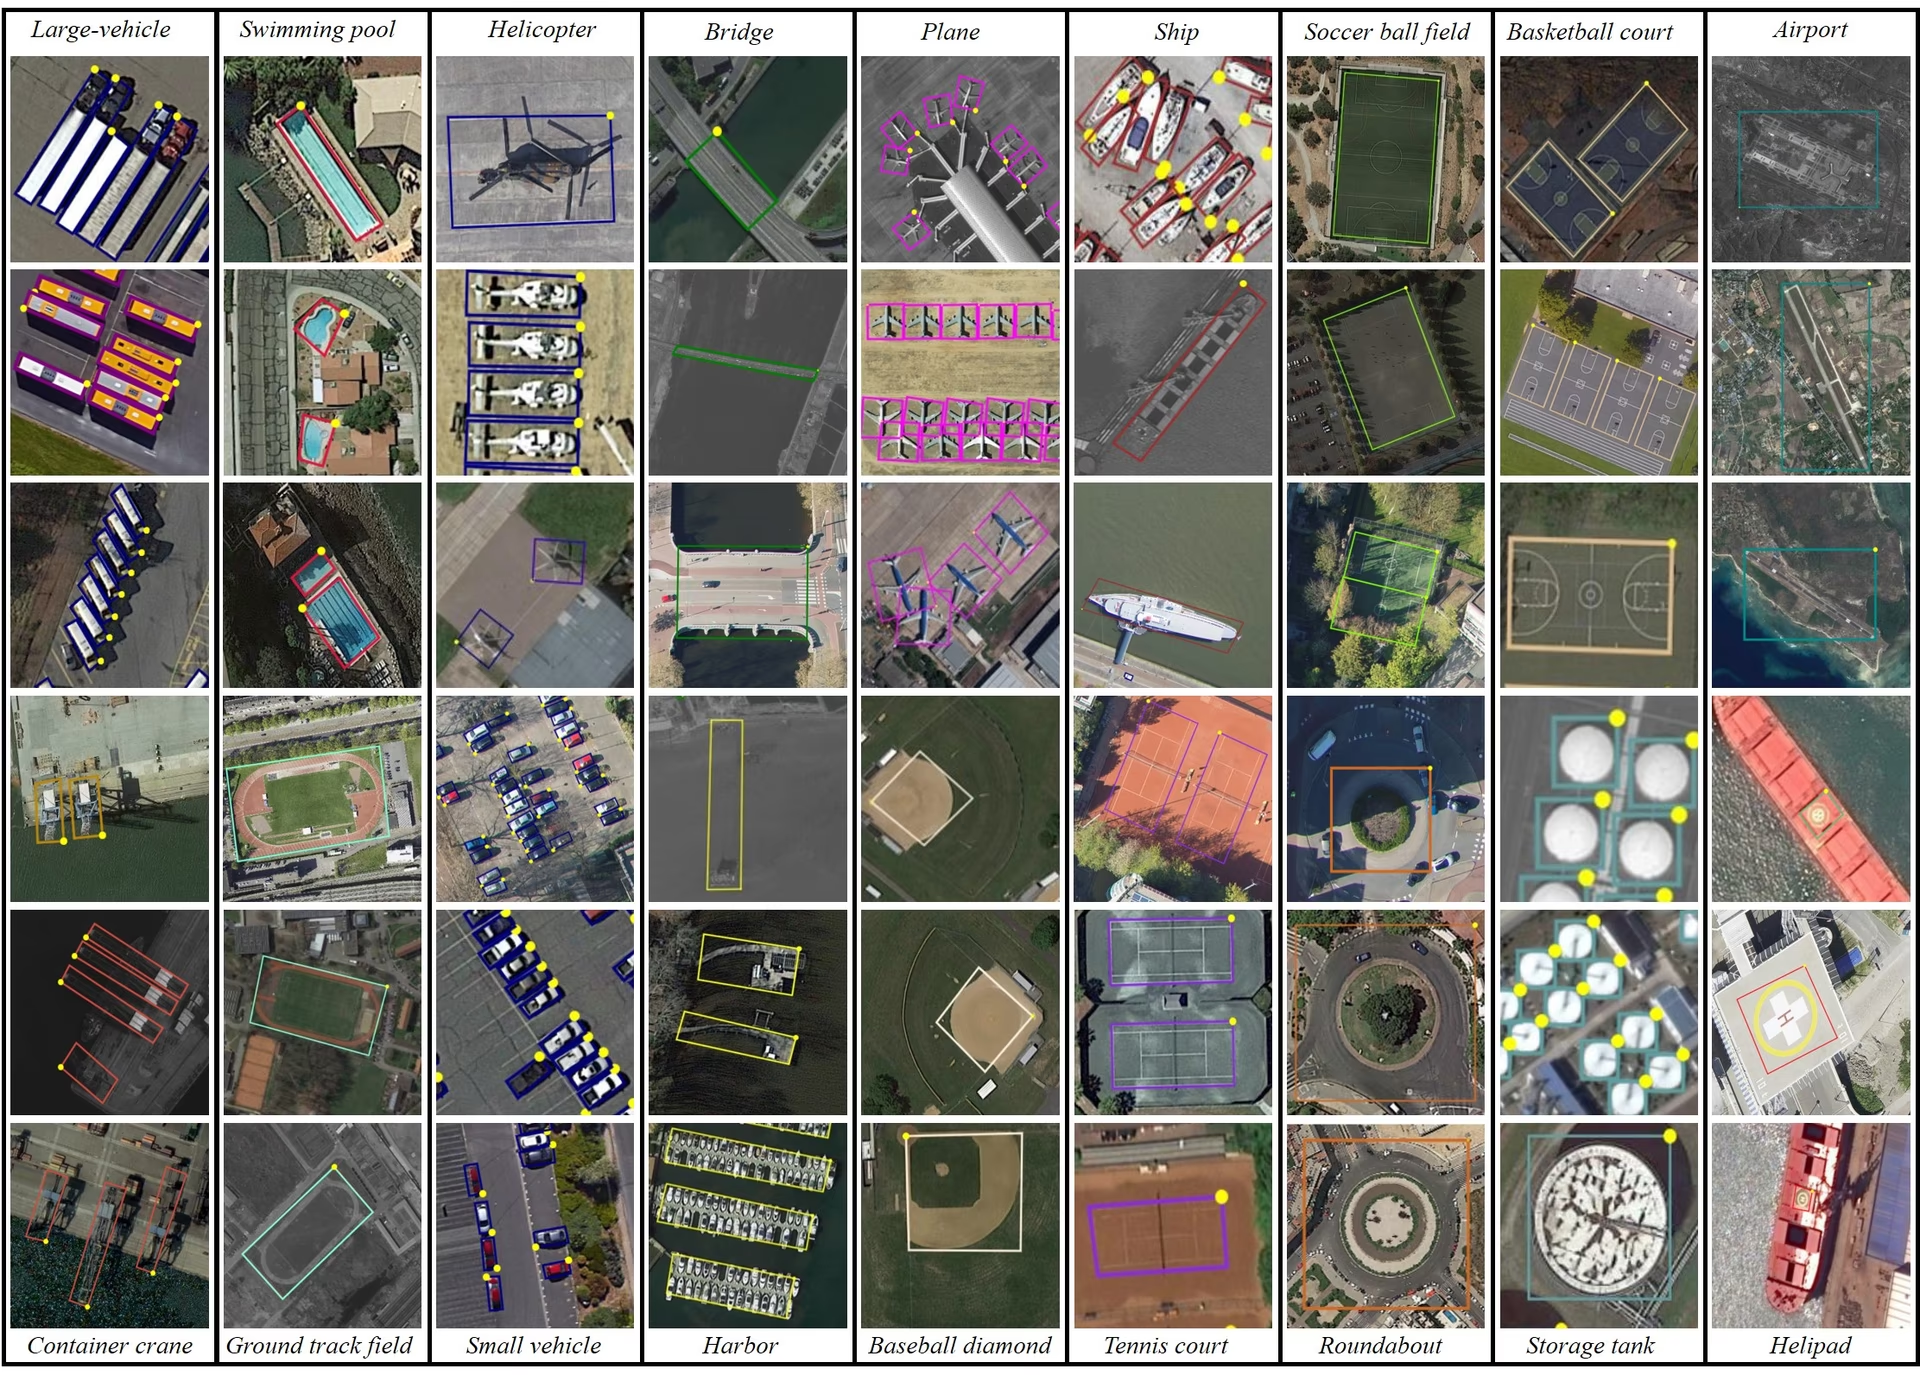
- Exemples DOTA : Cet aperçu souligne la complexité des scènes aériennes et l’importance des annotations de boîtes englobantes orientées, qui capturent les objets dans leur orientation naturelle.
Ces scènes mettent en évidence les défis de détection propres aux images aériennes. DOTA-v2.0 est largement utilisé dans les projets de télédétection et de surveillance aérienne grâce à ses annotations complètes et à la diversité de ses catégories d’objets.
Citations et remerciements#
Si tu utilises DOTA dans tes travaux, cite les articles de recherche pertinents :
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Nous remercions l’équipe à l’origine des jeux de données DOTA pour leur préparation. Pour consulter tous les détails du jeu de données, rends-toi sur le site officiel de DOTA.
FAQ#
Le jeu de données DOTA est un jeu de données spécialisé dans la détection d’objets dans les images aériennes. Il comprend des boîtes englobantes orientées (OBB) et des images annotées provenant de scènes aériennes variées. La diversité des orientations, des échelles et des formes d’objets dans DOTA, avec ses 1,7 million d’annotations et ses 18 catégories, en fait un jeu de données idéal pour développer et évaluer des modèles d’analyse d’images aériennes, notamment pour la surveillance, le suivi environnemental et la gestion des catastrophes.
DOTA utilise des boîtes englobantes orientées (OBB) pour les annotations. Elles sont représentées par des rectangles pivotés qui délimitent les objets quelle que soit leur orientation. Cette méthode garantit une localisation précise des objets, qu’ils soient petits ou inclinés. Les images multirésolution du jeu de données, qui vont de 800 × 800 à 20 000 × 20 000 pixels, permettent également de détecter efficacement les objets petits comme grands. Cette approche est particulièrement utile pour les images aériennes, où les objets apparaissent selon différents angles et à différentes échelles.
Pour entraîner un modèle sur le jeu de données DOTA, tu peux utiliser l’exemple suivant avec Ultralytics YOLO :
Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle YOLO26n-OBB préentraîné model = YOLO("yolo26n-obb.pt") # Entraîner le modèle sur le jeu de données DOTAv1 results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=1024)Pour en savoir plus sur le découpage et le prétraitement des images DOTA, consulte la section sur le découpage des images DOTA.
- DOTA-v1.0 : Comprend 15 catégories courantes réparties sur 2 806 images et 188 282 instances. Le jeu de données est divisé en ensembles d’entraînement, de validation et de test.
- DOTA-v1.5 : Reprend DOTA-v1.0 en annotant les très petites instances (moins de 10 pixels) et en ajoutant une nouvelle catégorie, « grue portuaire », pour un total de 403 318 instances.
- DOTA-v2.0 : Étend encore le jeu de données avec des annotations provenant de Google Earth et du satellite GF-2. Il comprend 11 268 images et 1 793 658 instances, ainsi que de nouvelles catégories comme « aéroport » et « héliport ».
Pour une comparaison détaillée et plus d’informations, consulte la section sur les versions du jeu de données.
Les images DOTA peuvent être très volumineuses ; on les découpe donc en images de plus petite résolution pour faciliter l’entraînement. Voici un extrait Python pour découper les images :
Exemplefrom ultralytics.data.split_dota import split_test, split_trainval # découper les jeux train et val, avec les étiquettes. split_trainval( data_root="path/to/DOTAv1.0/", save_dir="path/to/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, ) # découper le jeu test, sans étiquettes. split_test( data_root="path/to/DOTAv1.0/", save_dir="path/to/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, )Ce processus améliore l’efficacité de l’entraînement et les performances du modèle. Pour obtenir des instructions détaillées, consulte la section sur le découpage des images DOTA.


Commentaires17
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
XWP-PPP
May I ask how you converted the inference results from YOLOV8 OBB into inference results that can be uploaded to DOTA's Task 1 server? I saved the final inference results of the model in the form of xyxyxy and uploaded them via email. However, the mAP results provided on YOLO's official website differ significantly. I would like to know the reason for this. Can you provide me with a conversion code to convert the test image set into a result that can be uploaded to DOTA's Task 1 server? Thank you very much for your help!
1 Paula DerrengerUltralytics(modifié)
@XWP-PPP hi there!
DOTA's Task 1 server expects a zip of one text file per class (
Task1_plane.txt,Task1_storage-tank.txt, ...), where each line isimgname score x1 y1 x2 y2 x3 y3 x4 y4, with the image name given without extension. OBB results are stored inresult.obb, notresult.boxes. Here is a snippet that builds those files:import shutil from collections import defaultdict from pathlib import Path from ultralytics import YOLO # Load your trained YOLO26-OBB model model = YOLO("path/to/your/yolo26n-obb.pt") # Collect one DOTA Task1 line per detection: imgname score x1 y1 x2 y2 x3 y3 x4 y4 (pixels) category_results = defaultdict(list) for r in model.predict(source="path/to/test/images", stream=True): img_name = Path(r.path).stem for cls, conf, pts in zip(r.obb.cls.int().tolist(), r.obb.conf.tolist(), r.obb.xyxyxyxy.flatten(1).tolist()): coords = " ".join(f"{p:.1f}" for p in pts) category_results[f"Task1_{model.names[cls].replace(' ', '-')}.txt"].append(f"{img_name} {conf:.6f} {coords}\n") # Save one file per category and zip the submission folder output_dir = Path("submission") output_dir.mkdir(exist_ok=True) for category_file, lines in category_results.items(): (output_dir / category_file).write_text("".join(lines)) shutil.make_archive("submission", "zip", output_dir)Upload
submission.zipto the DOTA Task 1 server. If your mAP differs from your local validation, check that image names match the test set and that the coordinates are in pixels of the original (unsplit) images. For more details, see the DOTA Dataset Documentation. Happy coding! 😊
Taufiq-Ahmed-pranto
Hi, I want to use the DOTA dataset only for YOLOv11 Nano. I don't want to use the model with oriented bounding boxes (OBB). What is the procedure?
 Jie Liu
I have download dotav1 form
https://github.com/ultralytics/assets/releases/download/v0.0.0/DOTAv1.zipand use script split dataset.from ultralytics.data.split_dota import split_test, split_trainval # split train and val set, with labels. split_trainval( data_root="/dataset/coco/DOTAv1", save_dir="/dataset/coco/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, ) # split test set, without labels. split_test( data_root="/dataset/coco/DOTAv1/", save_dir="/dataset/coco/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, )how to reproduce yolov11 obb result, please show me the command like
yolo train model=ultralytics-8.3.13/ultralytics/cfg/models/11/yolo11n-obb.yaml data=DOTAv1/DOTAv1.yaml epochs=500 batch=32*4 imgsz=640 device=4,5,6,7 cache=disk amp=True Glenn JocherUltralytics(modifié)
@keeper-jie for training YOLO26-OBB on DOTAv1 after splitting, use this command with your 4 GPUs:
yolo obb train data=DOTAv1.yaml model=yolo26n-obb.pt epochs=500 imgsz=1024 batch=128 device=4,5,6,7Key parameters from our DOTA documentation:
imgsz=1024(matches dataset's multiscale split)- Use official model name
yolo26n-obb.ptrather than YAML path - Batch size 128 (32*4 GPUs) via
batch=128
Ensure your dataset YAML paths point to the split images directory.
huynhkhoa44
I have labeled data in YOLOv8 object detection format, our label data format is already rotated rectangles to the correct angle of the object, however since it is in YOLOv8 object detection format, the "angle" parameter is missing. I no longer keep the label folder on CVAT so I cannot export to a different label format. Is there a way to add the angle value from the 4 pre-existing <x_center> <y_center> values?
- Glenn JocherUltralytics
To add the angle value from your existing YOLOv8 labels, you'll need to calculate it based on the coordinates. Unfortunately, without the original CVAT labels, this requires manual computation or using a tool that supports angle annotations. For guidance on datasets with oriented bounding boxes, you can refer to the DOTA dataset documentation at https://docs.ultralytics.com/datasets/obb/dota-v2/.
jack-ready
Recently, I've been using YOLOv8 to train the DOTAv1 dataset and encountered some issues. I was wondering if I could seek advice. 1.To train the DOTA dataset, we split the original DOTA images with high-resolution into images with 1024x1024. I noticed that the provided segmentation code provides three sizes, rates=[0.5, 1.0, 1.5]. In order to obtain 1024×1024 images, it seems that we should choose rates=1, but I noticed that some images in the segmentation results of the validation set are smaller than 1024×1024, such as 1024×1023, 824*1024, etc. What is the reason for this?Will it affect the experiment? 2.Another issue arises during the training process. I noticed that the training process conducts validation after each epoch. I attempted to disable validation by setting val=False, but it seems to have no effect. What could be the reason for this? The training code snippet is as follows: results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=10, workers=0, val=False). Additionally, during validation, it seems that the images are not being resized to 640. Printing the results in the code yields torch.Size([10, 3, 672, 672]), whereas during the training process, images are correctly resized to 640. Could someone help me understand this?
- Glenn JocherUltralytics(modifié)
@jack-ready hi there!
Thank you for reaching out with your questions regarding training the DOTA dataset with YOLOv8. Let's address each of your concerns:
-
Image Splitting and Sizes: When splitting high-resolution DOTA images into 1024x1024 segments using
rates=[0.5, 1.0, 1.5], you might notice some resulting images are slightly smaller than 1024x1024 (e.g., 1024x1023 or 824x1024). This occurs due to the way the splitting algorithm handles the edges of the original images. If the original image dimensions are not perfectly divisible by 1024, the last segment in each row or column might be smaller. This should not significantly affect your experiment as long as the majority of your data maintains the expected size. However, you can ensure consistency by padding these smaller images to 1024x1024 if necessary. -
Disabling Validation: The
val=Falseargument should indeed disable validation during training. If it doesn't seem to work, please ensure you are using the latest version of the Ultralytics package. You can update it using:pip install --upgrade ultralyticsIf the issue persists, providing a minimum reproducible example would be very helpful for us to diagnose the problem. You can find guidance on creating one here: Minimum Reproducible Example.
-
Image Resizing During Validation: The discrepancy in image sizes during validation (e.g.,
torch.Size([10, 3, 672, 672])instead of 640) might be due to the model's internal resizing logic. Ensure that theimgszparameter is correctly set for both training and validation. Validation uses the sameimgszas training, so set it explicitly in your training script:results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=10, workers=0, val=True)
I hope this helps! If you have any further questions or need additional assistance, feel free to ask. Happy training! 🚀
-
Thank you very much for your help. I have another question regarding the YOLOV8 training on the DOTA v1.0 dataset. I would like to know how to set the training parameters, such as learning rate, optimizer, and loss function. When I try to reproduce the results, my mAP50 is about 74%, but it does not reach 78%. I would greatly appreciate any assistance you can provide.Below is my training code. from ultralytics import YOLO model = YOLO("yolov8n-obb.yaml") model.load("yolov8n-obb.pt") model = YOLO("yolov8n-obb.yaml").load("yolov8n.pt") results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=48, workers=0,project="runs/DOTAV1.0",val=True,resume=True)
- Glenn JocherUltralytics(modifié)
Hi there! Glad to help with your training setup. To fine-tune your training parameters for better mAP50 results, you can adjust the learning rate, optimizer, and loss function. For instance, you might try a lower learning rate or switch to a different optimizer like Adam. Here's a quick example:
from ultralytics import YOLO

model = YOLO("yolo26n-obb.yaml").load("yolo26n-obb.pt")
results = model.train(
    data="DOTAv1.yaml",
    epochs=100,
    imgsz=640,
    batch=48,
    workers=0,
    project="runs/DOTAV1.0",
    val=True,
    lr0=0.001,  # Adjust learning rate
    optimizer='Adam'  # Change optimizer
)
Ensure you're using the latest version of the Ultralytics package to avoid any bugs. If you still face issues, feel free to share more details. Happy training! 🚀
Tintin26100
How can I find the number of instances per class in DOTA v1.5 ? I've been searching for this information for a moment and I can't find any answers
- Paula DerrengerUltralytics
@Tintin26100 hello!
The number of instances per class in DOTA v1.5 isn't directly listed in the dataset's summary. However, you can obtain this information by analyzing the annotation files provided with the dataset. Each object instance in these files is labeled with a class, and you can count the number of times each class appears.
If you need further guidance on how to process these annotation files or any other assistance with the DOTA dataset, feel free to ask!
Happy coding! 😊
Hi, thanks for your quick answer, I will gladly accept your help because I don't really know what to do to extract those informations, where do you find the annotation files ? Is it on the github ? If it is what's it's path ? Thanks for the time you spend helping
- Paula DerrengerUltralytics
@Tintin26100 hello!
The annotation files for the DOTA dataset are typically included within the dataset download itself. These files contain the details for each instance, including class labels and oriented bounding box coordinates.
For the DOTA v1.5 dataset, you can find these files in the dataset directory after you download it from the official DOTA dataset page or the provided download link in the dataset's YAML configuration file. The path to the annotations will usually be structured under the
labelsorannotationsdirectory within the main dataset folder.If you've already downloaded the dataset, you should look for
.txtor.jsonfiles corresponding to each image in the dataset, which contain the annotations. If you need further assistance navigating these files or extracting specific data, feel free to ask!Thank you for reaching out, and happy analyzing! 😊
hencai
how to test DOTA datatests online using YOLOv8-obb? somebody help me ?
- Glenn JocherUltralytics(modifié)
Hey there! 😊 Testing the DOTA dataset online using YOLO26-obb is quite straightforward. If you've already prepared your dataset according to the Ultralytics guidelines and split the images, here's a simple example to get you started with training:
# Train a YOLO26n-OBB model on the DOTA v1 dataset
yolo obb train data=DOTAv1.yaml model=yolo26n-obb.pt epochs=100 imgsz=640
This command uses DOTA v1 and the corresponding
.yamlfile (DOTAv1.yaml) describing your dataset paths and classes. Adjustepochsandimgszbased on your needs.Just make sure to check out the DOTA dataset page on Ultralytics docs for more info on dataset preparation and additional configurations! Happy detecting! 🚀