Comment tester des modèles de vision par ordinateur#
Introduction#
Le test d'un modèle permet de vérifier comment un modèle entraîné se comporte sur des données réelles jamais vues — avec des objets en mouvement, mal éclairés ou partiellement masqués, plutôt que sur un jeu de données de référence soigneusement sélectionné. Alors que l'évaluation du modèle mesure des métriques sur un jeu de données annoté, le test vérifie que le comportement appris par le modèle correspond aux objectifs de ton application avant le déploiement. Ce guide explique comment préparer les données de test, tester les modèles Ultralytics YOLO26 et repérer le surapprentissage, le sous-apprentissage et les fuites de données.
À regarder : Comment tester les modèles d’apprentissage automatique | Éviter les fuites de données en vision par ordinateur 🚀
Test et évaluation du modèle#
Le test et l'évaluation d'un modèle sont deux étapes distinctes d'un projet de vision par ordinateur. L'évaluation mesure les performances à l'aide de métriques sur un jeu de données annoté ; le test vérifie si le comportement appris par le modèle reste fiable dans des conditions proches de celles du déploiement.
Supposons que tu aies entraîné un modèle de vision par ordinateur pour reconnaître les chats et les chiens et que tu souhaites le déployer dans une animalerie afin de surveiller les animaux. Pendant la phase d'évaluation, tu utilises un jeu de données annoté pour calculer des métriques comme l'exactitude, la précision et le rappel. Par exemple, le modèle pourrait atteindre une exactitude de 98 % pour distinguer les chats des chiens dans un jeu de données donné.
Après l'évaluation, tu testes le modèle sur des images provenant d'une animalerie pour voir dans quelle mesure il reconnaît les chats et les chiens dans des conditions plus variées et réalistes. Tu vérifies s'il peut correctement identifier les chats et les chiens lorsqu'ils bougent, dans différentes conditions d'éclairage ou lorsqu'ils sont partiellement cachés par des objets comme des jouets ou des meubles. Le test vérifie que le modèle se comporte comme prévu en dehors de l'environnement d'évaluation contrôlé.
Préparer le test du modèle#
Les jeux de données de vision par ordinateur sont généralement divisés en ensembles d'entraînement et de test pour simuler des conditions réelles : les données d'entraînement servent à enseigner au modèle, tandis que les données de test vérifient son comportement sur des exemples qu'il n'a jamais vus. L'Ultralytics Platform centralise l'organisation et l'annotation des jeux de données, ce qui facilite la création d'un ensemble de test annoté.
- Représentation réaliste : les données de test jamais vues doivent être similaires à celles que le modèle traitera après son déploiement. Cela donne une image réaliste des capacités du modèle.
- Taille suffisante : le jeu de données de test doit être assez volumineux pour fournir des informations fiables sur les performances du modèle.
Comment tester un modèle YOLO26#
Le test d'un modèle YOLO26 entraîné repose sur deux processus complémentaires : la validation sur une partition de test annotée pour obtenir des métriques quantitatives, et la prédiction sur de nouvelles images pour examiner qualitativement le comportement du modèle.
Valider sur une partition de test annotée#
Le mode validation compare les prédictions du modèle aux annotations de vérité terrain et indique la précision, le rappel, mAP50 et mAP50-95 pour les modèles de détection. Il enregistre également des éléments visuels comme une matrice de confusion et une courbe précision-rappel, qui t'aident à repérer les domaines où le modèle n'est peut-être pas assez performant.
from ultralytics import YOLO

# Charger un modèle préentraîné ou ton propre point de contrôle entraîné, par exemple « path/to/best.pt »
model = YOLO("yolo26n.pt")

# Valider ; ajoute split="test" si le fichier YAML de ton jeu de données définit une partition de test
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Par défaut, la validation s'exécute sur la partition val du jeu de données. Pour mesurer les performances sur un ensemble de test réservé, définis une partition test: dans le fichier YAML de ton jeu de données et passe split="test".
Effectuer des prédictions sur de nouvelles images#
Le mode prédiction exécute le modèle sur de nouvelles données jamais vues, sans nécessiter d'annotations. Il ne produit pas de métriques de performance, mais l'enregistrement des résultats annotés te permet d'examiner le comportement du modèle sur des images réelles — par exemple, en traitant d'un seul coup un dossier entier d'images de test.
from ultralytics import YOLO

# Charger un modèle préentraîné ou ton propre point de contrôle entraîné, par exemple « path/to/best.pt »
model = YOLO("yolo26n.pt")

# Effectuer des prédictions sur un dossier d'images de test et enregistrer les résultats annotés
results = model.predict(source="path/to/test_images", save=True)Pour vérifier si YOLO26 convient à ton application avant d'investir dans un entraînement personnalisé, lance le mode prédiction avec un point de contrôle préentraîné sur tes propres images. Les modèles sont préentraînés sur des jeux de données comme COCO ; les résultats donnent donc rapidement une idée des performances possibles du modèle dans ton contexte spécifique.
Mode validation ou mode prédiction#
| Mode | Rôle | Nécessite des annotations | Sortie |
|---|---|---|---|
| Validation | Quantifier les performances par rapport à la vérité terrain | Oui | Précision, rappel, mAP50, mAP50-95, matrice de confusion, courbes précision-rappel |
| Prédiction | Examiner le comportement du modèle sur de nouvelles données non annotées | Non | Images annotées et résultats des prédictions, sans métriques |
Comment analyser les résultats des tests#
Une fois les prédictions et les métriques obtenues, cherche à comprendre où et pourquoi le modèle échoue :
- Images mal classées : identifie et examine les images que le modèle a mal classées afin de comprendre où il se trompe.
- Analyse des erreurs : effectue une analyse approfondie des erreurs pour comprendre leur nature (par exemple, faux positifs ou faux négatifs) et leurs causes possibles.
- Biais et équité : vérifie la présence de biais dans les prédictions du modèle. Assure-toi que le modèle est aussi performant sur différents sous-ensembles des données, en particulier si ceux-ci comprennent des attributs sensibles comme la race, le genre ou l'âge.
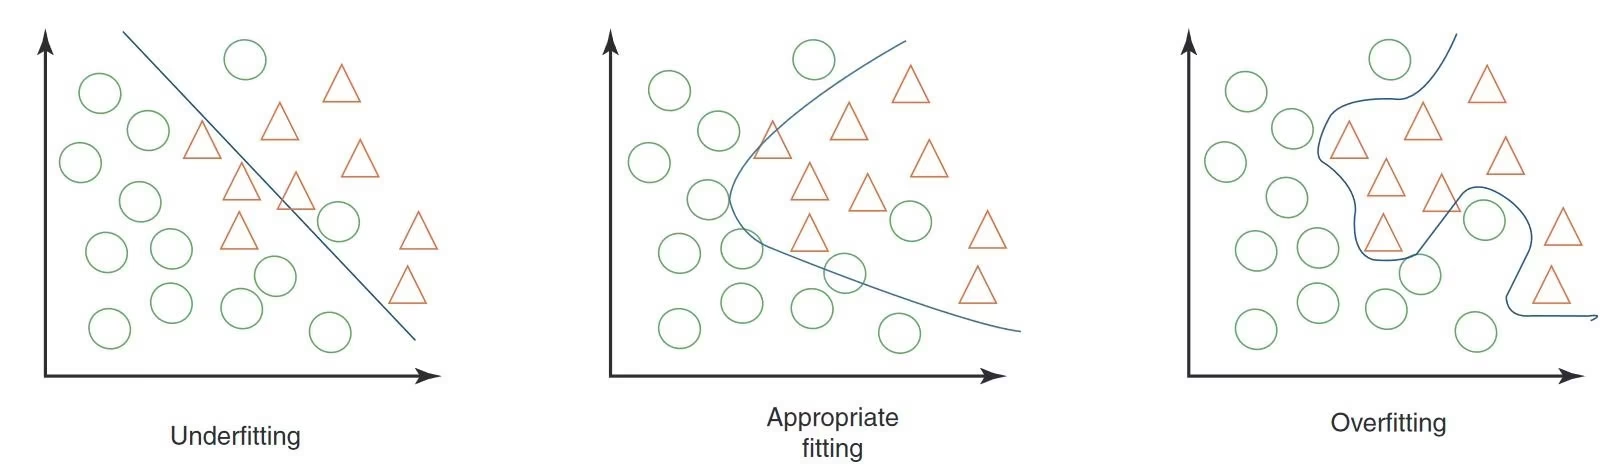
Surapprentissage et sous-apprentissage en apprentissage automatique#
Lors du test d'un modèle d'apprentissage automatique, surtout en vision par ordinateur, il est important de surveiller le surapprentissage et le sous-apprentissage. Ces problèmes peuvent fortement nuire aux performances du modèle sur de nouvelles données.
| Problème | Signes courants | Comment y remédier |
|---|---|---|
| Surapprentissage | Exactitude élevée sur les données d'entraînement, mais faible sur les données de validation ; sensibilité excessive aux petits changements ou aux détails non pertinents des images | Applique des techniques de régularisation, comme l'abandon de neurones, augmente la taille du jeu de données d'entraînement ou simplifie l'architecture du modèle |
| Sous-apprentissage | Faible exactitude, même sur l'ensemble d'entraînement ; incapacité persistante à reconnaître des caractéristiques ou des objets évidents | Utilise un modèle plus complexe, fournis des caractéristiques plus pertinentes ou augmente le nombre d'époques d'entraînement |
L'essentiel est de trouver un équilibre pour que le modèle soit performant sur les jeux de données d'entraînement et de validation. Le suivi régulier des métriques et l'examen visuel des prédictions pendant les tests t'aident à repérer toute dérive vers l'un ou l'autre de ces extrêmes.
Fuite de données en vision par ordinateur et comment l'éviter#
Une fuite de données se produit lorsque des informations provenant de l'extérieur du jeu de données d'entraînement sont utilisées par inadvertance pour entraîner le modèle. Le modèle peut sembler très précis pendant l'entraînement, mais il ne sera pas performant sur de nouvelles données jamais vues en cas de fuite.
Les fuites peuvent être difficiles à repérer et proviennent souvent de biais cachés dans les données d'entraînement :
| Type de biais | Manifestation |
|---|---|
| Biais lié à la caméra | Les angles, l'éclairage, les ombres et les mouvements de caméra différents introduisent des motifs indésirables |
| Biais lié aux superpositions | Les logos, horodatages ou autres éléments superposés aux images induisent le modèle en erreur |
| Biais lié aux polices et aux objets | Les polices ou les objets spécifiques qui apparaissent fréquemment dans certaines classes faussent l'apprentissage du modèle |
| Biais spatial | Les déséquilibres entre premier plan et arrière-plan, dans la répartition des boîtes englobantes et dans l'emplacement des objets ont une incidence sur l'entraînement |
| Biais lié aux annotations et au domaine | Des étiquettes incorrectes ou des changements de types de données entraînent une fuite de données |
Comment détecter et éviter les fuites de données#
Pour détecter les fuites de données, vérifie si les résultats du modèle sont étonnamment bons, si une caractéristique est beaucoup plus importante que les autres, si les décisions du modèle sont intuitivement cohérentes, et si les données ont été divisées correctement avant tout traitement.
Pour les éviter, utilise un jeu de données diversifié comprenant des images ou des vidéos provenant de différentes caméras et de différents environnements, et examine soigneusement tes données pour repérer les biais cachés — par exemple, si tous les échantillons positifs ont été collectés à un moment précis de la journée. Éviter les fuites de données rend tes modèles de vision par ordinateur plus fiables dans des situations réelles.
Que faire après les tests du modèle#
Après avoir testé ton modèle, les étapes suivantes dépendent des résultats. Si ton modèle fonctionne bien, tu peux le déployer dans un environnement réel. Si les résultats ne sont pas satisfaisants, tu devras apporter des améliorations. Cela peut consister à analyser les erreurs, à recueillir davantage de données, à améliorer la qualité des données, à ajuster les hyperparamètres et à réentraîner le modèle.
Conclusion#
Des tests rigoureux du modèle — validation sur un jeu de test mis de côté, prédictions sur des images du monde réel et vérification du surapprentissage et des fuites de données — transforment un modèle bien évalué en un modèle fiable. Corrige les problèmes révélés par les tests avant le déploiement, et ton modèle aura bien plus de chances de fonctionner comme prévu en production. Si tu as des questions en cours de route, pose-les à la communauté sur le dépôt GitHub d’Ultralytics ou le serveur Discord d’Ultralytics.
FAQ#
L’évaluation d’un modèle mesure ses performances à l’aide de métriques sur un jeu de données étiqueté, tandis que les tests vérifient le comportement du modèle sur de nouvelles données inédites ressemblant aux conditions de déploiement. L’évaluation produit des valeurs comme la précision et le mAP à partir d’un jeu de données contrôlé ; les tests révèlent si le comportement appris résiste à des variations d’éclairage, de mouvement ou d’occlusion. Consulte Tests de modèle et évaluation de modèle pour voir un exemple détaillé.
Utilise le mode de prédiction et indique le chemin d’un dossier comme
source— YOLO26 traite chaque image du dossier et peut enregistrer les résultats annotés pour examen. Le mode de prédiction ne calcule pas de métriques ; pour quantifier les performances sur un jeu de données étiqueté, utilise plutôt le mode de validation. Les deux procédures sont présentées dans Comment tester un modèle YOLO26.Pour les modèles de détection, la validation fournit la précision, le rappel, le mAP50 et le mAP50-95, et enregistre des graphiques, notamment une matrice de confusion et une courbe précision-rappel. Pour effectuer la validation sur un jeu de test dédié plutôt que sur le jeu
valutilisé par défaut, définistest:dans le fichier YAML de ton jeu de données et indiquesplit="test". Consulte le guide des métriques de performance pour savoir comment interpréter chaque métrique.En cas de surapprentissage, applique des techniques de régularisation comme le dropout, augmente la taille du jeu de données d’entraînement ou simplifie l’architecture du modèle. En cas de sous-apprentissage, utilise un modèle plus complexe, fournis des caractéristiques plus pertinentes ou entraîne le modèle pendant davantage d’époques. Les signes de chaque problème et les correctifs correspondants sont résumés dans Surapprentissage et sous-apprentissage en apprentissage automatique.
Soupçonne une fuite de données si les performances sur le jeu de test sont étonnamment bonnes, si une seule caractéristique domine les prédictions ou si les décisions du modèle ne semblent pas intuitivement cohérentes. Évite les fuites en utilisant des jeux de données diversifiés provenant de différentes caméras et de différents environnements, en examinant les données pour repérer les biais cachés et en vérifiant que la division entraînement/test a eu lieu avant tout traitement. Consulte Les fuites de données en vision par ordinateur pour connaître les types de biais courants.
Si les résultats répondent aux objectifs de ton projet, déploie le modèle ; sinon, améliore-le avant le déploiement. Cela peut consister à analyser les erreurs, à recueillir des données plus diversifiées, à améliorer la qualité des données, à ajuster les hyperparamètres et à réentraîner le modèle. Répète les tests après chaque série de modifications pour confirmer que les correctifs ont fonctionné.