Comprendre les étapes clés d’un projet de vision par ordinateur
Mener un projet de vision par ordinateur implique de suivre une série d’étapes bien définies : fixer tes objectifs, collecter et annoter des données, entraîner et évaluer un modèle, puis le déployer et le maintenir en production. Ce guide présente chaque étape dans l’ordre et explique son importance, afin que tu puisses planifier et mener ton propre projet en toute confiance.
La vision par ordinateur est un sous-domaine de l’intelligence artificielle (AI) qui aide les ordinateurs à voir et à comprendre le monde comme le font les humains. Elle traite et analyse des images ou des vidéos afin d’en extraire des informations, de reconnaître des motifs et de prendre des décisions à partir de ces données.
À regarder : Comment mener des projets de vision par ordinateur | Guide étape par étape
Les techniques de vision par ordinateur, comme la détection d’objets, la classification d’images et la segmentation d’instances, peuvent être appliquées dans divers secteurs, de la conduite autonome à l’imagerie médicale, pour obtenir des informations précieuses.
Vue d’ensemble d’un projet de vision par ordinateur#
Avant d’aborder les détails de chaque étape d’un projet de vision par ordinateur, examinons le processus dans son ensemble. Si tu lançais un projet de vision par ordinateur aujourd’hui, tu suivrais les étapes suivantes :
- Ta première priorité est de comprendre les exigences de ton projet.
- Ensuite, tu collectes et étiquettes précisément les images qui contribueront à l’entraînement de ton modèle.
- Puis, tu nettoies et augmentes tes données pour les préparer à l’entraînement du modèle.
- Après l’entraînement, tu évalues et testes minutieusement ton modèle pour vérifier qu’il fonctionne de manière cohérente dans différentes conditions.
- Enfin, tu déploies ton modèle dans le monde réel et tu le surveilles et le maintiens en tenant compte des nouvelles informations et des retours.
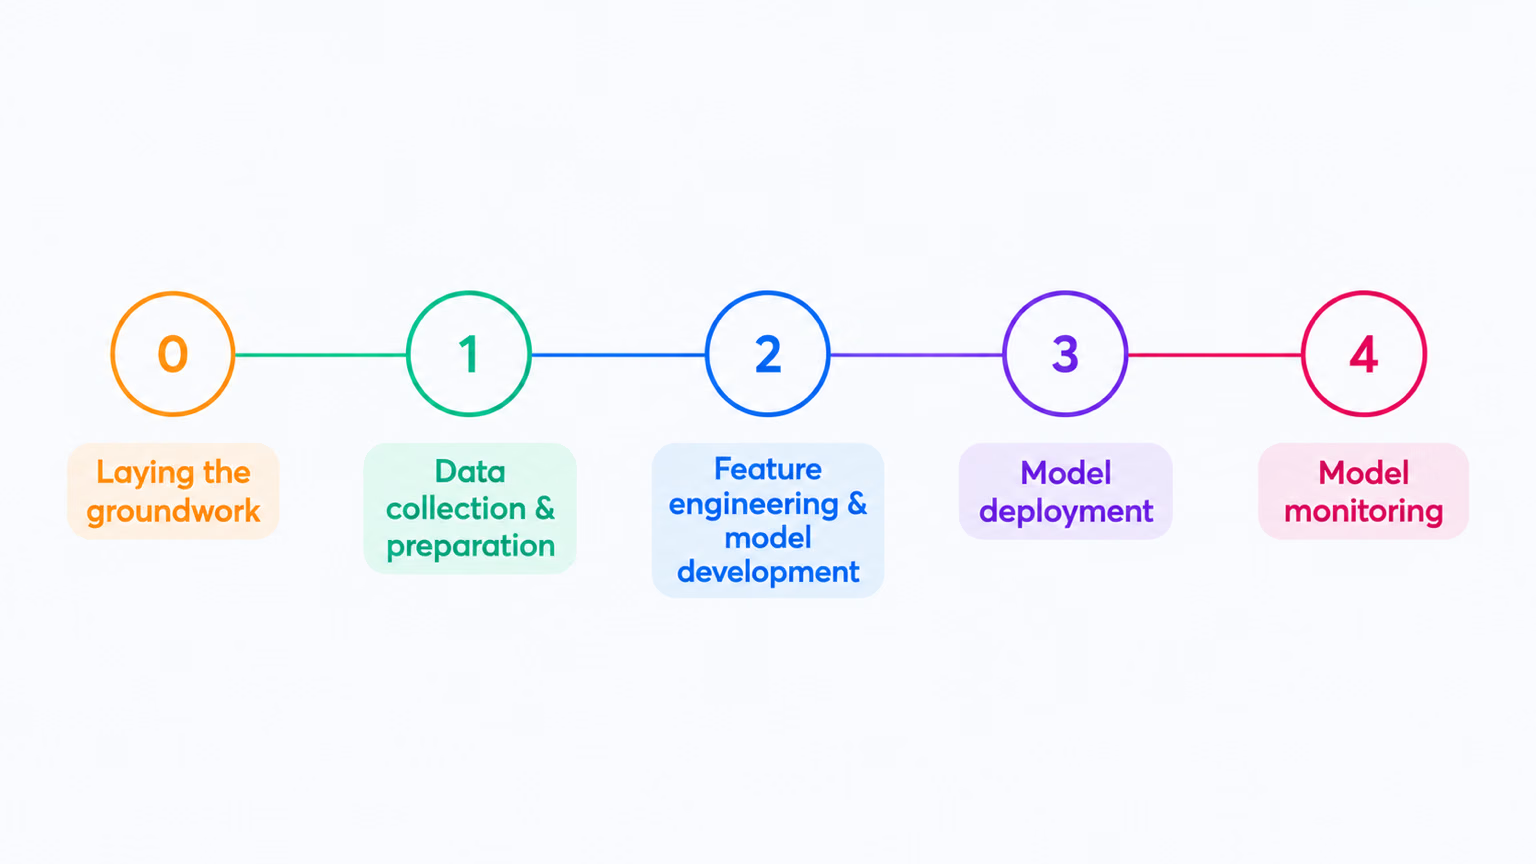
Maintenant que tu sais à quoi t’attendre, les sections ci-dessous détaillent chaque étape.
Étape 1 : définir les objectifs de ton projet#
La première étape de tout projet de vision par ordinateur consiste à définir clairement le problème que tu cherches à résoudre. Connaître l’objectif final t’aide à commencer à élaborer une solution. C’est particulièrement important en vision par ordinateur, car l’objectif de ton projet détermine directement la tâche de vision par ordinateur sur laquelle tu dois te concentrer.
Voici quelques exemples d’objectifs de projet et des tâches de vision par ordinateur qui peuvent permettre de les atteindre :
-
Objectif : Développer un système capable de surveiller et de gérer la circulation de différents types de véhicules sur les autoroutes, afin d’améliorer la gestion du trafic et la sécurité.
- Tâche de vision par ordinateur : La détection d’objets est idéale pour la surveillance du trafic, car elle localise et identifie efficacement plusieurs véhicules. Elle nécessite moins de calcul que la segmentation d’images, qui fournit des détails superflus pour cette tâche, ce qui permet une analyse plus rapide en temps réel.
-
Objectif : Développer un outil qui aide les radiologues en fournissant des contours précis, au niveau du pixel, des tumeurs dans les examens d’imagerie médicale.
- Tâche de vision par ordinateur : La segmentation d’images convient à l’imagerie médicale, car elle fournit des contours précis et détaillés des tumeurs, essentiels pour évaluer leur taille et leur forme, ainsi que pour planifier le traitement.
-
Objectif : Créer un système numérique qui classe différents documents (p. ex., factures, reçus, documents juridiques) afin d’améliorer l’efficacité organisationnelle et la recherche de documents.
- Tâche de vision par ordinateur : La classification d’images est idéale ici, car elle traite un document à la fois, sans avoir à tenir compte de sa position dans l’image. Cette approche simplifie et accélère le processus de tri.
Choisir le bon modèle et la bonne approche d’entraînement#
Après avoir compris l’objectif du projet et les tâches de vision par ordinateur adaptées, une étape essentielle pour définir le but du projet consiste à choisir le bon modèle et la bonne approche d’entraînement.
Selon l’objectif, tu peux choisir le modèle avant ou après avoir vu quelles données tu peux collecter à l’étape 2. Par exemple, supposons que ton projet dépende fortement de la disponibilité de types de données spécifiques. Dans ce cas, il peut être plus pratique de collecter et d’analyser d’abord les données avant de choisir un modèle. En revanche, si tu comprends clairement les exigences du modèle, tu peux choisir le modèle en premier, puis collecter des données qui répondent à ces spécifications.
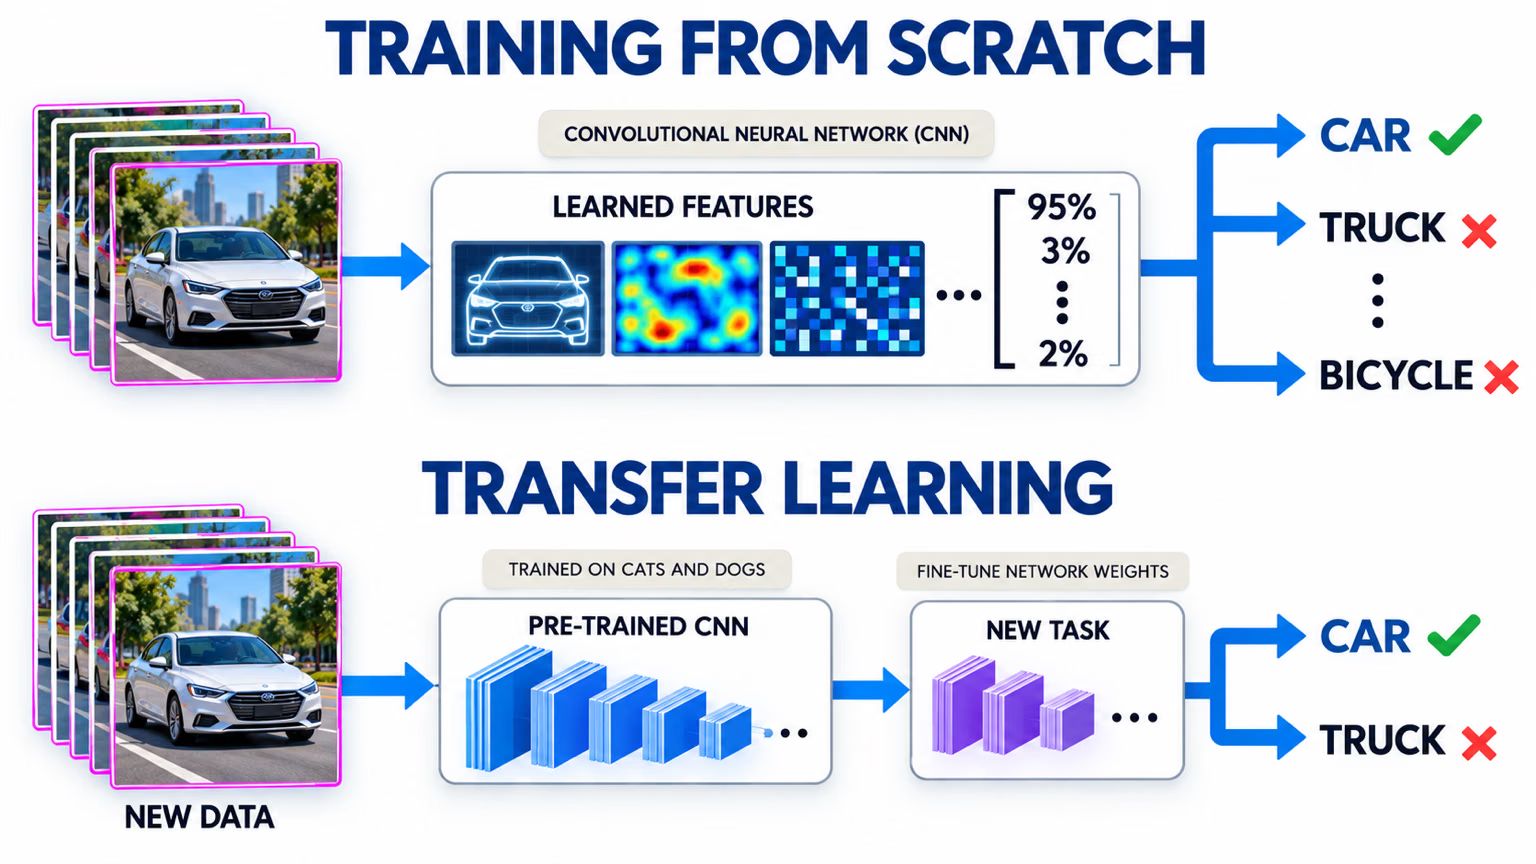
Choisir entre un entraînement à partir de zéro et l’utilisation de l’apprentissage par transfert influe sur la préparation de tes données. L’entraînement à partir de zéro nécessite un jeu de données diversifié pour construire la compréhension du modèle depuis le début. L’apprentissage par transfert, quant à lui, te permet d’utiliser un modèle préentraîné et de l’adapter avec un jeu de données plus petit et plus spécifique. De plus, le choix d’un modèle particulier à entraîner détermine la préparation des données requise, par exemple le redimensionnement des images ou l’ajout d’annotations, selon les besoins spécifiques du modèle.
Tiens compte de la cible de déploiement d’un modèle pour garantir sa compatibilité et ses performances. Par exemple, les modèles légers sont idéaux pour l’informatique en périphérie, grâce à leur efficacité sur les appareils aux ressources limitées.
Pour en savoir plus, consulte notre guide sur la définition des objectifs de ton projet et le choix du bon modèle.
Avant de passer à la mise en pratique d’un projet de vision par ordinateur, il est important de bien comprendre ces éléments. Avant de passer à l’étape 2, vérifie que tu as pris en compte les points suivants :
- Définis clairement le problème que tu cherches à résoudre.
- Détermine l’objectif final de ton projet.
- Identifie la tâche de vision par ordinateur spécifique nécessaire (p. ex., détection d’objets, classification d’images, segmentation d’images).
- Décide si tu vas entraîner un modèle à partir de zéro ou utiliser l’apprentissage par transfert.
- Sélectionne le modèle adapté à ta tâche et à tes besoins de déploiement.
Étape 2 : Collecte et annotation des données#
La qualité de tes modèles de vision par ordinateur dépend de celle de ton jeu de données. Tu peux collecter des images sur Internet, prendre tes propres photos ou utiliser des jeux de données existants. Parmi les sources utiles de jeux de données publics, on trouve Google Dataset Search Engine, le UC Irvine Machine Learning Repository et les jeux de données Kaggle.
Certaines bibliothèques, comme Ultralytics, proposent une prise en charge intégrée de divers jeux de données, ce qui facilite le démarrage avec des données de qualité. Elles incluent souvent des utilitaires de téléchargement et de chargement des jeux de données courants, qui peuvent te faire gagner beaucoup de temps et d’efforts au début de ton projet.
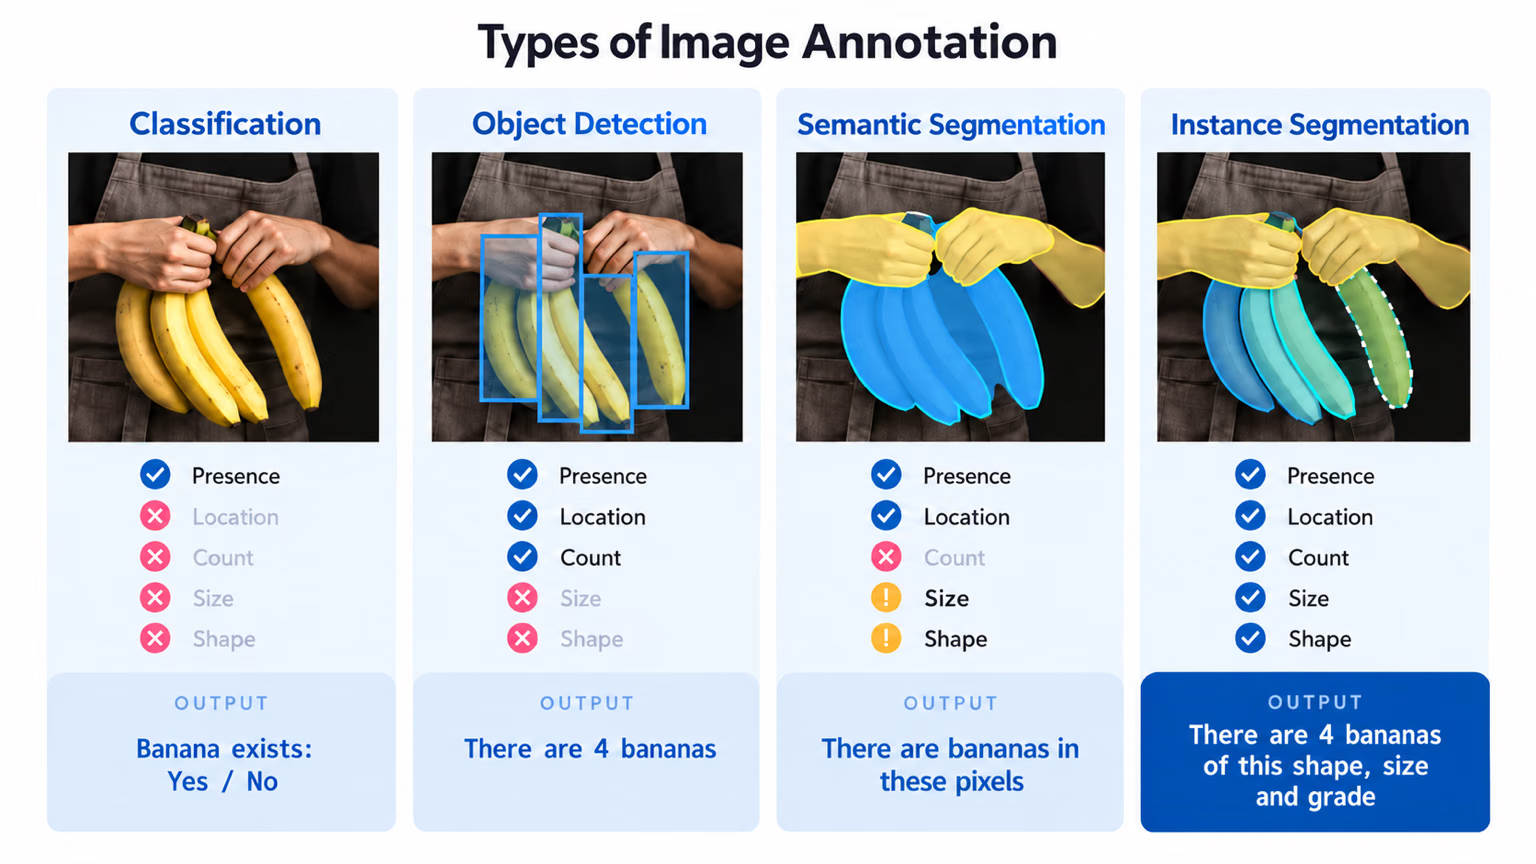
Cependant, si tu choisis de collecter des images ou de prendre tes propres photos, tu devras annoter tes données. L’annotation des données consiste à étiqueter tes données pour transmettre des connaissances à ton modèle. Le type d’annotation que tu utiliseras dépend de ta technique de vision par ordinateur. En voici quelques exemples :
- Classification d’images : Tu attribues une seule classe à l’image entière.
- Détection d’objets : Tu dessines des boîtes englobantes autour de chaque objet de l’image et tu étiquettes chaque boîte.
- Segmentation d’images : Tu étiquettes chaque pixel de l’image selon l’objet auquel il appartient, ce qui crée des contours détaillés des objets.
La collecte et l’annotation des données peuvent demander beaucoup de travail manuel. Un outil d’annotation dédié accélère le processus : Ultralytics Platform fournit un éditeur d’annotations intégré, avec une annotation intelligente optimisée par SAM pour les données de détection, de segmentation et OBB, et enregistre directement les étiquettes au format YOLO.
Étape 3 : Augmentation des données et division de ton jeu de données#
Après avoir collecté et annoté tes images, il est important de diviser d’abord ton jeu de données en ensembles d’entraînement, de validation et de test avant d’effectuer l’augmentation des données. Diviser ton jeu de données avant l’augmentation est essentiel pour tester et valider ton modèle sur des données originales et non modifiées. Cela permet d’évaluer avec précision la capacité du modèle à généraliser à de nouvelles données inédites.
Voici comment diviser tes données :
- Ensemble d’entraînement : Il constitue la plus grande partie de tes données, généralement 70 à 80 % du total, et sert à entraîner ton modèle.
- Ensemble de validation : Il représente généralement environ 10 à 15 % de tes données. Cet ensemble sert à régler les hyperparamètres et à valider le modèle pendant l’entraînement, ce qui aide à éviter le surapprentissage.
- Ensemble de test : Les 10 à 15 % restants de tes données constituent l’ensemble de test. Il sert à évaluer les performances du modèle sur des données inédites une fois l’entraînement terminé.
Après avoir divisé tes données, tu peux effectuer une augmentation des données en appliquant des transformations comme la rotation, le changement d’échelle et le retournement des images afin d’augmenter artificiellement la taille de ton jeu de données. L’augmentation des données rend ton modèle plus robuste aux variations et améliore ses performances sur des images inédites.
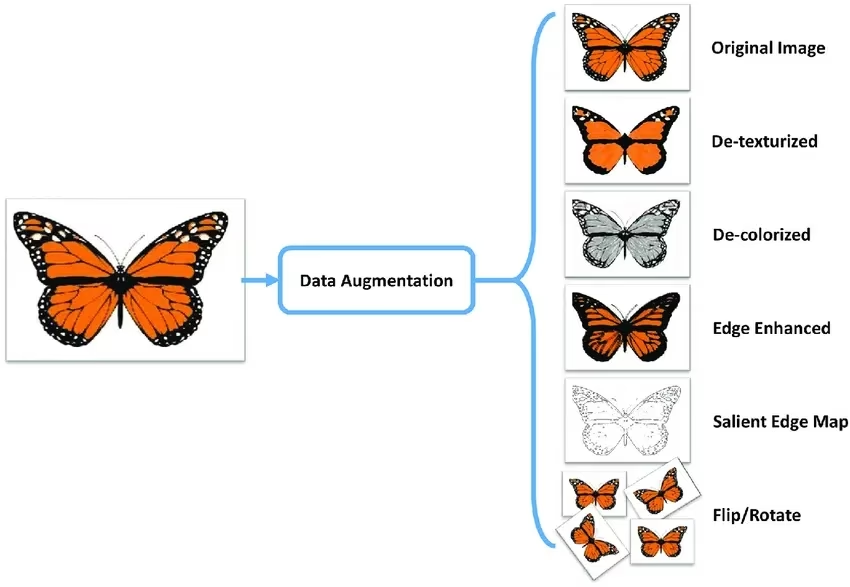
Des bibliothèques comme OpenCV, Albumentations et TensorFlow offrent des fonctions d’augmentation flexibles. En outre, certaines bibliothèques, comme Ultralytics, intègrent des paramètres d’augmentation directement dans leur fonction d’entraînement des modèles, ce qui simplifie le processus.
Pour mieux comprendre tes données, tu peux utiliser des outils comme Matplotlib ou Seaborn afin de visualiser les images et d’analyser leur distribution et leurs caractéristiques. La visualisation de tes données aide à repérer les motifs et les anomalies, ainsi qu’à évaluer l’efficacité de tes techniques d’augmentation. L’onglet Charts d’Ultralytics Platform peut faire ressortir bon nombre de ces informations sans aucun code, en générant automatiquement pour chaque jeu de données téléversé la distribution des divisions, le nombre de classes, des histogrammes des dimensions des images et des cartes thermiques de la position des annotations.
En comprenant, divisant et augmentant correctement tes données, tu peux développer un modèle bien entraîné, validé et testé, qui fonctionne bien dans des applications réelles.
Étape 4 : Entraînement du modèle#
Une fois ton jeu de données prêt pour l’entraînement, tu peux te concentrer sur la configuration de l’environnement nécessaire, la gestion de tes jeux de données et l’entraînement de ton modèle.
Tout d’abord, tu dois t’assurer que ton environnement est correctement configuré. En général, cela comprend les éléments suivants :
- Installer les bibliothèques et frameworks essentiels comme TensorFlow, PyTorch ou Ultralytics.
- Si tu utilises un GPU, l’installation de bibliothèques comme CUDA et cuDNN permettra d’activer l’accélération GPU et d’accélérer l’entraînement.
Tu peux ensuite charger tes jeux de données d’entraînement et de validation dans ton environnement. Normalise et prétraite les données en les redimensionnant, en convertissant leur format ou en leur appliquant une augmentation. Une fois ton modèle sélectionné, configure les couches et définis les hyperparamètres. Compile le modèle en définissant la fonction de perte, l’optimiseur et les métriques de performance.
Des bibliothèques comme Ultralytics simplifient l’entraînement. Tu peux lancer l’entraînement en transmettant des données au modèle avec un minimum de code. Ces bibliothèques gèrent automatiquement l’ajustement des poids, la rétropropagation et la validation. Elles proposent aussi des outils pour suivre facilement la progression et ajuster les hyperparamètres. Après l’entraînement, enregistre le modèle et ses poids à l’aide de quelques commandes.
N’oublie pas qu’une bonne gestion des jeux de données est essentielle à un entraînement efficace. Utilise le contrôle de version pour suivre les modifications apportées aux jeux de données et garantir la reproductibilité. Des outils comme DVC (Data Version Control) peuvent t’aider à gérer les grands jeux de données.
Étape 5 : Évaluation et ajustement fin du modèle#
Il est important d’évaluer les performances de ton modèle à l’aide de diverses métriques et de l’affiner pour améliorer sa précision. L’évaluation aide à repérer les points forts du modèle et ceux qui nécessitent des améliorations. L’ajustement fin permet d’optimiser le modèle pour obtenir les meilleures performances possibles.
- Mesures de performance : utilise des mesures comme l’exactitude, la précision, le rappel et le score F1 pour évaluer les performances de ton modèle. Ces mesures te renseignent sur la qualité des prédictions de ton modèle.
- Réglage des hyperparamètres : Ajuste les hyperparamètres pour optimiser les performances du modèle. Des techniques comme la recherche par grille ou la recherche aléatoire peuvent aider à trouver les meilleures valeurs d’hyperparamètres.
- Ajustement fin : Apporte de légères modifications à l’architecture du modèle ou au processus d’entraînement pour améliorer les performances. Cela peut consister à ajuster les taux d’apprentissage, les tailles de lot ou d’autres paramètres du modèle.
Pour mieux comprendre l’évaluation des modèles et les techniques d’ajustement fin, consulte notre guide sur l’évaluation des modèles.
Étape 6 : Test du modèle#
Le test du modèle confirme qu’il fonctionne bien sur des données totalement inédites et vérifie qu’il est prêt à être déployé. La différence entre le test et l’évaluation du modèle tient au fait que le test vérifie les performances du modèle final, au lieu de chercher à les améliorer de manière itérative.
Il est important de tester soigneusement le modèle et de déboguer les problèmes courants susceptibles de survenir. Teste ton modèle sur un jeu de données distinct, qui n’a pas été utilisé pendant l’entraînement ou la validation. Ce jeu de données doit représenter des scénarios réels afin de garantir la cohérence et la fiabilité des performances du modèle.
Traite également les problèmes courants comme le surapprentissage, le sous-apprentissage et la fuite de données. Utilise des techniques comme la validation croisée pour repérer ces problèmes. Pour connaître les stratégies de test complètes, consulte notre guide de test des modèles.
Étape 7 : Déploiement du modèle#
Une fois ton modèle testé en profondeur, tu peux le déployer. Le déploiement de modèles consiste à rendre ton modèle disponible dans un environnement de production. Voici les étapes pour déployer un modèle de vision par ordinateur :
- Configuration de l’environnement : Configure l’infrastructure nécessaire pour l’option de déploiement choisie, qu’elle soit dans le cloud (AWS, Google Cloud, Azure) ou en périphérie (appareils locaux, IoT).
- Exportation du modèle : Exporte ton modèle dans le format approprié (p. ex., ONNX, TensorRT, CoreML pour YOLO26) afin d’assurer sa compatibilité avec ta plateforme de déploiement.
- Déploiement du modèle : Déploie le modèle en configurant des API ou des points de terminaison et en l’intégrant à ton application.
- Garantie de l’évolutivité : Mets en place des équilibreurs de charge, des groupes de mise à l’échelle automatique et des outils de surveillance pour gérer les ressources et traiter l’augmentation des données et des demandes des utilisateurs.
Ultralytics Platform fournit également des points de terminaison de déploiement gérés dans 42 régions du monde, avec une mise à l’échelle automatique jusqu’à zéro par défaut ; la configuration de l’infrastructure est prise en charge automatiquement.
Étape 8 : Surveillance, maintenance et documentation#
Une fois ton modèle déployé, il est important de surveiller continuellement ses performances, de le maintenir pour résoudre les problèmes éventuels et de documenter l’ensemble du processus afin de pouvoir le consulter et l’améliorer ultérieurement.
Les outils de surveillance peuvent t’aider à suivre les indicateurs clés de performance (KPI) et à détecter les anomalies ou les baisses de précision. La surveillance du modèle permet de repérer sa dérive, c’est-à-dire la baisse de ses performances au fil du temps due à des changements dans les données d’entrée. Réentraîne régulièrement le modèle avec des données mises à jour afin de préserver sa précision et sa pertinence.
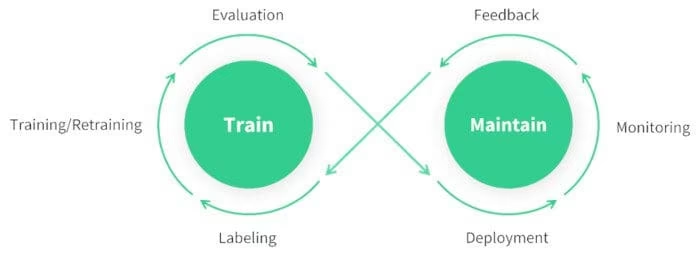
Outre la surveillance et la maintenance, la documentation est également essentielle. Documente soigneusement l’ensemble du processus, notamment l’architecture du modèle, les procédures d’entraînement, les hyperparamètres, les étapes de prétraitement des données et toute modification effectuée pendant le déploiement et la maintenance. Une bonne documentation garantit la reproductibilité et facilite les mises à jour ou le dépannage ultérieurs. En surveillant, maintenant et documentant efficacement ton modèle, tu peux garantir qu’il reste précis, fiable et facile à gérer tout au long de son cycle de vie.
Participer à la communauté#
Échanger avec une communauté de passionnés de vision par ordinateur peut t’aider à résoudre avec assurance les problèmes rencontrés dans le cadre de ton projet de vision par ordinateur. Voici quelques façons d’apprendre, de résoudre des problèmes et de développer ton réseau efficacement.
Ressources communautaires#
- Problèmes GitHub : Consulte le dépôt GitHub de YOLO26 et utilise l’onglet Issues pour poser des questions, signaler des bugs et suggérer de nouvelles fonctionnalités. La communauté active et les responsables de maintenance sont là pour t’aider à résoudre des problèmes précis.
- Serveur Discord d’Ultralytics : Rejoins le serveur Discord d’Ultralytics pour échanger avec d’autres utilisateurs et développeurs, obtenir de l’aide et partager des idées.
L’utilisation de ces ressources t’aidera à relever les défis et à rester au courant des dernières tendances et des meilleures pratiques de la communauté de la vision par ordinateur.
Étapes suivantes#
Tu disposes maintenant d’une feuille de route couvrant toutes les étapes d’un projet de vision par ordinateur, de la définition des objectifs à la surveillance d’un modèle déployé. Mets-la en pratique en entraînant ton premier modèle YOLO, ou approfondis une étape particulière à l’aide des guides liés ci-dessus. Pour exécuter l’ensemble du pipeline sans écrire de code, découvre Ultralytics Platform.
FAQ#
Le choix de la tâche de vision par ordinateur appropriée dépend de l’objectif final de ton projet. Par exemple, si tu veux surveiller la circulation, la détection d’objets convient, car elle peut localiser et identifier plusieurs types de véhicules en temps réel. Pour l’imagerie médicale, la segmentation d’images est idéale pour délimiter précisément les tumeurs, ce qui facilite le diagnostic et la planification du traitement.
L’annotation des données est essentielle pour apprendre à ton modèle à reconnaître des tendances. Le type d’annotation varie selon la tâche :
- Classification d’images : L’image entière est étiquetée comme une seule classe.
- Détection d’objets : Des boîtes englobantes sont dessinées autour des objets.
- Segmentation d’images : Chaque pixel est étiqueté selon l’objet auquel il appartient.
L’éditeur d’annotations intégré à Ultralytics Platform peut t’aider dans ce processus.
Diviser ton jeu de données avant l’augmentation permet de valider les performances du modèle sur des données originales et non modifiées. Suis ces étapes :
- Ensemble d’entraînement : 70 à 80 % de tes données.
- Ensemble de validation : 10 à 15 % pour le réglage des hyperparamètres.
- Ensemble de test : Les 10 à 15 % restants pour l’évaluation finale.
Après la division, applique des techniques d’augmentation des données comme la rotation, le changement d’échelle et le retournement pour diversifier ton jeu de données. Des bibliothèques comme Albumentations et OpenCV peuvent t’aider. Ultralytics propose également des paramètres d’augmentation intégrés pour te simplifier la tâche.
Exporte ton modèle entraîné à l’aide de la méthode
exportet choisis un format adapté à ta cible de déploiement. Ultralytics prend en charge plusieurs formats, notamment ONNX, TensorRT et CoreML. Pour exporter ton modèle YOLO26, suis ces étapes :- Utilise la méthode
exportavec le paramètre de format souhaité. - Assure-toi que le modèle exporté respecte les spécifications de ton environnement de déploiement (p. ex., appareils en périphérie, cloud).
Pour en savoir plus, consulte le guide sur l’exportation des modèles.
- Utilise la méthode
Une surveillance et une maintenance continues sont essentielles à la réussite à long terme d’un modèle. Mets en place des outils pour suivre les indicateurs clés de performance (KPI) et détecter les anomalies. Réentraîne régulièrement le modèle avec des données à jour pour contrer la dérive du modèle. Documente l’ensemble du processus, notamment l’architecture du modèle, les hyperparamètres et les modifications, afin de garantir la reproductibilité et de faciliter les mises à jour ultérieures. Pour en savoir plus, consulte notre guide de surveillance et de maintenance.


Commentaires2
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?