YOLOv10 : détection d’objets de bout en bout en temps réel
Sorti en mai 2024 et développé à partir du package Python Ultralytics par des chercheurs de l'université Tsinghua, YOLOv10 introduit une nouvelle approche de la détection d'objets en temps réel, qui répond aux lacunes du post-traitement et de l'architecture des modèles des versions précédentes de YOLO. En éliminant la suppression non maximale (NMS) et en optimisant divers composants du modèle, YOLOv10 a obtenu de bonnes performances avec une surcharge de calcul considérablement réduite au moment de sa sortie. Sa conception de bout en bout sans NMS a ouvert la voie à une approche développée depuis dans YOLO26.
Regarder : Comment entraîner YOLOv10 sur le jeu de données SKU-110k avec Ultralytics | Jeu de données de vente au détail
Présentation#
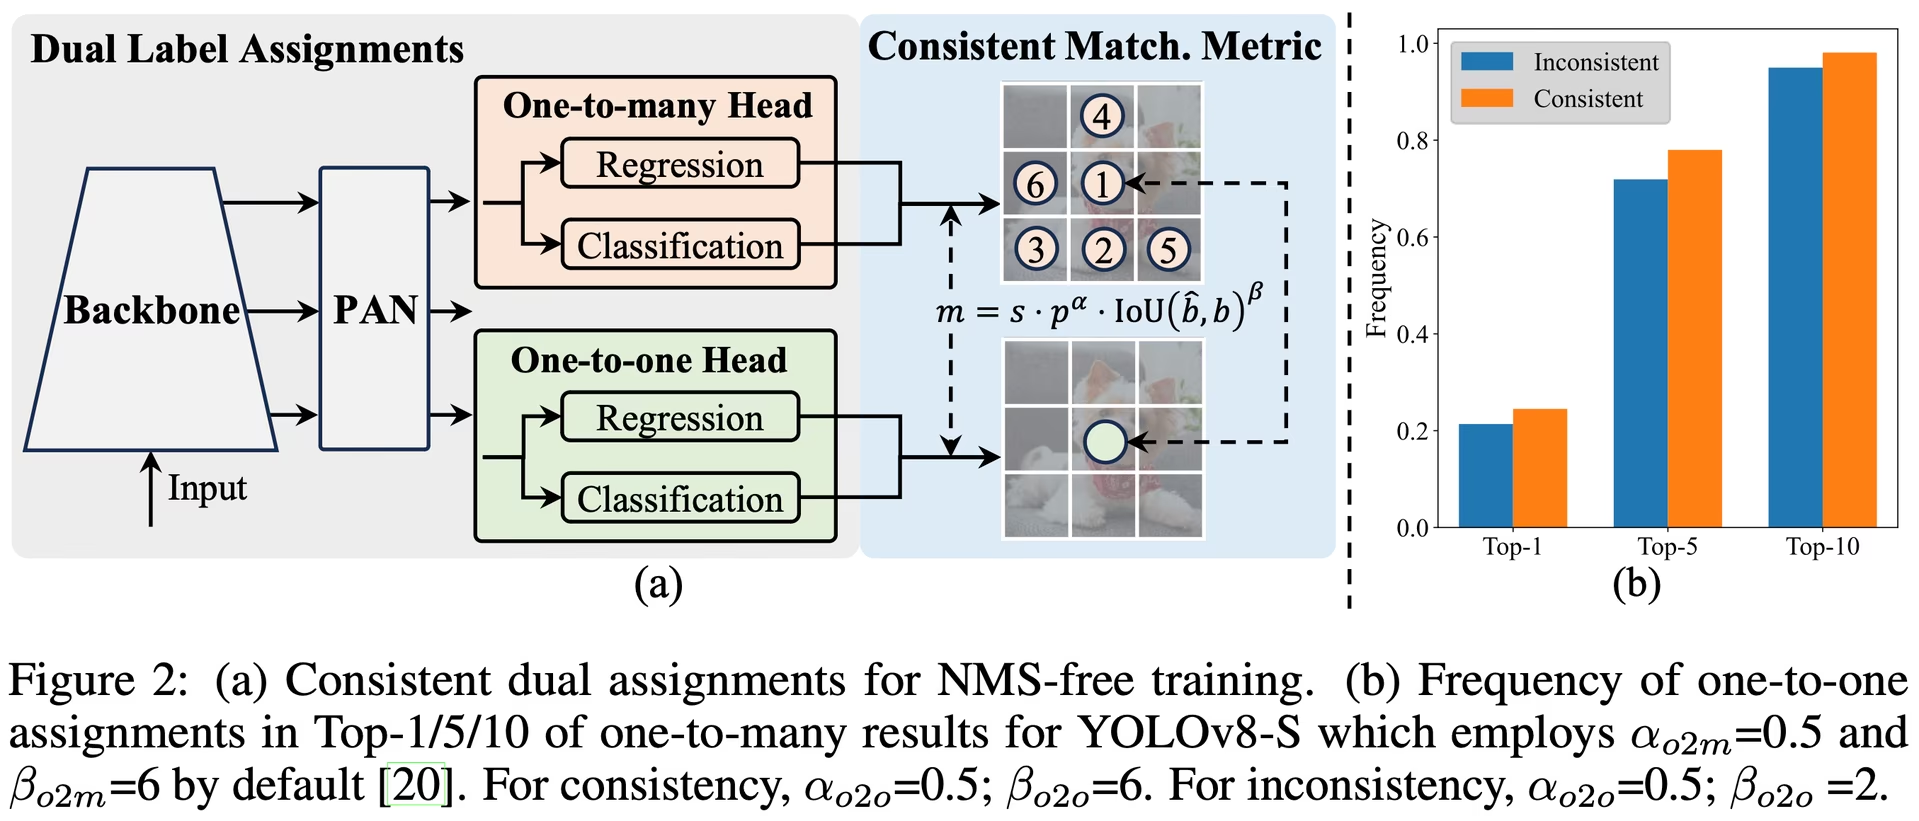
La détection d'objets en temps réel vise à prédire avec précision les catégories et les positions des objets dans les images, avec une faible latence. La série YOLO est à l'avant-garde de ces recherches grâce à son équilibre entre performances et efficacité. Cependant, la dépendance à la NMS et les inefficacités architecturales ont empêché d'atteindre des performances optimales. YOLOv10 résout ces problèmes en introduisant des attributions doubles cohérentes pour l'entraînement sans NMS et une stratégie globale de conception de modèle axée sur l'efficacité et la précision.
Architecture#
L’architecture de YOLOv10 s’appuie sur les atouts des modèles YOLO précédents tout en introduisant plusieurs innovations clés. Elle se compose des éléments suivants :
- Backbone : Chargé de l’extraction des caractéristiques, le backbone de YOLOv10 utilise une version améliorée de CSPNet (réseau partiel à travers les étapes) afin d’améliorer la propagation des gradients et de réduire la redondance des calculs.
- Neck : Le neck est conçu pour agréger les caractéristiques de différentes échelles et les transmettre à la tête. Il comprend des couches PAN (réseau d’agrégation de chemins) pour une fusion efficace des caractéristiques à plusieurs échelles.
- Tête un-à-plusieurs : Génère plusieurs prédictions par objet pendant l’entraînement afin de fournir des signaux de supervision riches et d’améliorer la précision de l’apprentissage.
- Tête One-to-One : génère une seule prédiction optimale par objet pendant l’inférence, ce qui élimine le besoin de NMS, réduit la latence et améliore l’efficacité.
Fonctionnalités clés#
- Entraînement sans NMS : utilise des assignations doubles cohérentes pour éliminer le besoin de NMS et réduire la latence d’inférence.
- Conception globale du modèle : optimisation complète de divers composants sous l’angle de l’efficacité et de la précision, notamment des têtes de classification légères, un sous-échantillonnage découplant l’espace et les canaux, et une conception des blocs guidée par le rang.
- Capacités du modèle améliorées : intègre des convolutions à grands noyaux et des modules d'auto-attention partielle pour améliorer les performances sans coût de calcul important.
Variantes du modèle#
YOLOv10 existe en plusieurs tailles de modèle pour répondre aux besoins de différentes applications :
- YOLOv10n : version nano pour les environnements soumis à de très fortes contraintes de ressources.
- YOLOv10s : petite version qui équilibre vitesse et précision.
- YOLOv10m : version moyenne pour un usage général.
- YOLOv10b : version équilibrée, plus large pour une meilleure précision.
- YOLOv10l : grande version offrant une meilleure précision au prix de ressources de calcul plus importantes.
- YOLOv10x : très grande version pour une précision et des performances maximales.
Performances#
À sa sortie, YOLOv10 surpassait les versions précédentes de YOLO et d'autres modèles de pointe en matière de précision et d'efficacité. Par exemple, YOLOv10s est 1,8 fois plus rapide que RT-DETR-R18 avec un AP similaire sur le jeu de données COCO, et YOLOv10b présente une latence inférieure de 46 % et 25 % de paramètres en moins que YOLOv9-C, à performances égales.
Latence mesurée avec TensorRT FP16 sur un GPU T4.
| Modèle | Taille d’entrée | APvalidation50-95 | FLOPs (G) | Latence (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Méthodologie#
Assignations doubles cohérentes pour un entraînement sans NMS#
YOLOv10 utilise des attributions doubles d'étiquettes, combinant les stratégies un-à-plusieurs et un-à-un pendant l'entraînement pour assurer une supervision riche et un déploiement de bout en bout efficace. Par défaut, les prédictions et la validation d'Ultralytics utilisent la tête un-à-plusieurs avec NMS ; définis nms=False pour sélectionner la tête sans NMS. La métrique d'appariement cohérente harmonise la supervision entre les deux stratégies et améliore la qualité des prédictions lors de l'inférence.
Conception globale du modèle axée sur l'efficacité et la précision#
Améliorations de l’efficacité#
- Tête de classification légère : réduit la charge de calcul de la tête de classification grâce à des convolutions séparables en profondeur.
- Sous-échantillonnage découplant l’espace et les canaux : dissocie la réduction spatiale de la modulation des canaux afin de minimiser la perte d’informations et le coût de calcul.
- Conception des blocs guidée par le rang : adapte la conception des blocs en fonction de la redondance intrinsèque de chaque étape, pour optimiser l’utilisation des paramètres.
Améliorations de la précision#
- Convolution à grand noyau : élargit le champ réceptif pour améliorer la capacité d’extraction des caractéristiques.
- Auto-attention partielle (PSA) : intègre des modules d’auto-attention pour améliorer l’apprentissage des représentations globales avec une surcharge minimale.
Expériences et résultats#
YOLOv10 a été évalué sur des benchmarks standard tels que COCO. À sa sortie, chaque variante améliorait le compromis entre latence et précision par rapport aux versions précédentes de YOLO et aux autres détecteurs contemporains.
Comparaisons#
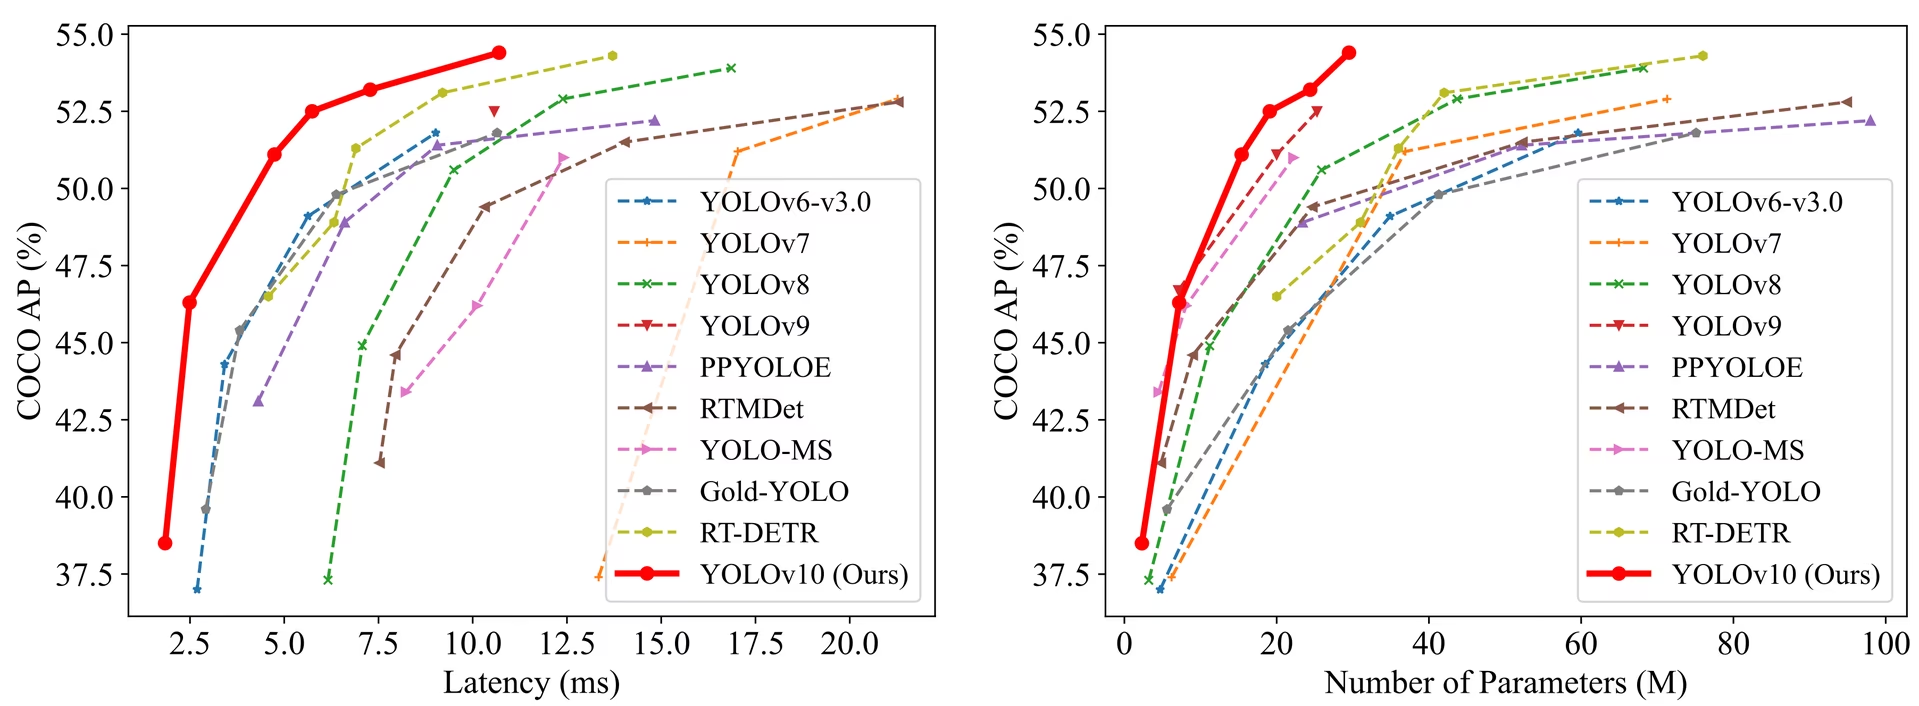
Par rapport aux autres détecteurs de pointe :
- YOLOv10s / x sont 1,8× / 1,3× plus rapides que RT-DETR-R18 / R101 avec une précision similaire
- YOLOv10b utilise 25 % de paramètres en moins et présente une latence inférieure de 46 % à celle de YOLOv9-C, à précision égale
- YOLOv10l / x surpassent YOLOv8l / x de 0,3 AP / 0,5 AP avec 1,8× / 2,3× moins de paramètres
Les chiffres ci-dessous sont ceux rapportés dans l’article YOLOv10, mesurés selon son propre protocole ; ils ne sont donc pas directement comparables aux valeurs figurant sur les pages des modèles Ultralytics :
| Modèle | Paramètres (M) | FLOPs (G) | mAPval50-95 | Latence (ms) | Latence de propagation avant (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Les valeurs de paramètres et de FLOPs correspondent au modèle fusionné après model.fuse(), qui fusionne les couches Conv et BatchNorm et supprime la tête de détection auxiliaire une-vers-plusieurs. Les points de contrôle préentraînés conservent l’architecture complète d’entraînement et peuvent afficher des valeurs plus élevées.
Exemples d'utilisation#
Tu peux aussi entraîner des modèles sur des GPU cloud via Ultralytics Platform. Pour effectuer des prédictions sur de nouvelles images avec YOLOv10 :
from ultralytics import YOLO

# Charger un modèle YOLOv10n préentraîné
model = YOLO("yolov10n.pt")

# Effectuer la détection d’objets sur une image
results = model("image.jpg")

# Afficher les résultats
results[0].show()
Pour entraîner YOLOv10 sur un jeu de données personnalisé :
from ultralytics import YOLO

# Charger le modèle YOLOv10n à partir de zéro
model = YOLO("yolov10n.yaml")

# Entraîner le modèle
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Tâches et modes pris en charge#
La série de modèles YOLOv10 propose plusieurs modèles, chacun optimisé pour la détection d'objets. Les variantes couvrent différents budgets de calcul et exigences de précision.
| Modèle | Noms de fichiers | Tâches | Entraînement | Validation | Inférence | Export |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Détection d'objets | ✅ | ✅ | ✅ | ✅ |
Exporter YOLOv10#
En raison des nouvelles opérations introduites avec YOLOv10, tous les formats d'export proposés par Ultralytics ne sont pas encore pris en charge. Le tableau suivant répertorie les formats qu'Ultralytics a réussi à convertir pour YOLOv10. Les pull requests ajoutant la prise en charge d'autres formats d'export sont les bienvenues.
| Format d’export | Prise en charge de l’export | Inférence du modèle exporté | Remarques |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Format de modèle PyTorch standard. |
| ONNX | ✅ | ✅ | Largement pris en charge pour le déploiement. |
| OpenVINO | ✅ | ✅ | Optimisé pour le matériel Intel. |
| TensorRT | ✅ | ✅ | Optimisé pour les GPU NVIDIA. |
| CoreML | ✅ | ✅ | Limité aux appareils Apple. |
| TF SavedModel | ✅ | ✅ | Format de modèle standard de TensorFlow. |
| TF GraphDef | ✅ | ✅ | Format TensorFlow historique. |
| TF Edge TPU | ✅ | ✅ | Spécifique aux appareils Edge TPU de Google. |
| LiteRT | ✅ | ✅ | Optimisé pour les appareils mobiles, les systèmes embarqués et les navigateurs (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Populaire en Chine ; moins pris en charge dans le reste du monde. |
| NCNN | ✅ | ✅ | Optimisé pour les appareils mobiles et embarqués. |
Conclusion#
À sa sortie, YOLOv10 a fait progresser la détection d'objets en temps réel en supprimant le post-traitement NMS et en repensant les composants du modèle pour gagner en efficacité et en précision. Son approche sans NMS a ouvert la voie à la détection d'objets de bout en bout dans la famille YOLO. YOLO26, le dernier modèle Ultralytics, s'appuie sur cette approche avec de meilleures performances et une inférence sans NMS.
Citations et remerciements#
Nous tenons à remercier les auteurs de YOLOv10 de l’université Tsinghua pour leurs recherches approfondies et leurs contributions majeures au framework Ultralytics :
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Pour en savoir plus sur l’implémentation, les innovations architecturales et les résultats expérimentaux, consulte l’article de recherche YOLOv10 et le dépôt GitHub de l’équipe de l’université Tsinghua.
FAQ#
YOLOv10, développé par des chercheurs de l’université Tsinghua, introduit plusieurs innovations clés dans la détection d’objets en temps réel. Il élimine le besoin de suppression non maximale (NMS) en employant des assignations doubles cohérentes pendant l’entraînement et optimise les composants du modèle afin de réduire la charge de calcul.
Lance l'inférence avec l'API Python Ultralytics ou l'interface en ligne de commande (CLI). Voici des exemples de prédiction sur de nouvelles images avec YOLOv10 :
Exemplefrom ultralytics import YOLO # Charger le modèle YOLOv10n préentraîné model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Pour découvrir d’autres exemples d’utilisation, consulte la section Exemples d’utilisation.
YOLOv10 propose plusieurs variantes de modèles pour répondre à différents cas d’utilisation :
- YOLOv10n : convient aux environnements disposant de ressources extrêmement limitées
- YOLOv10s : offre un équilibre entre vitesse et précision
- YOLOv10m : utilisation générale
- YOLOv10b : précision accrue grâce à une plus grande largeur
- YOLOv10l : grande précision au prix de ressources de calcul plus importantes
- YOLOv10x : précision et performances maximales
Chaque variante est conçue pour répondre à différents besoins en calcul et exigences de précision, ce qui les rend polyvalentes pour de nombreuses applications. Consulte la section Variantes de modèles pour en savoir plus.
YOLOv10 est entraîné avec des assignations doubles cohérentes afin que sa tête à assignation unique produise une seule meilleure prédiction par objet, ce qui élimine le besoin de suppression des maxima non locaux (NMS) lors de l’inférence. Par défaut, la prédiction et la validation Ultralytics utilisent la tête à assignations multiples avec NMS ; définis
nms=Falsepour sélectionner la tête sans NMS et supprimer l’étape NMS. Pour une explication détaillée, consulte la section Assignations doubles cohérentes pour l’entraînement sans NMS.YOLOv10 prend en charge plusieurs formats d’exportation, notamment TorchScript, ONNX, OpenVINO et TensorRT. Cependant, certains formats d’exportation proposés par Ultralytics ne sont pas encore pris en charge pour YOLOv10 en raison de ses nouvelles opérations. Pour en savoir plus sur les formats pris en charge et obtenir les instructions d’exportation, consulte la section Exporter YOLOv10.
À sa sortie, YOLOv10 surpassait les versions précédentes de YOLO et d'autres modèles de pointe en matière de précision et d'efficacité. Par exemple, YOLOv10s est 1,8 fois plus rapide que RT-DETR-R18 avec un AP similaire sur le jeu de données COCO. YOLOv10b présente une latence inférieure de 46 % et 25 % de paramètres en moins que YOLOv9-C, à performances égales. Tu trouveras des benchmarks détaillés dans la section Comparaisons.


Commentaires188
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 Glenn JocherUltralytics(modifié)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(modifié)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(modifié)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(modifié)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(modifié)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1