Utilitaires simples#
Le package ultralytics fournit divers utilitaires pour faciliter, améliorer et accélérer tes flux de travail. Il en existe bien d’autres ; ce guide présente quelques-uns des plus utiles aux développeurs et constitue une référence pratique pour programmer avec les outils Ultralytics.
Regarder : Outils Ultralytics | Annotation automatique, Explorer API et conversion de jeux de données
Données#
Étiquetage automatique / annotations#
L’annotation des jeux de données est un processus qui demande beaucoup de ressources et de temps. Si tu disposes d’un modèle Ultralytics YOLO de détection d’objets entraîné sur une quantité raisonnable de données, tu peux l’utiliser avec SAM pour annoter automatiquement des données supplémentaires au format segmentation.
from ultralytics.data.annotator import auto_annotate

auto_annotate(
    data="path/to/new/data",
    det_model="yolo26n.pt",
    sam_model="mobile_sam.pt",
    device="cuda",
    output_dir="path/to/save_labels",
)
Cette fonction ne renvoie aucune valeur. Pour plus de détails :
- Consulte la section de référence de
annotator.auto_annotatepour mieux comprendre le fonctionnement de la fonction. - Utilise cette fonction avec la fonction
segments2boxespour générer également des boîtes englobantes de détection d’objets.
Visualiser les annotations d’un jeu de données#
Cette fonction visualise les annotations YOLO sur une image avant l’entraînement, afin de repérer et de corriger les annotations erronées susceptibles de fausser les résultats de détection. Elle dessine des boîtes englobantes, étiquette les objets avec leurs noms de classe et ajuste la couleur du texte en fonction de la luminance de l’arrière-plan pour en améliorer la lisibilité.
from ultralytics.data.utils import visualize_image_annotations

label_map = {  # Définir la correspondance des étiquettes avec toutes les étiquettes de classe annotées.
    0: "person",
    1: "car",
}

# Visualize
visualize_image_annotations(
    "path/to/image.jpg",  # Chemin de l’image d’entrée.
    "path/to/annotations.txt",  # Chemin du fichier d’annotation de l’image.
    label_map,
)
Convertir des masques de segmentation au format YOLO#
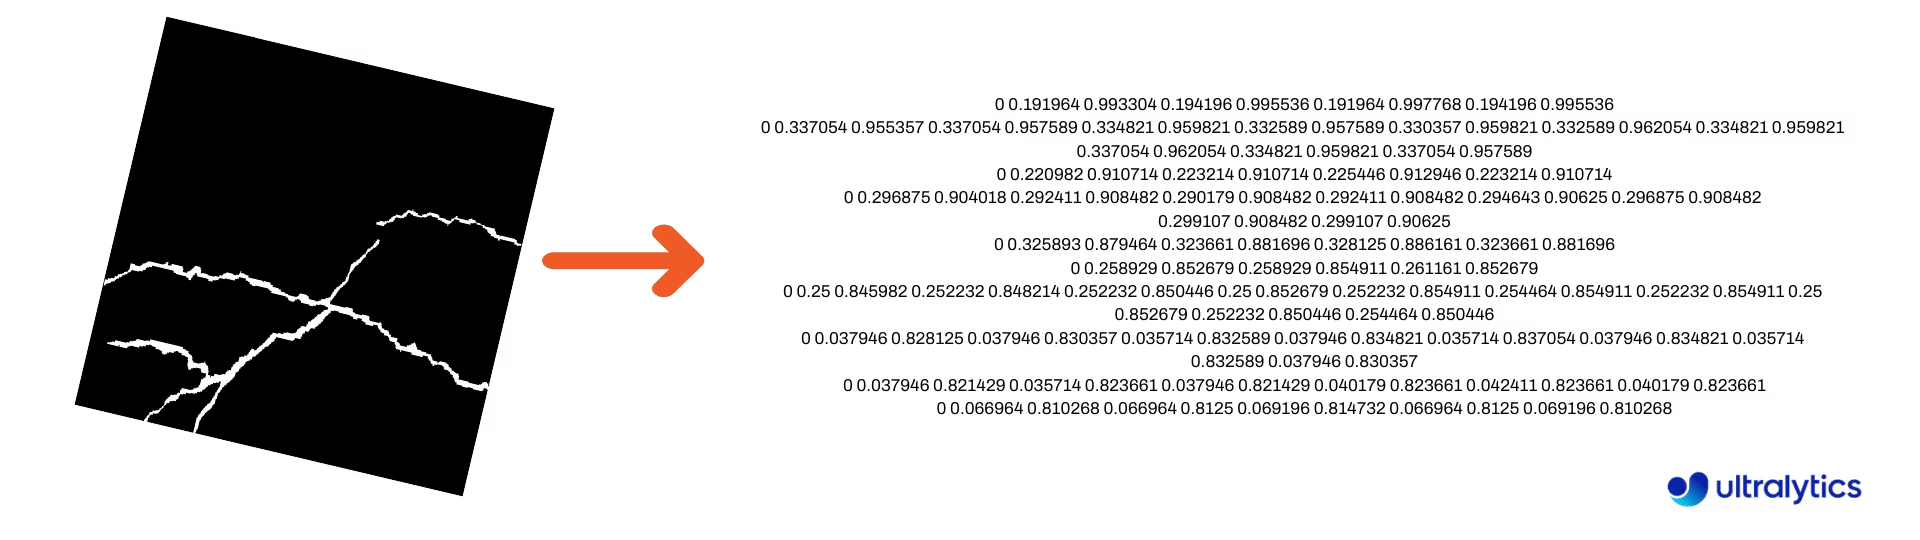
Utilise cette fonction pour convertir un jeu de données d’images de masques de segmentation au format de segmentation Ultralytics YOLO. Elle prend le répertoire contenant les images de masque au format binaire et les convertit au format de segmentation YOLO.
Les masques convertis seront enregistrés dans le répertoire de sortie spécifié.
from ultralytics.data.converter import convert_segment_masks_to_yolo_seg

# `classes` correspond au nombre total de classes du jeu de données.
# Le jeu de données COCO contient 80 classes.
convert_segment_masks_to_yolo_seg(masks_dir="path/to/masks_dir", output_dir="path/to/output_dir", classes=80)
Convertir COCO au format YOLO#
Utilise cette fonction pour convertir les annotations JSON de COCO au format YOLO. Pour les jeux de données de détection d’objets (boîtes englobantes), définis use_segments et use_keypoints sur False.
from ultralytics.data.converter import convert_coco

convert_coco(
    "coco/annotations/",
    use_segments=False,
    use_keypoints=False,
    cls91to80=True,
)
Pour plus d’informations sur la fonction convert_coco, consulte la page de référence.
Obtenir les dimensions des boîtes englobantes#
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import Annotator

model = YOLO("yolo26n.pt")  # Load pretrain or fine-tune model

# Process the image
source = cv2.imread("path/to/image.jpg")
results = model(source)

# Extract results
annotator = Annotator(source, example=model.names)

for box in results[0].boxes.xyxy.cpu():
    width, height, area = annotator.get_bbox_dimension(box)
    print(f"Bounding Box Width {width.item()}, Height {height.item()}, Area {area.item()}")
Convertir les boîtes englobantes en segments#
À partir de données existantes de boîtes englobantes x y w h, convertis-les en segments à l’aide de la fonction yolo_bbox2segment. Organise les fichiers d’images et d’annotations comme suit :
data
|__ images
    ├─ 001.jpg
    ├─ 002.jpg
    ├─ ..
    └─ NNN.jpg
|__ labels
    ├─ 001.txt
    ├─ 002.txt
    ├─ ..
    └─ NNN.txt
from ultralytics.data.converter import yolo_bbox2segment
yolo_bbox2segment(
im_dir="path/to/images",
save_dir=None, # enregistré dans « labels-segment » à côté du répertoire des images
sam_model="sam_b.pt",
)Consulte la page de référence de yolo_bbox2segment pour en savoir plus sur la fonction.
Convertir des segments en boîtes englobantes#
Si ton jeu de données utilise le format de jeu de données de segmentation, tu peux facilement convertir ces éléments en boîtes englobantes droites (ou horizontales) au format x y w h avec cette fonction.
import numpy as np

from ultralytics.utils.ops import segments2boxes

segments = np.array(
    [
        [805, 392, 797, 400, 812, 402, 808, 714, 808, 392],
        [115, 398, 113, 400, 150, 410, 150, 400, 149, 298],
        [267, 412, 265, 413, 300, 420, 300, 413, 299, 412],
    ],
    dtype=np.float32,
)

segments2boxes([s.reshape(-1, 2) for s in segments])
# >>> array([[804.5, 553. ,  15. , 322. ],
#           [131.5, 354. ,  37. , 112. ],
#           [282.5, 416. ,  35. ,   8. ]],
# dtype=float32) # boîtes englobantes xywh
Pour comprendre le fonctionnement de cette fonction, consulte la page de référence.
Utilitaires#
Compression d’images#
Compresse un fichier image unique pour en réduire la taille tout en préservant ses proportions et sa qualité. Si l’image d’entrée est plus petite que la dimension maximale, elle ne sera pas redimensionnée.
from pathlib import Path

from ultralytics.data.utils import compress_one_image

for f in Path("path/to/dataset").rglob("*.jpg"):
    compress_one_image(f)
Fractionnement automatique du jeu de données#
Fractionne automatiquement un jeu de données en sous-ensembles train/val/test et enregistre les sous-ensembles obtenus dans des fichiers autosplit_*.txt. Cet utilitaire crée des fichiers de fractionnement persistants ; l’argument d’entraînement fraction sélectionne plutôt un sous-ensemble reproductible pour une exécution.
from ultralytics.data.split import autosplit

autosplit(
    path="path/to/images",
    weights=(0.9, 0.1, 0.0),  # (entraînement, validation, test) fractionnements proportionnels
    annotated_only=False,  # ne fractionner que les images ayant un fichier d’annotation lorsque la valeur est True
)
Consulte la page de référence pour plus de détails sur cette fonction.
Polygone de segmentation vers masque binaire#
Convertit un polygone unique (sous forme de liste) en masque binaire aux dimensions d’image spécifiées. Le polygone doit être un tableau 1D aplati de coordonnées N, constitué de valeurs x, y alternées qui définissent le contour du polygone.
N doit toujours être pair.
import numpy as np

from ultralytics.data.utils import polygon2mask

imgsz = (1080, 810)
polygon = np.array([805, 392, 797, 400, ..., 808, 714, 808, 392])  # (N,) coordonnées x, y aplaties

mask = polygon2mask(
    imgsz,  # tuple
    [polygon],  # entrée sous forme de liste
    color=255,  # binaire 8 bits
    downsample_ratio=1,
)
Boîtes englobantes#
Instances de boîtes englobantes (horizontales)#
Pour gérer les données de boîtes englobantes, la classe Bboxes permet de convertir les formats de coordonnées des boîtes, de mettre leurs dimensions à l’échelle, de calculer leurs surfaces, d’ajouter des décalages et bien plus encore.
import numpy as np

from ultralytics.utils.instance import Bboxes

boxes = Bboxes(
    bboxes=np.array(
        [
            [22.878, 231.27, 804.98, 756.83],
            [48.552, 398.56, 245.35, 902.71],
            [669.47, 392.19, 809.72, 877.04],
            [221.52, 405.8, 344.98, 857.54],
            [0, 550.53, 63.01, 873.44],
            [0.0584, 254.46, 32.561, 324.87],
        ]
    ),
    format="xyxy",
)

boxes.areas()
# >>> array([ 4.1104e+05,       99216,       68000,       55772,       20347,      2288.5])

boxes.convert("xywh")
print(boxes.bboxes)
# >>> array(
#     [[ 413.93, 494.05,  782.1, 525.56],
#      [ 146.95, 650.63,  196.8, 504.15],
#      [  739.6, 634.62, 140.25, 484.85],
#      [ 283.25, 631.67, 123.46, 451.74],
#      [ 31.505, 711.99,  63.01, 322.91],
#      [  16.31, 289.67, 32.503,  70.41]]
# )
Consulte la section de référence de Bboxes pour découvrir d’autres attributs et méthodes.
Tu peux accéder à bon nombre des fonctions suivantes (et à d’autres) avec la classe Bboxes, mais si tu préfères utiliser directement les fonctions, consulte les sous-sections suivantes pour savoir comment les importer séparément.
Mise à l’échelle des boîtes#
Lorsque tu agrandis ou réduis une image, tu peux mettre à l’échelle les coordonnées des boîtes englobantes correspondantes pour les adapter, à l’aide de ultralytics.utils.ops.scale_boxes.
import cv2 as cv
import numpy as np

from ultralytics.utils.ops import scale_boxes

image = cv.imread("ultralytics/assets/bus.jpg")
h, w, c = image.shape
resized = cv.resize(image, None, fx=1.2, fy=1.2)
new_h, new_w, _ = resized.shape

xyxy_boxes = np.array(
    [
        [22.878, 231.27, 804.98, 756.83],
        [48.552, 398.56, 245.35, 902.71],
        [669.47, 392.19, 809.72, 877.04],
        [221.52, 405.8, 344.98, 857.54],
        [0, 550.53, 63.01, 873.44],
        [0.0584, 254.46, 32.561, 324.87],
    ]
)

new_boxes = scale_boxes(
    img1_shape=(h, w),  # dimensions de l’image d’origine
    boxes=xyxy_boxes,  # boîtes de l’image d’origine
    img0_shape=(new_h, new_w),  # dimensions de l’image redimensionnée (échelle cible)
    ratio_pad=None,
    padding=False,
    xywh=False,
)

print(new_boxes)
# >>> array(
#     [[  27.454,  277.52,  965.98,   908.2],
#     [   58.262,  478.27,  294.42,  1083.3],
#     [   803.36,  470.63,  971.66,  1052.4],
#     [   265.82,  486.96,  413.98,    1029],
#     [        0,  660.64,  75.612,  1048.1],
#     [   0.0701,  305.35,  39.073,  389.84]]
# )
Conversions de format des boîtes englobantes#
XYXY → XYWH#
Convertit les coordonnées des boîtes englobantes du format (x1, y1, x2, y2) au format (x, y, largeur, hauteur), où (x1, y1) correspond au coin supérieur gauche et (x2, y2) au coin inférieur droit.
import numpy as np

from ultralytics.utils.ops import xyxy2xywh

xyxy_boxes = np.array(
    [
        [22.878, 231.27, 804.98, 756.83],
        [48.552, 398.56, 245.35, 902.71],
        [669.47, 392.19, 809.72, 877.04],
        [221.52, 405.8, 344.98, 857.54],
        [0, 550.53, 63.01, 873.44],
        [0.0584, 254.46, 32.561, 324.87],
    ]
)
xywh = xyxy2xywh(xyxy_boxes)

print(xywh)
# >>> array(
#     [[ 413.93,  494.05,   782.1, 525.56],
#     [  146.95,  650.63,   196.8, 504.15],
#     [   739.6,  634.62,  140.25, 484.85],
#     [  283.25,  631.67,  123.46, 451.74],
#     [  31.505,  711.99,   63.01, 322.91],
#     [   16.31,  289.67,  32.503,  70.41]]
# )
Toutes les conversions de boîtes englobantes#
from ultralytics.utils.ops import (
    ltwh2xywh,
    ltwh2xyxy,
    xywh2ltwh,  # xywh → coin supérieur gauche, largeur, hauteur
    xywh2xyxy,
    xywhn2xyxy,  # normalisé → pixels
    xyxy2ltwh,  # xyxy → coin supérieur gauche, largeur, hauteur
    xyxy2xywhn,  # pixels → normalisé
)

for func in (ltwh2xywh, ltwh2xyxy, xywh2ltwh, xywh2xyxy, xywhn2xyxy, xyxy2ltwh, xyxy2xywhn):
    print(help(func))  # afficher les docstrings des fonctions
Consulte la docstring de chaque fonction ou visite la ultralytics.utils.ops page de référence pour en savoir plus.
Tracé#
Utilitaires d’annotation#
Ultralytics inclut une classe Annotator pour annoter différents types de données. Elle est particulièrement adaptée aux boîtes englobantes de détection d’objets, aux points clés de pose et aux boîtes englobantes orientées.
Annotation des boîtes#
import cv2 as cv
import numpy as np

from ultralytics.utils.plotting import Annotator, colors

names = {
    0: "person",
    5: "bus",
    11: "stop sign",
}

image = cv.imread("ultralytics/assets/bus.jpg")
ann = Annotator(
    image,
    line_width=None,  # default auto-size
    font_size=None,  # default auto-size
    font="Arial.ttf",  # must be ImageFont compatible
    pil=False,  # use PIL, otherwise uses OpenCV
)

xyxy_boxes = np.array(
    [
        [5, 22.878, 231.27, 804.98, 756.83],  # class-idx x1 y1 x2 y2
        [0, 48.552, 398.56, 245.35, 902.71],
        [0, 669.47, 392.19, 809.72, 877.04],
        [0, 221.52, 405.8, 344.98, 857.54],
        [0, 0, 550.53, 63.01, 873.44],
        [11, 0.0584, 254.46, 32.561, 324.87],
    ]
)

for nb, box in enumerate(xyxy_boxes):
    c_idx, *box = box
    label = f"{str(nb).zfill(2)}:{names.get(int(c_idx))}"
    ann.box_label(box, label, color=colors(c_idx, bgr=True))

image_with_bboxes = ann.result()
Tu peux utiliser les noms de model.names lorsque tu travailles avec les résultats de détection. Consulte également la page de référence Annotator pour plus de détails.
Annotation par balayage avec Ultralytics#
import sys

import cv2
import numpy as np

from ultralytics import YOLO
from ultralytics.solutions.solutions import SolutionAnnotator
from ultralytics.utils.plotting import colors

# User defined video path and model file
cap = cv2.VideoCapture("path/to/video.mp4")
model = YOLO(model="yolo26s-seg.pt")  # Model file, e.g., yolo26s.pt or yolo26m-seg.pt

if not cap.isOpened():
    print("Error: Could not open video.")
    sys.exit()

# Initialize the video writer object.
w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS))
video_writer = cv2.VideoWriter("ultralytics.avi", cv2.VideoWriter_fourcc(*"mp4v"), fps, (w, h))

masks = None  # Initialize variable to store masks data
f = 0  # Initialize frame count variable for enabling mouse event.
line_x = w  # Store width of line.
dragging = False  # Initialize bool variable for line dragging.
classes = model.names  # Store model classes names for plotting.
window_name = "Ultralytics Sweep Annotator"

def drag_line(event, x, _, flags, param):
    """Mouse callback function to enable dragging a vertical sweep line across the video frame."""
    global line_x, dragging
    if event == cv2.EVENT_LBUTTONDOWN or (flags & cv2.EVENT_FLAG_LBUTTON):
        line_x = max(0, min(x, w))
        dragging = True

while cap.isOpened():  # Loop over the video capture object.
    ret, im0 = cap.read()
    if not ret:
        break
    f = f + 1  # Increment frame count.
    count = 0  # Re-initialize count variable on every frame for precise counts.
    results = model.track(im0, persist=True)[0]

    if f == 1:
        cv2.namedWindow(window_name)
        cv2.setMouseCallback(window_name, drag_line)

    annotator = SolutionAnnotator(im0)

    if results.boxes.is_track:
        if results.masks is not None:
            masks = [np.array(m, dtype=np.int32) for m in results.masks.xy]

        boxes = results.boxes.xyxy.tolist()
        track_ids = results.boxes.id.int().cpu().tolist()
        clss = results.boxes.cls.cpu().tolist()

        for mask, box, cls, t_id in zip(masks or [None] * len(boxes), boxes, clss, track_ids):
            color = colors(t_id, True)  # Assign different color to each tracked object.
            label = f"{classes[cls]}:{t_id}"
            if mask is not None and mask.size > 0:
                if box[0] > line_x:
                    count += 1
                    cv2.polylines(im0, [mask], True, color, 2)
                    x, y = mask.min(axis=0)
                    (w_m, _), _ = cv2.getTextSize(label, cv2.FONT_HERSHEY_SIMPLEX, 0.5, 1)
                    cv2.rectangle(im0, (x, y - 20), (x + w_m, y), color, -1)
                    cv2.putText(im0, label, (x, y - 5), cv2.FONT_HERSHEY_SIMPLEX, 0.5, (255, 255, 255), 1)
            else:
                if box[0] > line_x:
                    count += 1
                    annotator.box_label(box=box, color=color, label=label)

    # Generate draggable sweep line
    annotator.sweep_annotator(line_x=line_x, line_y=h, label=f"COUNT:{count}")

    cv2.imshow(window_name, im0)
    video_writer.write(im0)
    if cv2.waitKey(1) & 0xFF == ord("q"):
        break

# Release the resources
cap.release()
video_writer.release()
cv2.destroyAllWindows()
Tu trouveras plus de détails sur la méthode sweep_annotator dans notre section de référence ici.
Annotation adaptative des étiquettes#
SolutionAnnotator.adaptive_label dessine une étiquette dont la forme est déterminée par l’argument shape (qui remplace les anciennes méthodes circle_label et text_label) :
- Rectangle :
annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="rect") - Cercle :
annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="circle")
Regarder : Guide détaillé des annotations de texte et de cercle avec démonstrations en direct Python | Annotations Ultralytics 🚀
import cv2

from ultralytics import YOLO
from ultralytics.solutions.solutions import SolutionAnnotator
from ultralytics.utils.plotting import colors

model = YOLO("yolo26s.pt")
names = model.names
cap = cv2.VideoCapture("path/to/video.mp4")

w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS))
writer = cv2.VideoWriter("Ultralytics circle annotation.avi", cv2.VideoWriter_fourcc(*"MJPG"), fps, (w, h))

while True:
    ret, im0 = cap.read()
    if not ret:
        break

    annotator = SolutionAnnotator(im0)
    results = model.predict(im0)[0]
    boxes = results.boxes.xyxy.cpu()
    clss = results.boxes.cls.cpu().tolist()

    for box, cls in zip(boxes, clss):
        annotator.adaptive_label(box, label=names[int(cls)], color=colors(cls, True), shape="circle")
    writer.write(im0)
    cv2.imshow("Ultralytics circle annotation", im0)

    if cv2.waitKey(1) & 0xFF == ord("q"):
        break

writer.release()
cap.release()
cv2.destroyAllWindows()
Consulte la page de référence SolutionAnnotator pour en savoir plus.
Divers#
Profilage du code#
Vérifie la durée d’exécution ou de traitement du code à l’aide de with ou d’un décorateur.
from ultralytics.utils.ops import Profile

with Profile(device="cuda:0") as dt:
    pass  # opération à mesurer

print(dt)
# >>> "Elapsed time is 9.5367431640625e-07 s"
Formats pris en charge par Ultralytics#
Tu dois utiliser par programmation les formats d’image ou de vidéo pris en charge par Ultralytics ? Utilise ces constantes si nécessaire :
from ultralytics.data.utils import IMG_FORMATS, VID_FORMATS

print(IMG_FORMATS)
# {'avif', 'bmp', 'dng', 'heic', 'heif', 'jp2', 'jpeg', 'jpg', 'mpo', 'png', 'tif', 'tiff', 'webp'}

print(VID_FORMATS)
# {'asf', 'avi', 'gif', 'm4v', 'mkv', 'mov', 'mp4', 'mpeg', 'mpg', 'ts', 'wmv', 'webm'}
Rendre divisible#
Calcule le plus petit entier supérieur ou égal à x qui est divisible par y.
from ultralytics.utils.ops import make_divisible

make_divisible(7, 3)
# >>> 9
make_divisible(7, 2)
# >>> 8FAQ#
Le package Ultralytics inclut des utilitaires conçus pour rationaliser et optimiser les workflows de machine learning. Parmi les principaux utilitaires figurent l’annotation automatique des jeux de données, la conversion de COCO au format YOLO avec convert_coco, la compression d’images et le fractionnement automatique des jeux de données. Ces outils réduisent les tâches manuelles, assurent la cohérence et améliorent l’efficacité du traitement des données.
Si tu disposes d’un modèle Ultralytics YOLO de détection d’objets préentraîné, tu peux l’utiliser avec le modèle SAM pour annoter automatiquement ton jeu de données au format de segmentation. Voici un exemple :
from ultralytics.data.annotator import auto_annotate

auto_annotate(
    data="path/to/new/data",
    det_model="yolo26n.pt",
    sam_model="mobile_sam.pt",
    device="cuda",
    output_dir="path/to/save_labels",
)
Pour en savoir plus, consulte la section de référence auto_annotate, ou utilise Ultralytics Platform, une alternative hébergée sans code qui permet de créer des masques en cliquant avec SAM 2.1, SAM 3 ou SAM 3.1, ou d’obtenir des prédictions de modèles YOLO préentraînés et affinés pour les tâches de détection, de segmentation et d’OBB.
Pour convertir des annotations JSON COCO au format YOLO pour la détection d’objets, tu peux utiliser l’utilitaire
convert_coco. Voici un exemple de code :from ultralytics.data.converter import convert_coco convert_coco( "coco/annotations/", use_segments=False, use_keypoints=False, cls91to80=True, )Pour plus d’informations, consulte la page de référence convert_coco.
Ultralytics Platform fournit des analyses automatiques des jeux de données : l’onglet
Chartsaffiche la distribution des partitions, le nombre d’instances des principales classes, des histogrammes des dimensions des images et des cartes thermiques 2D des positions des annotations, ce qui t’aide à repérer les déséquilibres et les valeurs aberrantes avant l’entraînement.Pour convertir des données de boîtes englobantes existantes (au format
x y w h) en segments, tu peux utiliser la fonctionyolo_bbox2segment. Veille à organiser tes fichiers dans des répertoires distincts pour les images et les étiquettes.from ultralytics.data.converter import yolo_bbox2segment yolo_bbox2segment( im_dir="path/to/images", save_dir=None, # enregistré dans « labels-segment » à côté du répertoire des images sam_model="sam_b.pt", )Pour en savoir plus, consulte la page de référence yolo_bbox2segment.