Dataset xView#
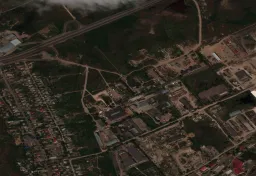
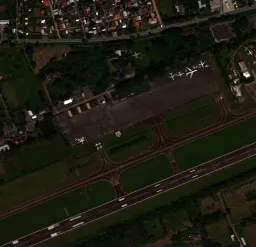
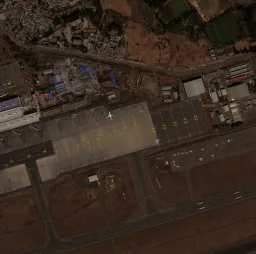
Il dataset xView è uno dei più grandi benchmark di immagini satellitari disponibili al pubblico per il rilevamento degli oggetti: offre oltre 1 milione di istanze di oggetti in 60 classi, annotate con bounding box su oltre 1.400 km² di immagini WorldView-3 a 0,3 m. È stato rilasciato per la DIUx xView 2018 Challenge dalla National Geospatial-Intelligence Agency (NGA) degli Stati Uniti e richiede un download manuale di circa 20,7 GB.
Il dataset è stato creato per ampliare quattro frontiere della visione artificiale:
- Ridurre la risoluzione minima per il rilevamento.
- Migliorare l'efficienza dell'apprendimento.
- Consentire la scoperta di un maggior numero di classi di oggetti.
- Migliorare il rilevamento delle classi a grana fine.
Sulla scia di benchmark come COCO, xView si concentra sulle immagini aeree, dove gli oggetti sono molto più piccoli e densi rispetto alle foto scattate da terra.
Il dataset xView non viene scaricato automaticamente. Registrati sul sito della DIUx xView 2018 Challenge per scaricare train_images.zip (~15 GB), train_labels.zip e val_images.zip (~5 GB), quindi estraili in datasets/xView/ in modo che contenga:
datasets/xView/
├── train_images/          # 847 TIF satellite images
├── val_images/            # 282 TIF images (no public labels)
└── xView_train.geojson    # bounding-box annotations
Al primo avvio dell'addestramento, Ultralytics converte le annotazioni GeoJSON nel formato YOLO e suddivide automaticamente le immagini etichettate in set di addestramento e validazione, con una proporzione di circa 90/10 — non è necessaria alcuna conversione manuale.
Funzionalità principali#
- Classi a grana fine: 60 classi di oggetti che includono aeromobili, veicoli, materiale rotabile, imbarcazioni, attrezzature da costruzione ed edifici — molti dei quali piccoli, rari e visivamente simili.
- Alta risoluzione: distanza di campionamento al suolo di 0,3 m acquisita dai satelliti WorldView-3.
- Annotazioni dense: oltre 1 milione di istanze di oggetti su più di 1.400 km² di immagini, tutte etichettate con bounding box orizzontali.
- Conversione automatica: al primo utilizzo, lo script di download di Ultralytics converte le etichette GeoJSON originali nel formato YOLO e genera lo split train/val.
Struttura del dataset#
Le immagini xView sono grandi scene satellitari in formato TIF e solo le 847 immagini di addestramento sono distribuite con etichette pubbliche: il set di validazione della challenge, composto da 282 immagini, ne è privo. Di conseguenza, al primo utilizzo la configurazione xView.yaml di Ultralytics suddivide automaticamente le immagini etichettate:
| Subset | Immagini | Descrizione |
|---|---|---|
| Addestra | ~90% di 847 | Immagini etichettate elencate in autosplit_train.txt, generate alla prima esecuzione |
| Validazione | ~10% di 847 | Immagini etichettate elencate in autosplit_val.txt, usate per la valutazione |
Le 60 classi includono categorie a grana fine come aeromobile ad ala fissa, aereo cargo, automobile piccola, autobus, locomotiva, imbarcazione, escavatore, edificio, hangar per aeromobili e serbatoio di stoccaggio; l'elenco completo è disponibile nel file YAML del dataset qui sotto. Durante la conversione, gli ID delle classi originali della challenge (11–94) vengono rimappati a indici consecutivi da 0 a 59.
Applicazioni#
Le classi a grana fine e la prospettiva aerea ad alta risoluzione di xView ne fanno un benchmark standard per addestrare e valutare modelli di deep learning nel telerilevamento. Le applicazioni comuni includono:
- Ricognizione militare e difesa
- Pianificazione e sviluppo urbano
- Monitoraggio ambientale
- Risposta e valutazione in caso di calamità
- Mappatura e gestione delle infrastrutture
Per altri benchmark basati su immagini aeree, consulta il dataset VisDrone, incentrato sui droni, oppure il dataset DOTA-v2, con bounding box orientate.
YAML del dataset#
Il file xView.yaml definisce la configurazione del dataset: i percorsi del dataset, i nomi delle 60 classi e lo script di download che converte le annotazioni GeoJSON e genera lo split automatico. È gestito nel repository Ultralytics all'indirizzo https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/xView.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DIUx xView 2018 Challenge dataset https://challenge.xviewdataset.org by U.S. National Geospatial-Intelligence Agency (NGA)
# --------  Download and extract data manually to `datasets/xView` before running the train command.  --------
# Documentation: https://docs.ultralytics.com/datasets/detect/xview
# Example usage: yolo train data=xView.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── xView ← downloads here (20.7 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: xView # dataset root dir
train: images/autosplit_train.txt # train images (relative to 'path') 90% of 847 train images
val: images/autosplit_val.txt # val images (relative to 'path') 10% of 847 train images

# Classes
names:
  0: Fixed-wing Aircraft
  1: Small Aircraft
  2: Cargo Plane
  3: Helicopter
  4: Passenger Vehicle
  5: Small Car
  6: Bus
  7: Pickup Truck
  8: Utility Truck
  9: Truck
  10: Cargo Truck
  11: Truck w/Box
  12: Truck Tractor
  13: Trailer
  14: Truck w/Flatbed
  15: Truck w/Liquid
  16: Crane Truck
  17: Railway Vehicle
  18: Passenger Car
  19: Cargo Car
  20: Flat Car
  21: Tank car
  22: Locomotive
  23: Maritime Vessel
  24: Motorboat
  25: Sailboat
  26: Tugboat
  27: Barge
  28: Fishing Vessel
  29: Ferry
  30: Yacht
  31: Container Ship
  32: Oil Tanker
  33: Engineering Vehicle
  34: Tower crane
  35: Container Crane
  36: Reach Stacker
  37: Straddle Carrier
  38: Mobile Crane
  39: Dump Truck
  40: Haul Truck
  41: Scraper/Tractor
  42: Front loader/Bulldozer
  43: Excavator
  44: Cement Mixer
  45: Ground Grader
  46: Hut/Tent
  47: Shed
  48: Building
  49: Aircraft Hangar
  50: Damaged Building
  51: Facility
  52: Construction Site
  53: Vehicle Lot
  54: Helipad
  55: Storage Tank
  56: Shipping container lot
  57: Shipping Container
  58: Pylon
  59: Tower

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  from pathlib import Path
  import shutil

  import numpy as np
  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.data.split import autosplit
  from ultralytics.utils.ops import xyxy2xywhn

  def convert_labels(fname=Path("xView/xView_train.geojson")):
      """Convert xView GeoJSON labels to YOLO format (classes 0-59) and save them as text files."""
      path = fname.parent
      with open(fname, encoding="utf-8") as f:
          print(f"Loading {fname}...")
          data = json.load(f)

      # Make dirs
      labels = path / "labels" / "train"
      shutil.rmtree(labels, ignore_errors=True)
      labels.mkdir(parents=True, exist_ok=True)

      # xView classes 11-94 to 0-59
      xview_class2index = [-1, -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, 0, 1, 2, -1, 3, -1, 4, 5, 6, 7, 8, -1, 9, 10, 11,
                           12, 13, 14, 15, -1, -1, 16, 17, 18, 19, 20, 21, 22, -1, 23, 24, 25, -1, 26, 27, -1, 28, -1,
                           29, 30, 31, 32, 33, 34, 35, 36, 37, -1, 38, 39, 40, 41, 42, 43, 44, 45, -1, -1, -1, -1, 46,
                           47, 48, 49, -1, 50, 51, -1, 52, -1, -1, -1, 53, 54, -1, 55, -1, -1, 56, -1, 57, -1, 58, 59]

      shapes = {}
      for feature in TQDM(data["features"], desc=f"Converting {fname}"):
          p = feature["properties"]
          if p["bounds_imcoords"]:
              image_id = p["image_id"]
              image_file = path / "train_images" / image_id
              if image_file.exists():  # 1395.tif missing
                  try:
                      box = np.array([int(num) for num in p["bounds_imcoords"].split(",")])
                      assert box.shape[0] == 4, f"incorrect box shape {box.shape[0]}"
                      cls = p["type_id"]
                      cls = xview_class2index[int(cls)]  # xView class to 0-59
                      assert 59 >= cls >= 0, f"incorrect class index {cls}"

                      # Write YOLO label
                      if image_id not in shapes:
                          shapes[image_id] = Image.open(image_file).size
                      box = xyxy2xywhn(box[None].astype(float), w=shapes[image_id][0], h=shapes[image_id][1], clip=True)
                      with open((labels / image_id).with_suffix(".txt"), "a", encoding="utf-8") as f:
                          f.write(f"{cls} {' '.join(f'{x:.6f}' for x in box[0])}\n")  # write label.txt
                  except Exception as e:
                      print(f"WARNING: skipping one label for {image_file}: {e}")

  # Download manually from https://challenge.xviewdataset.org
  dir = Path(yaml["path"])  # dataset root dir
  # urls = [
  #     "https://d307kc0mrhucc3.cloudfront.net/train_labels.zip",  # train labels
  #     "https://d307kc0mrhucc3.cloudfront.net/train_images.zip",  # 15G, 847 train images
  #     "https://d307kc0mrhucc3.cloudfront.net/val_images.zip",  # 5G, 282 val images (no labels)
  # ]
  # download(urls, dir=dir)

  # Convert labels
  convert_labels(dir / "xView_train.geojson")

  # Move images
  images = Path(dir / "images")
  images.mkdir(parents=True, exist_ok=True)
  Path(dir / "train_images").rename(dir / "images" / "train")
  Path(dir / "val_images").rename(dir / "images" / "val")

  # Split
autosplit(dir / "images" / "train")Utilizzo#
Per l'addestramento è necessario estrarre il download manuale descritto sopra in datasets/xView/; la conversione delle annotazioni e lo split train/val vengono quindi eseguiti automaticamente.
Per addestrare un modello sul dataset xView per 100 epoche con una dimensione dell'immagine di 640, puoi usare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Training del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="xView.yaml", epochs=100, imgsz=640)
Per etichettare altre immagini satellitari e gestire nel browser le esecuzioni di addestramento di xView, usa Ultralytics Platform.
Dati di esempio e annotazioni#
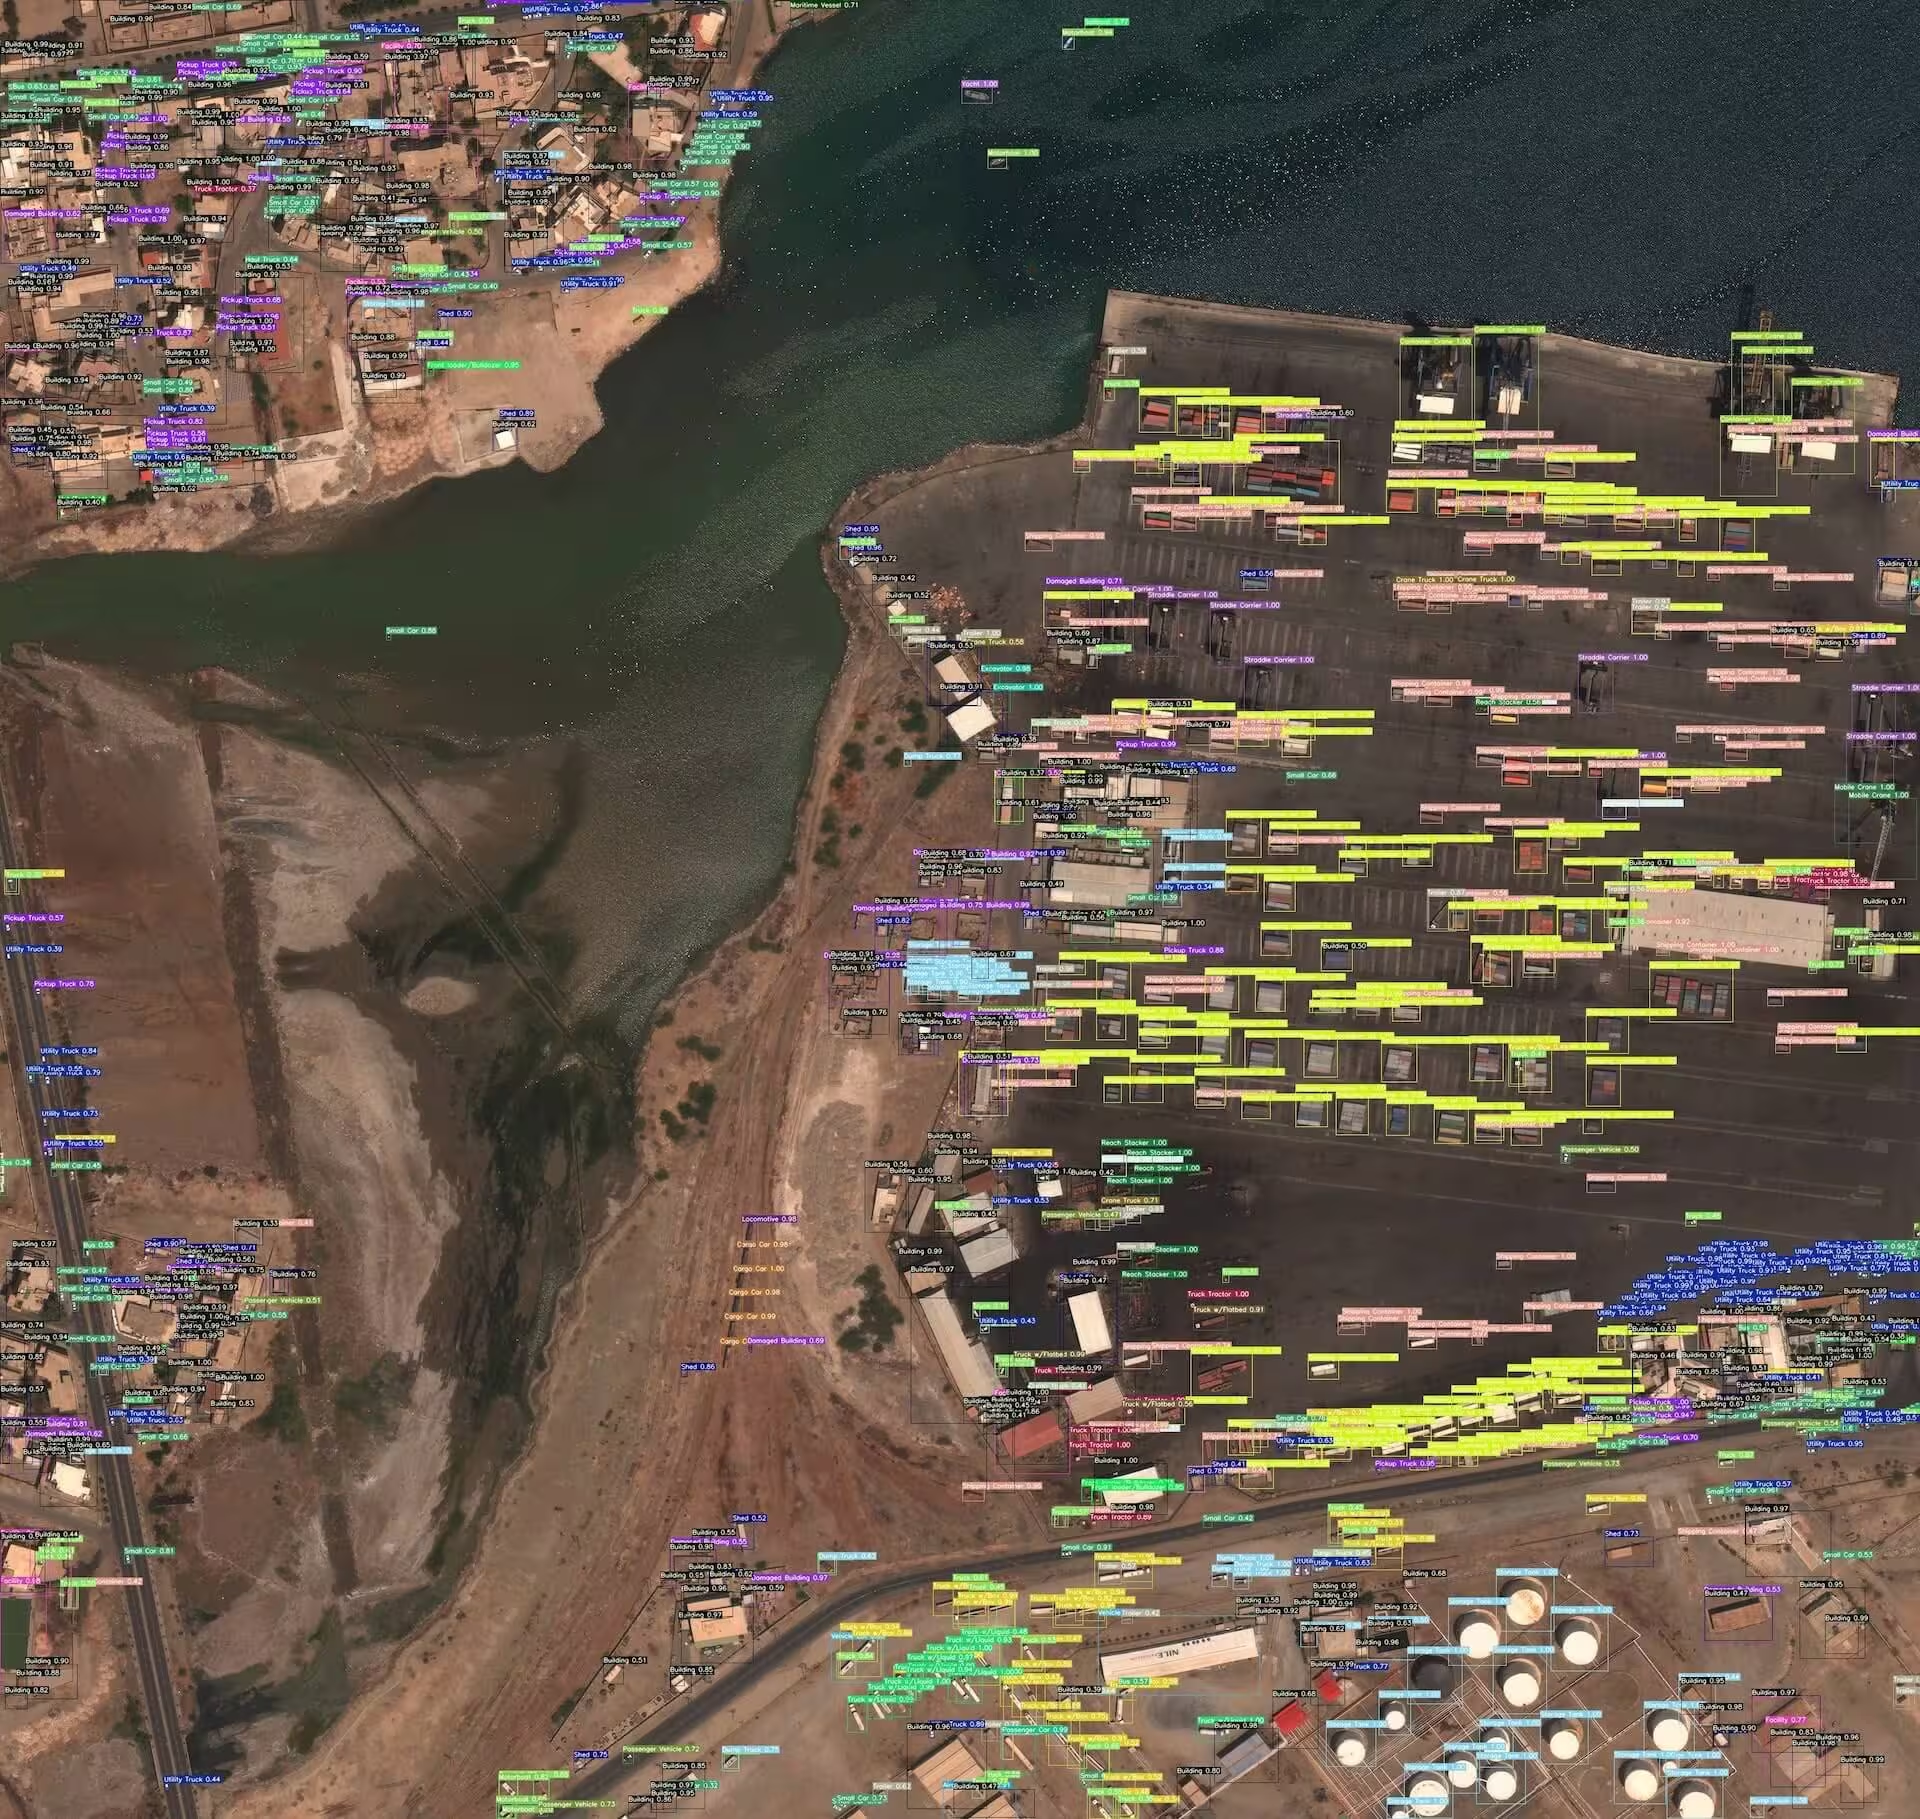
L'esempio qui sotto mostra una scena xView tipica: immagini aeree ad alta risoluzione in cui piccoli oggetti come veicoli ed edifici sono annotati con bounding box, a dimostrazione del fatto che il rilevamento degli oggetti nelle immagini satellitari richiede una localizzazione precisa a grana fine.
Citazioni e ringraziamenti#
Se usi il dataset xView nel tuo lavoro di ricerca o sviluppo, cita il seguente articolo:
@misc{lam2018xview,
      title={xView: Objects in Context in Overhead Imagery},
      author={Darius Lam and Richard Kuzma and Kevin McGee and Samuel Dooley and Michael Laielli and Matthew Klaric and Yaroslav Bulatov and Brendan McCord},
      year={2018},
      eprint={1802.07856},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Desideriamo ringraziare la Defense Innovation Unit (DIU) e i creatori del dataset xView per il loro prezioso contributo alla comunità di ricerca sulla visione artificiale. Per ulteriori informazioni, visita il sito web del dataset xView.
Domande frequenti#
Il dataset xView è un benchmark di immagini satellitari rilasciato per la DIUx xView 2018 Challenge dalla National Geospatial-Intelligence Agency degli Stati Uniti; offre oltre 1 milione di istanze di oggetti in 60 classi a grana fine, in immagini WorldView-3 a 0,3 m. Supporta la ricerca sul rilevamento di oggetti piccoli, rari e a grana fine nelle viste aeree, che sono molto più difficili da analizzare rispetto alle foto scattate da terra.
xView richiede un download manuale: registrati sul sito della DIUx xView 2018 Challenge, scarica
train_images.zip(~15 GB),train_labels.zipeval_images.zip(~5 GB) — circa 20,7 GB in totale — ed estraili indatasets/xView/seguendo la struttura mostrata nell'avviso in cima a questa pagina. Al primo avvio dell'addestramento, Ultralytics converte automaticamente le annotazioni GeoJSON nel formato YOLO e crea lo split di addestramento e validazione.xView contiene 847 immagini di addestramento etichettate e 282 immagini di validazione senza etichette pubbliche, tutte acquisite dai satelliti WorldView-3 a una risoluzione di 0,3 m. Le annotazioni coprono oltre 1 milione di istanze di oggetti in 60 classi. Poiché sono pubbliche solo le etichette di addestramento, la configurazione
xView.yamldi Ultralytics suddivide le 847 immagini etichettate in set di addestramento e validazione, con una proporzione di circa 90/10; per i dettagli, consulta Struttura del dataset.Addestra un modello YOLO26n su xView per 100 epoche con una dimensione dell'immagine di 640:
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="xView.yaml", epochs=100, imgsz=640)Per informazioni dettagliate su argomenti e impostazioni, consulta la pagina Training del modello.
Cita l'articolo "xView: Objects in Context in Overhead Imagery" (Lam et al., arXiv:1802.07856, 2018); la voce BibTeX completa è nella sezione Citazioni e ringraziamenti qui sopra.