Come testare i modelli di visione artificiale#
Introduzione#
Il test di un modello verifica come si comporta un modello addestrato su dati reali mai visti prima: oggetti in movimento, scarsamente illuminati o parzialmente nascosti, anziché esempi di un benchmark selezionato. Mentre la valutazione del modello misura le metriche su un set di dati etichettato, il test verifica che il comportamento appreso dal modello sia in linea con gli obiettivi della tua applicazione prima della distribuzione. Questa guida illustra come preparare i dati di test, testare i modelli Ultralytics YOLO26 e individuare l'overfitting, l'underfitting e la perdita di dati.
Guarda: Come testare i modelli di machine learning | Evita la fuga di dati nella visione artificiale 🚀
Test del modello e valutazione del modello#
Il test e la valutazione del modello sono due fasi distinte di un progetto di visione artificiale. La valutazione misura le prestazioni con metriche su un set di dati etichettato; il test verifica se il comportamento appreso dal modello regge in condizioni simili a quelle della distribuzione.
Supponiamo che tu abbia addestrato un modello di visione artificiale per riconoscere gatti e cani e voglia distribuirlo in un negozio di animali per monitorare gli animali. Durante la fase di valutazione del modello, usi un set di dati etichettato per calcolare metriche come accuratezza, precisione e richiamo. Per esempio, il modello potrebbe raggiungere un'accuratezza del 98% nel distinguere cani e gatti in un determinato set di dati.
Dopo la valutazione, testi il modello usando immagini provenienti da un negozio di animali per verificare quanto bene riconosce cani e gatti in condizioni più varie e realistiche. Controlli se riesce a etichettare correttamente cani e gatti quando sono in movimento, in condizioni di illuminazione diverse o parzialmente nascosti da oggetti come giocattoli o mobili. Il test verifica che il modello si comporti come previsto al di fuori dell'ambiente di valutazione controllato.
Prepararsi al test del modello#
I set di dati di visione artificiale sono solitamente suddivisi in set di addestramento e di test per simulare le condizioni del mondo reale: i dati di addestramento insegnano al modello, mentre i dati di test ne verificano il comportamento su esempi mai visti. La piattaforma Ultralytics consente di gestire l'organizzazione e l'annotazione dei set di dati in un unico posto, facilitando la creazione di un set di test etichettato.
- Rappresentatività realistica: i dati di test mai visti prima dovrebbero essere simili ai dati che il modello gestirà una volta distribuito. In questo modo ottieni un quadro realistico delle capacità del modello.
- Dimensioni sufficienti: il set di dati di test deve essere abbastanza grande da fornire indicazioni affidabili sulle prestazioni del modello.
Come testare un modello YOLO26#
Il test di un modello YOLO26 addestrato prevede due flussi di lavoro complementari: la validazione su una partizione di test etichettata per ottenere metriche quantitative e la predizione su nuove immagini per esaminare qualitativamente il comportamento.
Validazione su una partizione di test etichettata#
La modalità di validazione confronta le predizioni del modello con le etichette di verità di riferimento e riporta precisione, richiamo, mAP50 e mAP50-95 per i modelli di rilevamento. Salva anche elementi visivi utili, come una matrice di confusione e una curva precisione-richiamo, che ti aiutano a individuare aree specifiche in cui il modello potrebbe non funzionare bene.
from ultralytics import YOLO

# Carica un modello preaddestrato o un tuo checkpoint addestrato, ad es. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Esegui la validazione; aggiungi split="test" se lo YAML del set di dati definisce una partizione di test
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Per impostazione predefinita, la validazione viene eseguita sulla partizione val del set di dati. Per misurare le prestazioni su un set di test separato, definisci una partizione test: nello YAML del set di dati e passa split="test".
Esegui predizioni su nuove immagini#
La modalità di predizione esegue il modello su nuovi dati mai visti, senza richiedere etichette. Non produce metriche delle prestazioni, ma salvando i risultati annotati puoi esaminare il comportamento del modello su immagini del mondo reale, ad esempio elaborando in una volta sola un'intera cartella di immagini di test.
from ultralytics import YOLO

# Carica un modello preaddestrato o un tuo checkpoint addestrato, ad es. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Esegui predizioni su una cartella di immagini di test e salva i risultati annotati
results = model.predict(source="path/to/test_images", save=True)Per verificare se YOLO26 è adatto alla tua applicazione prima di investire nell'addestramento personalizzato, esegui la modalità di predizione con un checkpoint preaddestrato sulle tue immagini. I modelli sono preaddestrati su set di dati come COCO, quindi i risultati ti danno un'idea rapida delle prestazioni che il modello potrebbe raggiungere nel tuo contesto specifico.
Modalità di validazione e di predizione#
| Modalità | Scopo | Richiede etichette | Output |
|---|---|---|---|
| Validazione | Quantifica le prestazioni rispetto alla verità di riferimento | Sì | Precisione, richiamo, mAP50, mAP50-95, matrice di confusione, curve PR |
| Predizione | Esamina il comportamento del modello su nuovi dati non etichettati | No | Immagini annotate e risultati delle predizioni, senza metriche |
Come analizzare i risultati dei test#
Una volta ottenute le predizioni e le metriche, approfondisci dove e perché il modello non funziona:
- Immagini classificate in modo errato: individua ed esamina le immagini classificate in modo errato dal modello per capire dove sbaglia.
- Analisi degli errori: esegui un'analisi approfondita degli errori per comprenderne le tipologie (ad es. falsi positivi rispetto a falsi negativi) e le possibili cause.
- Bias ed equità: verifica la presenza di bias nelle predizioni del modello. Assicurati che il modello funzioni altrettanto bene su diversi sottoinsiemi di dati, soprattutto se includono attributi sensibili come etnia, genere o età.
Overfitting e underfitting nel machine learning#
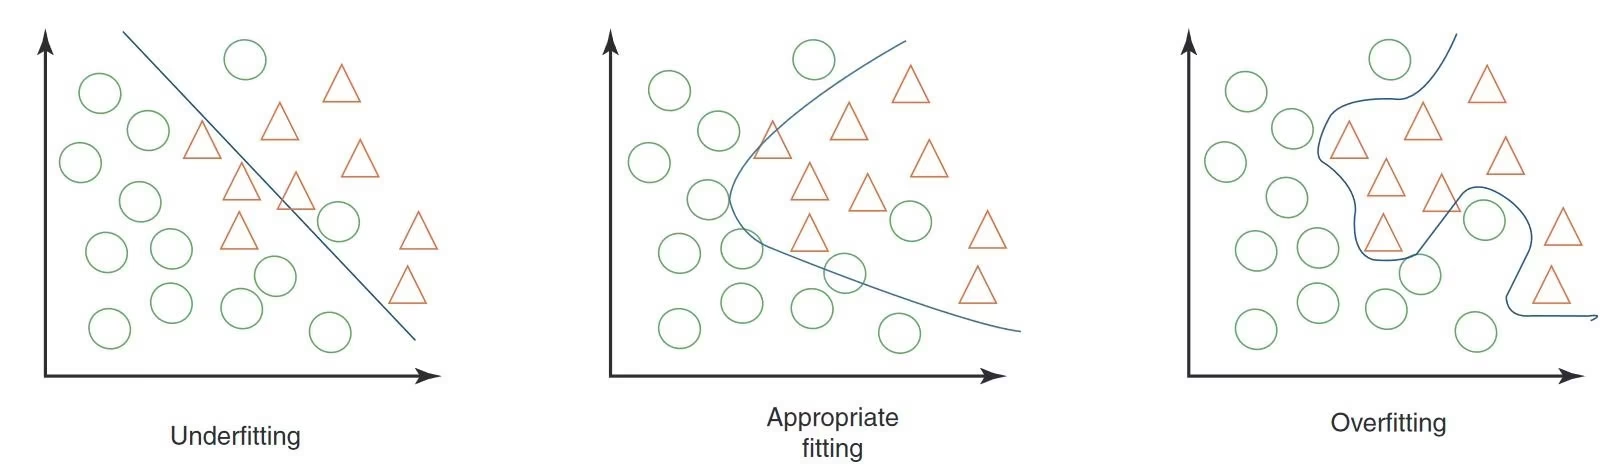
Quando testi un modello di machine learning, soprattutto nella visione artificiale, è importante prestare attenzione all'overfitting e all'underfitting. Questi problemi possono influire notevolmente sulle prestazioni del modello con nuovi dati.
| Problema | Segnali comuni | Come intervenire |
|---|---|---|
| Overfitting | Accuratezza elevata sull'insieme di addestramento ma bassa su quello di validazione; eccessiva sensibilità a piccole variazioni o dettagli irrilevanti nelle immagini | Applica tecniche di regolarizzazione, come il dropout, aumenta le dimensioni del set di dati di addestramento o semplifica l'architettura del modello |
| Underfitting | Accuratezza bassa anche sul set di addestramento; incapacità costante di riconoscere caratteristiche o oggetti evidenti | Usa un modello più complesso, fornisci caratteristiche più pertinenti o aumenta le epoche di addestramento |
L'obiettivo è trovare un equilibrio che consenta al modello di funzionare bene sia sui set di dati di addestramento sia su quelli di validazione. Monitorare regolarmente le metriche ed esaminare visivamente le predizioni durante i test ti aiuta a individuare eventuali tendenze verso uno dei due estremi.
La perdita di dati nella visione artificiale e come evitarla#
La perdita di dati si verifica quando informazioni esterne al set di dati di addestramento vengono usate accidentalmente per addestrare il modello. Durante l'addestramento il modello può sembrare molto accurato, ma in presenza di perdita di dati non funzionerà bene su dati nuovi e mai visti.
La perdita di dati può essere difficile da individuare e spesso deriva da bias nascosti nei dati di addestramento:
| Tipo di bias | Come si manifesta |
|---|---|
| Bias della fotocamera | Angolazioni, illuminazione, ombre e movimenti della fotocamera diversi introducono schemi indesiderati |
| Bias delle sovrapposizioni | Loghi, timestamp o altre sovrapposizioni nelle immagini possono fuorviare il modello |
| Bias dei caratteri e degli oggetti | Caratteri o oggetti specifici che compaiono spesso in determinate classi alterano l'apprendimento del modello |
| Bias spaziale | Gli squilibri tra primo piano e sfondo, nelle distribuzioni dei riquadri di delimitazione e nelle posizioni degli oggetti influiscono sull'addestramento |
| Bias delle etichette e del dominio | Etichette errate o variazioni nei tipi di dati causano leakage |
Come rilevare ed evitare il data leakage#
Per individuare il data leakage, verifica se i risultati del modello sono sorprendentemente buoni, controlla se una feature è molto più importante delle altre, assicurati che le decisioni del modello siano intuitive e verifica che i dati siano stati suddivisi correttamente prima di qualsiasi elaborazione.
Per evitarlo, usa un dataset eterogeneo con immagini o video acquisiti da diverse fotocamere e in ambienti differenti, e controlla attentamente i dati per individuare bias nascosti, ad esempio se tutti i campioni positivi sono stati acquisiti in una specifica fascia oraria. Evitare il data leakage rende i tuoi modelli di computer vision più affidabili nelle situazioni reali.
Cosa fare dopo aver testato il modello#
Dopo aver testato il modello, i passaggi successivi dipendono dai risultati. Se il modello offre buone prestazioni, puoi distribuirlo in un ambiente reale. Se i risultati non sono soddisfacenti, dovrai apportare dei miglioramenti. Potrebbe essere necessario analizzare gli errori, raccogliere più dati, migliorare la qualità dei dati, regolare gli iperparametri e riaddestrare il modello.
Conclusione#
Test rigorosi del modello — convalida su uno split di test escluso dall'addestramento, predizioni su immagini del mondo reale e verifica di overfitting e data leakage — trasformano un modello valutato accuratamente in un modello affidabile. Risolvi i problemi emersi durante i test prima della distribuzione: così il modello avrà molte più probabilità di funzionare come previsto in produzione. Se durante il processo hai domande, chiedi alla community nel repository GitHub di Ultralytics o nel server Discord di Ultralytics.
Domande frequenti#
La valutazione del modello misura le prestazioni con metriche su un dataset etichettato, mentre il test verifica come si comporta il modello su dati nuovi e mai visti, simili a quelli delle condizioni di distribuzione. La valutazione produce valori come precisione e mAP su un dataset controllato; il test rivela se il comportamento appreso regge in condizioni variabili di illuminazione, movimento o occlusione. Consulta Test del modello e valutazione del modello per un esempio pratico.
Usa la modalità di predizione e passa il percorso di una cartella come
source: YOLO26 elabora ogni immagine nella cartella e può salvare i risultati annotati per la revisione. La modalità di predizione non calcola metriche; per quantificare le prestazioni su un set etichettato, usa invece la modalità di convalida. Entrambi i flussi di lavoro sono illustrati in Come testare un modello YOLO26.Per i modelli di rilevamento, la convalida riporta precisione, richiamo, mAP50 e mAP50-95 e salva grafici tra cui una matrice di confusione e una curva precisione-richiamo. Per convalidare su uno split di test dedicato invece che sullo split predefinito
val, definiscitest:nel file YAML del dataset e passasplit="test". Consulta la guida alle metriche di prestazione per capire come interpretare ogni metrica.Per l'overfitting, applica tecniche di regolarizzazione come il dropout, aumenta le dimensioni del dataset di addestramento oppure semplifica l'architettura del modello. Per l'underfitting, usa un modello più complesso, fornisci feature più pertinenti oppure aumenta il numero di epoche di addestramento. I segnali di ciascun problema e le relative soluzioni sono riepilogati in Overfitting e underfitting nel machine learning.
Sospetta un data leakage quando le prestazioni sul test sono sorprendentemente buone, una singola feature domina le predizioni oppure le decisioni del modello non sono intuitive. Previeni il problema usando dataset eterogenei acquisiti da diverse fotocamere e in ambienti differenti, controllando i dati per individuare bias nascosti e verificando che la suddivisione tra train e test sia avvenuta prima di qualsiasi elaborazione. Consulta Data leakage nella computer vision per conoscere i tipi di bias più comuni.
Se i risultati soddisfano gli obiettivi del progetto, distribuisci il modello; in caso contrario, miglioralo prima della distribuzione. Potrebbe essere necessario analizzare gli errori, raccogliere dati più eterogenei, migliorare la qualità dei dati, ottimizzare gli iperparametri e riaddestrare il modello. Ripeti i test dopo ogni ciclo di modifiche per verificare che le correzioni abbiano funzionato.