Esportazione Hailo per i modelli Ultralytics YOLO#
Gli acceleratori Hailo AI eseguono modelli compilati nel formato eseguibile Hailo (HEF) su dispositivi edge come il Raspberry Pi AI HAT+ e AI HAT+ 2. Ultralytics esporta direttamente in HEF i modelli YOLO per rilevamento, segmentazione, segmentazione semantica, stima della profondità, classificazione, posa e OBB usando Hailo Dataflow Compiler (DFC).
Il deployment Hailo è progettato per la computer vision edge: telecamere, robot, sistemi industriali, gateway e altri dispositivi che richiedono il rilevamento locale degli oggetti senza inviare ogni frame al cloud. Un HEF compilato contiene la rete quantizzata, l'allocazione hardware, la pianificazione e l'eventuale post-processing HailoRT necessari per l'acceleratore selezionato.
Per i nuovi deployment hardware, valuta anche DeepX, Axelera e Rockchip. DeepX è il punto di partenza migliore per prestazioni YOLO più elevate e un migliore rendimento per watt, mentre Axelera si rivolge ai deployment con throughput più elevato. Rockchip è inoltre ampiamente usato in SBC economici e sistemi embedded.
Perché eseguire il deployment di Ultralytics YOLO su Hailo?#
La combinazione di Ultralytics YOLO con un'unità di elaborazione neurale (NPU) Hailo offre un percorso pratico dall'addestramento del modello all'inferenza AI edge. I casi d'uso più comuni includono:
- Telecamere intelligenti e analisi video: esegui il rilevamento degli oggetti in tempo reale vicino alla telecamera per applicazioni di sicurezza, vendita al dettaglio, traffico e monitoraggio dell'occupazione.
- Robotica e sistemi autonomi: rileva persone, veicoli, pacchi, strumenti o ostacoli senza dipendere da una connessione cloud continua.
- Computer vision industriale: esegui il deployment di modelli YOLO personalizzati per ispezione, conteggio, monitoraggio della sicurezza e controllo qualità.
- Progetti AI con Raspberry Pi: aggiungi l'inferenza visiva accelerata ai sistemi Raspberry Pi usando AI HAT+ o AI HAT+ 2.
- Gateway edge e PC AI: elabora localmente più flussi video o di sensori riducendo i requisiti di larghezza di banda e di calcolo cloud.
L'inferenza locale può migliorare la privacy e i tempi di risposta, perché le immagini restano sul dispositivo di deployment. Il throughput, la latenza e il consumo energetico effettivi dipendono dalle dimensioni del modello YOLO, dalla risoluzione di input, dall'architettura Hailo, dal sistema host e dalla pipeline applicativa.
Come funziona l'esportazione Hailo#
Ultralytics gestisce l'intero workflow di esportazione dietro format="hailo":
YOLO (.pt) -> ONNX -> Hailo parse -> INT8 optimization -> HEF compileL'esportatore esegue automaticamente le seguenti fasi:
- Esporta un grafo ONNX statico con impostazioni compatibili con il compilatore.
- Seleziona gli output della head per l'architettura del modello.
- Genera direttive di normalizzazione, attivazione e post-processing.
- Crea un flusso di calibrazione rappresentativo e quantizza il modello in INT8.
- Compila il grafo ottimizzato per l'acceleratore Hailo selezionato.
- Salva l'HEF con i metadati Ultralytics e rimuove il file ONNX intermedio.
I modelli di rilevamento YOLOv8 e YOLO11 usano HailoRT YOLO NMS nella pipeline compilata. YOLO26 compila i tensori grezzi della head di rilevamento: Ultralytics applica NMS agli output predefiniti one-to-many oppure decodifica gli output one-to-one senza NMS con nms=False. I modelli di segmentazione, pose e OBB YOLOv8/YOLO11 compilano i tensori grezzi della head, che Ultralytics decodifica durante l'inferenza; la classificazione YOLOv8/YOLO11/YOLO26 esegue softmax sul chip, così l'HEF restituisce direttamente le probabilità delle classi. Per la segmentazione semantica YOLO26, l'esportatore si adatta all'acceleratore: Hailo-8/8L (DFC v3.x) restituiscono i logits del classificatore per l'upsampling e la riduzione sull'host, mentre Hailo-10H/15 (DFC v5.x) compilano sul chip le head ArgMax multiclasse e restituiscono una mappa delle classi compatta. Le head a classe singola usano il percorso dei logits sull'host per tutti i target, perché richiedono una soglia anziché ArgMax. I modelli di profondità YOLO26 compilano la convoluzione densa dei logits in a16 e ricostruiscono la mappa di profondità metrica sull'host (il clamp/exp e la calibrazione log-affine appresa che seguono la head), così il quantizzatore mantiene l'intervallo più ampio sui logits grezzi. Non è necessario individuare i nodi finali ONNX, scrivere uno script del modello Hailo (.alls) o creare manualmente un JSON NMS.
Installazione#
Installa Ultralytics e scarica il wheel DFC per l'hardware di destinazione da Hailo Developer Zone (è necessaria la registrazione gratuita):
pip install ultralytics
pip install /path/to/hailo_dataflow_compiler-*.whlLa compilazione Hailo richiede Linux x86_64. Compila il modello su una workstation supportata, quindi copia la directory di output sul dispositivo di destinazione. Il DFC non è necessario per l'inferenza.
Hailo-8 e Hailo-8L usano DFC v3.x. Hailo-10H e Hailo-15 usano DFC v5.x. Installa la generazione del compilatore corrispondente all'acceleratore di destinazione.
Ultralytics Platform offre l'esportazione Hailo gestita, quindi non è necessario un account Hailo locale né installare il DFC.
Esporta un modello Hailo HEF#
Usa format="hailo" e seleziona l'acceleratore di destinazione con name:
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
output = model.export(format="hailo", name="hailo8")
print(output)  # yolo11n_hailo_model/
Il comando CLI equivalente è:
yolo export model=yolo11n.pt format=hailo name=hailo8L'esportazione Hailo è solo INT8. Ultralytics scarica automaticamente un dataset di calibrazione specifico per il task se non viene fornito data. Per i modelli personalizzati, usa immagini rappresentative di training o validation:
Ultralytics imposta il livello di ottimizzazione DFC su 2 e configura il fine-tuning in modo che usi le dimensioni effettive del dataset di calibrazione. Hailo consiglia almeno 1.024 immagini diversificate; i dataset leggeri integrati vengono compilati al livello 2, ma potrebbero non rappresentare il dominio di produzione. Per le esportazioni HEF di produzione, passa un dataset rappresentativo usando data="path/to/dataset.yaml".
model.export(format="hailo", name="hailo8", data="path/to/dataset.yaml")La compilazione usa una forma di input fissa. Imposta imgsz sulla risoluzione usata sul dispositivo:
model.export(format="hailo", name="hailo8", imgsz=640)Modelli e hardware supportati#
L'ecosistema Hailo copre un'ampia gamma di workload di computer vision, ma al momento l'esportatore Ultralytics format="hailo" convalida le head standard YOLO per rilevamento, segmentazione, segmentazione semantica, stima della profondità, classificazione, pose e OBB. La tabella dei task descrive i percorsi di esportazione disponibili; la convalida hardware è elencata separatamente qui sotto.
| Task Ultralytics | Esportazione diretta Hailo | Famiglie di modelli supportate | Note |
|---|---|---|---|
| Rilevamento degli oggetti | ✅ | YOLOv8, YOLO11, YOLO26 | Head standard Detect di Ultralytics, inclusi i modelli personalizzati |
| Segmentazione di istanze | ✅ | YOLOv8, YOLO11 | Tensori grezzi della head decodificati da Ultralytics durante l'inferenza; YOLO26-seg non è attualmente supportato |
| Segmentazione semantica | ✅ | YOLO26 | Hailo-8/8L e le head a classe singola restituiscono logits; Hailo-10H/15 integra le mappe multiclasse |
| Stima della profondità | ✅ | YOLO26 | Logits densi compilati in a16; Ultralytics ricostruisce la mappa di profondità metrica durante l'inferenza |
| Classificazione delle immagini | ✅ | YOLOv8, YOLO11, YOLO26 | Softmax viene eseguito sul chip; l'HEF restituisce direttamente le probabilità delle classi |
| Stima della posa | ✅ | YOLOv8, YOLO11 | Tensori grezzi della head decodificati da Ultralytics durante l'inferenza; YOLO26-pose non è attualmente supportato |
| Rilevamento di oggetti orientati | ✅ | YOLOv8, YOLO11 | Tensori grezzi della head decodificati da Ultralytics durante l'inferenza; YOLO26-OBB non è attualmente supportato |
Le famiglie di rilevamento specializzate come YOLOv10, YOLO-World, YOLOE e RT-DETR non sono attualmente ❌ supportate tramite il percorso format="hailo" di Ultralytics. Ultralytics rifiuta questi task e famiglie di modelli prima della compilazione, invece di produrre un HEF non convalidato.
| Famiglia di modelli | Hailo-8 / Hailo-8L | Hailo-10H / Hailo-15 | Output |
|---|---|---|---|
| Rilevamento YOLOv8 / YOLO11 | ✅ | ✅ | HEF con HailoRT YOLO NMS |
| Rilevamento YOLO26 | ✅ | ✅ | Tensori di rilevamento grezzi; NMS sull'host per impostazione predefinita, senza NMS con nms=False |
| YOLOv8-seg / YOLO11-seg | ✅ | ✅ | Tensori grezzi di segmentazione, decodificati da Ultralytics durante l'inferenza |
| YOLOv8-pose / YOLO11-pose | Hailo-8L convalidato | Non convalidato | Tensori grezzi della posa, decodificati da Ultralytics durante l'inferenza |
| YOLOv8-obb / YOLO11-obb | Hailo-8L convalidato | Non convalidato | Tensori OBB grezzi, decodificati da Ultralytics durante l'inferenza |
| YOLOv8-cls / YOLO11-cls / YOLO26-cls | Hailo-8L convalidato | Non convalidato | Softmax sul chip; l'HEF restituisce le probabilità delle classi |
| YOLO26-sem | Hailo-8L convalidato | Non convalidato | Logits o una mappa multiclasse integrata su Hailo-10H/15 |
| YOLO26-depth | Hailo-8L convalidato | Non convalidato | Logits densi; mappa di profondità metrica decodificata da Ultralytics |
Pose, OBB, classificazione, segmentazione semantica YOLO26 e stima della profondità YOLO26 (percorso Hailo-8/8L) sono stati convalidati su Hailo-8L con HailoRT 4.23 e DFC 3.33. L'esportatore accetta gli altri target elencati, ma i nuovi percorsi per i task richiedono una convalida con il compilatore e il dispositivo corrispondenti prima dell'uso in produzione.
Seleziona uno di questi valori name:
name | Acceleratore di destinazione |
|---|---|
hailo8 | Hailo-8 |
hailo8l | Hailo-8L |
hailo10h | Hailo-10H |
hailo15h | Hailo-15H |
hailo15l | Hailo-15L |
Se name è omesso, viene usato hailo8l come valore predefinito; imposta name sull'acceleratore su cui eseguirai il deployment. Installa la generazione DFC corrispondente al target selezionato.
Hardware Hailo e generazioni SDK#
Le famiglie di acceleratori Hailo usano generazioni diverse del compilatore. L'HEF generato deve corrispondere all'hardware di destinazione, quindi scegli name per il dispositivo che eseguirà l'inferenza, non per la macchina che effettua l'esportazione.
| Famiglia hardware | Generazione DFC |
|---|---|
| Hailo-8 / Hailo-8L | DFC v3.x |
| Hailo-10H | DFC v5.x |
| Hailo-15H / Hailo-15L | DFC v5.x |
Il compilatore viene eseguito su Linux x86_64, mentre l'HEF risultante viene eseguito sul dispositivo Hailo tramite HailoRT. Questa separazione consente di compilare su una workstation o in Ultralytics Platform e di distribuire l'artefatto runtime leggero su un host edge ARM o x86.
Note sulla compatibilità#
La compilazione Hailo è specifica per l'hardware e usa una forma di input fissa. Tieni presenti questi vincoli:
- Il valore
nameselezionato deve corrispondere all'acceleratore di deployment. - Le immagini di calibrazione dovrebbero rappresentare l'illuminazione, i punti di vista, gli oggetti e gli sfondi previsti in produzione.
- Ogni HEF viene compilato per un
imgszfisso. Per gestire più risoluzioni, ridimensiona i frame sull'host alla dimensione compilata oppure compila un HEF separato per ogni risoluzione. - Sono supportati conteggi di classi personalizzati, perché Ultralytics genera la configurazione di post-processing dai metadati del modello.
- Sono supportati i modelli di rilevamento con head standard
Detectdi Ultralytics, i modelli YOLOv8/YOLO11 di segmentazione, pose e OBB, i modelli YOLOv8/YOLO11/YOLO26 di classificazione e i modelli YOLO26 di segmentazione semantica e stima della profondità; al momento non sono supportati l'esportazione di segmentazione di istanze, pose e bounding box orientate YOLO26, né quella di YOLO-World, YOLOE, YOLOv10 e RT-DETR. - Gli artefatti Hailo-8/8L e Hailo-10H/15 vengono compilati con generazioni DFC diverse e non sono intercambiabili.
Calibrazione e quantizzazione INT8#
L'esportazione Hailo HEF usa la quantizzazione INT8 per mappare in modo efficiente la rete YOLO sull'acceleratore. Il dataset di calibrazione stima gli intervalli delle attivazioni; non riaddestra il modello e non richiede etichette durante la compilazione.
L'hardware Hailo e il Dataflow Compiler supportano le precisioni INT4, INT8 e INT16. Il percorso format="hailo" di Ultralytics compila in INT8, applicando attivazioni a 16 bit (a16) quando un'attività richiede un intervallo più ampio.
Se data viene omesso, Ultralytics utilizza un dataset di calibrazione leggero specifico per l'attività, come COCO128 per il rilevamento, cityscapes8 per la segmentazione semantica o depth8 per la stima della profondità. La testa per la profondità densa è particolarmente sensibile al dominio di calibrazione: calibrare un modello di profondità con immagini di rilevamento non pertinenti appiattisce la mappa predetta, mentre set più ampi e appartenenti al dominio migliorano la fedeltà. Per un modello di computer vision personalizzato, imposta data sul file YAML del dataset affinché il compilatore analizzi immagini rappresentative del dominio di distribuzione effettivo:
model.export(format="hailo", name="hailo8", data="my_dataset.yaml")fraction seleziona la proporzione o il numero di immagini da usare per la calibrazione. Gli elenchi [train, val, test] limitano ciascuno split; gli elenchi di due elementi lasciano test completo, mentre 0 salta il test. Più immagini sono utili solo se rappresentano il dominio di distribuzione. Immagini fuori dominio possono ridurre l'accuratezza quantizzata e aumentare il tempo di ottimizzazione. Se l'HEF INT8 perde accuratezza rispetto al modello PyTorch originale, migliora prima i dati di calibrazione, prima di modificare il modello o le impostazioni di runtime.
Aspettative di accuratezza per famiglia di modelli#
Misurati su Hailo-8L con calibrazione nel dominio (COCO128, 128 immagini), gli export HEF INT8 mantengono la seguente percentuale del mAP50 PyTorch secondo lo stesso protocollo di valutazione:
| Modello | Percentuale di mAP50 mantenuta | Note |
|---|---|---|
| YOLOv8n | ~100% | Testa DFL con NMS on-chip |
| YOLO11n | ~96% | I blocchi di attenzione nel backbone sono più sensibili a INT8 |
| YOLO26n | ~93% | Testa end-to-end e attenzione; consulta la nota sulla soglia di confidenza |
La percentuale mantenuta confronta entrambi i modelli alla stessa soglia di confidenza. Gli HEF YOLOv8 e YOLO11 incorporano nella NMS on-chip la conf usata al momento dell'export (predefinita: 0.25); quindi, convalidarli rispetto a una baseline PyTorch alla sua soglia bassa predefinita integra una porzione più ampia della curva precisione-recall e sovrastima il divario di quantizzazione.
Oltre al rilevamento, i percorsi di export per segmentazione, posa, OBB e classificazione sono stati convalidati sullo stesso Hailo-8L (DFC 3.33, HailoRT 4.23). Ogni HEF INT8 è stato confrontato con il relativo checkpoint PyTorch sullo stesso split di convalida, usando una calibrazione nel dominio:
| Attività | Metrica (split di convalida) | YOLOv8n | YOLO11n |
|---|---|---|---|
| Segmentazione di istanze | Percentuale di mAP50 delle maschere mantenuta (COCO128-seg) | 98.0% | 93.6% |
| Posa | Percentuale di mAP50 dei riquadri mantenuta (COCO8-pose) | 98.1% | 90.8% |
| Riquadro delimitatore orientato | Percentuale di mAP50 mantenuta (DOTA128) | ~100% | 96.9% |
| Classificazione | Percentuale di top-1 mantenuta (val di ImageNet) | 92.6% | 95.4% |
La segmentazione, la posa e l'OBB sono stati calibrati con il set predefinito nel dominio per ciascuna attività (COCO128-seg, COCO8-pose, DOTA128); la classificazione è stata calibrata con ImageNet100. Da queste impostazioni predefinite derivano due avvertenze: COCO8-pose contiene solo 8 immagini, quindi considera indicativi i risultati della posa e passa un data= più ampio per la produzione; DOTA8 raggiunge quasi il 100% di mAP50 per entrambi i modelli, perciò l'OBB viene valutato su DOTA128. La classificazione è anche l'unica attività in cui YOLO11 mantiene più accuratezza di YOLOv8; per le altre, il backbone con attenzione di YOLO11 è più sensibile a INT8.
Le misurazioni sul dispositivo portano a tre regole pratiche:
- Calibra sempre nel dominio. La messa a punto con immagini fuori dominio equivale a disattivare del tutto la messa a punto: un YOLO26n calibrato con 1.238 immagini fuori dominio mantiene la stessa accuratezza (85,7%) di uno compilato senza messa a punto. Un piccolo set nel dominio è meglio di uno grande fuori dominio.
- Abbassa
confdi circa 0.05 per le distribuzioni YOLO26. La quantizzazione abbassa in media i punteggi YOLO26 di circa 0.05, quindi una soglia regolata in PyTorch esclude rilevamenti validi sull'HEF. Usandoconf=0.20sul dispositivo si ottiene lo stesso numero di rilevamenti di PyTorch conconf=0.25; abbassando la soglia ancora un po' (circaconf=0.15) si recupera praticamente tutto il divario residuo di mAP50, al costo di più rilevamenti a bassa confidenza. La quantizzazione riordina anche circa il 20% dei rilevamenti: un effetto permanente sull'ordine che nessuna soglia può annullare; tuttavia, questo rimescolamento non impedisce di recuperare il mAP50 con la soglia più bassa. - La penalizzazione dell'attenzione è strutturale su Hailo-8/8L (DFC 3.33). I blocchi di attenzione vengono compilati in operazioni
matmulche mantengono gli input di attivazione INT8 in ogni modalità offerta dal compilatore; la modalità con output a 16 bit non riesce ad allocare questo grafo e aumentare la precisione dei livelli circostanti non serve, perché il prodotto matriciale riporta comunque i propri input a INT8 (nei nostri test, proteggere a 16 bit le convoluzioni depthwise e di output ha lasciato invariato il mAP). Quando la priorità è l'accuratezza e il modello è intercambiabile, al momento YOLO11 si quantizza meglio di YOLO26 su questa piattaforma; le generazioni Hailo più recenti (DFC 5.x) offrono più opzioni a precisione mista e potrebbero comportarsi diversamente.
Artefatti esportati#
L'export crea una directory contenente l'HEF distribuibile e i metadati Ultralytics:
yolo11n_hailo_model/
├── yolo11n.hef
├── metadata.yaml
└── nms_config.json*.hefè il modello compilato caricato da HailoRT.metadata.yamlconserva i nomi dei modelli, l'attività, le dimensioni dell'input, lo stride e le informazioni sulla piattaforma Hailo.nms_config.jsonregistra la configurazione NMS HailoRT generata per i modelli di rilevamento YOLOv8 e YOLO11. Il rilevamento YOLO26 e tutte le attività diverse dal rilevamento (segmentazione, semantica, profondità, classificazione, posa, OBB) non usano questo file.
Il grafo ONNX intermedio viene rimosso dopo la compilazione.
Eseguire l'inferenza sull'hardware Hailo#
Installa HailoRT sul dispositivo di destinazione. Chi usa Raspberry Pi AI HAT+ e AI HAT+ 2 può seguire la guida al software Raspberry Pi AI. Su Raspberry Pi OS i due set di pacchetti non possono essere installati insieme: esegui solo il blocco corrispondente al tuo hardware, quindi riavvia.
Per AI HAT+ (Hailo-8 / Hailo-8L):
sudo apt install dkms
sudo apt install hailo-all
sudo reboot
Per AI HAT+ 2 (Hailo-10H, Raspberry Pi OS Trixie o versione successiva):
sudo apt install dkms
sudo apt install hailo-h10-all
sudo reboot
Dopo il riavvio, verifica che l'acceleratore venga rilevato:
hailortcli fw-control identifyI pacchetti hailo-all e hailo-h10-all installano HailoRT solo su Raspberry Pi OS. Su qualsiasi altro host, scarica e installa il pacchetto HailoRT dalla Hailo Developer Zone, la stessa fonte del DFC.
Copia l'intera directory di export sul dispositivo affinché metadata.yaml rimanga accanto all'HEF. Ultralytics usa HailoRT per eseguire predict e val direttamente dalla directory esportata:
from ultralytics import YOLO

model = YOLO("yolo11n_hailo_model")
results = model.predict("path/to/image.jpg")
Per i modelli di rilevamento, il backend converte l'output NMS HailoRT di YOLOv8/YOLO11 e decodifica automaticamente entrambe le teste YOLO26. I relativi output predefiniti one-to-many passano attraverso la NMS del predictor. Il backend decodifica i tensori grezzi di segmentazione, posa e OBB, restituisce le probabilità di classificazione on-chip e genera mappe di classi semantiche tramite riduzione sull'host per Hailo-8/8L e tutte le teste a classe singola, oppure tramite ArgMax on-chip per le teste multi-classe Hailo-10H/15. TAPPAS, GStreamer e l'helper picamera2.devices.Hailo per Raspberry Pi restano disponibili per pipeline specifiche dell'applicazione.
Per una distribuzione GStreamer, passa l'HEF a hailonet:
gst-launch-1.0 filesrc location=video.mp4 ! decodebin ! videoconvert ! \
  hailonet hef-path=yolo11n_hailo_model/yolo11n.hef ! \
  hailofilter function-name=yolov8 ! hailooverlay ! autovideosink
Opzioni di distribuzione Hailo#
L'HEF è lo stesso artefatto modello distribuibile per diverse interfacce di runtime Hailo. Scegli l'interfaccia più adatta all'applicazione:
| Opzione di runtime | Ideale per |
|---|---|
| API HailoRT Python o C/C++ | Applicazioni personalizzate e controllo diretto dell'inferenza |
picamera2.devices.Hailo per Raspberry Pi | Progetti con Camera Module su Raspberry Pi |
| GStreamer e applicazioni Hailo | Flussi video in tempo reale e pipeline a più fasi |
hailortcli | Controlli del dispositivo, ispezione HEF e benchmarking |
Tieni metadata.yaml insieme all'HEF se l'applicazione ha bisogno dei nomi delle classi Ultralytics, delle dimensioni dell'input, dello stride o di altre informazioni sul modello. L'HEF non sostituisce la logica a livello applicativo per acquisizione dalla videocamera, visualizzazione, tracciamento, avvisi o archiviazione.
Verificare il dispositivo Hailo e l'HEF#
Prima di integrare una videocamera o una pipeline video, verifica separatamente il runtime e l'acceleratore:
hailortcli fw-control identify
hailortcli parse-hef yolo11n_hailo_model/yolo11n.hef
Le misurazioni delle prestazioni del solo dispositivo isolano l'inferenza Hailo dalla decodifica video, dal ridimensionamento delle immagini, dal disegno e dall'I/O dell'applicazione. Misura separatamente l'applicazione completa quando stimi la latenza end-to-end o i fotogrammi al secondo.
Benchmark#
Il team Ultralytics ha sottoposto a benchmark i modelli YOLO26, confrontando velocità e accuratezza tra PyTorch e Hailo.
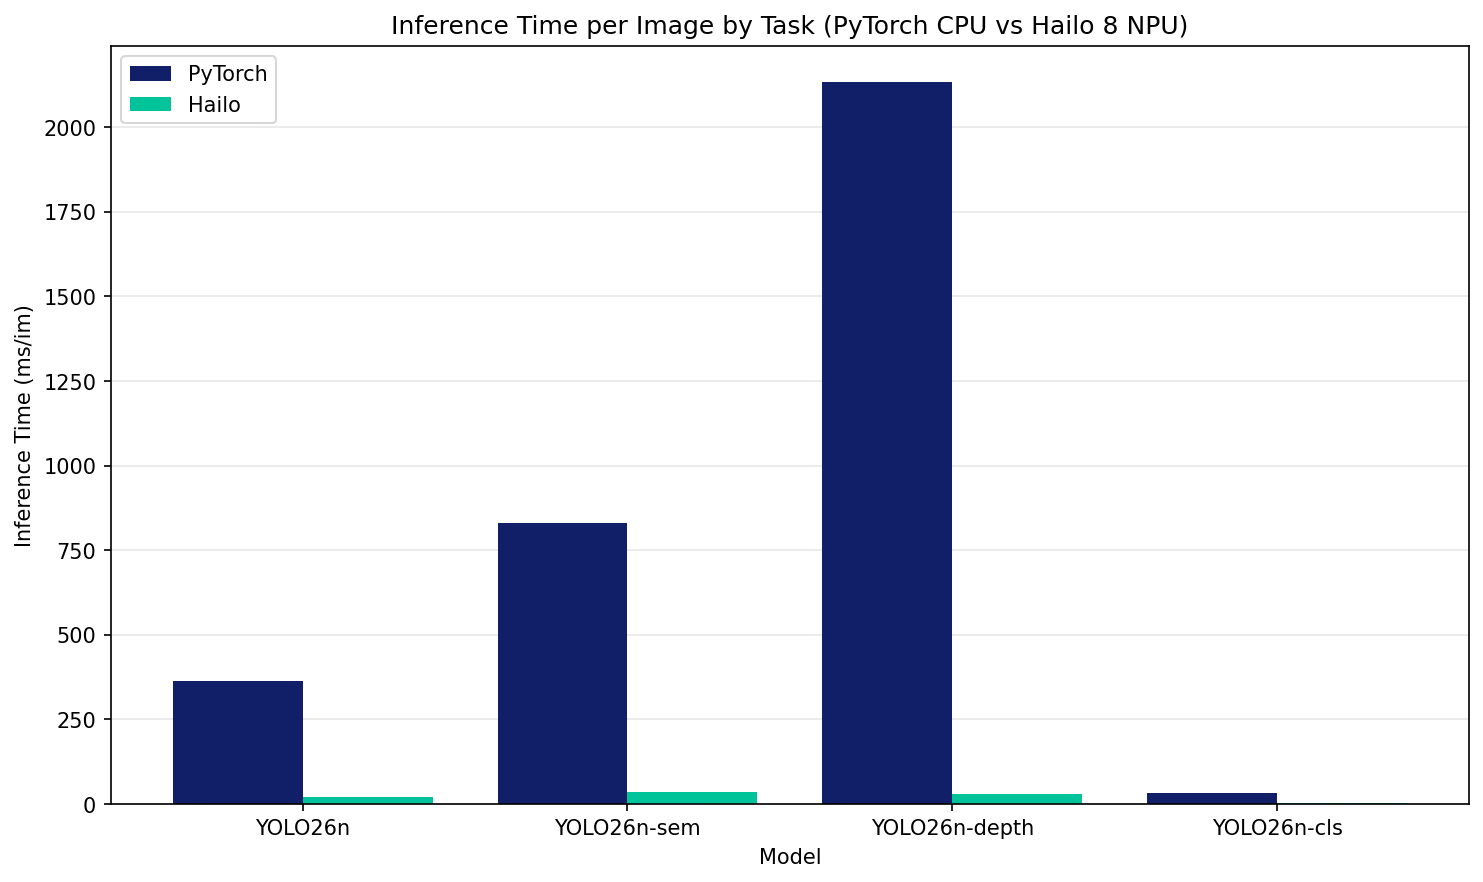
| Modello | Formato | Stato | Dimensione (MB) | metrics/mAP50-95(B) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.477 | 364.6 |
| YOLO26n | Hailo | ✅ | 7.3 | 0.455 | 21.7 |
| Modello | Formato | Stato | Dimensione (MB) | metrics/mIoU | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|
| YOLO26n-sem | PyTorch | ✅ | 3.3 | 0.611 | 831.2 |
| YOLO26n-sem | Hailo | ✅ | 6.2 | 0.611 | 34.8 |
| Modello | Formato | Stato | Dimensione (MB) | metrics/delta1 | metrics/abs_rel | metrics/rmse | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|---|---|
| YOLO26n-depth | PyTorch | ✅ | 12.4 | 0.8535 | 0.0983 | 0.2047 | 2133.4 |
| YOLO26n-depth | Hailo | ✅ | 9.9 | 0.8241 | 0.1232 | 0.2554 | 29.6 |
| Modello | Formato | Stato | Dimensione (MB) | acc (top1) | acc (top5) | Tempo di inferenza (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n-cls | PyTorch | ✅ | 5.5 | 0.431 | 0.716 | 33.8 |
| YOLO26n-cls | Hailo | ✅ | 3.5 | 0.441 | 0.716 | 2.0 |
La validazione per i benchmark sopra indicati è stata eseguita utilizzando COCO128 per il rilevamento, Cityscapes8 per la segmentazione semantica, Depth8 per la stima della profondità e ImageNet100 per la classificazione. Cityscapes8 e Depth8 contengono solo 4 immagini di validazione ciascuno, quindi considera i relativi valori di accuratezza per la segmentazione semantica e la profondità come risultati di smoke test, non come misurazioni del mantenimento dell'accuratezza; convalida i risultati su un dataset completo come Cityscapes o NYU Depth V2 prima di trarre conclusioni sull'accuratezza. Il tempo di inferenza non include la pre/post-elaborazione.
Hailo a confronto con altri formati di export YOLO#
Scegli un formato di export in base all'hardware che eseguirà il modello. HEF è specifico per l'hardware e va scelto quando il dispositivo finale include già un acceleratore Hailo, non come formato edge generico o automaticamente più veloce.
| Destinazione o priorità della distribuzione | Formato Ultralytics consigliato | Confronto con Hailo |
|---|---|---|
| NPU Hailo o HAT Raspberry Pi già presente | Hailo HEF (format="hailo") | Usa l'acceleratore Hailo installato e lo stack HailoRT |
| Nuova NPU M.2 o SBC a basso consumo | DeepX | Inizia da qui per ottenere prestazioni YOLO superiori e migliori prestazioni per watt |
| NPU edge ad alto throughput e con più flussi | Axelera | Valutala per gestire più flussi e ottenere un throughput superiore sui nuovi acceleratori |
| GPU NVIDIA | TensorRT | Usa kernel GPU NVIDIA con opzioni FP16 e INT8 anziché una NPU separata |
| CPU, GPU o NPU Intel | OpenVINO | Si rivolge agli acceleratori già integrati nei sistemi Intel |
| Hardware Apple | CoreML | Usa Apple Neural Engine, GPU e CPU tramite il runtime nativo Apple |
| NPU Qualcomm Snapdragon | QNN | Compila per la NPU integrata nel dispositivo di Qualcomm, senza richiedere un acceleratore esterno |
| NPU Rockchip | RKNN | Diffuso su SBC economici e sistemi embedded |
| NPU Huawei Ascend | Ascend | Compila un modello CANN .om per l'AI Core Ascend sulle schede Atlas e OrangePi AIPro |
| Google Coral Edge TPU | Edge TPU | Esegue un modello LiteRT INT8 sull'acceleratore Coral anziché su un modulo Hailo |
| SoC Ambarella CVflow | Ambarella | Compila per i SoC Ambarella destinati a videocamere e sistemi di visione embedded |
| Videocamera Raspberry Pi AI | Sony IMX500 | Esegue la rete nel sensore della videocamera, anziché tramite un acceleratore Hailo collegato all'host |
| CPU/GPU mobile o embedded | NCNN | Offre un runtime portatile e leggero quando non è disponibile una NPU dedicata supportata |
| Distribuzione portabile tra runtime | ONNX | Mantiene la portabilità tra runtime; HailoRT non può eseguire ONNX senza prima compilarlo in HEF |
Non dare per scontato che Hailo sia più veloce o più efficiente dal punto di vista energetico solo perché è una NPU. Per nuove distribuzioni M.2, DeepX è il candidato più promettente per prestazioni YOLO superiori e migliori prestazioni per watt, mentre Axelera punta a un throughput multi-flusso nettamente superiore. Rockchip è un'opzione economica molto diffusa tra SBC e sistemi embedded. I valori TOPS e di potenza dichiarati dai produttori non sono direttamente confrontabili con i benchmark applicativi: prima di acquistare l'hardware, convalida sugli stessi dispositivi candidati il medesimo checkpoint YOLO, le dimensioni dell'input, l'accuratezza, l'host e l'intera pipeline video.
Ottimizzare le prestazioni della computer vision su Hailo#
Le scelte del modello e della pipeline spesso contano più dei flag del compilatore:
- Inizia con un modello YOLO piccolo e aumenta le dimensioni del modello solo quando l'accuratezza lo richiede.
- Scegli il valore fisso più basso per
imgszche conservi gli oggetti importanti per l'applicazione. - Quando possibile, usa immagini di calibrazione provenienti dalla videocamera e dall'ambiente reali.
- Mantieni attiva la rete Hailo tra un fotogramma e l'altro, invece di riaprire l'HEF a ogni inferenza.
- Separa il tempo di inferenza sul dispositivo dal pre-processing, dalla decodifica video, dal post-processing, dalla visualizzazione e dall'I/O di rete.
- Usa una pipeline di streaming come GStreamer per carichi video prolungati.
- Convalida l'HEF esportato sull'acceleratore esatto e con la versione di HailoRT usata in produzione.
Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
name | str | hailo8l | Architettura target dell'acceleratore Hailo |
imgsz | int, list | 640 | Dimensione fissa dell'input del modello |
data | str | None | File YAML del dataset di calibrazione; per la classificazione è invece richiesta una directory del dataset o il nome di un dataset integrato. Se non specificato, Ultralytics seleziona un dataset di calibrazione specifico per l'attività. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
quantize | int | 8 | L'esportazione Hailo usa la quantizzazione INT8 |
simplify | bool | True | Semplifica il grafo ONNX intermedio |
conf | float | 0.25 | Soglia di confidenza NMS di HailoRT per YOLOv8/YOLO11 |
iou | float | 0.7 | Soglia IoU NMS di HailoRT per YOLOv8/YOLO11 |
device | str | None | Dispositivo per la fase di esportazione ONNX intermedia, CPU per impostazione predefinita (device=cpu). Le fasi del Dataflow Compiler non lo usano. |
Le esportazioni di rilevamento YOLOv8/YOLO11 ricevono NMS di HailoRT. Per impostazione predefinita, YOLO26 produce output grezzi one-to-many per NMS sull'host; nms=False seleziona i suoi output one-to-one senza NMS. Segmentazione, stima della posa e OBB usano tensori grezzi delle head, la classificazione restituisce probabilità on-chip e la segmentazione semantica restituisce logit grezzi su Hailo-8/8L e su tutte le head a classe singola, oppure mappe di classe precalcolate per le head multi-classe Hailo-10H/15. La stima della profondità restituisce il logit di profondità grezzo, che Ultralytics decodifica in una mappa di profondità metrica durante l'inferenza. Le forme dinamiche, la NMS integrata di Ultralytics, FP16 e FP32 non sono supportati.
Risoluzione dei problemi di esportazione Hailo#
Errore di importazione del Dataflow Compiler di Hailo#
Se l'esportazione segnala che manca hailo_sdk_client, installa il wheel DFC per la generazione hardware target nello stesso ambiente Python di Ultralytics. Hailo-8/8L e Hailo-10H/15 richiedono generazioni diverse del compilatore.
Sistema operativo o architettura non supportati#
La compilazione HEF è supportata su Linux x86_64. Esporta tramite Ultralytics Platform oppure usa una workstation compatibile se il computer locale esegue macOS, Windows, Raspberry Pi o un altro sistema ARM.
L'esportazione richiede molto tempo#
L'ottimizzazione DFC è la fase più onerosa. Il tempo di compilazione aumenta con le dimensioni del modello, la risoluzione dell'input e i dati di calibrazione. Una GPU supportata può accelerare l'ottimizzazione, mentre la compilazione solo su CPU può essere notevolmente più lenta.
Calo della precisione del modello quantizzato#
Usa immagini di calibrazione simili agli input di produzione e che includano gli oggetti, le scale, le condizioni di illuminazione e gli sfondi importanti. Prima della distribuzione, confronta il modello PyTorch originale e l'HEF esportato sullo stesso set di convalida. Anche con una buona calibrazione permane un divario moderato, che varia in base alla famiglia; consulta Aspettative di precisione per famiglia di modelli per i valori di riferimento misurati.
L'HEF non si carica sul dispositivo#
Verifica che name corrisponda all'architettura Hailo fisica e che il driver del dispositivo, il firmware e i pacchetti HailoRT siano compatibili tra loro. Ispeziona l'artefatto con hailortcli parse-hef e verifica l'acceleratore con hailortcli fw-control identify.
L'analisi dell'output sembra errata#
Tieni metadata.yaml accanto all'HEF, così Ultralytics può selezionare il percorso di post-processing corrispondente per YOLOv8, YOLO11 o YOLO26. Anche le applicazioni HailoRT personalizzate devono abbinare il post-processing alla famiglia del modello esportato.
Riepilogo#
L'esportazione Hailo di Ultralytics offre un percorso diretto da un modello YOLO addestrato a un HEF distribuibile:
- Carica un modello di rilevamento o classificazione YOLOv8, YOLO11 o YOLO26, un modello di segmentazione, stima della posa o OBB YOLOv8/YOLO11 oppure un modello di segmentazione semantica o stima della profondità YOLO26.
- Esporta con
format="hailo"e seleziona l'architettura target. - Esegui localmente la calibrazione e la compilazione con il DFC corrispondente oppure usa l'esportazione gestita in Ultralytics Platform.
- Copia l'HEF e
metadata.yamlsul dispositivo edge con acceleratore Hailo. - Esegui l'inferenza con HailoRT, Raspberry Pi Picamera2 o una pipeline video GStreamer.
Per altri target di distribuzione per la visione artificiale, consulta Modalità Export, Modalità Benchmark e la guida alle integrazioni. Le guide correlate all'hardware includono DeepX, Axelera, ONNX, OpenVINO, TensorRT, NCNN, RKNN, Sony IMX500 e Qualcomm QNN.
Domande frequenti#
No. Esegui il DFC su un sistema Linux x86_64 supportato e distribuisci l'HEF risultante su Raspberry Pi.
Una GPU supportata riduce notevolmente il tempo di ottimizzazione DFC. È possibile compilare su CPU, ma l'operazione può richiedere molto più tempo.
L'esportazione diretta supporta i modelli di rilevamento con la head di rilevamento standard YOLOv8, YOLO11 o YOLO26, i modelli di segmentazione, stima della posa e OBB YOLOv8/YOLO11 e i modelli di classificazione YOLOv8/YOLO11/YOLO26. Sono inclusi i modelli addestrati su dati personalizzati e basati su queste architetture standard. Sono supportati anche i modelli YOLO26 di segmentazione semantica e stima della profondità. I modelli YOLO26 di segmentazione di istanze, stima della posa e OBB, oltre a YOLOv10, YOLO-World, YOLOE e RT-DETR, vengono rifiutati invece di generare un HEF non convalidato.
Sì. Usa lo stesso comando
format="hailo"con i pesi personalizzati.pte passa lo YAML del dataset di addestramento tramitedataper una calibrazione INT8 rappresentativa. I nomi e il numero delle classi vengono letti dai metadati del modello.Ogni HEF viene compilato per una forma di input fissa, quindi un singolo HEF non può essere ridimensionato dinamicamente. In pratica, puoi ridimensionare gli input sull'host alla dimensione compilata oppure compilare più HEF per le risoluzioni necessarie. In fase di esportazione, scegli
imgszin modo che corrisponda alla pipeline di distribuzione.YOLO26 usa una regressione dei riquadri senza DFL, quindi entrambe le head vengono compilate in tensori grezzi anziché nella pipeline NMS di HailoRT in stile YOLOv8. Per impostazione predefinita, Ultralytics decodifica i tensori e applica NMS oppure, se esportato con
nms=False, restituisce rilevamenti senza NMS.Hailo Dataflow Compiler converte e quantizza il modello in un HEF specifico per l'hardware su una macchina di compilazione Linux x86_64. HailoRT carica ed esegue quell'HEF sul dispositivo target.
Distribuisci l'HEF compilato sul runtime Hailo. ONNX è una rappresentazione intermedia usata durante l'esportazione e viene rimosso dopo la compilazione.
Scarica il wheel del compilatore per la tua generazione hardware da Hailo Developer Zone. Il compilatore serve solo per creare l'HEF; HailoRT lo esegue sull'acceleratore target.