Esportazione Qualcomm QNN per i modelli Ultralytics YOLO#
La distribuzione di modelli di computer vision sui dispositivi Qualcomm Snapdragon richiede un formato del modello ottimizzato per il runtime Qualcomm AI Engine Direct (QNN). Esportare i modelli Ultralytics YOLO nel formato QNN consente di eseguire inferenze accelerate direttamente sul dispositivo con l'hardware CPU Snapdragon, GPU Adreno e NPU Hexagon, presente in miliardi di telefoni cellulari, laptop, sistemi automobilistici e dispositivi IoT. Questa guida illustra come esportare YOLO in Qualcomm QNN e distribuirlo per eseguire inferenze rapide e a basso consumo sull'hardware Snapdragon.
Il plugin Flutter ufficiale di Ultralytics offre il supporto QNN opzionale per l'inferenza in tempo reale dalla fotocamera e la predizione su singola immagine per tutte e sette le attività di YOLO26. Abilita il runtime QNN e aggiungi la relativa dipendenza ONNX Runtime come descritto nel README del plugin. Per la distribuzione su iOS, consulta Ultralytics YOLO iOS SDK e l'integrazione CoreML.
Esporta i modelli di classificazione in imgsz=224. Esporta i modelli di rilevamento, segmentazione, semantici, di profondità, posa e OBB in imgsz=640. Questo standard 224/640 è condiviso dagli asset mobili ufficiali QNN, LiteRT e CoreML. Gli asset v73 e v81 pronti all'uso per tutte e sette le attività nano sono pubblicati nella release v0.6.6 di yolo-flutter-app.
Che cos'è Qualcomm QNN?#
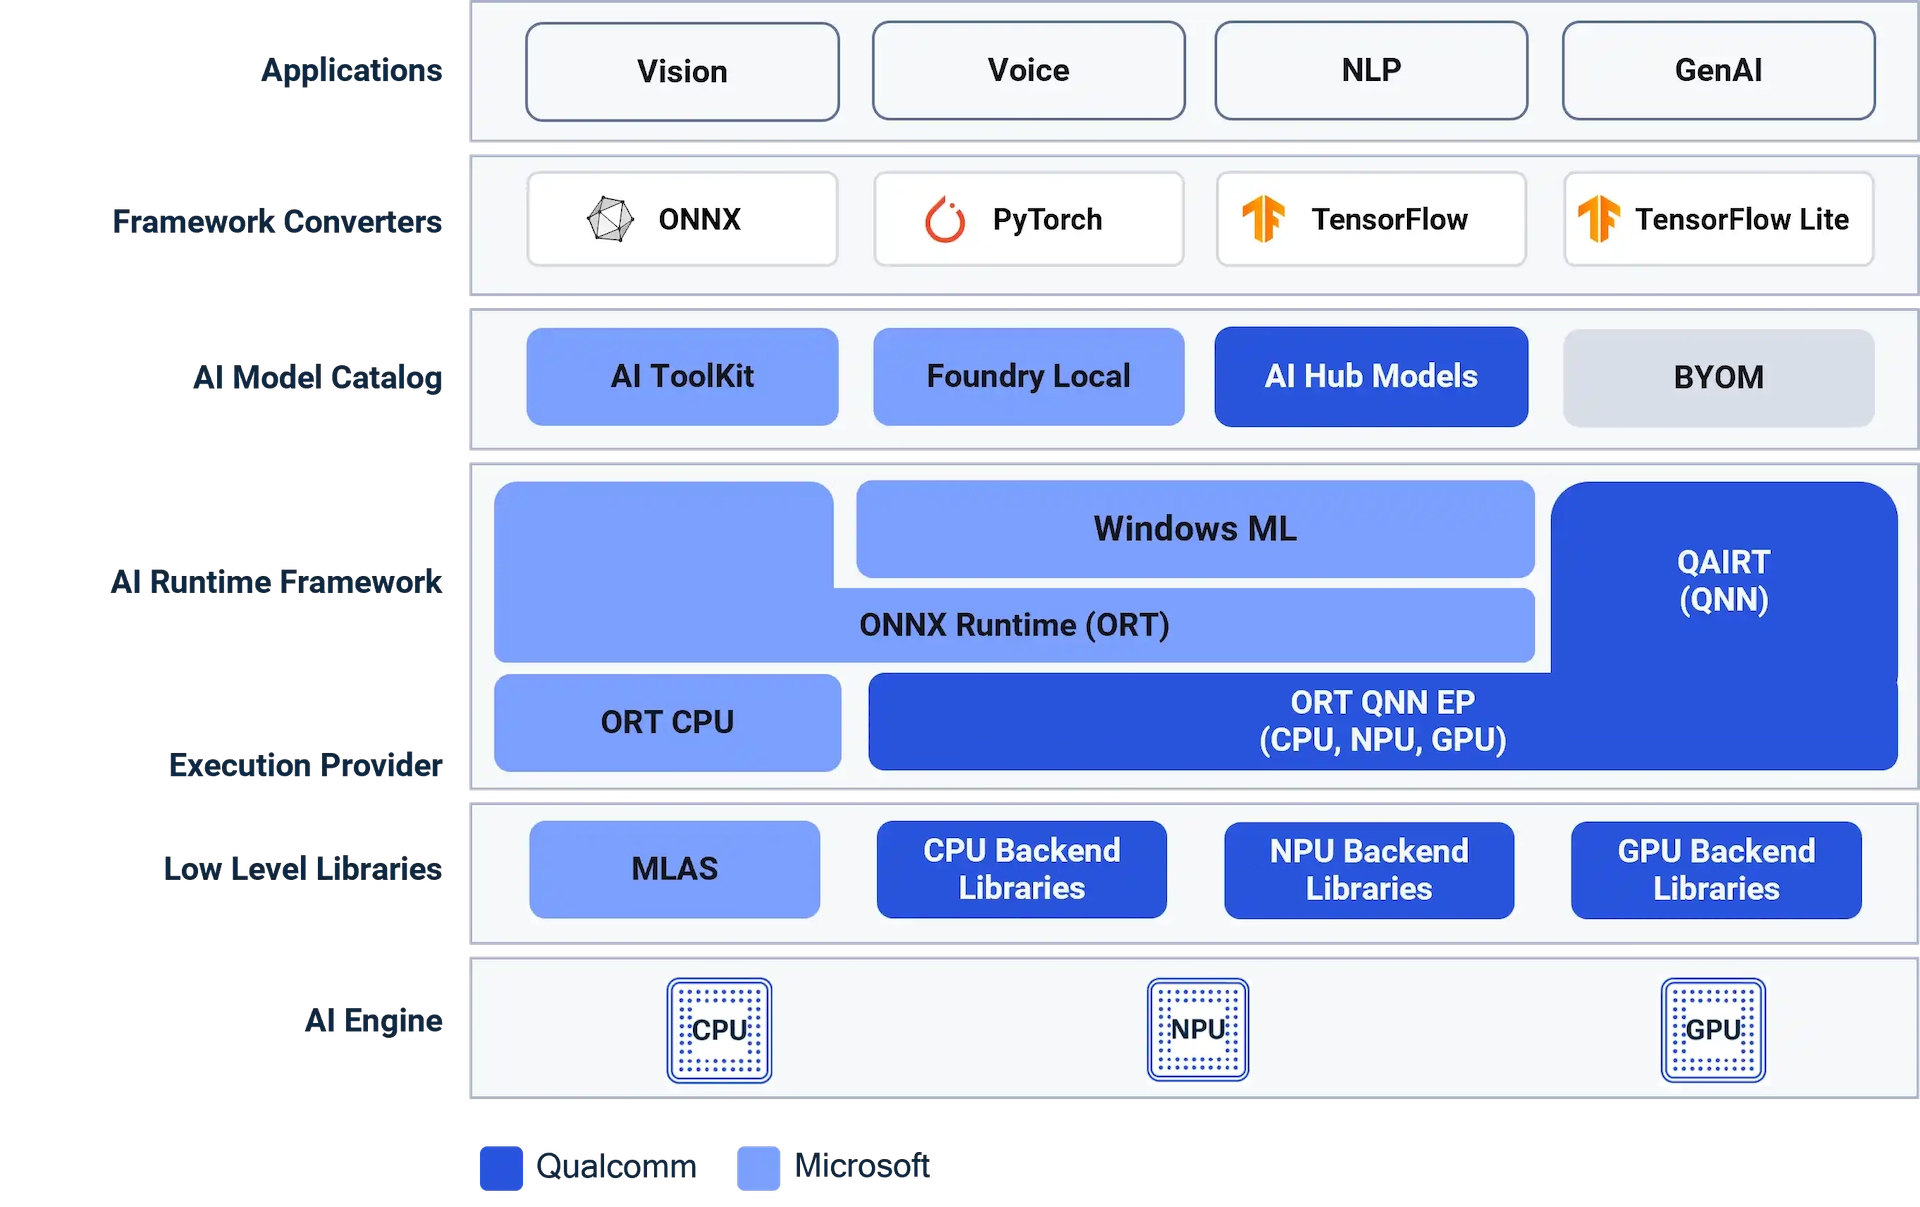
Qualcomm AI Engine Direct — comunemente noto come QNN e distribuito come parte dell'SDK Qualcomm per l'ambiente di esecuzione dell'intelligenza artificiale (QAIRT) — è lo stack di inferenza a basso livello di Qualcomm per i processori Snapdragon. Fornisce un'API unificata con librerie specifiche per ciascun backend, destinate alla CPU Snapdragon, alla GPU Adreno e al processore tensoriale Hexagon (HTP), l'unità dedicata all'elaborazione delle reti neurali (NPU) integrata nei moderni SoC Snapdragon. QNN offre agli sviluppatori accesso completo allo stack di questi acceleratori AI di Snapdragon ed è il successore moderno del vecchio SDK del motore di elaborazione neurale Snapdragon (SNPE). Consente l'esecuzione locale dell'AI sulle piattaforme mobili Snapdragon 8 Gen 2, 8 Gen 3 e 8 Elite, sui laptop Snapdragon X e sui prodotti automotive e XR.
Perché esportare in Qualcomm QNN?#
Snapdragon è la piattaforma di elaborazione mobile più diffusa al mondo. Esportare Ultralytics YOLO nel formato Qualcomm QNN permette di sfruttare l'hardware AI dedicato di questi dispositivi:
- Accelerazione NPU Hexagon: eseguire YOLO sul processore Tensor Hexagon offre un throughput nettamente superiore e un consumo inferiore rispetto all'inferenza su CPU: l'ideale per l'inferenza in tempo reale e la computer vision sempre attiva su Snapdragon.
- On-device e offline: l'inferenza QNN viene eseguita interamente sul dispositivo Snapdragon, senza comunicazioni di andata e ritorno con il cloud; la latenza rimane bassa e i dati non escono mai dal dispositivo.
- Efficienza della quantizzazione: l'esportazione QNN quantizza YOLO con pesi INT8 e attivazioni a 16 bit, il compromesso tra accuratezza e prestazioni preferito dalla NPU Hexagon. Questo riduce le dimensioni del modello e massimizza i fotogrammi al secondo sull'hardware alimentato a batteria.
- Un formato, molti dispositivi: una singola esportazione Qualcomm QNN è destinata alle CPU Snapdragon, alle GPU Adreno e alle NPU Hexagon delle famiglie Snapdragon 8 Gen 2, 8 Gen 3 e 8 Elite e successive.
- Stack Qualcomm AI pronto per la produzione: QNN (Qualcomm AI Engine Direct / QAIRT) è il runtime AI on-device attuale di Qualcomm, mantenuto attivamente e consigliato come sostituto di SNPE.
Formato di esportazione QNN#
Ultralytics compila localmente i modelli YOLO in QNN usando il provider di esecuzione QNN di ONNX Runtime (il pacchetto onnxruntime-qnn, installabile con pip e contenente le librerie QAIRT). L'esportatore converte il modello in ONNX, lo quantizza con dati di calibrazione usando attivazioni a 16 bit e pesi INT8 (il compromesso consigliato per la NPU Hexagon), quindi inizializza una sessione ONNX Runtime con la memorizzazione nella cache del context binary abilitata: in questo modo il grafo quantizzato viene compilato in un context binary QNN incorporato in <model>_qnn.onnx. Non serve un account Qualcomm, né caricare dati sul cloud o scaricare un SDK separato.
A differenza di Qualcomm AI Hub, basato sul cloud, che compila e profila i modelli su dispositivi Snapdragon ospitati da Qualcomm e richiede un account Qualcomm, l'esportazione QNN di Ultralytics viene eseguita interamente sul tuo computer con una sola chiamata export(format="qnn", imgsz=640) (imgsz=224 per la classificazione). Ottieni lo stesso runtime QNN/QAIRT — CPU Snapdragon, GPU Adreno e NPU Hexagon — senza registrazione, limiti di caricamento o tempi di attesa, e puoi integrarlo direttamente nel flusso di lavoro standard di esportazione YOLO.
Il file *_qnn.onnx esportato è autonomo: incorpora il context binary QNN e metadati ONNX come i nomi delle classi, la dimensione dell'immagine e l'attività.
Funzionalità principali dei modelli QNN#
- Quantizzazione: il modello viene quantizzato con attivazioni a 16 bit e pesi INT8 usando il flusso QDQ QNN di ONNX Runtime e un dataset di calibrazione: il compromesso tra accuratezza e prestazioni consigliato per la NPU Hexagon. Scopri di più sulla quantizzazione dei modelli.
- Compilazione interamente locale: il context binary viene generato interamente sul tuo computer host, senza account Qualcomm, token API o caricamenti sul cloud.
- Accelerazione Snapdragon completa: esegui l'inferenza sulla NPU Hexagon (HTP), sulla GPU Adreno o sulla CPU tramite un unico runtime unificato.
- Ampia compatibilità con i dispositivi: supporta l'ampia gamma di piattaforme Snapdragon presenti su telefoni, PC (Windows su Snapdragon), prodotti per il settore automobilistico, XR e sistemi embedded.
- Context binary precompilato: distribuire un context binary riduce al minimo la compilazione del grafo sul dispositivo, diminuendo la latenza di caricamento del modello sul dispositivo di destinazione.
- Output autonomo: il file ONNX esportato include il context binary QNN precompilato e i metadati per semplificare la distribuzione.
Prestazioni misurate#
Telefono Android#
Hardware: Xiaomi 17 con 12 GB di memoria LPDDR5X e Android 16 / API 36. Il suo Snapdragon 8 Elite Gen 5 a 3 nm (SM8850) ha una CPU Qualcomm Oryon a 8 core (2 core Prime fino a 4,6 GHz e 6 core Performance fino a 3,62 GHz), una GPU Adreno e una NPU Hexagon (HTP v81).
| Modello | Attività | dimensione (pixel) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Rilevamento | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | Segmentazione | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | Semantica | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | Profondità | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | Classificazione | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | Posa | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- I valori di velocità sono latenze in burst su singola immagine: la media di 15 esecuzioni dopo 3 esecuzioni di riscaldamento su
bus.jpg, misurata con il benchmark on-device0.6.10del plugin Flutter e gli asset standardizzativ0.6.6. L'ordine dei backend è stato alternato tra le attività in un'unica sequenza. I log nativi hanno confermato che ogni riga CPU usava LiteRT CPU/XNNPACK, ogni riga GPU delegava il grafo completo a LiteRT OpenCL (LITERT_CL) e ogni riga NPU usava il backend QNN Hexagon HTP. - Il resoconto dettagliato del benchmark è disponibile nel documento sulle prestazioni Flutter.
- Confronta altri dispositivi Android nell'integrazione LiteRT e i dispositivi Apple nell'integrazione CoreML.
Laptop Windows su Snapdragon#
Questa prova storica ha usato file binari QNN v73 precedenti alla standardizzazione; le attività semantiche e OBB hanno usato input da 1024 px. È stata eseguita su un laptop Lenovo con 32 GB di memoria e Windows 11. Il suo Snapdragon X Elite (X1E78100) ha una CPU Qualcomm Oryon a 12 core, una GPU Adreno e una NPU Hexagon (HTP v73); il modello esatto del Lenovo non è stato registrato. Questo confronto su Windows con Snapdragon mette a confronto la baseline CPU nativa PyTorch FP32, da cui partono la maggior parte degli sviluppatori desktop, con il percorso ONNX Runtime QNN Hexagon HTP. Ogni cella mostra il tempo totale model.predict() con sotto i tempi riportati di preelaborazione / inferenza / postelaborazione; il totale può includere overhead del framework esterno a queste tre fasi. I valori CPU sono PyTorch FP32 (torch==2.10.0+cpu) e i valori NPU sono ONNX Runtime QNN (onnxruntime-qnn==2.2.0, pesi INT8 / attivazioni a 16 bit).
| Modello | Attività | dimensione (pixel) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Rilevamento | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segmentazione | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Semantica | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Classificazione | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Posa | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- I valori di Speed sono latenze a raffica su singola immagine: la media di 100 esecuzioni dopo 10 esecuzioni di riscaldamento su
bus.jpg, misurata contime.perf_counter()intorno all'intera chiamatamodel.predict()su un dispositivo lasciato raffreddare (ultralytics==8.4.67, Python 3.12.10). - L'NPU Hexagon è circa 2-4 volte più veloce della baseline CPU di PyTorch per le attività da 640 a 1024 px (rilevamento ~3.4x); il vantaggio scende a ~1.3x sul classificatore da 224 px, dove i costi fissi di preelaborazione incidono maggiormente sul carico di lavoro ridotto.
Attività supportate#
L'esportazione Qualcomm QNN supporta tutte e sette le attività Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste head.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Stima della posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Esportazione in QNN: conversione del tuo modello YOLO#
Esporta un modello Ultralytics YOLO nel formato QNN per distribuirlo sull'hardware Qualcomm. Il binario di contesto viene finalizzato per un'architettura Hexagon Tensor Processor (HTP) o un SoC supportato, selezionabili con l'argomento name, lo stesso argomento usato per specificare il chip nell'esportazione RKNN.
Target HTP supportati#
Specifica l'architettura target o il SoC tramite name (ad es. name="73" o name="iq-8275"). Il supporto è determinato dal target HTP, quindi le righe Snapdragon qui sotto rappresentano piattaforme esemplificative e non un elenco esaustivo di tutti i SoC. I dispositivi Dragonwing sono elencati esplicitamente.
| Stato | name | Hexagon HTP | Dispositivo o piattaforma di esempio |
|---|---|---|---|
| ✅ Supportato | 68 | v68 | Snapdragon 888 |
| ✅ Supportato | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Supportato | 73 | v73 | Snapdragon 8 Gen 2, X Elite (predefinito) |
| ✅ Supportato | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Supportato | 79 | v79 | Snapdragon 8 Elite |
| ✅ Supportato | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Supportato | iq-8275 o qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (modello SoC QNN 82) |
| ❌ Non supportato | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 non può usare l'esportazione Ultralytics QNN del binario di contesto perché ONNX Runtime non espone il suo DSP v66 come target HTP offline. È comunque possibile integrare separatamente un'esportazione ONNX standard con un provider di esecuzione CPU o GPU supportato dal BSP della scheda.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)L'esportazione QNN utilizza il pacchetto onnxruntime-qnn. Dalla versione 2.4.0, sono disponibili wheel precompilate per Windows (x64 e ARM64) e Linux (x86-64 e ARM64) con Python 3.11 o versioni successive; macOS non è un host QNN supportato. La generazione del binario di contesto QNN viene eseguita su un host x64 e non richiede un dispositivo Snapdragon per l'esportazione.
Installazione#
Per installare i pacchetti necessari, esegui:
# Install the required package for YOLO
pip install ultralytics
Il pacchetto onnxruntime-qnn (che fornisce il provider di esecuzione QNN di ONNX Runtime e include le librerie QAIRT) viene installato automaticamente alla prima esportazione. Per istruzioni dettagliate e best practice sul processo di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti richiesti per YOLO riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Utilizzo#
Il formato QNN supporta le modalità Esportazione, Previsione e Validazione. L'inferenza e la validazione vengono eseguite sull'hardware Qualcomm Snapdragon tramite il provider di esecuzione QNN di ONNX Runtime (lo stesso pacchetto onnxruntime-qnn usato per l'esportazione). Esporta il modello, quindi carica il modello esportato su un dispositivo Snapdragon per eseguire l'inferenza o verificarne l'accuratezza.
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta nel formato Qualcomm QNN (INT8, applicato automaticamente) per il target HTP v73 predefinito
model.export(format="qnn", name="73", imgsz=640) # usa imgsz=224 per la classificazionefrom ultralytics import YOLO
# Carica il modello QNN esportato (su un dispositivo Snapdragon con onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carica il modello QNN esportato (su un dispositivo Snapdragon con onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# # Convalida l'accuratezza sul dataset COCO8
metrics = model.val(data="coco8.yaml")Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'qnn' | Formato target per il modello esportato, che definisce la compatibilità con il runtime Qualcomm QNN. |
imgsz | int o tuple | 640 | Dimensione desiderata dell'immagine di input del modello. Può essere un intero per immagini quadrate oppure una tupla (height, width). |
batch | int | 1 | Specifica la dimensione del batch del modello da esportare, incorporata nel binario di contesto QNN generato. |
name | str | '73' | Architettura Hexagon HTP target (68, 69, 73, 75, 79 o 81) o SoC supportato (iq-8275 o qcs8275). Il binario di contesto viene finalizzato per questo target. |
quantize | int o str | 'w8a16'/auto | Precisione della quantizzazione. L'esportazione QNN HTP usa pesi INT8 e attivazioni a 16 bit ('w8a16') e viene attivata automaticamente se non specificata. Sostituisce i flag deprecati half/int8. |
simplify | bool | True | Semplifica il grafo ONNX intermedio con onnxslim. |
opset | int | None | Specifica la versione opset ONNX per il grafo ONNX intermedio. Se non è impostata, viene usata l'ultima versione supportata. |
data | str | None | File YAML del dataset usato per la calibrazione INT8; per la classificazione, invece, accetta una directory del dataset o il nome di un dataset integrato. Se omesso, Ultralytics seleziona il dataset di calibrazione predefinito per l'attività del modello. |
fraction | float, int o list | 1.0 | Sottoinsieme di calibrazione espresso come rapporto, numero di immagini o rapporti/conteggi [train, val, test]. Gli elenchi di due elementi lasciano completo test, mentre 0 lo esclude. |
device | str | None | Specifica il dispositivo per la fase di esportazione ONNX: GPU (device=0) o CPU (device=cpu). |
L'esportazione QNN quantizza il modello con attivazioni a 16 bit e pesi INT8 — il compromesso consigliato tra accuratezza e prestazioni per l'NPU Hexagon — usando il flusso di quantizzazione QDQ di ONNX Runtime con immagini di calibrazione da data. quantize='w8a16' viene applicato automaticamente.
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
Struttura dell'output#
Al termine dell'esportazione viene creato un file ONNX autonomo:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
Il file yolo26n_qnn.onnx incorpora il binario di contesto QNN e viene caricato da ONNX Runtime con il provider di esecuzione QNN sul dispositivo Snapdragon. Contiene anche metadati del modello, come i nomi delle classi, le dimensioni dell'immagine e l'attività, in ONNX metadata_props.
Distribuzione dei modelli YOLO QNN esportati#
I modelli QNN vengono eseguiti su hardware Qualcomm supportato, semplificando la distribuzione dei modelli direttamente sul dispositivo. Su un dispositivo compatibile con onnxruntime-qnn installato, esegui direttamente il modello esportato con l'API Ultralytics (yolo predict/yolo val; vedi Utilizzo sopra): Ultralytics carica il binario di contesto HTP tramite il provider di esecuzione QNN di ONNX Runtime.
Per le pipeline personalizzate, puoi anche caricare direttamente il file ONNX del binario di contesto con ONNX Runtime. onnxruntime-qnn è un provider di esecuzione plug-in, quindi registralo in fase di esecuzione:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# Sul dispositivo Snapdragon, registra il provider di esecuzione QNN plug-in e seleziona il/i dispositivo/i
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Poiché il binario di contesto QNN è precompilato, la sessione si carica rapidamente senza ricompilare il grafo sul dispositivo.
Requisiti Linux e Yocto BSP#
La scheda target deve fornire un runtime Qualcomm e un BSP compatibili tra loro. Per l'inferenza HTP, sono necessari il provider di esecuzione QNN di ONNX Runtime, libQnnSystem.so, libQnnHtp.so, le librerie stub e skeleton HTP v75 per IQ-8275, il supporto FastRPC nello spazio utente, ad esempio libcdsprpc.so, il firmware DSP e i driver FastRPC/kernel corrispondenti. La libreria skeleton deve essere individuabile tramite il percorso delle librerie DSP del BSP.
Questi componenti lato target provengono dal BSP del produttore della scheda abilitato per QAIRT/QNN; non sono incorporati nel modello esportato. L'esecuzione GPU richiede invece libQnnGpu.so e lo stack di driver nello spazio utente Adreno corrispondente. L'output Ultralytics format=qnn è un binario di contesto specifico per HTP, quindi la distribuzione su GPU o CPU dovrebbe partire da un'esportazione ONNX standard anziché dal file precompilato *_qnn.onnx.
Flusso di lavoro consigliato#
- Addestra il tuo modello usando la modalità Train di Ultralytics
- Esporta nel formato QNN usando
model.export(format="qnn", name="iq-8275", imgsz=640)su una piattaforma supportata (usaimgsz=224per la classificazione) - Distribuisci il file
*_qnn.onnxesportato sul tuo dispositivo Qualcomm - Esegui l'inferenza con ONNX Runtime e il provider di esecuzione QNN usando il backend HTP
Applicazioni nel mondo reale#
I modelli YOLO eseguiti sull'hardware Qualcomm Snapdragon sono adatti a un'ampia gamma di applicazioni di edge AI:
- Smartphone: Rilevamento di oggetti in tempo reale e comprensione delle scene nelle app della fotocamera e delle foto con accelerazione NPU.
- Windows su Snapdragon: visione artificiale direttamente sul dispositivo nei PC Copilot+ senza trasferire i dati sul cloud.
- Automotive: monitoraggio del conducente, rilevamento degli occupanti e funzionalità ADAS sulle piattaforme Snapdragon Digital Chassis.
- XR e dispositivi indossabili: percezione a basso consumo e bassa latenza per visori AR/VR e occhiali smart.
- IoT e robotica: inferenza visiva efficiente su fotocamere, droni e sistemi embedded basati su Snapdragon.
Riepilogo#
In questa guida hai imparato a esportare localmente i modelli Ultralytics YOLO nel formato Qualcomm QNN con il provider di esecuzione QNN di ONNX Runtime. La pipeline di esportazione converte il modello in ONNX, quindi lo compila in un binario di contesto QNN sul computer host, senza bisogno di un account Qualcomm né del cloud, generando un file *_qnn.onnx ottimizzato per CPU Snapdragon, GPU Adreno e hardware NPU Hexagon tramite il runtime QNN/QAIRT.
La combinazione di Ultralytics YOLO e dello stack di IA direttamente sul dispositivo di Qualcomm offre una soluzione efficace per eseguire carichi di lavoro avanzati di visione artificiale nell'ampio ecosistema Snapdragon.
Per altri target di distribuzione su dispositivo e mobile, consulta le guide correlate all'esportazione ONNX, CoreML, NCNN, LiteRT, ExecuTorch, RKNN, Sony IMX500 e TensorRT. Per confrontare i formati prima della distribuzione, usa la modalità Benchmark. Per l'elenco completo dei formati e delle opzioni, consulta la documentazione della modalità Export e la pagina della guida alle integrazioni.
Domande frequenti#
Puoi esportare il modello usando
export(format="qnn", imgsz=640)(imgsz=224per la classificazione) o gli argomenti CLI equivalenti. L'esportazione crea prima un modello ONNX, poi lo compila localmente in un binario di contesto QNN usando il provider di esecuzione QNN di ONNX Runtime. Il pacchettoonnxruntime-qnnviene installato automaticamente alla prima esportazione.Esempiofrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # usa imgsz=224 per la classificazioneNo. L'esportazione QNN viene eseguita interamente sul tuo computer locale usando il pacchetto
onnxruntime-qnn, che include le librerie QAIRT. Non sono necessari un account Qualcomm, un token API o l'accesso alla rete.Qualcomm AI Hub è il servizio cloud di Qualcomm per compilare, profilare e confrontare le prestazioni dei modelli su dispositivi Snapdragon ospitati; richiede un account Qualcomm. L'esportazione Ultralytics QNN è destinata allo stesso runtime QNN/QAIRT (CPU Snapdragon, GPU Adreno e NPU Hexagon), ma compila il binario di contesto localmente con il provider di esecuzione QNN di ONNX Runtime, senza account, caricamenti né code. È il modo più rapido per passare da un modello
.pta una build pronta per Snapdragon, direttamente nel normale flusso di esportazione YOLO.onnxruntime-qnn2.4.0 e versioni successive fornisce wheel precompilate per Windows (x64 e ARM64) e Linux (x86-64 e ARM64) con Python 3.11 o versioni successive; macOS non è un host QNN supportato. La generazione del binario di contesto viene eseguita su un host x64 e non richiede un dispositivo Snapdragon fisico.Esporta con
model.export(format="qnn", imgsz=640)(imgsz=224per la classificazione), copia il file risultanteyolo26n_qnn.onnxsul dispositivo Snapdragon ed eseguiyolo predict model=yolo26n_qnn.onnx source=image.jpg(oyolo val). Ultralytics carica il binario di contesto tramite il provider di esecuzione QNN di ONNX Runtime e lo esegue sull'NPU Hexagon: consulta Distribuzione dei modelli YOLO QNN esportati.QNN (Qualcomm AI Engine Direct, parte del QAIRT SDK) è lo stack di inferenza attuale di Qualcomm e il sostituto consigliato per il precedente SDK Snapdragon Neural Processing Engine (SNPE). Le nuove distribuzioni dovrebbero usare QNN.
Sì, su un dispositivo Qualcomm Snapdragon con
onnxruntime-qnninstallato:YOLO("yolo26n_qnn.onnx")carica il binario di contesto tramite il provider di esecuzione QNN ed eseguepredict/valcome in qualsiasi altro formato. Su un host x86 senza hardware QNN, il modello non può essere eseguito, perché il binario di contesto è destinato all'NPU Snapdragon.L'esportazione crea un file ONNX autonomo con binario di contesto (ad es.
yolo26n_qnn.onnx) che incorpora i nomi delle classi, le dimensioni dell'immagine, l'attività e altri metadati del modello in ONNXmetadata_props.