Segmentazione Semantica con Ultralytics YOLO#
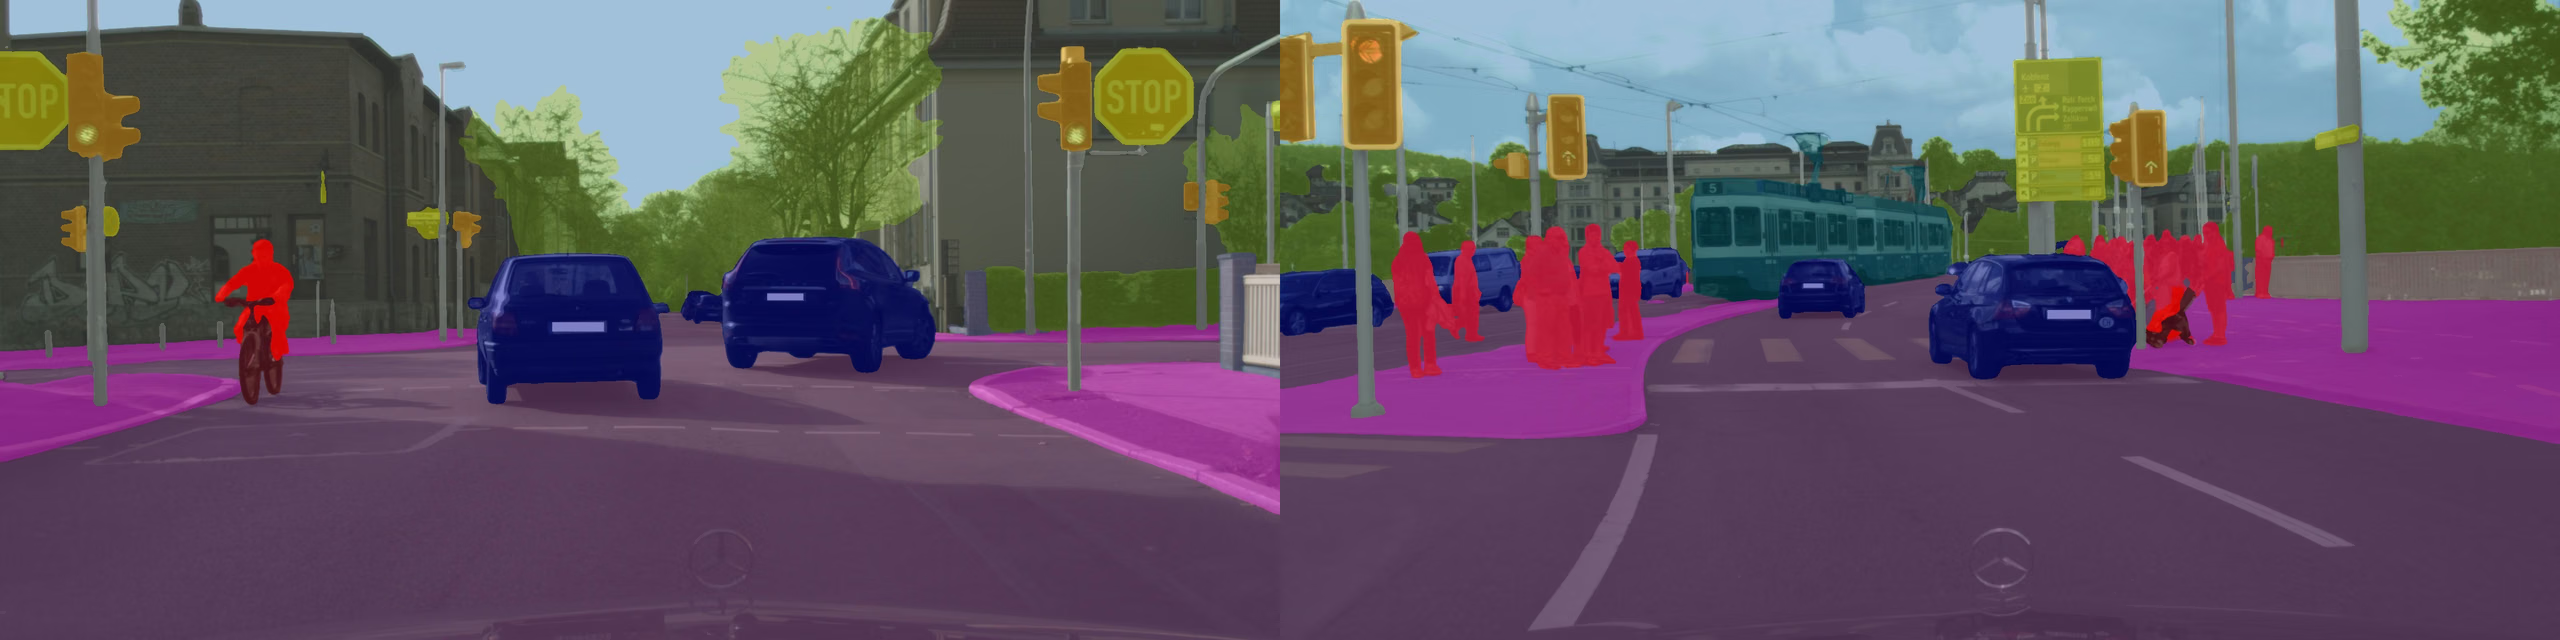
La segmentazione semantica assegna un'etichetta di classe a ogni pixel di un'immagine, producendo una mappa di classe densa che copre l'intera scena. A differenza della segmentazione delle istanze, che separa i singoli oggetti, la segmentazione semantica raggruppa tutti i pixel della stessa classe indipendentemente dal numero di oggetti distinti presenti.
Watch: Semantic Segmentation with Ultralytics YOLO26 | Quickstart Tutorial
L'output di un modello di segmentazione semantica è un'unica mappa di classe con altezza e larghezza, in cui il valore di ogni pixel corrisponde all'ID della classe predetta. Questo rende la segmentazione semantica ideale per attività di interpretazione della scena come guida autonoma, imaging medico e mappatura della copertura del suolo.
Usa l'attività CLI task=semantic o yolo semantic per la segmentazione semantica. I file dei modelli di segmentazione semantica YOLO26 usano il suffisso -sem, come yolo26n-sem.pt.
Modelli#
Di seguito sono mostrati i modelli di segmentazione semantica YOLO26 preaddestrati sul dataset Cityscapes.
I modelli vengono scaricati automaticamente dall'ultima release di Ultralytics al primo utilizzo.
| Modello | dimensione (pixel) | mIoUval | Velocità RTX3090 PyTorch (ms) | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- I valori di mIoUval sono calcolati con un singolo modello e una singola scala sul set di convalida Cityscapes.
Riproduci conyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Le metriche di velocità sono mediate sulle immagini di convalida Cityscapes utilizzando un'istanza RTX3090.
Riproduci conyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - I valori di Params e FLOPs si riferiscono al modello fuso dopo
model.fuse(), che unisce i layer Conv e BatchNorm. I checkpoint preaddestrati conservano l'architettura completa di addestramento e possono mostrare conteggi più elevati.
Di seguito sono mostrati i modelli di segmentazione semantica YOLO26 preaddestrati sul dataset ADE20K.
I modelli vengono scaricati automaticamente dall'ultima release di Ultralytics al primo utilizzo.
| Modello | dimensione (pixel) | mIoUval | Velocità RTX3090 PyTorch (ms) | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- I valori di mIoUval sono calcolati con un singolo modello e una singola scala sul set di convalida ADE20K.
Riproduci conyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, sostituendoyolo26n-sem-ade20k.ptcon il checkpointyolo26*-sem-ade20k.ptdesiderato. - Le metriche di velocità sono mediate sulle immagini di convalida ADE20K utilizzando un'istanza RTX3090.
Riproduci conyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, sostituendoyolo26n-sem-ade20k.ptcon il checkpointyolo26*-sem-ade20k.ptdesiderato. - I valori di Params e FLOPs si riferiscono al modello fuso dopo
model.fuse(), che unisce i layer Conv e BatchNorm. I checkpoint preaddestrati conservano l'architettura completa di addestramento e possono mostrare conteggi più elevati.
Consulta l'anteprima inedita di YOLO27 per i risultati preliminari di mIoU su Cityscapes.
Addestramento#
Addestra YOLO26n-sem sul dataset Cityscapes8 per 100 epoche con una dimensione delle immagini di 1024. Per un elenco completo degli argomenti disponibili, consulta la pagina Configurazione.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.yaml")  # build a new model from YAML
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # build from YAML and transfer weights

# Train the model
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Consulta tutti i dettagli della modalità train nella pagina Addestramento. I modelli di segmentazione semantica possono essere addestrati anche con l'addestramento cloud di Ultralytics Platform.
Formato del dataset#
I dataset di segmentazione semantica usano immagini maschera a canale singolo, in genere PNG, in cui ogni valore di pixel rappresenta un ID di classe. I pixel con valore 255 vengono trattati come "ignore" ed esclusi dal calcolo della loss. Il file YAML del dataset deve specificare i percorsi delle immagini e delle directory delle maschere corrispondenti. Consulta la Guida ai dataset di segmentazione semantica per i dettagli sul formato. I dataset supportati includono Cityscapes e ADE20K. Puoi gestire e annotare i dataset semantici con l'annotazione di Ultralytics Platform.
Val#
Convalida l'accuratezza del modello YOLO26n-sem addestrato su un dataset di segmentazione semantica. Passa esplicitamente data in modo che la convalida utilizzi il file YAML del dataset previsto.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Validate the model
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # mean Intersection over Union
metrics.pixel_accuracy # overall pixel accuracyPredizione#
Usa un modello YOLO26n-sem addestrato per eseguire predizioni sulle immagini.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Predict with the model
results = model("https://ultralytics.com/images/bus.jpg")  # predict on an image

# Access the results
for result in results:
    semantic_mask = result.semantic_mask.data  # class map, shape (H,W), integer dtype selected by class count
Consulta la pagina Predict per tutti i dettagli sulla modalità predict.
Output dei risultati#
La segmentazione semantica YOLO restituisce un oggetto Results per immagine. Ogni risultato memorizza una mappa di classe densa per l'intera
immagine invece di un elenco di maschere degli oggetti. I pixel con la stessa classe predetta condividono lo stesso ID di classe, anche quando
appartengono a oggetti separati.
| Attributo | Tipo | Forma | Descrizione |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Mappa densa delle classi. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | ID di classe; dtype selezionato in base al numero di classi. |
result.masks | - | - | Nessuna maschera di istanza. |
result.boxes | - | - | Nessuna box/confidenza delle istanze. |
result.masks.xy | - | - | Nessun poligono predefinito. |
Per i campi Results specifici dell'attività in tutte le attività, consulta la sezione Risultati delle predizioni per attività.
La segmentazione semantica predice una mappa di classe densa, quindi ridimensiona tale mappa alle dimensioni dell'immagine per la visualizzazione e
l'utilizzo successivo. Le strutture molto sottili, come la segnaletica stradale, le linee dei campi, i pali o i cavi, possono quindi apparire
a scalini quando l'inferenza viene eseguita con un imgsz molto inferiore alla risoluzione dell'immagine originale. Se i bordi appaiono
frastagliati, ripeti innanzitutto il test del modello PyTorch nativo .pt con un imgsz maggiore, ad esempio 1024, 1280 o il valore pratico più vicino
alle dimensioni dell'immagine sorgente. Usa i modelli esportati solo dopo aver verificato che l'output .pt sia accettabile,
poiché gli input a risoluzione inferiore non possono recuperare dettagli fini che non erano presenti nella mappa di classe predetta.
Segmentazione delle istanze e segmentazione semantica#
| Aspetto | Segmentazione delle istanze (task="segment") | Segmentazione semantica (task="semantic") |
|---|---|---|
| Obiettivo della predizione | Segmentare separatamente ogni oggetto rilevato | Assegnare un ID di classe a ogni pixel |
| Campo di output | result.masks | result.semantic_mask |
| Dati principali | result.masks.data | result.semantic_mask.data |
| Forma | (N,H,W) | (H,W) |
| Valori dei pixel | Valori della maschera binaria: 0 o 1 | ID di classe: 0, 1, 2, ... |
| Dtype | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Oggetti della stessa classe | Mantenuti come istanze separate | Uniti nella stessa regione di classe |
| Poligoni | Sì, tramite result.masks.xy e result.masks.xyn | Nessun output di poligoni per impostazione predefinita |
| BBox e confidenza | Sì, tramite result.boxes | Nessun BBox o punteggio di confidenza per istanza |
| Utilizzo tipico | Conteggio, tracciamento, ritaglio e misurazione a livello di oggetto | Etichettatura densa della scena, area percorribile, copertura del suolo e regioni mediche |
Esportazione#
Esporta un modello YOLO26n-sem in un formato diverso, come ONNX, CoreML, ecc.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load an official model
model = YOLO("path/to/best.pt")  # load a custom model

# Export the model
model.export(format="onnx")
I formati di esportazione disponibili per la segmentazione semantica YOLO26 sono riportati nella tabella seguente. Puoi esportare in qualsiasi formato usando l'argomento format, ovvero format='onnx' o format='engine'. Puoi eseguire predizioni o convalide direttamente sui modelli esportati, ovvero yolo predict model=yolo26n-sem.onnx. Al termine dell'esportazione verranno mostrati esempi di utilizzo per il tuo modello.
| Formato | Argomento format | Modello | Metadati | Argomenti |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, keras, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
nms=None utilizza i valori predefiniti per gli output grezzi per la NMS esterna. Imposta nms=False per selezionare una testa senza NMS disponibile; i formati non supportati ricorrono al loro percorso di output nativo. Le voci nms sopra indicano i formati che possono incorporare la NMS con nms=True.
Consulta la pagina Export per tutti i dettagli su export.
FAQ#
Per addestrare un modello di segmentazione semantica YOLO26 su un dataset personalizzato, devi preparare immagini maschera PNG in cui ogni valore di pixel rappresenta un ID di classe (0, 1, 2, ...) e i pixel con valore 255 vengono ignorati durante l'addestramento. Crea un file YAML del dataset che punti alle directory delle immagini e delle maschere, quindi addestra il modello:
Esempiofrom ultralytics import YOLO # Load a pretrained YOLO26 semantic segmentation model model = YOLO("yolo26n-sem.pt") # Train the model results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=512)Consulta la pagina Configurazione per altri argomenti disponibili.
La segmentazione delle istanze e la segmentazione semantica sono entrambe attività a livello di pixel, ma differiscono per un aspetto fondamentale:
- La segmentazione semantica assegna un'etichetta di classe a ogni pixel, ma non distingue tra singoli oggetti della stessa classe. Ad esempio, tutte le auto in una scena condividono la stessa etichetta di classe.
- La segmentazione delle istanze identifica separatamente ogni singolo oggetto, producendo maschere distinte per ciascun oggetto anche se appartengono alla stessa classe.
La segmentazione semantica è più adatta alle attività di comprensione della scena, come la guida autonoma e la mappatura della copertura del suolo, mentre la segmentazione delle istanze è preferibile quando è importante contare o tracciare singoli oggetti.
Sì. Se il tuo dataset usa etichette poligonali Ultralytics YOLO (una
.txtper immagine), omettimasks_dirdal file YAML del dataset e assicurati che non esista alcuna cartellamasks/accanto alle immagini nella radice del dataset (la sua sola presenza attiva la modalità maschera PNG anche senza che sia impostatomasks_dir). Il caricatore converte quindi i poligoni in maschere semantiche per immagine al volo. Per i dataset multiclass (N > 1) una classebackgroundaggiuntiva viene aggiunta automaticamente anames. Per i dataset a classe singola (N == 1) l'addestramento rimane a 1 classe: la classe dichiarata diventa1nella maschera e i pixel non coperti diventano0. Consulta la Guida ai dataset di segmentazione semantica per i dettagli.Ultralytics YOLO26 fornisce configurazioni integrate per diversi dataset di segmentazione semantica:
- Cityscapes: scene stradali urbane con 19 classi, ampiamente utilizzate nella ricerca sulla guida autonoma.
- ADE20K: un dataset di interpretazione della scena su larga scala con 150 classi.
Puoi anche usare qualsiasi dataset personalizzato che fornisca annotazioni di maschere PNG in cui i valori dei pixel corrispondono agli ID di classe.
Convalida un modello di segmentazione semantica YOLO26 preaddestrato usando il file YAML del dataset utilizzato per la valutazione:
Esempiofrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Validate the model metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Questi passaggi forniranno metriche di convalida come l'intersezione media sull'unione (mIoU) e l'accuratezza dei pixel, misure standard per valutare le prestazioni della segmentazione semantica.
Esporta un modello di segmentazione semantica YOLO26 in formato ONNX con comandi Python o CLI:
Esempiofrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n-sem.pt") # Export the model to ONNX format model.export(format="onnx")Per maggiori dettagli sull'esportazione in vari formati, consulta la pagina Export.