Stima della profondità monoculare con Ultralytics YOLO#
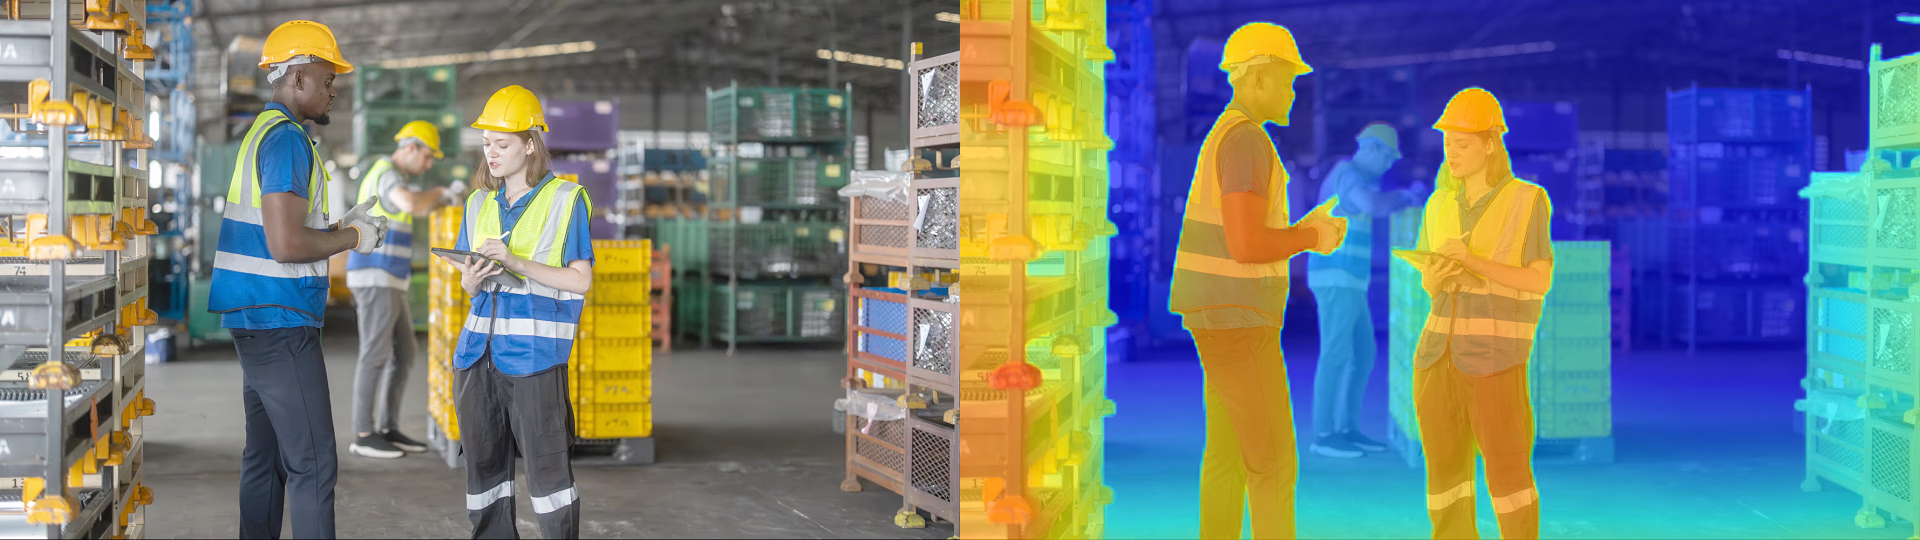
La stima della profondità monoculare prevede una mappa di profondità per pixel a partire da una singola immagine RGB. Ogni pixel in uscita contiene un valore di profondità in metri che rappresenta la distanza stimata tra la telecamera e quel punto della superficie.
L'output di un modello di profondità è una mappa densa di valori float con forma (H, W), allineata all'immagine di input. Questa rappresentazione per pixel rende la stima della profondità monoculare ideale per la ricostruzione di scene 3D, la navigazione robotica, la creazione di contenuti AR/VR e qualsiasi applicazione che richieda la disposizione spaziale ricavata da una singola telecamera.
Guarda: Stima monoculare della profondità con Ultralytics YOLO26 | Tutorial Python | Vision AI 🚀
Usa task=depth o l'attività CLI yolo depth per la stima della profondità monoculare. I file dei modelli di profondità YOLO26 usano il suffisso -depth, ad esempio yolo26n-depth.pt.
Modelli#
Di seguito sono mostrati i modelli di profondità YOLO26 preaddestrati su un'ampia combinazione di più dataset (interni + esterni, ~2.19M immagini). Le colonne delle metriche riportano i risultati sullo split di test Eigen di NYU Depth V2.
I modelli vengono scaricati automaticamente dalla più recente release di Ultralytics al primo utilizzo.
| Modello | dimensione (pixel) | delta1NYU | abs_relNYU | rmseNYU | Velocità CPU ONNX (ms) | Velocità T4 TensorRT10 (ms) | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU è la frazione di pixel per cui la profondità prevista rientra entro un fattore di 1.25 rispetto al valore reale, sullo split di test Eigen di NYU Depth V2 (654 immagini), con TTA a più scale + ribaltamento orizzontale e allineamento ai minimi quadrati sul log.
- L'accuratezza a singola scala senza TTA è riproducibile con
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(sostituiscimodel=con ciascuna dimensione); usa l'allineamento mediano (solo scala) e ottiene punteggi inferiori: delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel è l'errore relativo assoluto medio tra i valori di profondità previsti e quelli reali.
- rmse è la radice dell'errore quadratico medio, espressa in metri.
- Velocità indica la latenza della sola inferenza (esclusa la pre/post-elaborazione) a
imgsz=768,batch=1, riportata come media ± deviazione standard sulle esecuzioni cronometrate dopo il riscaldamento. CPU ONNX indica ONNX Runtime fp32 su un Intel Xeon a 32 core (Skylake); T4 TensorRT10 indica TensorRT fp16 su una Tesla T4. - params e FLOPs sono misurati a 768×768, la risoluzione di addestramento dei pesi rilasciati.
Consulta l'anteprima non rilasciata di YOLO27 per i risultati preliminari su NYU Depth V2.
Velocità a confronto con Depth Anything V2#
Depth Anything V2 è un baseline open source ampiamente utilizzato per la profondità monoculare. Il backbone DINOv2 Vision Transformer e il decoder DPT richiedono molte risorse di calcolo, quindi, sulla stessa Tesla T4 con TensorRT fp16, il modello Depth Anything V2 rilasciato più piccolo è più lento di tutti i modelli di profondità YOLO26, compreso YOLO26x-depth, che ha più del doppio dei parametri.
A ~768 px — imgsz=768 per YOLO26, la risoluzione a cui sono stati addestrati i pesi rilasciati, e 770 px per Depth Anything V2, il cui backbone DINOv2 richiede un multiplo della dimensione della patch pari a 14:
| Modello | params (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Accelerazione rispetto a V2 Small | Accelerazione rispetto a V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
A ~640 px — imgsz=640 e 644 px rispettivamente — l'ordine non cambia e YOLO26n-depth è 5.9× più veloce di Depth Anything V2 Small:
| Modello | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- La latenza è relativa alla sola inferenza,
batch=1, TensorRT fp16 su una Tesla T4: lo stesso banco di prova della tabella dei modelli qui sopra, mostrata con due cifre decimali; gli FPS sono il reciproco della latenza non arrotondata. Le colonne Accelerazione dividono la latenza di Depth Anything V2 Small (20.99 ms) e Base (55.40 ms) per la latenza di YOLO26. - Depth Anything V2 Small e Base sono rispettivamente i checkpoint ViT-S e ViT-B rilasciati.
- Il confronto riguarda solo la latenza: in questa sede, le due famiglie di modelli non vengono valutate con un protocollo di accuratezza condiviso.
Intervallo di profondità e testa log-depth#
La testa di profondità prevede exp(logit) — senza limiti (~0.02–150 m) — e separa la forma della scena dalla scala assoluta: la rete prevede un campo di profondità logaritmica relativa, mentre i metri assoluti sono determinati da una trasformazione separata a due parametri (exp(a·log d + b)), stimata durante la valutazione, tramite una calibrazione leggera o con il fine-tuning. L'alternativa comune, una testa sigmoid × max_depth con intervallo limitato, incorpora invece nell'architettura un limite massimo fisso, perciò qualsiasi profondità oltre max_depth viene tagliata: questo impedisce di addestrare e fare previsioni su scene a distanza maggiore.
Confronto A/B controllato: stessi dati, stessa pianificazione, cambia solo la testa. Addestramento da zero di entrambe le teste su una combinazione identica di dati interni (≤10 m) ed esterni (≤80 m):
| Testa | Intervallo di output | δ1 di convalida su intervallo misto | Comportamento durante l'addestramento |
|---|---|---|---|
sigmoid × max_depth (10 m) | intervallo limitato 0–10 m | 0.221 | si stabilizza all'epoca 1 |
log (senza limiti) | 0–~150 m | 0.367 (+66%) | migliora per tutta la durata dell'addestramento |
La testa con intervallo limitato non può rappresentare la maggior parte dei pixel esterni, che supera i 10 m, quindi smette di migliorare quasi subito; la testa log apprende sull'intero intervallo.
Il problema che risolve: fine-tuning su un singolo dataset, suddiviso per intervallo. Il fine-tuning di una testa con intervallo limitato (10 m) su singoli dataset funziona quando i dati rientrano nel limite e crolla quando lo superano:
| Dataset | Intervallo di profondità | δ1 della testa con intervallo limitato |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | per lo più ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0 — la discrepanza di scala 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
Il crollo si verifica esattamente al limite massimo. La testa log non presenta questo limite.
Modelli rilasciati: prestazioni su intervalli diversi. La famiglia rilasciata con testa log, valutata su benchmark che coprono da 10 m (NYU, iBims-1) a 80 m (KITTI), con δ1 allineato in scala:
| Benchmark | Intervallo | YOLO26x-depth (log) | rilascio precedente con intervallo limitato |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Media | — | 0.819 | 0.799 |
Entrambe le colonne riportano i valori pubblicati. Gli altri risultati sono calcolati con il protocollo TTA e dei minimi quadrati sul log descritto nelle pagine dei rispettivi dataset, che il validatore in questo repository non implementa; pertanto, il risultato su KITTI non può essere rimisurato alle stesse condizioni. La pagina di KITTI riporta invece i valori misurati sullo split Eigen canonico di 652 fotogrammi.
I miglioramenti maggiori si registrano sui benchmark esterni a distanza maggiore (KITTI, ETH3D), proprio dove un limite fisso di 10 m penalizza di più, mentre le prestazioni in ambienti interni restano invariate.
Addestra#
Addestra YOLO26n-depth sul dataset Depth8 per 100 epoche con dimensione immagine 640. Per l'elenco completo degli argomenti disponibili, consulta la pagina Configurazione.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-depth.yaml")  # crea un nuovo modello dal file YAML
model = YOLO("yolo26n-depth.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # crea dal file YAML e trasferisci i pesi

# Addestra il modello
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Consulta la pagina Addestramento per tutti i dettagli della modalità train. Puoi addestrare i modelli di profondità anche usando l'addestramento cloud di Ultralytics Platform.
Formato del dataset#
I dataset per la stima della profondità associano ogni immagine RGB a una mappa di profondità PNG uint16 scalata o a una mappa di profondità NPY in virgola mobile, espressa in metri. Per impostazione predefinita, i valori PNG sono in millimetri; se un dataset usa un'altra convenzione, imposta depth_scale nel relativo YAML. Il caricatore ricava il percorso della mappa di profondità sostituendo il componente images con depth, dando la precedenza a .png e, in sua assenza, usando .npy.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Ad esempio, all'immagine images/train/scene_001.jpg viene associata la mappa di profondità depth/train/scene_001.png. Consulta la guida ai dataset per la stima della profondità per le specifiche complete del formato.
Fine-tuning sui tuoi dati#
Quando adatti un modello di profondità preaddestrato a un dataset personalizzato, riduci il tasso di apprendimento e usa l'ottimizzatore AdamW. Le impostazioni predefinite dell'ottimizzatore sono calibrate per l'addestramento da zero; applicate a un modello di profondità già convergente, possono sovrascrivere le conoscenze preaddestrate e peggiorare i risultati, soprattutto quando esegui il fine-tuning su un singolo dominio.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # parti dai pesi preaddestrati

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100 volte inferiore al valore predefinito per l'addestramento da zero
    warmup_bias_lr=1e-4,  # mantieni graduale anche il warmup
)
Suggerimenti aggiuntivi:
- L'aumento dei dati è controllato dagli argomenti standard (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); la deformazione geometrica e i capovolgimenti vengono applicati in modo identico alla mappa di profondità abbinata. Per vedere la ricetta esatta usata per i pesi YOLO26-Depth rilasciati, esaminatrain_argssalvato nel checkpoint: consulta Esaminare gli argomenti di addestramento del checkpoint YOLO26. mosaic,mixup,cutmixecopy_pastenon sono implementati per la profondità. Il caricatore del dataset di profondità imposta automaticamente queste probabilità a 0, quindi passarle non ha alcun effetto. Questi aumenti dei dati non sono supportati perché combinano più immagini, generando mappe di profondità abbinate non valide.- Qualsiasi intervallo di profondità funziona subito. I modelli
log-head prevedono una profondità senza limiti, quindi si adattano ai dati a corto raggio (macro) o a lungo raggio (esterni/guida) senza modifiche. Impostandomax_depth:nel tuo YAML del dataset (in metri), definisci i pixel GT che vengono considerati nelle metriche di validazione. - Mantieni le prestazioni generali. Se ti serve che il modello rimanga accurato in scene diverse da quelle del tuo set di addestramento, mescola una piccola percentuale (~5–10%) di immagini eterogenee e di uso generale nei dati di addestramento; questo riduce notevolmente l'oblio durante il fine-tuning.
- Addestra da zero (
model=yolo26s-depth.yaml) solo se il tuo dominio è molto diverso e hai un dataset di grandi dimensioni: in quel caso il valore predefinitooptimizer=autoè appropriato, poiché non ci sono pesi preaddestrati da preservare.
Calibrazione della scala di profondità#
La testa di profondità separa la forma (struttura relativa della scena) dalla scala (metri assoluti). Se un modello produce già una buona profondità relativa nelle tue scene, ma i valori assoluti non sono corretti per la tua videocamera, puoi correggere la scala in pochi secondi con model.calibrate(): un adattamento in forma chiusa, limitato alla scala, della trasformazione log-affine della testa rispetto a un piccolo set etichettato, mantenuto solo se migliora δ1 sui dati esclusi dalla validazione incrociata, senza addestramento tramite gradiente e senza modificare i pesi della rete, quindi non può peggiorare la struttura relativa.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Adatta la scala su una suddivisione etichettata (~100+ immagini sono sufficienti), poi salvala
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
La calibrazione richiede profondità di riferimento con cui eseguire l'adattamento, quindi viene effettuata su una suddivisione etichettata: non può essere eseguita durante l'inferenza senza riferimenti. L'adattamento e il calcolo del punteggio usano gli stessi pixel valutati dalle metriche di validazione: i valori GT pari o superiori a max_depth nel YAML del dataset (100 m per impostazione predefinita) vengono esclusi. Usala quando la profondità relativa è già buona e solo la scala/l'intervallo è errato; se è necessario modificare la struttura relativa per il tuo dominio, esegui invece il fine-tuning.
L'addestramento lo fa automaticamente: al termine di model.train(...), i checkpoint best e last vengono calibrati sul set di validazione, in modo da fornire subito una profondità scalata in metri.
I checkpoint yolo26*-depth.pt rilasciati includono già questa calibrazione, adattata alla combinazione di validazione del preaddestramento. Si tratta di un'unica scala globale per tutti i domini, quindi per ottenere la profondità assoluta più accurata con una videocamera o in un tipo di scena specifico, esegui model.calibrate() su una piccola suddivisione etichettata dei tuoi dati: questa sostituirà l'adattamento già incluso.
Ottenere la profondità di ground truth senza una videocamera con sensore di profondità#
Se la tua videocamera non ha un sensore di profondità, puoi comunque calibrarla. La calibrazione adatta un'unica scala globale e ignora i pixel con profondità pari a 0, quindi bastano pochi punti misurati per immagine.
-
Raccogli le immagini. Scatta da 50 a 150 immagini con la videocamera alla risoluzione e con le impostazioni dell'obiettivo che userai in produzione e inseriscile in
dataset/images/val/. La calibrazione legge la suddivisioneval. -
Etichetta la profondità. Usa uno dei due metodi seguenti. Entrambi scrivono una mappa di profondità per ogni immagine in
dataset/depth/val/nel formato del dataset.
Misura la distanza da alcuni punti in ogni immagine con un distanziometro laser o un metro a nastro, su superfici piane e lontano dai bordi degli oggetti, e registra la posizione in pixel di ogni punto in points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
Poi scrivi le mappe di profondità, lasciando a 0 tutti i pixel non misurati. Ogni punto viene disegnato come un piccolo punto, così da non andare perso quando l'immagine viene ridimensionata a imgsz:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Un distanziometro misura la distanza in linea retta da un punto, mentre le mappe di profondità memorizzano la distanza lungo l'asse visivo della videocamera. Le due misure coincidono al centro dell'immagine e differiscono di circa il 3,5% a 15° dal centro; quindi misura punti vicini al centro oppure converti ogni lettura con meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) usando i parametri intrinseci della videocamera.
-
Scrivi il file YAML del dataset come
calib.yaml.depth_scale: 100legge le immagini PNG in centimetri dei punti misurati e viene ignorato per le mappe NPY:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Calibra e salva, poi carica
yolo26s-depth-calibrated.ptper eseguire predizioni o esportare:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
Nei test con yolo26s-depth.pt e 150 immagini per videocamera, la calibrazione rilasciata differiva dal fit della scala sulla ground truth completa dal 4% al 46% per NYU, KITTI e una videocamera con obiettivo a campo stretto. La calibrazione su 5 punti misurati per immagine si è discostata da quel fit di meno dell'1%, mentre quella sulle etichette DA3METRIC-LARGE si è discostata di meno del 7%. Aggiungere immagini è più utile che aggiungere punti per immagine: 150 immagini con 1 punto ciascuna si sono discostate di circa il 3%, mentre 20 immagini con 5 punti ciascuna hanno presentato variazioni fino al 9%.
Convalida#
Convalida l'accuratezza di un modello YOLO26n-depth addestrato su un dataset di stima della profondità. Passa esplicitamente data affinché la convalida usi il file YAML del dataset previsto. I pesi rilasciati sono addestrati a imgsz=768 su immagini deformate fino a diventare quadrate, anziché adattate con padding, quindi per ottenere la massima accuratezza convalida ed esegui predizioni a quella dimensione. La predizione, la convalida e model.calibrate() deformano l'input nello stesso modo.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-depth.pt")  # carica un modello ufficiale
model = YOLO("path/to/best.pt")  # carica un modello personalizzato

# Convalida il modello
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # frazione di pixel entro la soglia δ=1.25
metrics.abs_rel  # errore relativo assoluto medio
metrics.rmse  # radice dell'errore quadratico medio (metri)
metrics.silog # errore logaritmico invariante rispetto alla scalaPredici#
Usa un modello YOLO26n-depth addestrato per eseguire predizioni sulle immagini.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-depth.pt")  # carica un modello ufficiale
model = YOLO("path/to/best.pt")  # carica un modello personalizzato

# Esegui previsioni con il modello
results = model("https://ultralytics.com/images/bus.jpg")  # esegui una previsione su un’immagine

# Accedi ai risultati
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, forma (H, W), metri
Consulta la pagina Previsione per i dettagli completi sulla modalità predict.
Output dei risultati#
La stima della profondità YOLO restituisce un oggetto Results per immagine. Ogni risultato memorizza una mappa di profondità densa a virgola mobile per l'intera immagine.
| Attributo | Tipo | Forma | Descrizione |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Mappa di profondità densa per pixel. |
result.depth.data | torch.Tensor | (H,W) | Valori di profondità in metri; chiama .cpu().numpy() per NumPy. |
result.boxes | - | - | Nessun riquadro di istanza. |
result.masks | - | - | Nessuna maschera di istanza. |
Per consultare i campi Results specifici di ogni attività, visita la sezione Risultati delle previsioni per attività.
Profondità per oggetto con segmentazione delle istanze#
Combina la segmentazione delle istanze con la profondità per stimare quanto è lontano ciascun oggetto rilevato. Esegui entrambi i modelli sulla stessa immagine con retina_masks=True così le maschere condividono la risoluzione dell'immagine originale della mappa di profondità, quindi calcola la mediana dei pixel di profondità validi all'interno di ciascuna maschera.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
La mediana è robusta rispetto ai pixel dello sfondo ai bordi della maschera, ma descrive la superficie visibile dell'oggetto anziché il suo centro, e la sua accuratezza dipende dalla scala di profondità del modello (vedi Calibrazione della scala di profondità).
Colorare la mappa di profondità#
La mappa di profondità grezza è un array a virgola mobile a canale singolo, espresso in metri: utile per i calcoli, ma difficile da leggere direttamente. Per trasformarla in un'immagine a colori, usa l'helper colorize_depth in ultralytics.utils.plotting, che converte l'array di profondità (H, W) in un'immagine BGR (H, W, 3) uint8 (i pixel non validi <= 0 vengono visualizzati in nero).
result.plot() applica già questa colorazione all'immagine di input usando i valori predefiniti (cmap="jet", mode="disparity"); chiama direttamente colorize_depth quando vuoi un'immagine di profondità a colori autonoma o una mappa di colori o una normalizzazione diversa.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Colora con i valori vicini in tonalità calde e salva
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Fissa l'intervallo a 0-20 m affinché lo stesso colore indichi la stessa distanza tra i fotogrammi
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Sovrapposizione con fusione direttamente dall'oggetto Results (usa cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Ogni mappa di colori procede da tonalità fredde/scure a calde/luminose. mode stabilisce quale estremità rappresenta i valori vicini, mentre vmin/vmax fissano l'intervallo tra i fotogrammi, così ogni colore indica sempre la stessa distanza.
| Argomento | Valore | Descrizione |
|---|---|---|
cmap | jet (predefinito) | Elevato contrasto, dal blu al verde al rosso: la palette usata da result.plot(). |
cmap | inferno | Dal nero al viola, all'arancione, al giallo. Uniforme dal punto di vista percettivo, adatta a chi ha daltonismo e leggibile in scala di grigi. |
cmap | spectral | Dal rosso al giallo, al verde, al blu (Spectral_r di matplotlib). |
mode | disparity (predefinito) | Normalizza la profondità inversa (1/d) tra il 2º e il 98º percentile; le tonalità calde indicano i valori vicini e gli outlier lontani vengono assorbiti. |
mode | metric | Normalizza linearmente la profondità in metri tra vmin e vmax; le tonalità calde indicano i valori lontani, quindi i colori corrispondono alla distanza reale. |
Esporta#
Esporta un modello YOLO26n-depth in un altro formato, ad esempio ONNX, CoreML, ecc.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-depth.pt")  # carica un modello ufficiale
model = YOLO("path/to/best.pt")  # carica un modello personalizzato

# Esporta il modello
model.export(format="onnx")
I formati di esportazione disponibili per la stima della profondità YOLO26 sono elencati nella tabella seguente. Puoi esportare in qualsiasi formato usando l'argomento format, ad esempio format='onnx' o format='engine'. Puoi eseguire predizioni o validazioni direttamente sui modelli esportati, ad esempio yolo predict model=yolo26n-depth.onnx. Al termine dell'esportazione vengono mostrati esempi d'uso per il tuo modello.
| Formato | Argomento format | Modello | Metadati | Argomenti |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None restituisce per impostazione predefinita output grezzi per NMS esterno. Imposta nms=False per selezionare una head disponibile senza NMS; i formati non supportati utilizzano il proprio percorso di output nativo. Le voci nms qui sopra identificano i formati che possono integrare NMS con nms=True.
Consulta i dettagli completi di export nella pagina Esportazione.
Domande frequenti#
Prepara immagini RGB abbinate e mappe di profondità PNG a 16 bit oppure NPY a virgola mobile, espresse in metri; poi crea un YAML del dataset che punti alla tua directory
images/. Il caricatore individua automaticamente i file di profondità sostituendoimagescondepthnel percorso, dando la precedenza a.pnge ripiegando su.npy.Parti dai pesi preaddestrati e usa un tasso di apprendimento basso con AdamW, così il fine-tuning conserva ciò che il modello ha già appreso (per sapere perché, consulta Eseguire il fine-tuning sui tuoi dati):
Esempiofrom ultralytics import YOLO # Carica un modello di profondità YOLO26 preaddestrato model = YOLO("yolo26s-depth.pt") # Esegui il fine-tuning su un dataset di profondità personalizzato results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Consulta la pagina Configurazione per altri argomenti disponibili.
La validazione della stima della profondità riporta le metriche usate da Depth Anything e dai lavori correlati sulla profondità monoculare:
- delta1 / delta2 / delta3 — frazione di pixel in cui il rapporto tra la profondità prevista e quella di riferimento (o il suo inverso) è inferiore rispettivamente a 1.25, 1.25² e 1.25³. Più alto è meglio.
- abs_rel — errore relativo assoluto medio. Più basso è meglio.
- rmse — radice dell'errore quadratico medio in metri. Più basso è meglio.
- silog — errore logaritmico invariante rispetto alla scala. Più basso è meglio.
Per ogni immagine, ogni predizione viene allineata alla relativa profondità di riferimento tramite la mediana, ogni metrica viene calcolata e i risultati per immagine vengono mediati sull'intero set di validazione; così tutte le immagini hanno lo stesso peso, indipendentemente dal numero di pixel di profondità validi. Le immagini con meno di 10 pixel di profondità di riferimento validi vengono ignorate e non rientrano nella media, poiché allineare la mediana di una manciata di pixel non ha senso; le predizioni non finite ricevono invece il punteggio corrispondente ai limiti di profondità. Questo corrisponde alla media per campione e alla soglia minima di 10 pixel usate da Depth Anything V2.
La mappa di profondità è memorizzata come
torch.Tensorcon forma(H, W), dove ogni valore rappresenta la profondità prevista in metri (usaresult.depth.data.cpu().numpy()per ottenere un array NumPyfloat32). Accedivi tramiteresult.depth.datadopo aver eseguito la predizione. La mappa è allineata alla risoluzione dell'immagine di input.Ultralytics YOLO26 include configurazioni YAML integrate per diversi dataset di stima della profondità, tra cui NYU Depth V2, KITTI, Hypersim, SUN RGB-D e ARKitScenes. Consulta la Guida ai dataset per la stima della profondità per l'elenco completo e i dettagli sui formati.
Valida un modello YOLO26 preaddestrato per la stima della profondità specificando il YAML del dataset usato per la valutazione:
Esempiofrom ultralytics import YOLO # Carica un modello preaddestrato model = YOLO("yolo26n-depth.pt") # Convalida il modello metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Esporta un modello YOLO26 per la stima della profondità in ONNX con Python o CLI:
Esempiofrom ultralytics import YOLO # Carica un modello preaddestrato model = YOLO("yolo26n-depth.pt") # Esporta il modello in formato ONNX model.export(format="onnx")Per maggiori dettagli sull'esportazione in vari formati, consulta la pagina Esportazione.