IBM WatsonxでYOLO26モデルをトレーニングするステップバイステップガイド
スケーラブルなコンピュータービジョンソリューションには、データ、トレーニング、デプロイを支えるインフラストラクチャが必要です。IBM Watsonxは、AIモデルの開発、デプロイ、管理を支援するAIおよびデータプラットフォームです。AIのライフサイクル全体を網羅し、IBM Cloudサービスと連携します。
Ultralytics YOLO26モデルはIBM Watsonxでトレーニングできます。効率的なモデルのトレーニング、特定タスク向けのファインチューニング、堅牢なツールと使いやすいセットアップによるモデルのパフォーマンス改善を目指す企業に適しています。このガイドでは、環境のセットアップからトレーニング済みモデルの評価まで、IBM Watsonxを使ってYOLO26をトレーニングする手順を説明します。
IBM Watsonxとは何ですか?#
Watsonxは、商用の生成AIと科学データを対象としたIBMのクラウドベースプラットフォームです。IBM Watsonxの3つのコンポーネントであるwatsonx.ai、watsonx.data、watsonx.governanceが連携し、ビジネス課題の解決を目指すAIプロジェクトを加速できる、エンドツーエンドで信頼性の高いAIプラットフォームを構成します。機械学習モデルの構築、トレーニング、デプロイに役立つツールを提供し、さまざまなデータソースに簡単に接続できます。
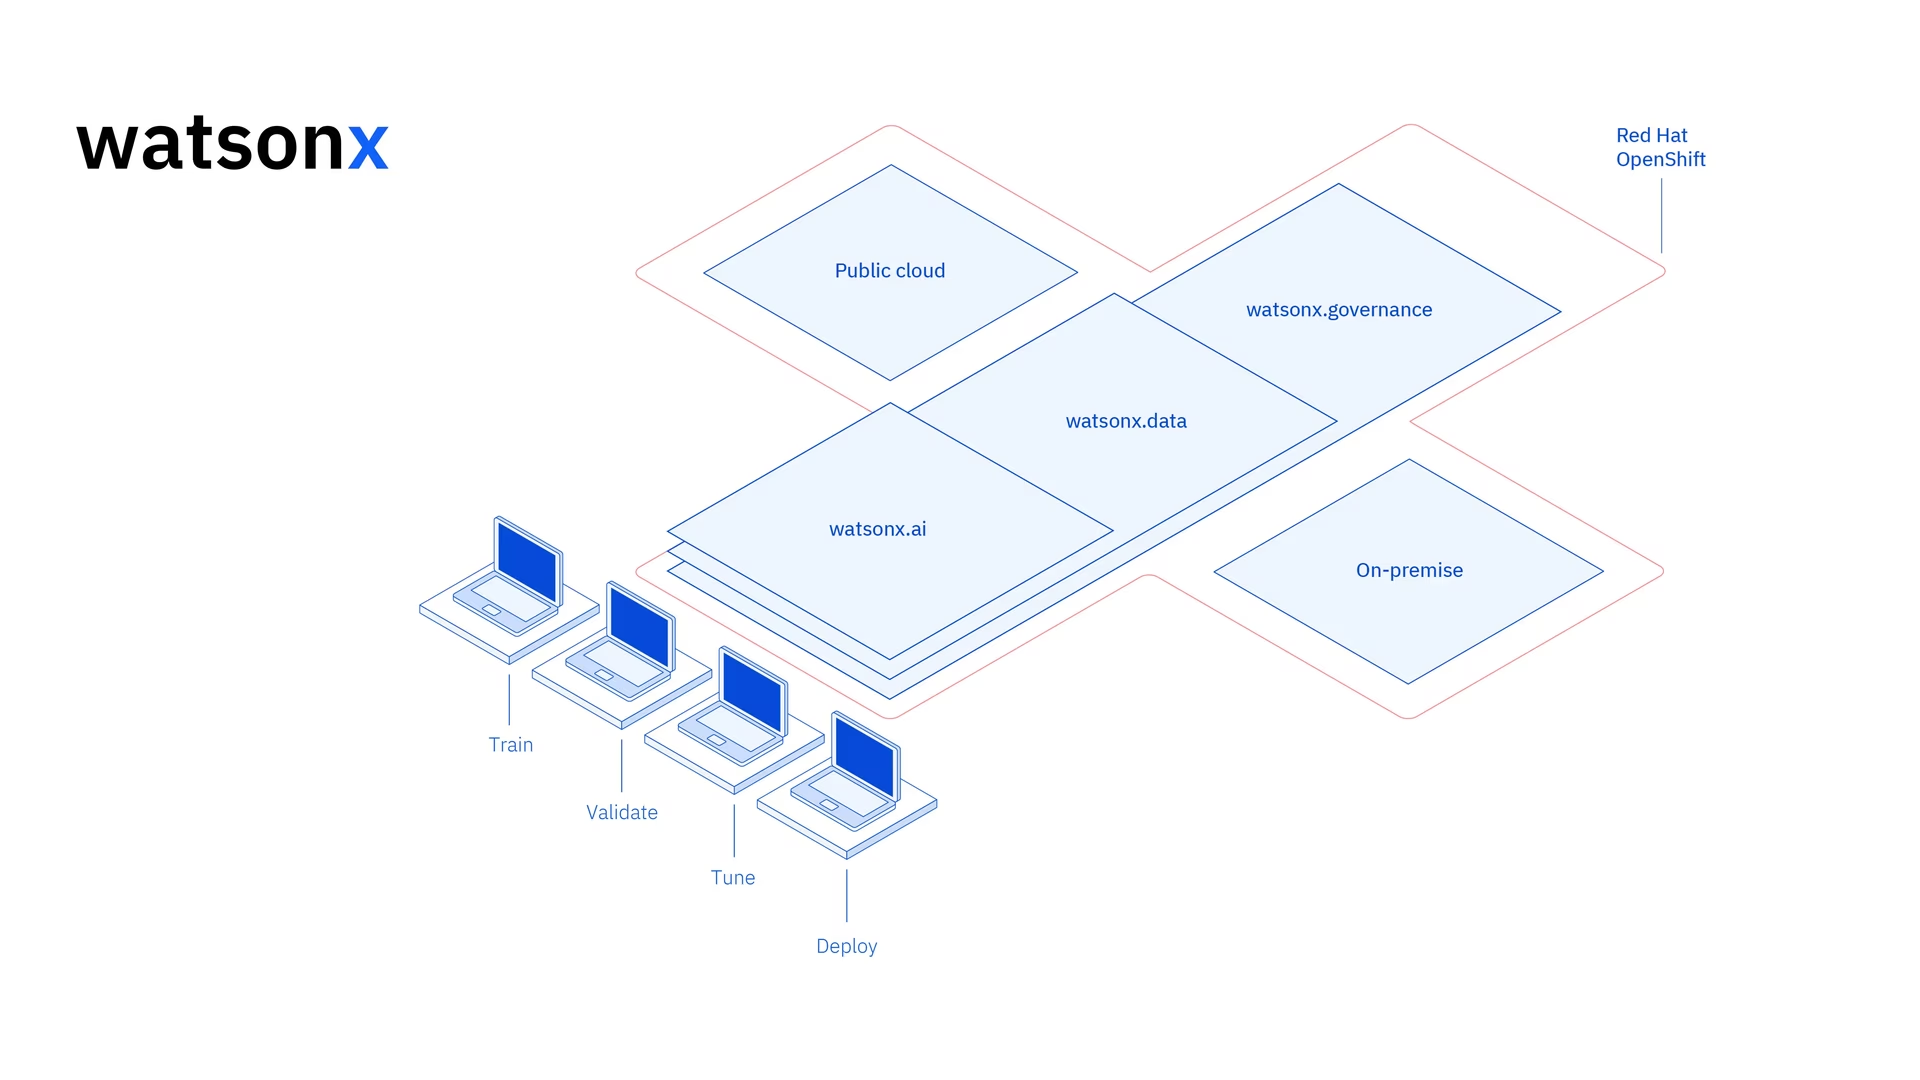
そのインターフェースとコラボレーション機能は、モデルの開発、管理、デプロイを支援します。IBM Watsonxは、コンピュータービジョン、予測分析、自然言語処理など、さまざまなAIアプリケーションに利用できます。
IBM Watsonxの主な機能#
IBM Watsonxは、watsonx.ai、watsonx.data、watsonx.governanceの3つの主要コンポーネントで構成されています。各コンポーネントは、AIとデータ管理の異なる側面をカバーします。
Watsonx.ai#
Watsonx.aiはAI開発ツールを提供し、IBMがサポートするカスタムモデル、Llama 3などのサードパーティモデル、IBM独自のGraniteモデルを利用できます。AIプロンプトを試すためのPrompt Labと、ラベル付きデータを使用してモデルの性能を向上させるTuning Studioが含まれています。また、AIモデルのライフサイクルを自動化し、さまざまなAPIやライブラリに接続するための包括的なツールも提供します。
Watsonx.data#
Watsonx.dataは、クラウドとオンプレミスの両方のデプロイに対応しています。使いやすいコンソールから環境全体のデータに一元的にアクセスでき、一般的なSQLで簡単にデータを探索できます。PrestoやSparkなどの効率的なクエリエンジンでワークロードを最適化し、AIを活用したセマンティックレイヤーでデータの分析を加速します。また、AIの関連性を高めるベクトルデータベースを備え、分析データやAIデータを簡単に共有できるオープンデータ形式に対応しています。
Watsonx.governance#
Watsonx.governanceは、規制の変更を自動的に特定してポリシーを適用することで、コンプライアンス対応を容易にします。要件を社内のリスクデータに関連付け、最新のAIファクトシートを提供します。このプラットフォームは、アラートやバイアスとドリフトなどの問題を検出するツールを使って、リスク管理を支援します。また、AIライフサイクルのモニタリングと文書化を自動化し、モデルインベントリでAI開発を整理し、使いやすいダッシュボードとレポートツールでコラボレーションを強化します。
IBM Watsonxを使用してYOLO26をトレーニングする方法#
IBM Watsonxを使用して、YOLO26モデルのトレーニングワークフローを加速できます。
前提条件#
watsonx.aiプロジェクトを作成するにはIBM Cloudアカウントが必要です。また、データセットを読み込むにはKaggleアカウントも必要です。
ステップ1: 環境をセットアップする#
まず、Jupyter Notebookを使用するためにIBMアカウントをセットアップする必要があります。IBM Cloudアカウントを使用してwatsonx.aiにログインしてください。
次に、watsonx.aiプロジェクトとJupyter Notebookを作成します。
これを行うと、データセットを読み込むためのノートブック環境が開きます。このチュートリアルのコードを使用して、シンプルな物体検出モデルをトレーニングできます。
ステップ2: 関連ライブラリをインストールしてインポートする#
次に、必要なPythonライブラリをインストールしてインポートします。
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headlessインストール手順の詳細とベストプラクティスについては、Ultralyticsのインストールガイドをご覧ください。YOLO26に必要なパッケージのインストールで問題が発生した場合は、解決策とヒントが記載されたよくある問題のガイドをご確認ください。
続いて、必要なパッケージをインポートします。
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
ステップ3: データを読み込む#
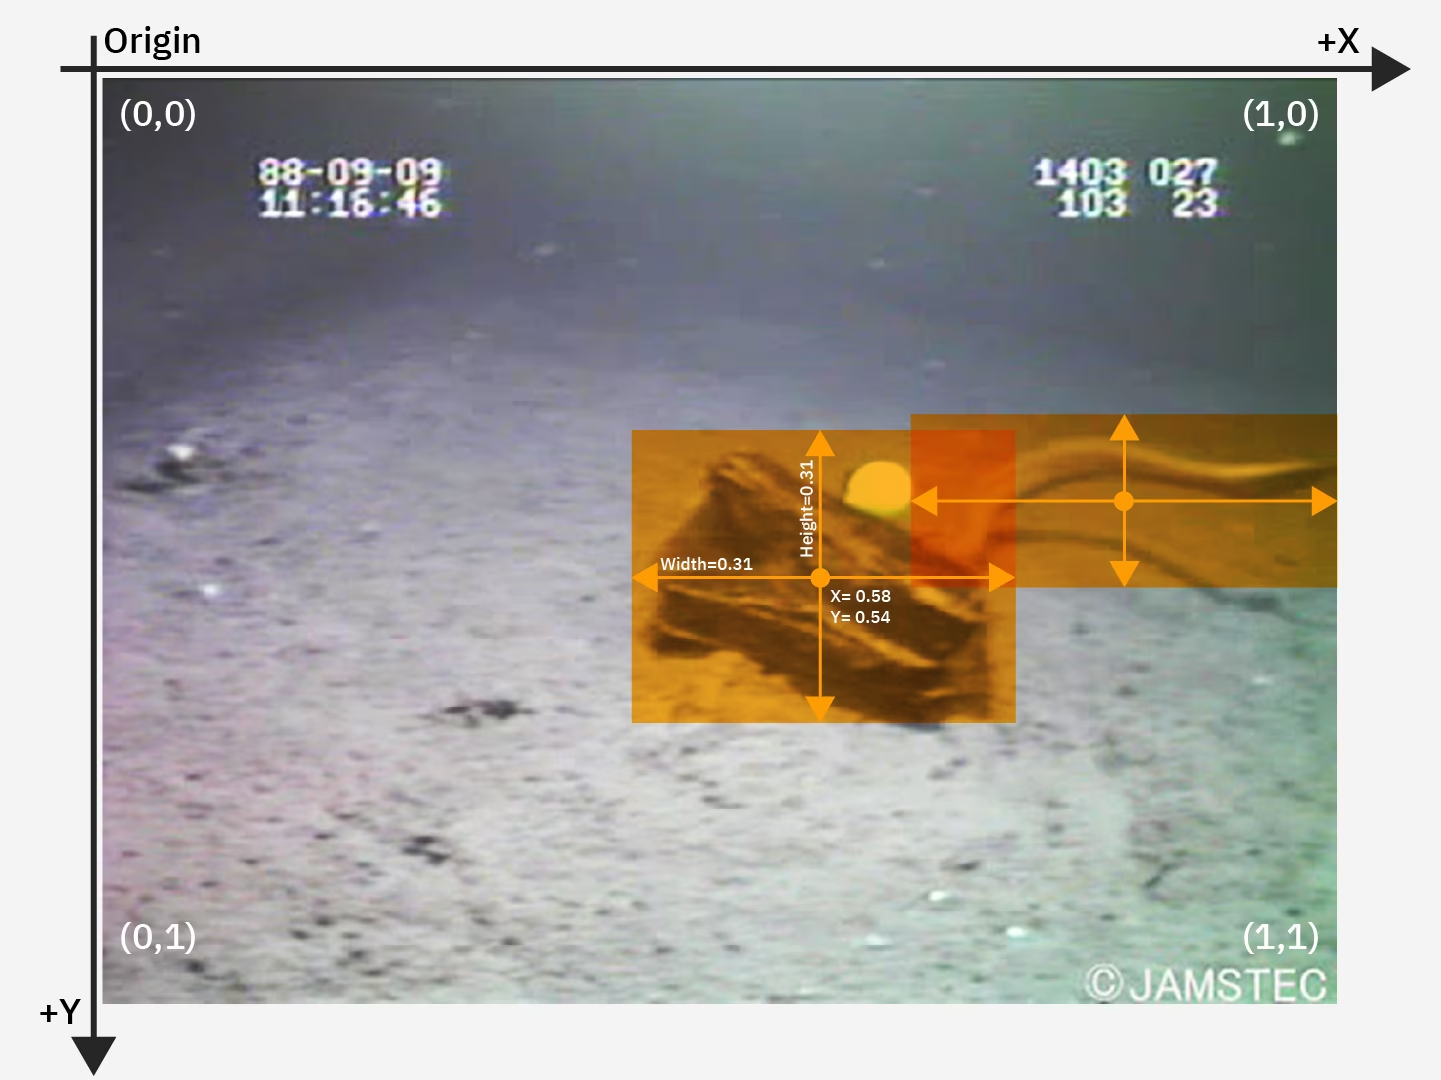
このチュートリアルでは、Kaggleで公開されている海洋ごみデータセット(Ultralytics PlatformのTrash-ICRA19としても利用可能)を使用します。このデータセットを使ってYOLO26モデルをカスタムトレーニングし、水中画像のごみや生物を検出・分類します。
Kaggle APIを使って、データセットをノートブックに直接読み込めます。まず、無料のKaggleアカウントを作成してください。アカウントを作成したら、APIキーを生成します。キーの生成方法は、Kaggle APIドキュメントの「API credentials」セクションに記載されています。
次のコードにKaggleのユーザー名とAPIキーをコピーして貼り付けてください。その後、コードを実行してAPIをインストールし、Watsonxにデータセットを読み込みます。
# Install kaggle
pip install kaggle
Kaggleをインストールしたら、データセットをWatsonxに読み込めます。
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
データセットを読み込んだ後、作業ディレクトリを表示して保存しました。また、"trash_ICRA19"データセットが正しく読み込まれたことを確認するため、作業ディレクトリの内容も表示しました。
ディレクトリの内容に「trash_ICRA19」があれば、正常に読み込まれています。config.yamlファイル、videos_for_testingディレクトリ、datasetディレクトリの3つが表示されます。videos_for_testingディレクトリは使用しないため、削除してかまいません。
config.yamlファイルとデータセットディレクトリの内容を使用して、物体検出モデルをトレーニングします。以下は、海洋ごみデータセットのサンプル画像です。
ステップ4: データを前処理する#
海洋ごみデータセットのラベルは、すべてすでにYOLO .txtファイル形式になっています。ただし、モデルが画像とラベルを見つけられるよう、画像ディレクトリとラベルディレクトリを再配置する必要があります。現在、読み込んだデータセットディレクトリは次の構造になっています。
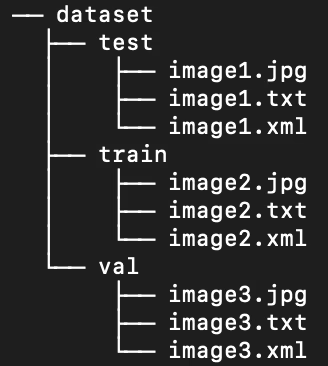
デフォルトでは、YOLOモデルは各train/val/test分割内に個別のimagesサブディレクトリとlabelsサブディレクトリを必要とします。ディレクトリを次の構造に再編成する必要があります。
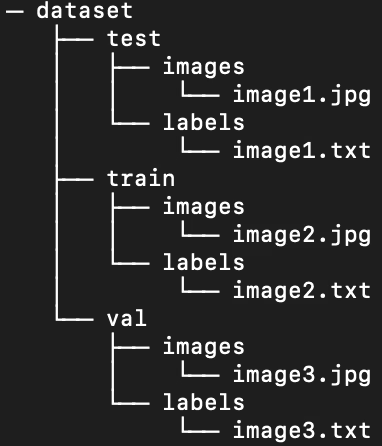
データセットディレクトリを再編成するには、次のスクリプトを実行します。
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
organize_files(directory)次に、データセットYAMLファイルを変更する必要があります。.yamlファイルでは、次の設定を使用します。クラスID番号は0から始まります。
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
2: rov次のスクリプトを実行して、現在のconfig.yamlの内容を削除し、新しいデータセットディレクトリ構造を反映した設定に置き換えます。スクリプトは先ほど定義したwork_dir変数を自動的に使用するため、実行前にデータセットを指していることを確認してください。また、train、val、testサブディレクトリの定義は変更しないでください。
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
ステップ5: YOLO26モデルをトレーニングする#
次のコマンドを実行して、事前学習済みのYOLO26nモデルをファインチューニングします。
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=Trueモデルのトレーニングコマンドで使用するパラメーターを詳しく見てみましょう。
- detect: 指定したYOLOモデルとデータセットで実行するコンピュータービジョンタスクです。
- train: 指定したモデルとデータを読み込む目的を表すモードです。後でモデルのパフォーマンスをテストするときは、
predictを使用します。 - epochs: YOLO26がデータセット全体を処理する回数です。
- batch: トレーニングのバッチサイズです。モデルがパラメーターを更新する前に処理する画像の数を表します。
- plots: YOLOに、モデルのトレーニングおよび評価メトリクスのプロットを生成して保存するよう指示します。
モデルのトレーニングプロセスとベストプラクティスを詳しく理解するには、YOLO26モデルのトレーニングガイドを参照してください。このガイドは、実験から最大限の成果を得て、YOLO26を効果的に活用するのに役立ちます。
ステップ6: モデルをテストする#
ファインチューニングしたモデルのパフォーマンスをテストするため、推論を実行できます。
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=Trueこのコマンドは、テストセット内の各画像について予測ラベルを生成するとともに、元の画像に予測されたバウンディングボックスを重ねた新しい出力画像ファイルを生成します。
各画像の予測された.txtラベルはsave_txt=True引数を使用して保存され、バウンディングボックスを重ねた出力画像はsave=True引数を通じて生成されます。 conf=0.5パラメーターは、信頼度が50%未満の予測をすべて無視するようモデルに指示します。
最後に、iou=.5は非最大抑制(NMS)のしきい値を設定します。同じクラスのボックスが、スコアの高いボックスと50%を超えて重なる場合、そのボックスは破棄されます。これにより、同じ物体に対して生成される重複ボックスを減らせます。 予測されたバウンディングボックスを重ねた画像を読み込み、いくつかの画像でモデルの性能を確認できます。
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
上記のコードは、テストセットから10枚の画像を表示し、予測されたバウンディングボックス、クラス名ラベル、信頼度を併せて示します。
ステップ7: モデルを評価する#
各クラスのモデルの適合率と再現率を可視化できます。これらの可視化結果は、トレーニング実行ディレクトリ({work_dir}/runs/detect/train/)に保存されます。適合率スコアはBoxP_curve.pngに表示されます。
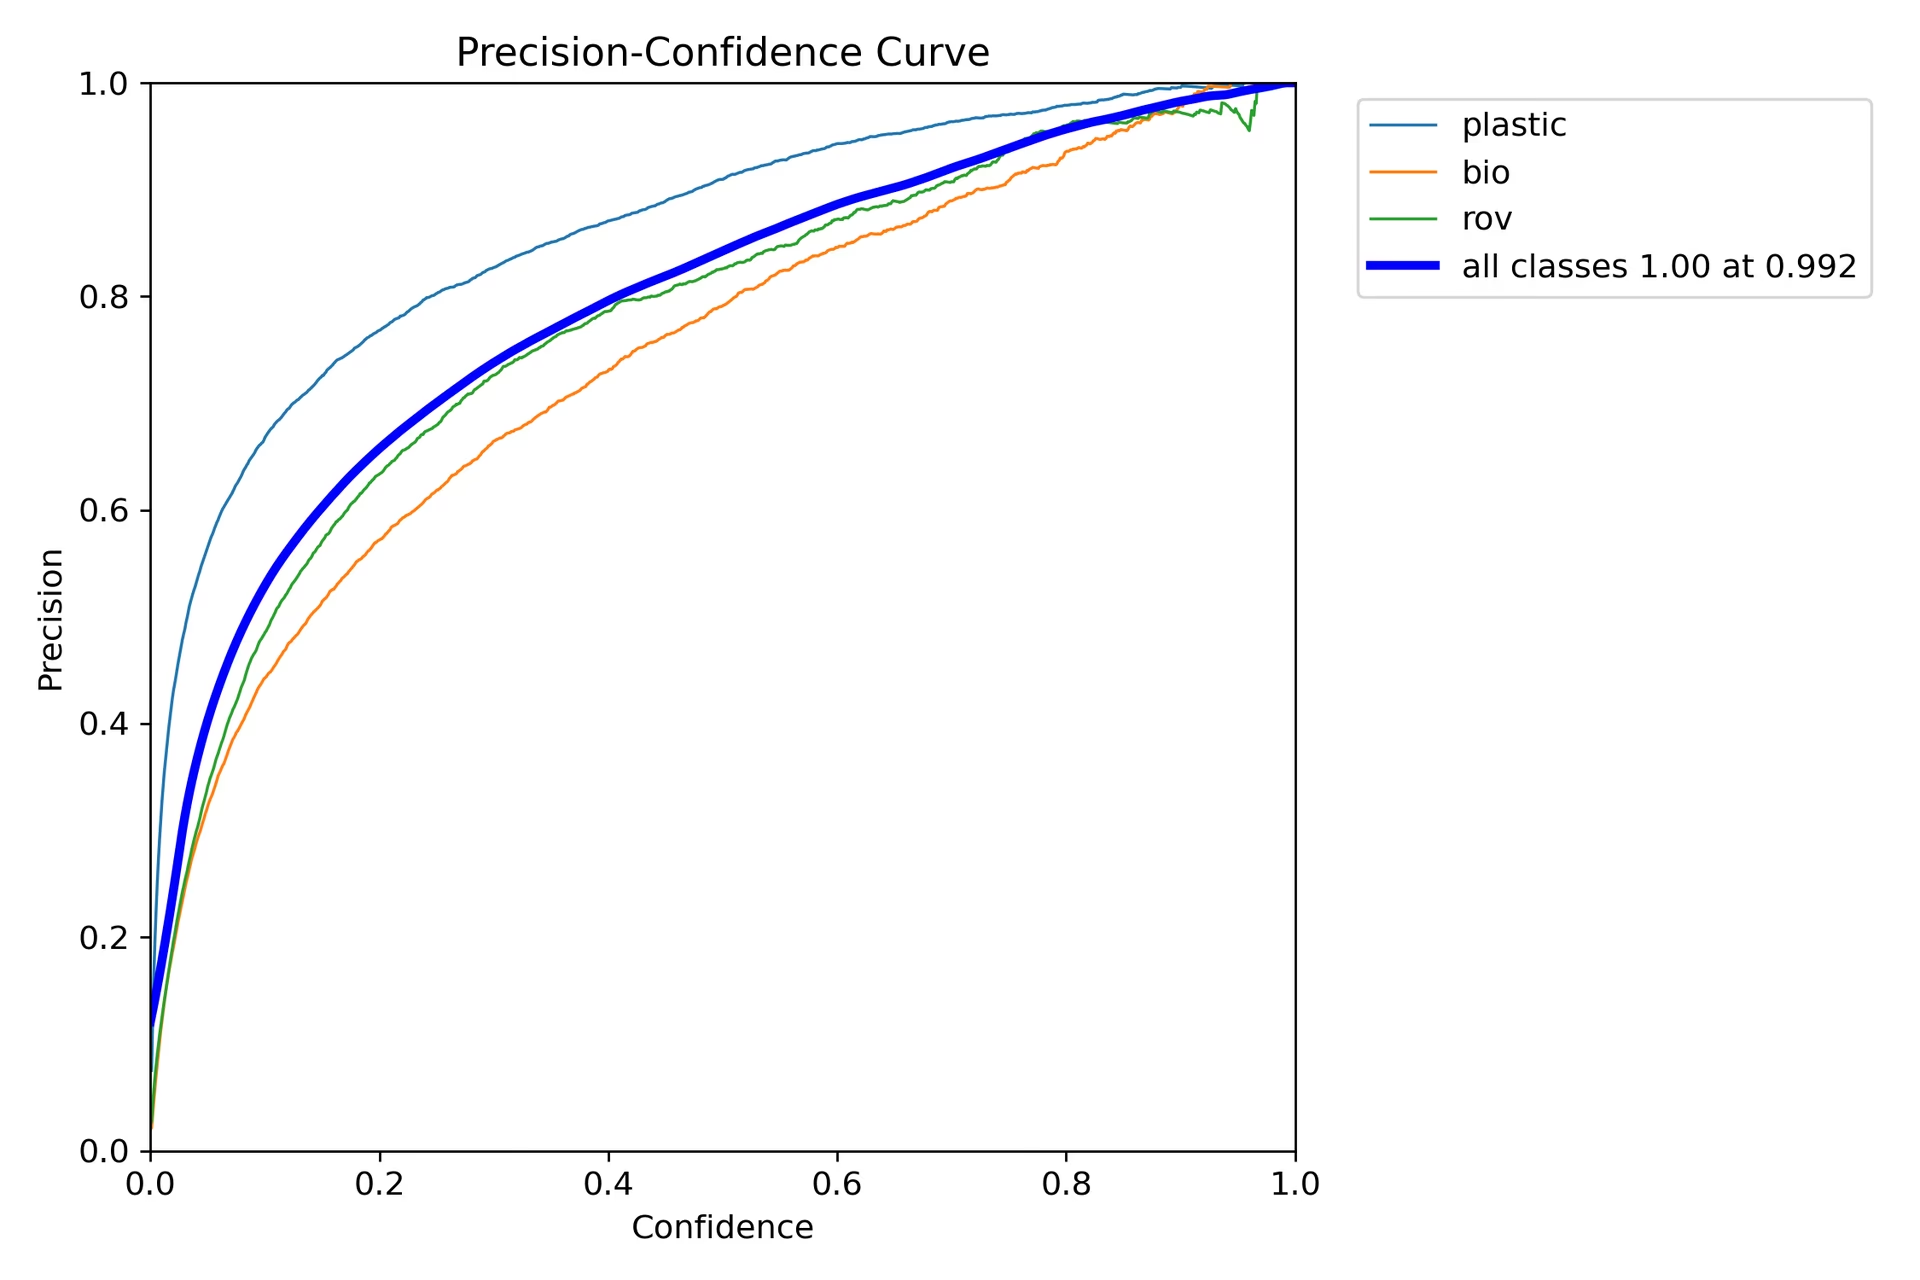
グラフは、予測の信頼度しきい値が上がるにつれて適合率が上昇することを示しています。ただし、エポックを2回実行した後も、モデルの適合率は特定の信頼度でまだ安定していません。
再現率のグラフ(BoxR_curve.png)は、逆の傾向を示しています。
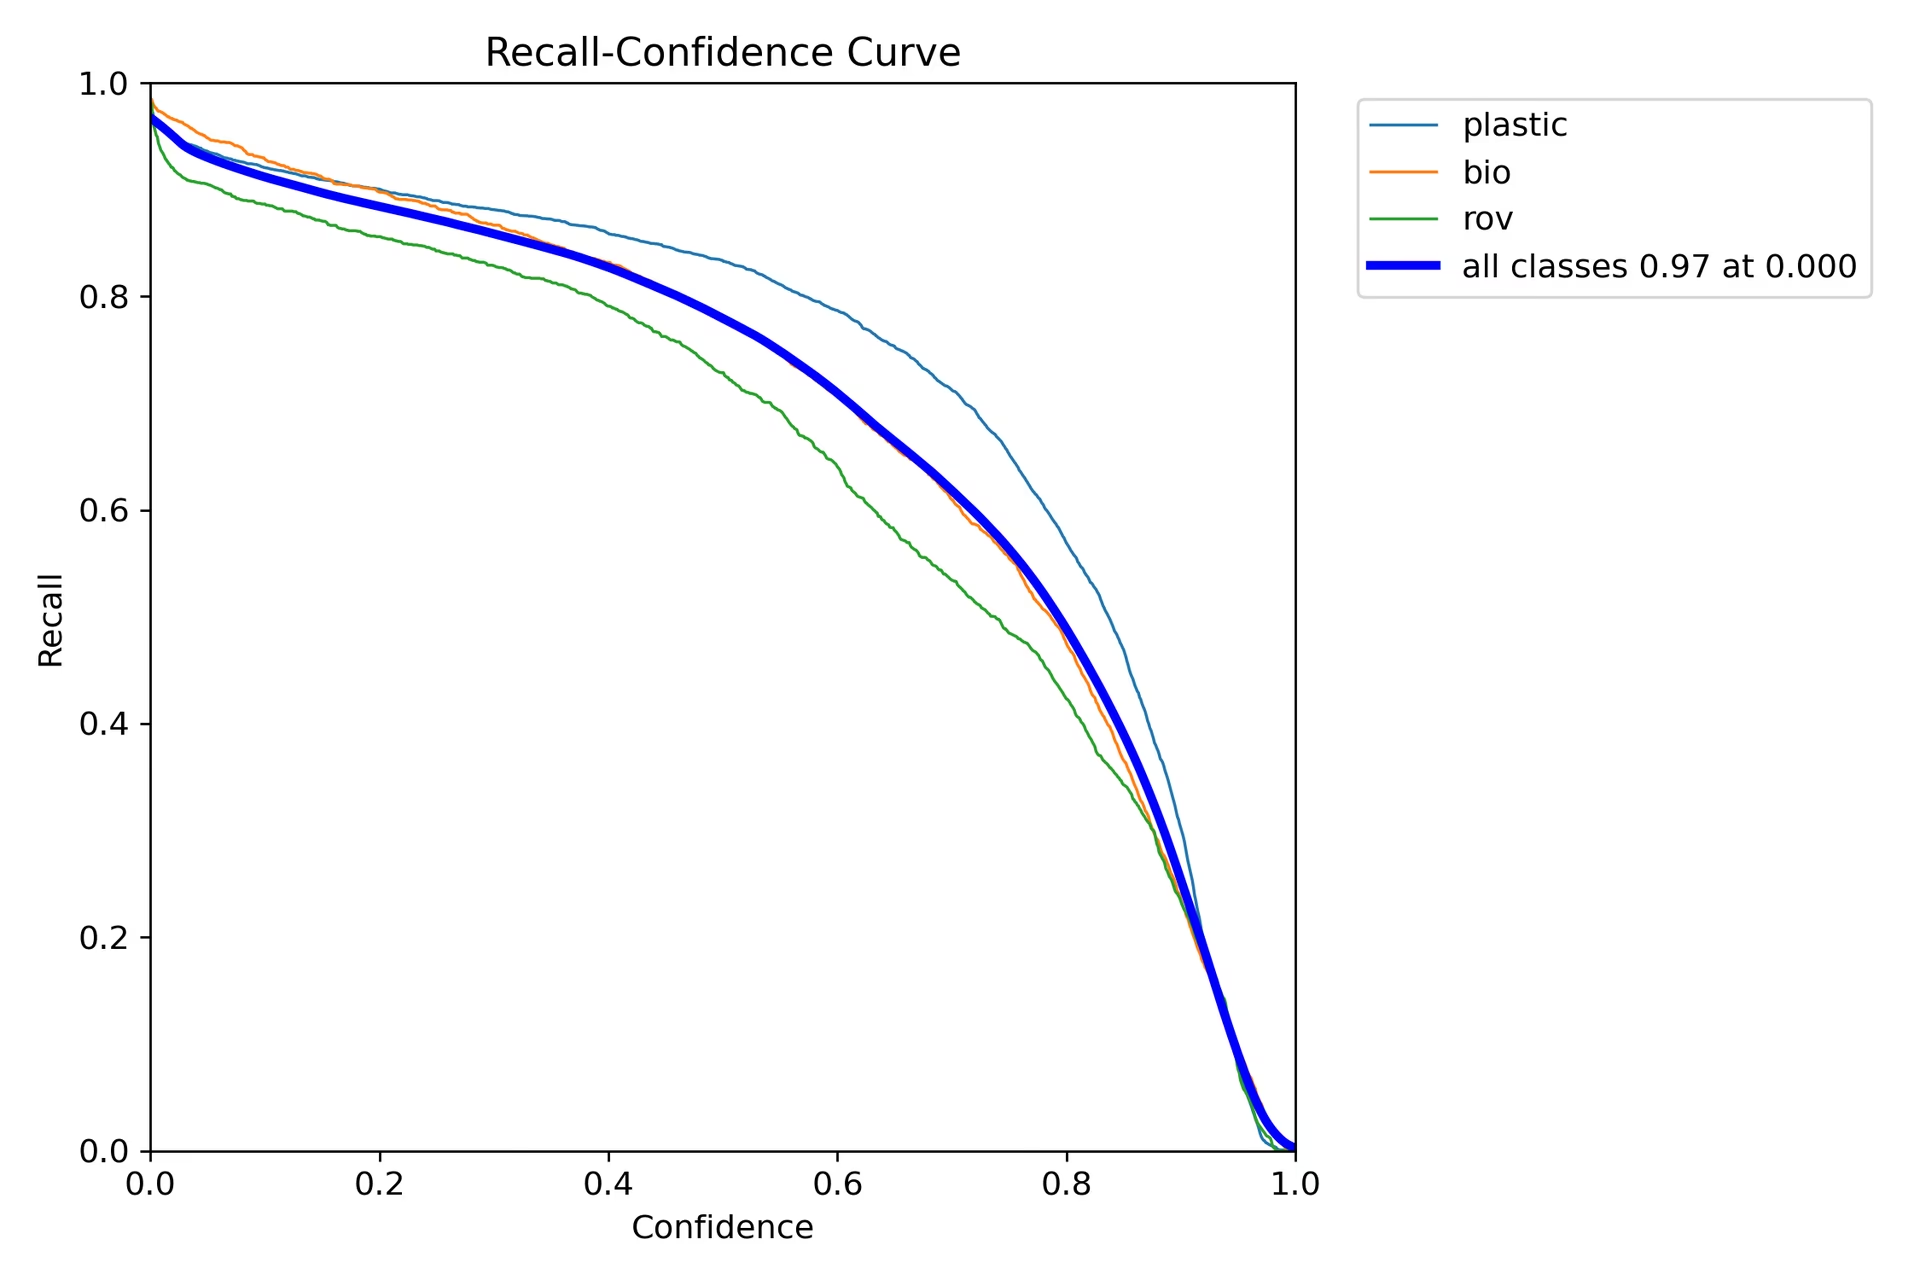
適合率とは異なり、再現率は信頼度しきい値が低いときに最も高く、しきい値が上がるにつれて低下します。これは、適合率と再現率のトレードオフを示しています。
ステップ8: Intersection Over Unionの計算#
同じ物体に対する予測バウンディングボックスと正解バウンディングボックスのIntersection over Union(IoU)を計算することで、位置特定の精度を測定できます。
概要#
IBM Watsonxの主な機能と、IBM Watsonxを使ってYOLO26モデルをトレーニングする方法を紹介しました。IBM Watsonxは、モデル構築、データ管理、コンプライアンスのためのツールも提供しています。
使用方法の詳細については、IBM Watsonxの公式ドキュメントをご覧ください。
よくある質問#
IBM Watsonxを使用してYOLO26モデルをトレーニングするには、次の手順に従ってください。
- 環境をセットアップする: IBM Cloudアカウントを作成し、Watsonx.aiプロジェクトをセットアップします。コーディング環境としてJupyter Notebookを使用します。
- ライブラリをインストールする:
torch、opencv、ultralyticsなど、必要なライブラリをインストールします。 - データを読み込む: Kaggle APIを使用して、データセットをWatsonxに読み込みます。
- データを前処理する: データセットを必要なディレクトリー構成に整理し、
.yaml設定ファイルを更新します。 - モデルをトレーニングする: YOLOのコマンドラインインターフェースを使用し、
epochsやbatchなどのパラメーターを指定してモデルをトレーニングします。 - テストと評価を行う: 推論を実行してモデルをテストし、適合率や再現率などのメトリクスを使用してパフォーマンスを評価します。
詳しい手順については、YOLO26モデルのトレーニングガイドを参照してください。
IBM Watsonxは、AIモデルのトレーニングに役立つ次のような主要機能を提供します。
- Watsonx.ai:IBMがサポートするカスタムモデルやLlama 3などのサードパーティモデルを含む、AI開発ツールを提供します。包括的なAIライフサイクル管理のためのPrompt LabとTuning Studioを備えています。
- Watsonx.data: クラウド環境とオンプレミス環境へのデプロイをサポートし、データへの一元的なアクセス、PrestoやSparkなどの効率的なクエリエンジン、AIを活用したセマンティックレイヤーを提供します。
- Watsonx.governance: コンプライアンスを自動化し、アラートでリスクを管理するとともに、バイアスやドリフトなどの問題を検出するツールを提供します。また、コラボレーション用のダッシュボードやレポートツールも含まれています。
詳しくは、IBM Watsonxの公式ドキュメントをご覧ください。
IBM Watsonxは、AIライフサイクル全体をカバーするツールを備えているため、Ultralytics YOLO26のトレーニングに適しています。主なメリットは次のとおりです。
- スケーラビリティ: IBM Cloudサービスを使って、モデルのトレーニングを簡単にスケールできます。
- 統合: さまざまなデータソースやAPIに接続できます。
- 使いやすいインターフェース: コラボレーションに適した直感的なインターフェースにより、開発プロセスを簡素化します。
- 高度なツール:Prompt LabやTuning Studioなどのツールを利用して、モデルの性能を向上させます。
IBM WatsonxでYOLO26をトレーニングするためにデータセットを前処理するには、次の手順に従います。
- ディレクトリーを整理する: データセットがYOLOのディレクトリー構造に従い、train/val/testの各分割内で画像とラベルが別々のサブディレクトリーに格納されていることを確認します。
- .yamlファイルを更新する:
.yaml設定ファイルを変更し、新しいディレクトリー構造とクラス名を反映します。 - 前処理スクリプトを実行する: Pythonスクリプトを使用してデータセットを再編成し、それに応じて
.yamlファイルを更新します。
データセットを整理するスクリプトの例を以下に示します。
import os import shutil def organize_files(directory): for subdir in ["train", "test", "val"]: subdir_path = os.path.join(directory, subdir) if not os.path.exists(subdir_path): continue images_dir = os.path.join(subdir_path, "images") labels_dir = os.path.join(subdir_path, "labels") os.makedirs(images_dir, exist_ok=True) os.makedirs(labels_dir, exist_ok=True) for filename in os.listdir(subdir_path): if filename.endswith(".txt"): shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename)) elif filename.endswith((".jpg", ".png", ".jpeg")): shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename)) if __name__ == "__main__": directory = f"{work_dir}/trash_ICRA19/dataset" organize_files(directory)詳しくは、データ前処理ガイドを参照してください。
IBM WatsonxでYOLO26モデルのトレーニングを始める前に、次の前提条件を満たしていることを確認してください。
- IBM Cloudアカウント: Watsonx.aiにアクセスするため、IBM Cloudのアカウントを作成します。
- Kaggleアカウント: データセットを読み込むには、KaggleアカウントとAPIキーが必要です。
- Jupyter Notebook: コーディングとモデルのトレーニングに使用するJupyter Notebook環境をWatsonx.ai内にセットアップします。
環境のセットアップについて詳しくは、Ultralyticsインストールガイドをご覧ください。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。