Paperspace GradientでYOLO26モデルのトレーニングを簡単に#
YOLO26のようなコンピュータービジョンモデルのトレーニングは複雑になることがあります。大規模なデータセットの管理、GPU、TPU、CPUなどさまざまな種類のコンピューターハードウェアの使用、トレーニング中のデータフローの円滑化が必要です。通常、開発者はコンピューターシステムや環境の管理に多くの時間を費やすことになります。最高のモデルを開発することに集中したいだけなのに、こうした作業に悩まされることがあります。
Paperspace Gradientのようなプラットフォームを利用すれば、作業を簡素化できます。Paperspace Gradientは、機械学習モデルの構築、トレーニング、デプロイを1か所で行えるMLOpsプラットフォームです。Gradientを使えば、開発者はインフラストラクチャや環境の管理に煩わされることなく、YOLO26モデルのトレーニングに集中できます。
Paperspace#
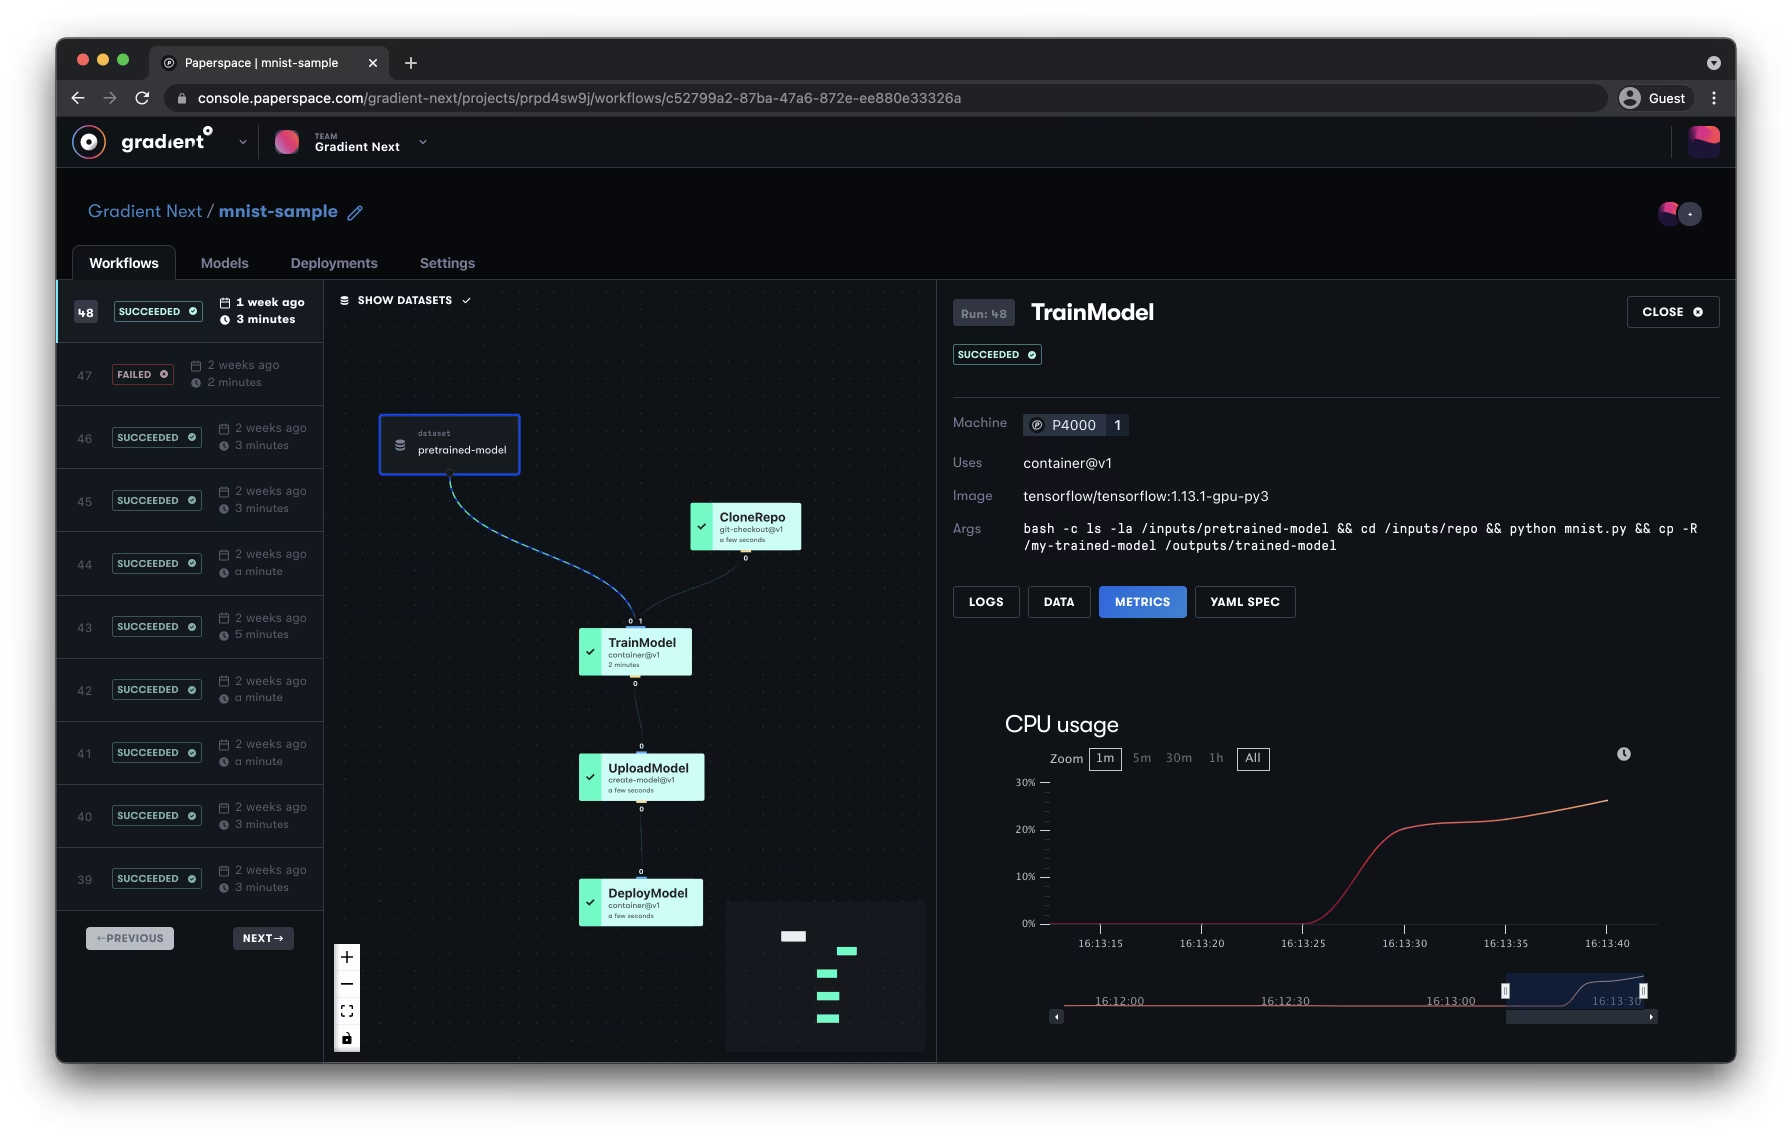
Paperspaceは、ミシガン大学の卒業生によって2014年に創業され、2023年にDigitalOceanに買収された、機械学習に特化したクラウドプラットフォームです。高性能GPU、共同作業に対応したJupyterノートブック、デプロイ用のコンテナサービス、機械学習タスク向けの自動ワークフロー、高性能な仮想マシンをユーザーに提供します。これらの機能により、コーディングからデプロイまで、機械学習開発の全プロセスを効率化できます。
Paperspace Gradient#
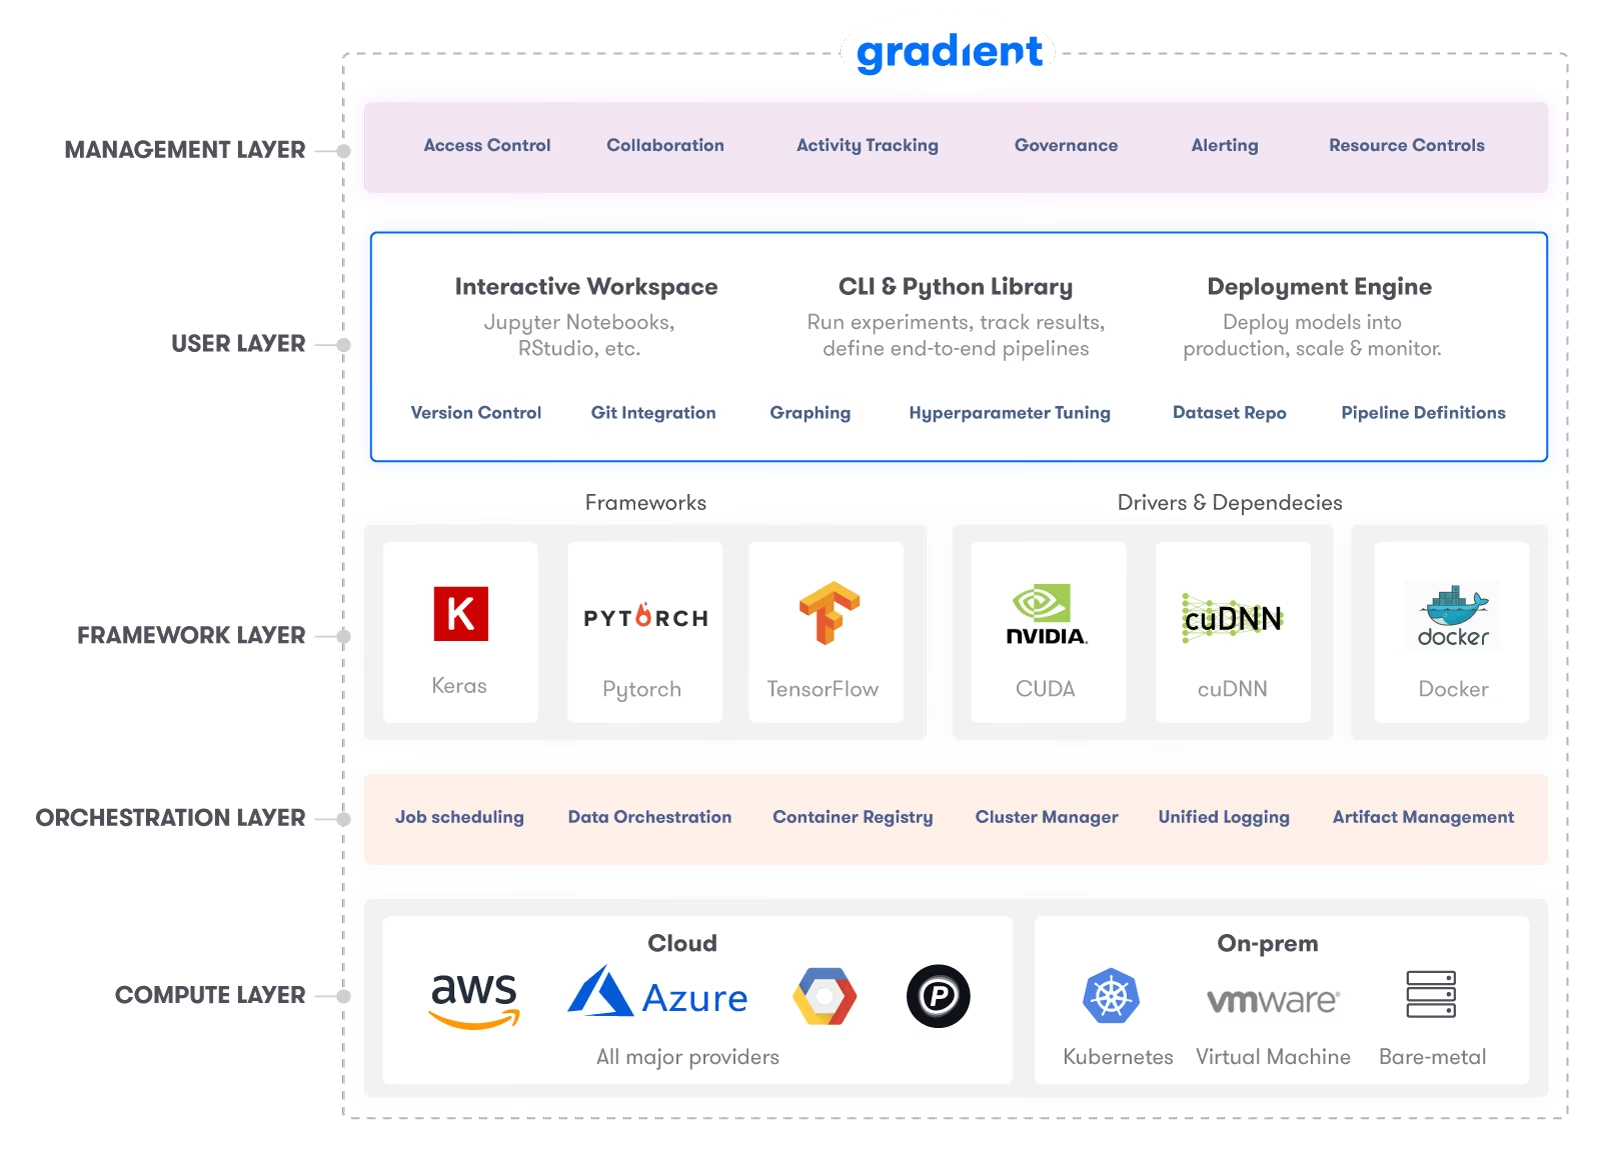
Paperspace Gradientは、クラウドでのAIや機械学習の作業を大幅に高速化し、簡素化するツールスイートです。Gradientは、モデルの構築やトレーニングからデプロイまで、機械学習のライフサイクル全体をサポートします。
ツールキットには、ジョブランナーを介したGoogleのTPUのサポート、Jupyterノートブックとコンテナの包括的なサポート、新しいプログラミング言語との統合が含まれています。特に言語統合に重点を置いているため、ユーザーは既存のPythonプロジェクトを容易に適応させ、利用可能な最先端のGPUインフラストラクチャを活用できます。
Paperspace Gradientを使用したYOLO26のトレーニング#
Paperspace Gradientを使えば、数回のクリックでYOLO26モデルをトレーニングできます。この統合により、Paperspaceコンソールにアクセスして、すぐにモデルのトレーニングを開始できます。モデルのトレーニングプロセスとベストプラクティスの詳細については、YOLO26モデルのトレーニングガイドをご覧ください。
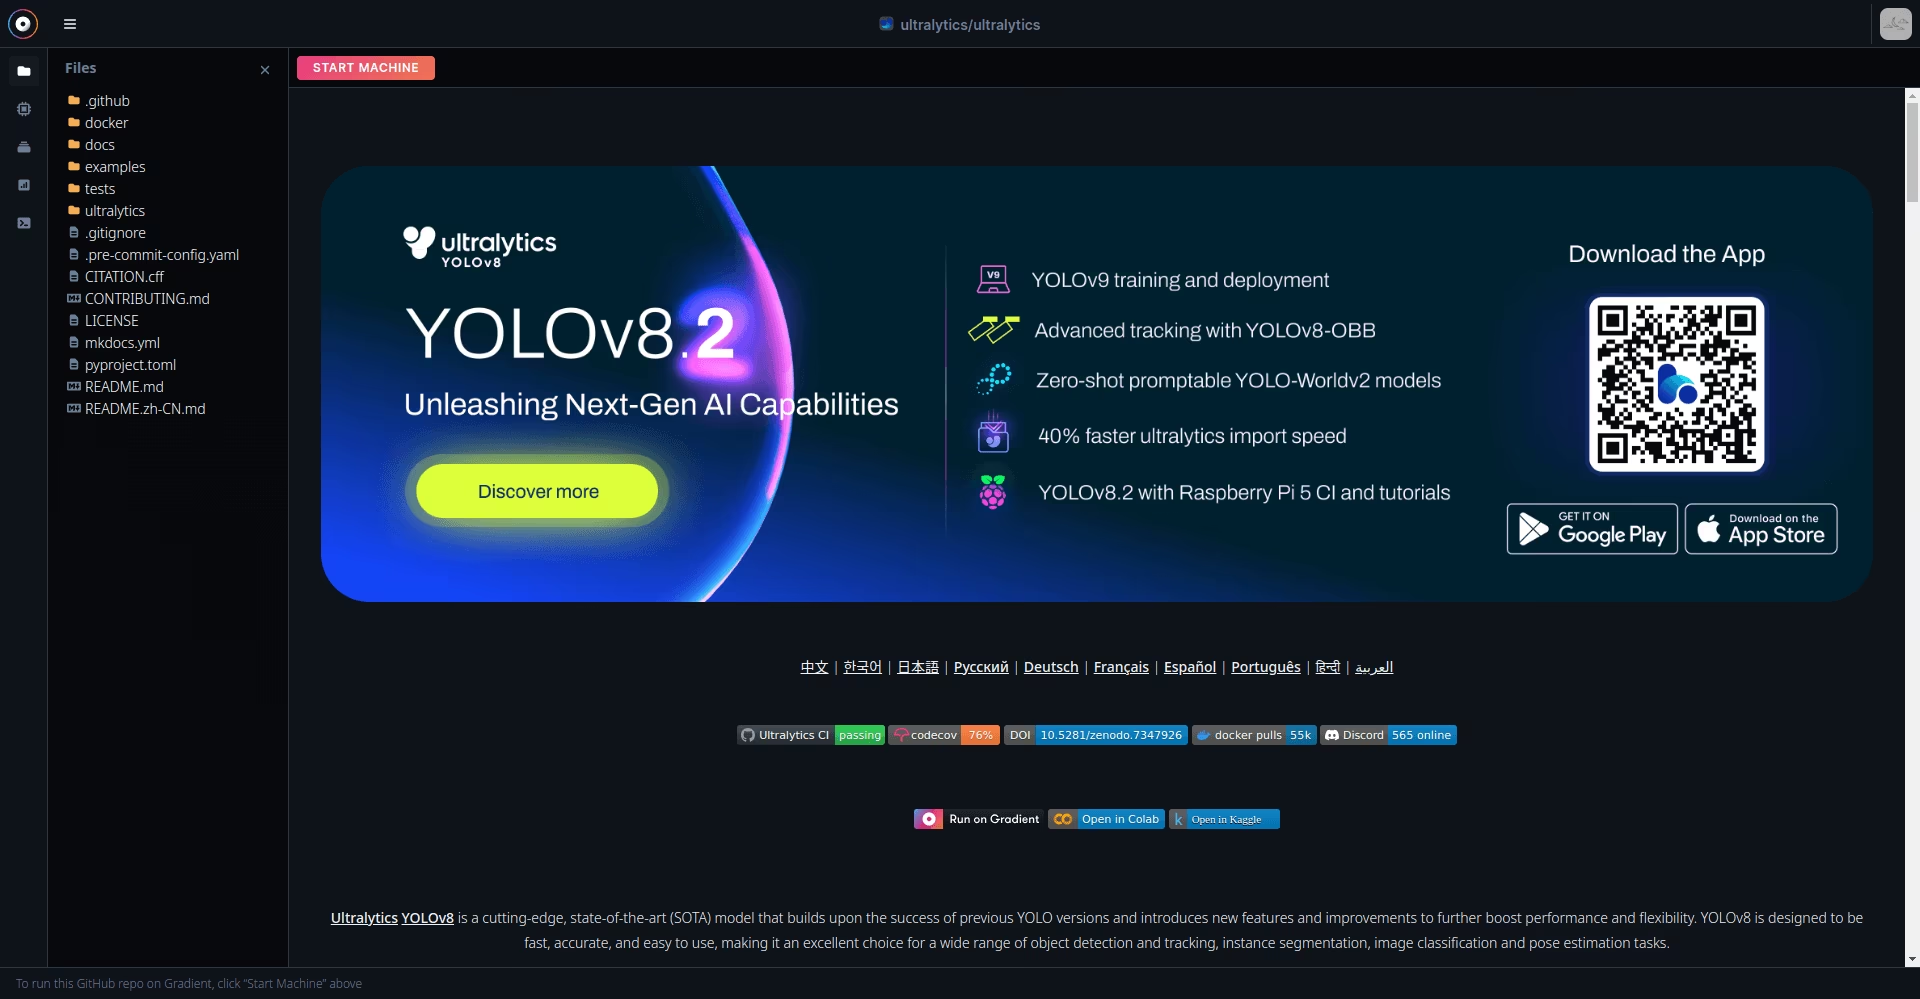
サインインし、以下の画像に示されている「Start Machine」ボタンをクリックします。数秒後に管理対象のGPU環境が起動し、ノートブックのセルを実行できるようになります。
Ultralyticsの創設者であるGlenn Jocherと、PaperspaceのJames Skeltonによるディスカッションで、YOLO26とPaperspace Gradientの機能をさらにご紹介します。以下のディスカッションをご覧ください。
視聴: Ultralyticsライブセッション7:すべては環境次第:勾配を用いたYOLO26トレーニングの最適化
Paperspace Gradientの主な機能#
Paperspaceコンソールを確認すると、機械学習ワークフローの各ステップがどのようにサポートされ、強化されるかがわかります。注目すべき機能をいくつかご紹介します。
-
ワンクリックノートブック: Gradientは、YOLO26に特化して事前設定されたJupyterノートブックを提供するため、環境のセットアップや依存関係の管理が不要です。目的のノートブックを選択するだけで、すぐに実験を開始できます。
-
ハードウェアの柔軟性: トレーニングのニーズや予算に合わせて、CPU、GPU、TPUの構成が異なる複数のマシンタイプから選択できます。Gradientがバックエンドのセットアップをすべて処理するため、モデル開発に集中できます。
-
実験の追跡: Gradientは、ハイパーパラメーター、メトリクス、コードの変更など、実験の内容を自動的に追跡します。これにより、異なるトレーニング実行を簡単に比較し、最適な構成を特定して、成功した結果を再現できます。
-
データセット管理: Gradient内でデータセットを効率的に直接管理できます。データのアップロード、バージョン管理、前処理を簡単に行い、プロジェクトのデータ準備段階を効率化できます。
-
モデルのサービング: 数回のクリックで、トレーニング済みのYOLO26モデルをREST APIとしてデプロイできます。Gradientがインフラストラクチャを処理するため、物体検出モデルをアプリケーションに簡単に統合できます。
-
リアルタイムモニタリング: Gradientの直感的なダッシュボードで、デプロイ済みモデルのパフォーマンスと状態を監視できます。推論速度、リソース使用率、潜在的なエラーを把握できます。
YOLO26プロジェクトにGradientを使うべき理由#
YOLO26モデルのトレーニング、デプロイ、評価には多くの選択肢がありますが、Paperspace Gradientとの統合には他のソリューションとは異なる独自の利点があります。この統合ならではの特徴を見ていきましょう。
-
コラボレーションの強化: 共有ワークスペースとバージョン管理により、チームで円滑に作業しながら再現性を確保できます。チームが効果的に協力し、プロジェクトの履歴を明確に保てます。
-
低コストのGPU: Gradientは、大手クラウドプロバイダーやオンプレミスのソリューションより大幅に低いコストで、高性能GPUを利用できる環境を提供します。秒単位の課金により、実際に使用したリソース分だけを支払うため、予算を最適化できます。
-
予測可能なコスト: Gradientのオンデマンド料金により、コストの透明性と予測可能性が確保されます。必要に応じてリソースを増減でき、使用した時間分だけを支払うため、不要な出費を避けられます。
-
契約上の縛りなし: プロジェクトの要件の変化に合わせて、いつでもインスタンスタイプを変更し、コストとパフォーマンスのバランスを最適化できます。契約期間や拘束条件がないため、最大限の柔軟性が得られます。
概要#
このガイドでは、YOLO26モデルのトレーニングに使用するPaperspace Gradientとの統合について説明しました。Gradientは、モデルの簡単なトレーニングと評価から効率的なデプロイオプションまで、AI開発を加速するツールとインフラストラクチャを提供します。
詳しくは、Paperspaceの公式ドキュメントをご覧ください。
また、さまざまなYOLO26統合について詳しく知るには、Ultralyticsの統合ガイドページをご覧ください。コンピュータービジョンプロジェクトを次のレベルへ引き上げるための知見やヒントが満載です。
よくある質問#
Paperspace Gradientを使ったYOLO26モデルのトレーニングは、簡単かつ効率的です。まず、Paperspaceコンソールにサインインします。次に、「Start Machine」ボタンをクリックして、管理対象のGPU環境を起動します。環境の準備が整ったら、ノートブックのセルを実行してYOLO26モデルのトレーニングを開始できます。詳しい手順については、YOLO26モデルのトレーニングガイドをご覧ください。
Paperspace Gradientには、YOLO26モデルのトレーニングとデプロイに役立つ、次のような独自の利点があります。
- ハードウェアの柔軟性: さまざまなCPU、GPU、TPU構成から選択できます。
- ワンクリックノートブック: 環境のセットアップを気にせず、YOLO26向けに事前設定されたJupyterノートブックを使用できます。
- 実験の追跡: ハイパーパラメーター、メトリクス、コードの変更を自動的に追跡します。
- データセット管理: Gradient内でデータセットを効率的に管理できます。
- モデルのサービング: モデルをREST APIとして簡単にデプロイできます。
- リアルタイムモニタリング: ダッシュボードでモデルのパフォーマンスとリソース使用率を監視できます。
Paperspace Gradientの実験追跡は、ハイパーパラメーター、メトリクス、コードの変更を自動的に記録し、モデル開発プロセスを効率化します。これにより、異なるトレーニング実行を簡単に比較し、最適な構成を特定して、成功した実験を再現できます。Ultralytics YOLO26と統合できる他の実験追跡ツールにも、同様の機能があります。