ADE20K 데이터셋#
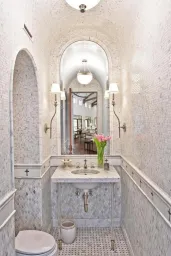
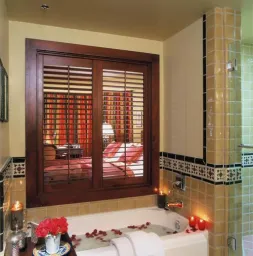
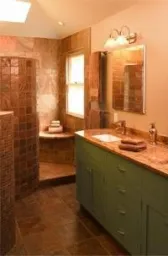
ADE20K 데이터셋은 MIT CSAIL에서 제공하는 대규모 시맨틱 세그멘테이션 벤치마크로, 실내, 실외, 객체 및 stuff 카테고리 150개에 걸쳐 20,210개의 학습 이미지와 2,000개의 검증 이미지가 정밀하게 어노테이션되어 있습니다. Ultralytics YOLO를 사용하여 dense scene-understanding 모델을 학습하고 평가하기 위한 표준 리소스입니다.
주요 기능#
- ADE20K의 전체 SceneParsing 벤치마크는 총 25,562개의 이미지로 구성됩니다. 학습용 20,210개, 검증용 2,000개, 테스트용 3,352개입니다. 테스트 이미지의 어노테이션은 공개되지 않으므로 다운로드 가능한
ADEChallengeData2016아카이브와 Ultralyticsade20k.yamlconfig는 학습 및 검증 split만 사용합니다. - 이 데이터셋은 실내, 실외, 객체 및 stuff 카테고리에 걸쳐 150개의 semantic class를 포함합니다.
- 어노테이션은 scene parsing에 적합한 dense pixel-level segmentation mask입니다.
데이터셋 구조#
Ultralytics configuration은 공식 ADEChallengeData2016 layout을 사용합니다:
ADEChallengeData2016/
├── images/
│   ├── training/
│   └── validation/
└── annotations/
    ├── training/
└── validation/ADE20K에는 자동 다운로드 스크립트가 없습니다. ~1 GB 크기의 ADEChallengeData2016.zip 아카이브를 다운로드하여 datasets/ 폴더에 직접 압축 해제합니다. 아카이브 자체의 최상위 폴더 이름은 이미 ADEChallengeData2016/으로 지정되어 있으므로, 이렇게 하면 위 layout과 일치하는 datasets/ADEChallengeData2016/가 생성됩니다. 직접 ADEChallengeData2016 폴더를 만들고 그 안에 압축을 해제하지 마십시오. 그렇게 하면 YAML이 찾지 못하는 중첩된 datasets/ADEChallengeData2016/ADEChallengeData2016/ 디렉터리가 생성됩니다.
masks_dir 필드는 annotations로 설정되어 있으므로 images/ 아래의 각 이미지가 해당 mask인 annotations/과 연결됩니다. 원본 ADE20K mask는 0가 무시되는 source label ID를 사용하며, label_mapping section은 유효한 label 1부터 150까지를 연속적인 train ID 0부터 149까지로 변환하고, 무시된 pixel을 255으로 매핑합니다.
응용 분야#
ADE20K는 시맨틱 세그멘테이션과 scene parsing에서 딥러닝 모델을 학습하고 평가하는 데 널리 사용됩니다. 다양한 카테고리와 복잡한 scene을 제공하므로 자율 주행, robotics, augmented reality 및 image editing과 같은 애플리케이션에 유용합니다.
실내 및 실외 scene의 폭넓은 구성 덕분에 ADE20K는 domain 전반에서 모델 generalization을 평가하기 위한 강력한 벤치마크이기도 합니다. 사전 학습된 YOLO26 semantic segmentation 모델은 ADE20K validation set에서 최대 51.5 mIoU에 도달합니다. 전체 벤치마크 표는 semantic segmentation models 페이지를 참조하십시오. ADE20K 형식의 데이터셋은 dataset management 및 training을 위해 Ultralytics Platform과도 완벽하게 호환됩니다.
데이터셋 YAML#
dataset YAML 파일은 ADE20K의 경로, class, mask directory 및 label mapping을 정의합니다. ade20k.yaml 파일은 https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/ade20k.yaml에서 관리됩니다.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# ADE20K semantic segmentation dataset (150 classes)
# Documentation: https://docs.ultralytics.com/datasets/semantic/ade20k
# Example usage: yolo semantic train data=ade20k.yaml model=yolo26n-sem.pt
# parent
# ├── ultralytics
# └── datasets
#     └── ADEChallengeData2016 ← downloads here (1 GB)
#         └── images
#         └── annotations

# Dataset root directory
path: ADEChallengeData2016
train: images/training
val: images/validation

masks_dir: annotations # semantic mask directory

# ADE20K 150-class labels
names:
  0: wall
  1: building
  2: sky
  3: floor
  4: tree
  5: ceiling
  6: road
  7: bed
  8: windowpane
  9: grass
  10: cabinet
  11: sidewalk
  12: person
  13: earth
  14: door
  15: table
  16: mountain
  17: plant
  18: curtain
  19: chair
  20: car
  21: water
  22: painting
  23: sofa
  24: shelf
  25: house
  26: sea
  27: mirror
  28: rug
  29: field
  30: armchair
  31: seat
  32: fence
  33: desk
  34: rock
  35: wardrobe
  36: lamp
  37: bathtub
  38: railing
  39: cushion
  40: base
  41: box
  42: column
  43: signboard
  44: chest of drawers
  45: counter
  46: sand
  47: sink
  48: skyscraper
  49: fireplace
  50: refrigerator
  51: grandstand
  52: path
  53: stairs
  54: runway
  55: case
  56: pool table
  57: pillow
  58: screen door
  59: stairway
  60: river
  61: bridge
  62: bookcase
  63: blind
  64: coffee table
  65: toilet
  66: flower
  67: book
  68: hill
  69: bench
  70: countertop
  71: stove
  72: palm
  73: kitchen island
  74: computer
  75: swivel chair
  76: boat
  77: bar
  78: arcade machine
  79: hovel
  80: bus
  81: towel
  82: light
  83: truck
  84: tower
  85: chandelier
  86: awning
  87: streetlight
  88: booth
  89: television receiver
  90: airplane
  91: dirt track
  92: apparel
  93: pole
  94: land
  95: bannister
  96: escalator
  97: ottoman
  98: bottle
  99: buffet
  100: poster
  101: stage
  102: van
  103: ship
  104: fountain
  105: conveyor belt
  106: canopy
  107: washer
  108: plaything
  109: swimming pool
  110: stool
  111: barrel
  112: basket
  113: waterfall
  114: tent
  115: bag
  116: minibike
  117: cradle
  118: oven
  119: ball
  120: food
  121: step
  122: tank
  123: trade name
  124: microwave
  125: pot
  126: animal
  127: bicycle
  128: lake
  129: dishwasher
  130: screen
  131: blanket
  132: sculpture
  133: hood
  134: sconce
  135: vase
  136: traffic light
  137: tray
  138: ashcan
  139: fan
  140: pier
  141: crt screen
  142: plate
  143: monitor
  144: bulletin board
  145: shower
  146: radiator
  147: glass
  148: clock
  149: flag

# Map source label IDs to train IDs; ignore_label is converted to 255.
label_mapping:
  0: ignore_label
  1: 0
  2: 1
  3: 2
  4: 3
  5: 4
  6: 5
  7: 6
  8: 7
  9: 8
  10: 9
  11: 10
  12: 11
  13: 12
  14: 13
  15: 14
  16: 15
  17: 16
  18: 17
  19: 18
  20: 19
  21: 20
  22: 21
  23: 22
  24: 23
  25: 24
  26: 25
  27: 26
  28: 27
  29: 28
  30: 29
  31: 30
  32: 31
  33: 32
  34: 33
  35: 34
  36: 35
  37: 36
  38: 37
  39: 38
  40: 39
  41: 40
  42: 41
  43: 42
  44: 43
  45: 44
  46: 45
  47: 46
  48: 47
  49: 48
  50: 49
  51: 50
  52: 51
  53: 52
  54: 53
  55: 54
  56: 55
  57: 56
  58: 57
  59: 58
  60: 59
  61: 60
  62: 61
  63: 62
  64: 63
  65: 64
  66: 65
  67: 66
  68: 67
  69: 68
  70: 69
  71: 70
  72: 71
  73: 72
  74: 73
  75: 74
  76: 75
  77: 76
  78: 77
  79: 78
  80: 79
  81: 80
  82: 81
  83: 82
  84: 83
  85: 84
  86: 85
  87: 86
  88: 87
  89: 88
  90: 89
  91: 90
  92: 91
  93: 92
  94: 93
  95: 94
  96: 95
  97: 96
  98: 97
  99: 98
  100: 99
  101: 100
  102: 101
  103: 102
  104: 103
  105: 104
  106: 105
  107: 106
  108: 107
  109: 108
  110: 109
  111: 110
  112: 111
  113: 112
  114: 113
  115: 114
  116: 115
  117: 116
  118: 117
  119: 118
  120: 119
  121: 120
  122: 121
  123: 122
  124: 123
  125: 124
  126: 125
  127: 126
  128: 127
  129: 128
  130: 129
  131: 130
  132: 131
  133: 132
  134: 133
  135: 134
  136: 135
  137: 136
  138: 137
  139: 138
  140: 139
  141: 140
  142: 141
  143: 142
  144: 143
  145: 144
  146: 145
  147: 146
  148: 147
  149: 148
  150: 149
# Download URL (manual): https://data.csail.mit.edu/places/ADEchallenge/ADEChallengeData2016.zip사용법#
ADE20K 데이터셋에서 이미지 크기 512로 100개의 epoch 동안 YOLO26n-sem 모델을 학습하려면 다음 code snippet을 사용할 수 있습니다. 사용 가능한 인자의 전체 목록은 모델 Training 페이지를 참조하십시오.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="ade20k.yaml", epochs=100, imgsz=512)
인용, 라이선스 및 감사의 글#
ADE20K 이미지는 비상업적 연구 및 교육 용도로만 제공되며, 데이터셋의 annotation software는 BSD-3.0에 따라 별도로 라이선스됩니다. 상업적 사용을 위해서는 MIT CSAIL의 허가가 필요합니다.
연구 또는 개발 작업에서 ADE20K 데이터셋을 사용하는 경우 다음 논문을 인용해 주십시오:
@inproceedings{zhou2017scene,
  title={Scene Parsing through ADE20K Dataset},
  author={Zhou, Bolei and Zhao, Hang and Puig, Xavier and Fidler, Sanja and Barriuso, Adela and Torralba, Antonio},
  booktitle={Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition},
  year={2017}
}
컴퓨터 비전 커뮤니티를 위해 이 귀중한 리소스를 만들고 유지 관리해 온 MIT CSAIL Computer Vision Group에 감사드립니다. ADE20K 데이터셋과 제작자에 대한 자세한 내용은 ADE20K dataset website를 방문하십시오.
FAQ#
ADE20K 데이터셋은 시맨틱 세그멘테이션에 사용되는 대규모 scene parsing 벤치마크로, 실내, 실외, 객체 및 stuff class를 포함한 150개 카테고리에 걸쳐 학습 이미지 20,210개와 검증 이미지 2,000개가 공개되어 있습니다. 연구자들은 다양한 scene, 세분화된 category set, 그리고 평균 Intersection over Union(mIoU)과 같은 표준화된 evaluation metric을 제공하는 ADE20K를 사용합니다. 이러한 특성 덕분에 dense prediction 모델의 benchmark에 적합합니다.
ADE20K 데이터셋에서 이미지 크기 512로 100 epoch 동안 YOLO26n-sem 모델을 학습하려면 다음 code snippet을 사용할 수 있습니다. 사용 가능한 인자의 자세한 목록은 모델 Training 페이지를 참조하십시오.
학습 예제from ultralytics import YOLO # Load a model model = YOLO("yolo26n-sem.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="ade20k.yaml", epochs=100, imgsz=512)ADE20K 데이터셋은 공식 ADEChallengeData2016 layout을 따르며, 이미지는
images/training/및images/validation/아래에 구성되고 해당 mask는annotations/training/및annotations/validation/아래에 구성됩니다. Ultralytics YAML 파일은masks_dir: annotations필드를 통해 각 이미지를 해당 mask와 연결하고,label_mapping를 사용하여 source label ID1–150을 연속적인 train ID0–149로 변환하며, ignore label을255으로 매핑합니다.예.
ADEChallengeData2016.zip아카이브(~1 GB)를 다운로드하여 학습 전에datasets/폴더에 직접 압축 해제합니다. 아카이브 자체의 최상위 폴더 이름은 이미ADEChallengeData2016/으로 지정되어 있으므로, 별도로 만든ADEChallengeData2016폴더 안이 아닌 해당 위치에 압축을 해제하면ade20k.yaml이 기대하는images/및annotations/layout이 생성됩니다.ADE20K annotation mask는
0이 ignore 또는 background class를 나타내는 source label ID를 저장합니다.label_mappingsection은 유효한 label1부터150까지를 연속적인 train ID0부터149까지로 매핑하고,255을 무시된 pixel에 할당하여 training 및 validation 중 loss와 metric에서 제외합니다.아니요. ADE20K 이미지는 비상업적 연구 및 교육으로 사용을 제한하는 조건에 따라 제공되며, 함께 제공되는 annotation software는 BSD-3에 따라 별도로 라이선스됩니다. 상업적 라이선스 옵션은 MIT CSAIL에 문의하십시오.