Como testar modelos de visão computacional
Introdução#
Os testes do modelo verificam o desempenho de um modelo treinado com dados do mundo real que ainda não foram vistos — objetos em movimento, com pouca iluminação ou parcialmente ocultos, em vez de dados de referência selecionados. Enquanto a avaliação do modelo mede métricas num conjunto de dados etiquetado, os testes verificam se o comportamento aprendido pelo modelo corresponde aos objetivos da sua aplicação antes da implantação. Este guia aborda a preparação dos dados de teste, os testes dos modelos Ultralytics YOLO26 e a identificação de sobreajuste, subajuste e vazamento de dados.
Assista: Como testar modelos de aprendizado de máquina | Evite vazamento de dados em visão computacional 🚀
Testes do modelo vs. avaliação do modelo#
Os testes do modelo e a avaliação do modelo são etapas distintas num projeto de visão computacional. A avaliação mede o desempenho com métricas num conjunto de dados etiquetado; os testes verificam se o comportamento aprendido pelo modelo se mantém em condições semelhantes às da implantação.
Imagine que treinou um modelo de visão computacional para reconhecer gatos e cães e pretende implantá-lo numa loja de animais para monitorizar os animais. Durante a fase de avaliação do modelo, você usa um conjunto de dados etiquetado para calcular métricas como exatidão, precisão e recall. Por exemplo, o modelo pode ter 98% de exatidão ao distinguir gatos de cães num determinado conjunto de dados.
Após a avaliação, teste o modelo com imagens de uma loja de animais para verificar a sua capacidade de identificar gatos e cães em condições mais variadas e realistas. Verifique se ele consegue etiquetar corretamente gatos e cães quando estão em movimento, sob diferentes condições de iluminação ou parcialmente ocultos por objetos como brinquedos ou móveis. Os testes do modelo verificam se ele se comporta como esperado fora do ambiente de avaliação controlado.
Preparação para testar o modelo#
Os conjuntos de dados de visão computacional costumam ser divididos em conjuntos de treino e teste para simular condições do mundo real: os dados de treino ensinam o modelo, enquanto os dados de teste verificam o seu comportamento com exemplos que nunca viu. A Ultralytics Platform centraliza a organização e a anotação dos conjuntos de dados, o que ajuda a criar um conjunto de teste anotado.
- Representação realista: os dados de teste ainda não vistos devem ser semelhantes aos dados que o modelo tratará após a implantação. Isso oferece uma visão realista das capacidades do modelo.
- Tamanho suficiente: o conjunto de dados de teste deve ser grande o bastante para fornecer informações fiáveis sobre o desempenho do modelo.
Como testar um modelo YOLO26#
Testar um modelo YOLO26 treinado envolve dois fluxos de trabalho complementares: validá-lo numa divisão de teste anotada para obter métricas quantitativas e fazer previsões em novas imagens para inspecionar o comportamento qualitativamente.
Validar uma partição de teste etiquetada#
O modo de validação compara as previsões do modelo com as etiquetas de referência e apresenta a precisão, a revocação, mAP50 e mAP50-95 para modelos de deteção. Também guarda recursos visuais, como uma matriz de confusão e uma curva de precisão-revocação, que te ajudam a identificar áreas específicas em que o modelo pode não estar a ter um bom desempenho.
from ultralytics import YOLO

# Carregue um modelo pré-treinado ou o seu próprio checkpoint treinado, por exemplo, "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Valide; adicione split="test" se o YAML do seu conjunto de dados definir uma partição de teste
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Por padrão, a validação é executada na partição val do conjunto de dados. Para medir o desempenho num conjunto de teste reservado, defina uma partição test: no YAML do conjunto de dados e passe split="test".
Fazer previsões em imagens novas#
O modo de previsão executa o modelo com dados novos e ainda não vistos, sem exigir etiquetas. Não produz métricas de desempenho, mas guardar os resultados anotados permite analisar o comportamento do modelo em imagens do mundo real — por exemplo, em toda uma pasta de imagens de teste de uma só vez.
from ultralytics import YOLO

# Carregue um modelo pré-treinado ou o seu próprio checkpoint treinado, por exemplo, "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Execute previsões numa pasta de imagens de teste e guarde os resultados anotados
results = model.predict(source="path/to/test_images", save=True)Para verificar se o YOLO26 é adequado à tua aplicação antes de investires em treino personalizado, executa o modo de previsão com um checkpoint pré-treinado nas tuas próprias imagens. Os modelos são pré-treinados com conjuntos de dados como o COCO, pelo que os resultados dão uma ideia rápida do desempenho que o modelo poderá ter no teu contexto específico.
Validação vs. modo de previsão#
| Modo | Finalidade | Requer etiquetas | Saída |
|---|---|---|---|
| Validação | Quantificar o desempenho em relação à verdade fundamental | Sim | Precisão, revocação, mAP50, mAP50-95, matriz de confusão, curvas PR |
| Previsão | Inspecionar o comportamento do modelo com dados novos e sem etiquetas | Não | Imagens anotadas e resultados de previsão, sem métricas |
Como analisar os resultados dos testes#
Depois de obter previsões e métricas, investigue onde e por que razão o modelo falha:
- Imagens classificadas incorretamente: identifique e analise as imagens que o modelo classificou incorretamente para compreender onde está a falhar.
- Análise de erros: faça uma análise aprofundada dos erros para compreender os tipos de erro (por exemplo, falsos positivos e falsos negativos) e as suas possíveis causas.
- Viés e equidade: verifica se existem vieses nas previsões do modelo. Certifica-te de que o modelo tem um desempenho igualmente bom em diferentes subconjuntos dos dados, especialmente se estes incluírem atributos sensíveis como raça, género ou idade.
Sobreajuste e subajuste em aprendizado de máquina#
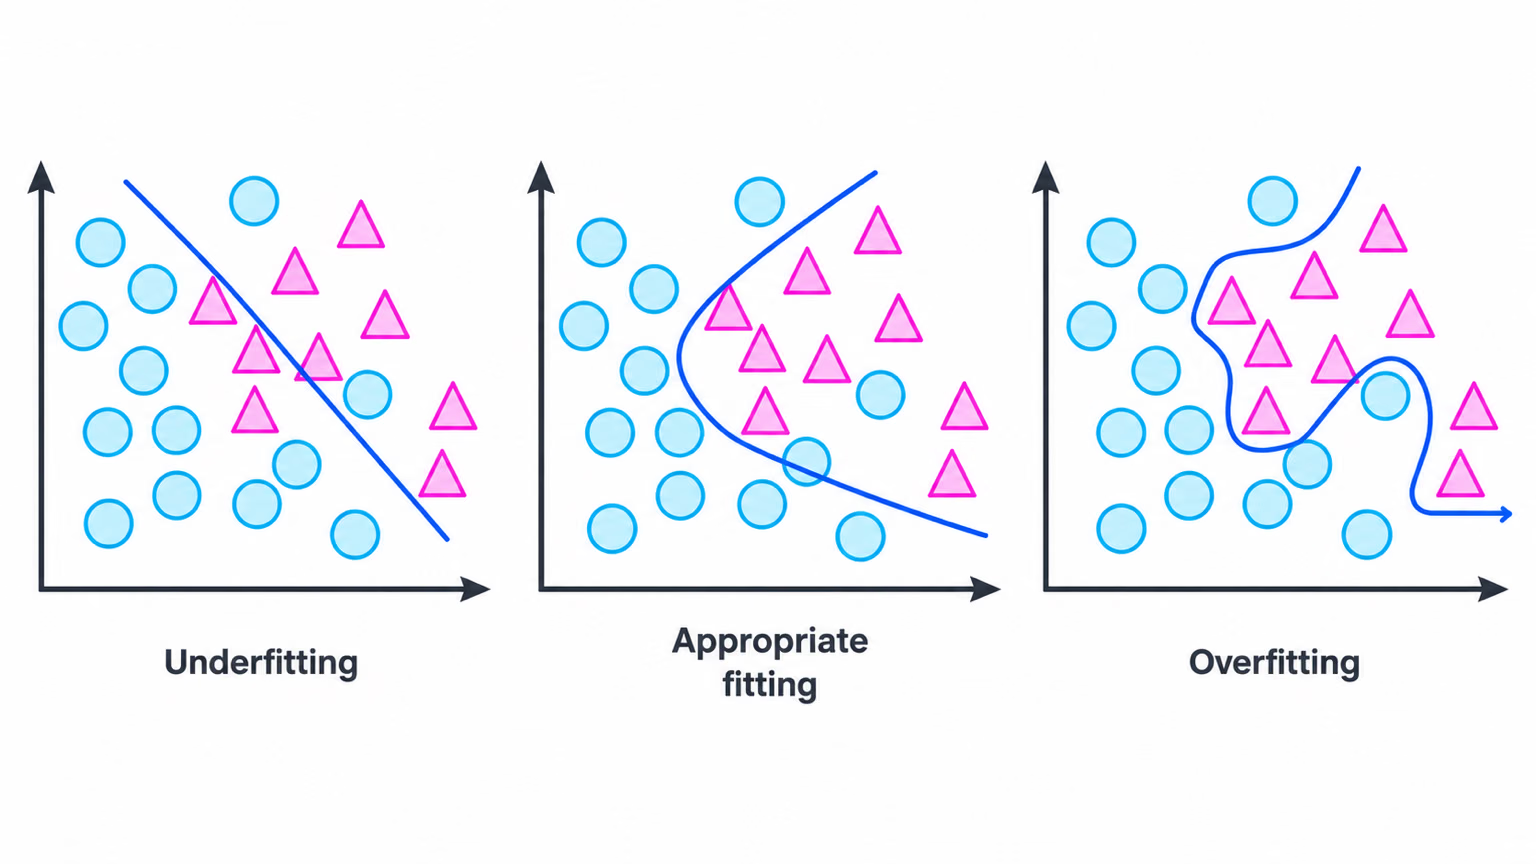
Ao testar um modelo de aprendizagem automática, especialmente em visão computacional, é importante estar atento ao sobreajuste e ao subajuste. Estes problemas podem afetar significativamente o desempenho do modelo com dados novos.
| Problema | Sinais comuns | Como resolver |
|---|---|---|
| Sobreajuste | Alta exatidão no treinamento, mas baixa exatidão na validação; sensibilidade excessiva a pequenas alterações ou a detalhes irrelevantes nas imagens | Aplique regularização, como dropout, aumente o tamanho do conjunto de dados de treinamento ou simplifique a arquitetura do modelo |
| Subajuste | Baixa exatidão mesmo no conjunto de treinamento; falhas consistentes ao reconhecer características ou objetos evidentes | Use um modelo mais complexo, forneça características mais relevantes ou aumente o número de épocas de treinamento |
O essencial é encontrar um equilíbrio para que o modelo tenha um bom desempenho nos conjuntos de dados de treinamento e de validação. Monitorizar regularmente as métricas e inspecionar visualmente as previsões durante os testes ajuda você a detetar uma tendência para qualquer um dos extremos.
Vazamento de dados em visão computacional e como evitá-lo#
A fuga de dados ocorre quando informações externas ao conjunto de dados de treino são usadas acidentalmente para treinar o modelo. O modelo pode parecer muito preciso durante o treino, mas não terá um bom desempenho com dados novos e não vistos quando ocorre uma fuga de dados.
Pode ser difícil detetar uma fuga de dados, que muitas vezes tem origem em vieses ocultos nos dados de treino:
| Tipo de viés | Como se manifesta |
|---|---|
| Viés de câmera | Diferentes ângulos, iluminação, sombras e movimentos da câmera introduzem padrões indesejados |
| Viés de sobreposição | Logótipos, marcas temporais ou outras sobreposições nas imagens induzem o modelo em erro |
| Viés de fonte e de objeto | Fontes ou objetos específicos que aparecem frequentemente em determinadas classes distorcem o aprendizado do modelo |
| Viés espacial | Desequilíbrios entre primeiro plano e fundo, nas distribuições de caixas delimitadoras e na localização dos objetos afetam o treinamento |
| Viés de etiquetas e de domínio | Rótulos incorretos ou mudanças nos tipos de dados causam vazamento |
Como detectar e evitar o vazamento de dados#
Para identificar vazamento de dados, verifique se os resultados do modelo são surpreendentemente bons, observe se um recurso é muito mais importante do que os outros, confirme se as decisões do modelo fazem sentido intuitivamente e verifique se os dados foram divididos corretamente antes de qualquer processamento.
Para evitar isso, use um conjunto de dados diversificado, com imagens ou vídeos de diferentes câmeras e ambientes, e examine cuidadosamente os dados em busca de vieses ocultos — como todas as amostras positivas terem sido coletadas em um horário específico do dia. Evitar o vazamento de dados torna seus modelos de visão computacional mais confiáveis em situações do mundo real.
O que fazer após testar o modelo#
Após testar o modelo, os próximos passos dependem dos resultados. Se o modelo tiver um bom desempenho, você pode implantá-lo em um ambiente real. Se os resultados não forem satisfatórios, será preciso fazer melhorias. Isso pode envolver analisar erros, coletar mais dados, melhorar a qualidade dos dados, ajustar hiperparâmetros e treinar o modelo novamente.
Conclusão#
Testes rigorosos do modelo — validação em uma divisão de teste reservada, realização de previsões em imagens do mundo real e verificação de sobreajuste e vazamento de dados — transformam um modelo bem avaliado em um modelo confiável. Resolva os problemas identificados nos testes antes da implantação, e o modelo terá muito mais chances de funcionar como esperado em produção. Se surgirem dúvidas ao longo do caminho, pergunte à comunidade no repositório do Ultralytics no GitHub ou no servidor do Ultralytics no Discord.
Perguntas frequentes#
A avaliação do modelo mede o desempenho com métricas em um conjunto de dados rotulado, enquanto o teste do modelo verifica como ele se comporta com dados novos e ainda não vistos, semelhantes às condições de implantação. A avaliação gera números como precisão e mAP a partir de um conjunto de dados controlado; os testes revelam se o comportamento aprendido se mantém diante de variações de iluminação, movimento ou oclusão. Consulte Teste de modelos vs. avaliação de modelos para ver um exemplo prático.
Use o modo de previsão e passe o caminho de uma pasta como
source— o YOLO26 será executado em todas as imagens da pasta e poderá salvar os resultados anotados para revisão. O modo de previsão não calcula métricas; para quantificar o desempenho em um conjunto rotulado, use o modo de validação. Os dois fluxos de trabalho são apresentados em Como testar um modelo YOLO26.Para modelos de deteção, a validação apresenta a precisão, a revocação, mAP50 e mAP50-95, e guarda gráficos que incluem uma matriz de confusão e uma curva de precisão-revocação. Para validar num subconjunto de teste dedicado em vez do subconjunto
valpredefinido, definetest:no YAML do teu conjunto de dados e passasplit="test". Consulta o guia de métricas de desempenho para saber como interpretar cada métrica.Para lidar com o sobreajuste, aplique técnicas de regularização, como dropout, aumente o tamanho do conjunto de dados de treinamento ou simplifique a arquitetura do modelo. Para lidar com o subajuste, use um modelo mais complexo, forneça mais recursos relevantes ou treine por mais épocas. Os sinais de cada problema e as respectivas soluções estão resumidos em Sobreajuste e subajuste em aprendizado de máquina.
Suspeite de vazamento de dados quando o desempenho no teste parecer surpreendentemente bom, um único recurso dominar as previsões ou as decisões do modelo não fizerem sentido intuitivamente. Evite esse problema usando conjuntos de dados diversificados, de diferentes câmeras e ambientes, verificando os dados em busca de vieses ocultos e confirmando que a divisão entre treino e teste ocorreu antes de qualquer processamento. Consulte Vazamento de dados em visão computacional para conhecer os tipos comuns de viés.
Se os resultados atenderem aos objetivos do projeto, implante o modelo; caso contrário, melhore-o antes da implantação. Isso pode significar analisar erros, coletar dados mais diversificados, melhorar a qualidade dos dados, ajustar hiperparâmetros e treinar o modelo novamente. Repita os testes após cada rodada de alterações para confirmar que as correções funcionaram.


Comentários2
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
gregnoel
Hello, is it possible to annotate on an image true negatives before the model trainig with YOLO ?
 Glenn JocherUltralytics(editado)
@gregnoel hello! You don't need to annotate true negatives. Images with no objects can be included in training as background images: a missing or empty label file marks the image as background. To assess performance after training, you can use validation mode. For more details, visit the Model Validation docs.