YOLOv10: deteção de objetos ponta a ponta em tempo real
Lançado em maio de 2024 e desenvolvido no pacote Python Ultralytics por investigadores da Universidade Tsinghua, o YOLOv10 introduz uma nova abordagem à deteção de objetos em tempo real, resolvendo deficiências do pós-processamento e da arquitetura dos modelos encontradas em versões anteriores do YOLO. Ao eliminar a supressão não máxima (NMS) e otimizar vários componentes do modelo, o YOLOv10 alcançou um desempenho sólido com uma sobrecarga computacional significativamente menor na altura do seu lançamento. O seu design de ponta a ponta sem NMS foi pioneiro numa abordagem que foi desenvolvida posteriormente no YOLO26.
Assista: Como treinar YOLOv10 no conjunto de dados SKU-110k usando Ultralytics | Conjunto de dados de varejo
Visão geral#
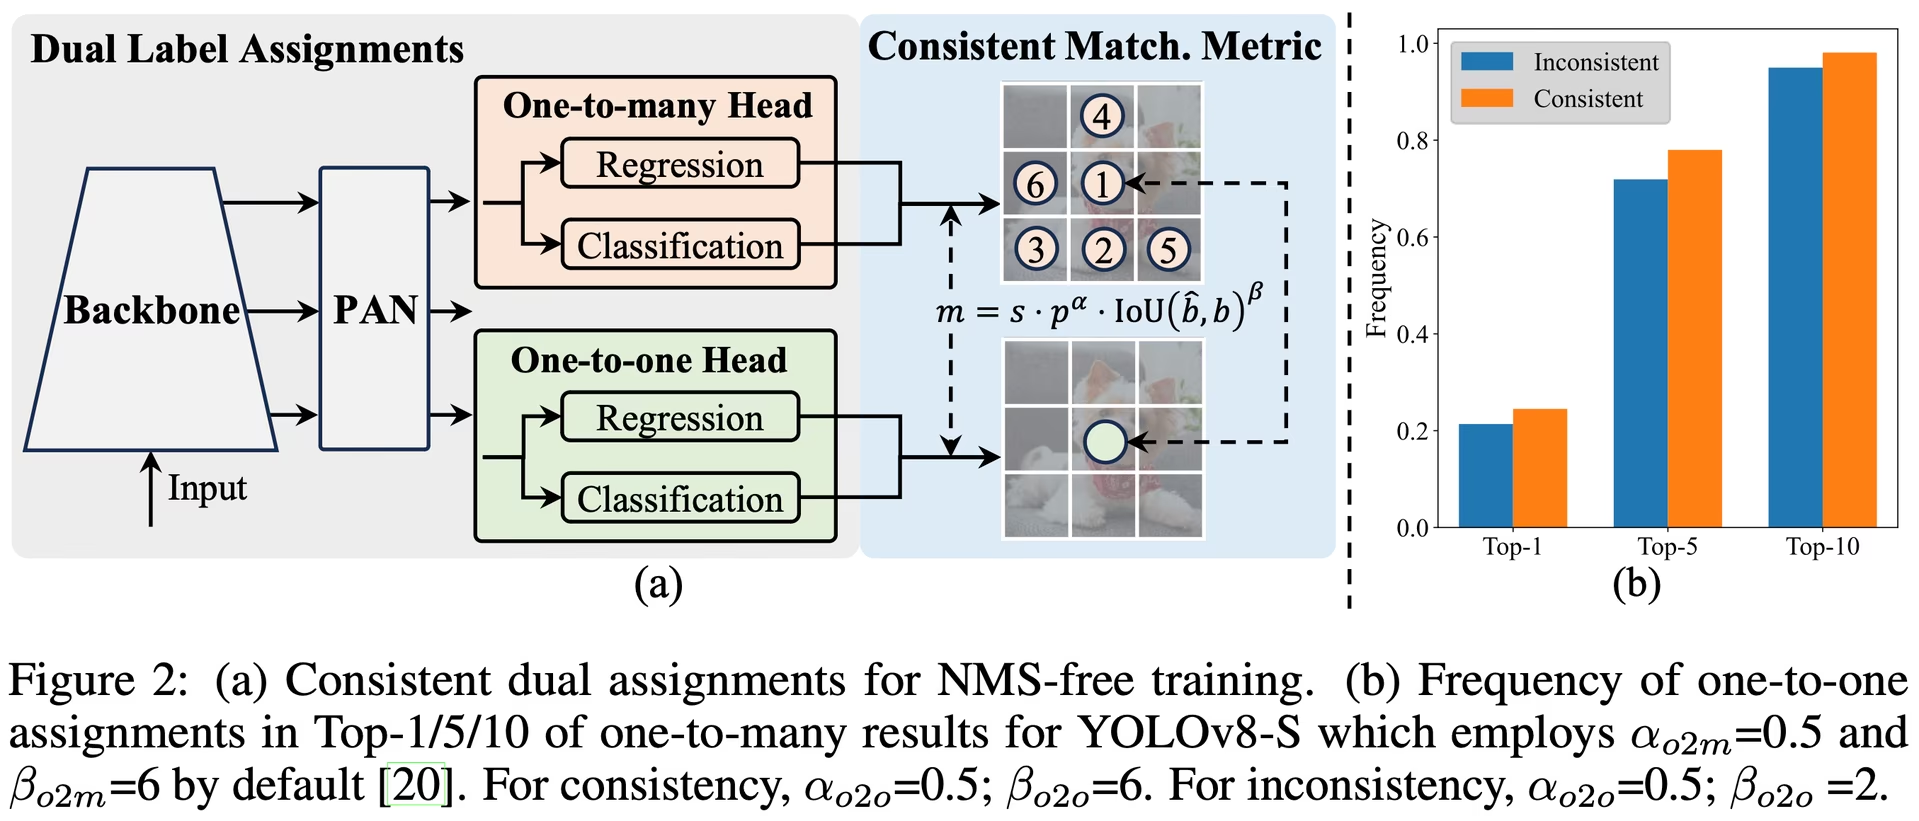
A deteção de objetos em tempo real procura prever com precisão as categorias e as posições dos objetos em imagens com baixa latência. A série YOLO tem estado na vanguarda desta investigação graças ao equilíbrio entre desempenho e eficiência. No entanto, a dependência de NMS e as ineficiências arquitetónicas têm impedido um desempenho ideal. O YOLOv10 resolve estes problemas através de atribuições duplas consistentes para treino sem NMS e de uma estratégia holística de conceção do modelo orientada para a eficiência e a precisão.
Arquitetura#
A arquitetura do YOLOv10 baseia-se nos pontos fortes dos modelos YOLO anteriores e introduz várias inovações importantes. A arquitetura do modelo é composta pelos seguintes elementos:
- Backbone: responsável pela extração de características, o backbone do YOLOv10 utiliza uma versão aprimorada do CSPNet (Cross Stage Partial Network) para melhorar o fluxo de gradientes e reduzir a redundância computacional.
- Neck: o neck foi concebido para agregar características de diferentes escalas e encaminhá-las para a head. Inclui camadas PAN (Path Aggregation Network) para uma fusão eficaz de características multiescala.
- Head One-to-Many: gera várias previsões por objeto durante o treino para fornecer sinais de supervisão ricos e melhorar a precisão da aprendizagem.
- Cabeça One-to-One: Gera uma única previsão melhor por objeto durante a inferência, eliminando a necessidade de NMS e, assim, reduzindo a latência e aumentando a eficiência.
Principais funcionalidades#
- Treinamento sem NMS: Utiliza atribuições duplas consistentes para eliminar a necessidade de NMS e reduzir a latência da inferência.
- Design holístico do modelo: Otimização abrangente de vários componentes sob as perspectivas de eficiência e precisão, incluindo cabeças de classificação leves, redução de resolução desacoplada entre espaço e canais e design de blocos orientado por classificação.
- Capacidades do modelo melhoradas: incorpora convoluções de kernels grandes e módulos de autoatenção parcial para melhorar o desempenho sem um custo computacional significativo.
Variantes do modelo#
O YOLOv10 oferece modelos em várias escalas para atender a diferentes necessidades de aplicação:
- YOLOv10n: Versão Nano para ambientes com recursos extremamente limitados.
- YOLOv10s: Versão Small que equilibra velocidade e precisão.
- YOLOv10m: Versão Medium para uso geral.
- YOLOv10b: Versão equilibrada com maior largura para obter mais precisão.
- YOLOv10l: Versão Large para obter mais precisão à custa de um maior consumo de recursos computacionais.
- YOLOv10x: Versão Extra-large para obter o máximo de precisão e desempenho.
Desempenho#
Na altura do seu lançamento, o YOLOv10 superava as versões anteriores do YOLO e outros modelos de última geração em precisão e eficiência. Por exemplo, o YOLOv10s é 1,8 vezes mais rápido do que RT-DETR-R18, com AP semelhante no conjunto de dados COCO, e o YOLOv10b tem menos 46% de latência e menos 25% de parâmetros do que YOLOv9-C, com o mesmo desempenho.
Latência medida com TensorRT FP16 em uma GPU T4.
| Modelo | Tamanho de entrada | APval50-95 | FLOPs (G) | Latência (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Metodologia#
Atribuições duplas consistentes para treinamento sem NMS#
O YOLOv10 utiliza atribuições duplas de rótulos, combinando estratégias de um para muitos e de um para um durante o treino para garantir supervisão abrangente e implementação eficiente de ponta a ponta. A predição e a validação da Ultralytics utilizam por predefinição a cabeça de um para muitos com NMS; define nms=False para selecionar a cabeça sem NMS. A métrica de correspondência consistente alinha a supervisão entre as duas estratégias, melhorando a qualidade das previsões durante a inferência.
Conceção holística do modelo orientada para eficiência e precisão#
Melhorias de eficiência#
- Cabeça de classificação leve: Reduz a sobrecarga computacional da cabeça de classificação usando convoluções separáveis em profundidade.
- Redução de resolução desacoplada entre espaço e canais: Desacopla a redução espacial e a modulação de canais para minimizar a perda de informação e o custo computacional.
- Design de blocos orientado por classificação: Adapta o design dos blocos com base na redundância intrínseca de cada estágio, garantindo o uso ideal dos parâmetros.
Melhorias de precisão#
- Convolução com kernel grande: Amplia o campo receptivo para aprimorar a capacidade de extração de características.
- Atenção própria parcial (PSA): Incorpora módulos de atenção própria para melhorar o aprendizado de representações globais com sobrecarga mínima.
Experimentos e resultados#
O YOLOv10 foi avaliado em benchmarks padrão, como COCO. Na altura do lançamento, todas as variantes melhoraram o equilíbrio entre latência e precisão em comparação com versões anteriores do YOLO e outros detetores da época.
Comparações#
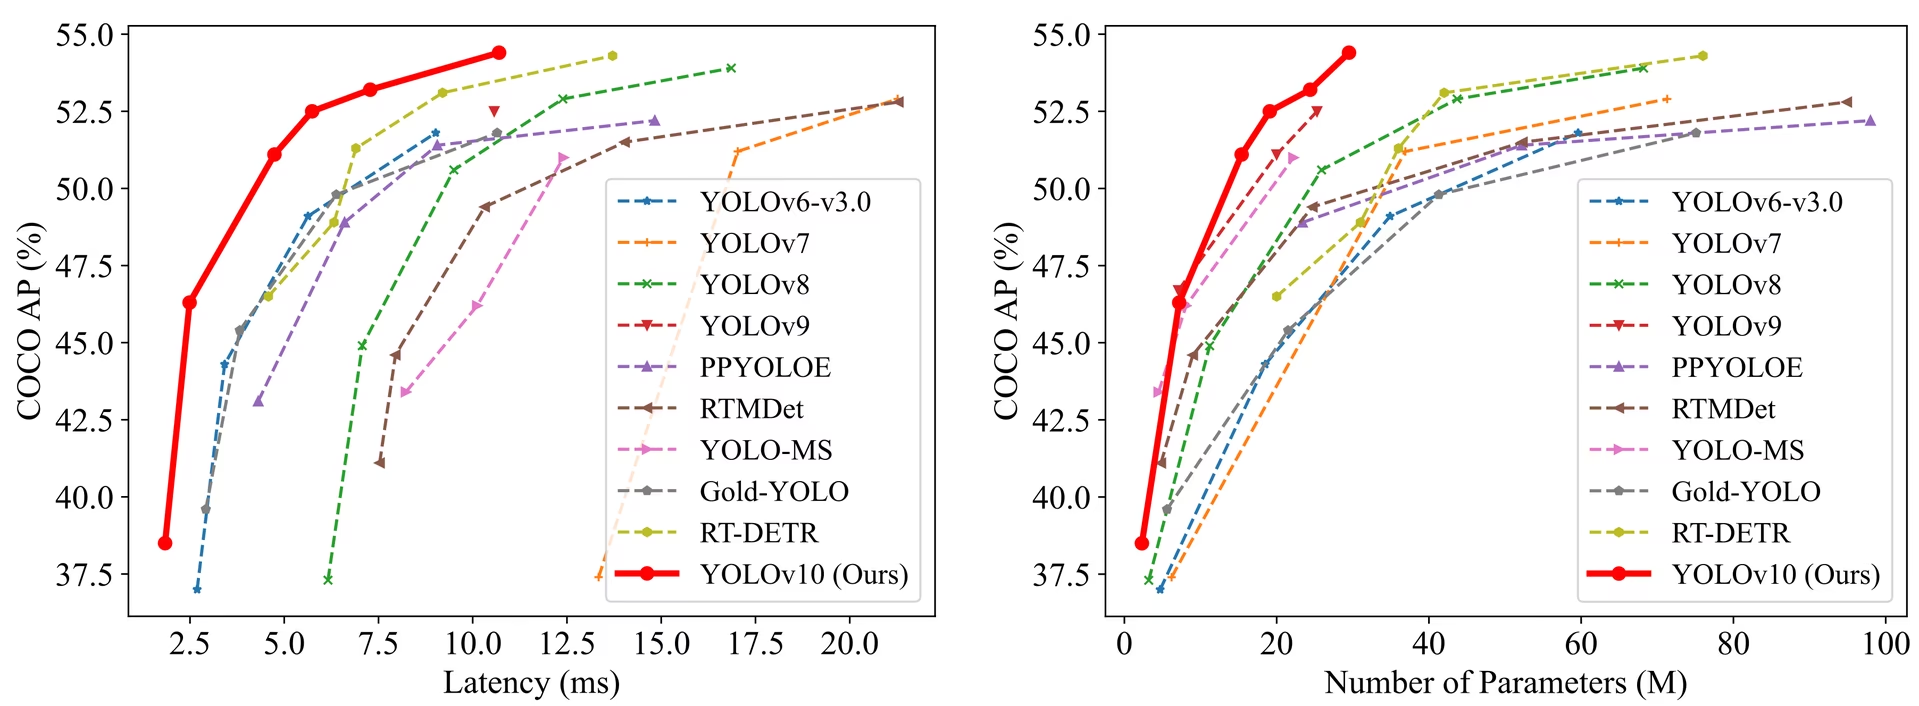
Em comparação com outros detectores de última geração:
- YOLOv10s / x são 1,8× / 1,3× mais rápidos que RT-DETR-R18 / R101, com precisão semelhante
- O YOLOv10b tem 25% menos parâmetros e 46% menos latência que o YOLOv9-C com a mesma precisão
- YOLOv10l / x superam o YOLOv8l / x em 0,3 AP / 0,5 AP, com 1,8× / 2,3× menos parâmetros
Os valores abaixo são os apresentados no artigo do YOLOv10, medidos de acordo com o protocolo próprio do estudo; por isso, não são diretamente comparáveis aos valores nas páginas de modelos do Ultralytics:
| Modelo | Parâmetros (M) | FLOPs (G) | mAPval50-95 | Latência (ms) | Latência-forward (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Os valores de parâmetros e FLOPs correspondem ao modelo fundido após model.fuse(), que combina as camadas Conv e BatchNorm e remove a cabeça auxiliar de detecção one-to-many. Os checkpoints pré-treinados mantêm a arquitetura completa de treinamento e podem apresentar valores maiores.
Exemplos de uso#
Os modelos também podem ser treinados em GPUs na nuvem por meio da Plataforma Ultralytics. Para fazer previsões em novas imagens com o YOLOv10:
from ultralytics import YOLO

# Carrega um modelo YOLOv10n pré-treinado
model = YOLO("yolov10n.pt")

# Realizar detecção de objetos em uma imagem
results = model("image.jpg")

# Apresenta os resultados
results[0].show()
Para treinar o YOLOv10 em um conjunto de dados personalizado:
from ultralytics import YOLO

# Carrega o modelo YOLOv10n do zero
model = YOLO("yolov10n.yaml")

# Treinar o modelo
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Tarefas e modos compatíveis#
A série de modelos YOLOv10 oferece vários modelos, cada um otimizado para a deteção de objetos. As variantes abrangem diferentes orçamentos computacionais e requisitos de precisão.
| Modelo | Nomes de arquivo | Tarefas | Treinamento | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
Exportação do YOLOv10#
Devido às novas operações introduzidas no YOLOv10, nem todos os formatos de exportação fornecidos pela Ultralytics são atualmente compatíveis. A tabela seguinte apresenta os formatos que a Ultralytics converteu com sucesso para YOLOv10. São bem-vindos pedidos de pull que adicionem suporte à exportação para outros formatos.
| Formato de exportação | Suporte à exportação | Inferência do modelo exportado | Observações |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Formato padrão de modelo PyTorch. |
| ONNX | ✅ | ✅ | Amplo suporte para implantação. |
| OpenVINO | ✅ | ✅ | Otimizado para hardware Intel. |
| TensorRT | ✅ | ✅ | Otimizado para GPUs NVIDIA. |
| CoreML | ✅ | ✅ | Limitado a dispositivos Apple. |
| TF SavedModel | ✅ | ✅ | Formato padrão de modelo do TensorFlow. |
| TF GraphDef | ✅ | ✅ | Formato legado do TensorFlow. |
| TF Edge TPU | ✅ | ✅ | Específico para dispositivos Edge TPU do Google. |
| LiteRT | ✅ | ✅ | Otimizado para dispositivos móveis, sistemas embarcados e navegadores (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Popular na China; menor suporte global. |
| NCNN | ✅ | ✅ | Otimizado para dispositivos móveis e integrados. |
Conclusão#
Na altura do seu lançamento, o YOLOv10 fez avançar a deteção de objetos em tempo real ao remover o pós-processamento NMS e redesenhar os componentes do modelo para melhorar a eficiência e a precisão. A sua abordagem sem NMS foi pioneira na deteção de objetos de ponta a ponta na família YOLO. O YOLO26, o modelo Ultralytics mais recente, desenvolve esta abordagem com melhor desempenho e inferência sem NMS.
Citações e agradecimentos#
Gostaríamos de agradecer aos autores do YOLOv10, da Universidade Tsinghua, pela extensa pesquisa e pelas contribuições significativas para o framework Ultralytics:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Para obter informações detalhadas sobre a implementação, as inovações arquiteturais e os resultados experimentais, consulta o artigo de pesquisa sobre o YOLOv10 e o repositório do GitHub da equipe da Universidade Tsinghua.
Perguntas frequentes#
O YOLOv10, desenvolvido por investigadores da Universidade Tsinghua, introduz várias inovações importantes na deteção de objetos em tempo real. Elimina a necessidade de supressão não máxima (NMS) ao utilizar atribuições duplas consistentes durante o treino e otimiza os componentes do modelo para reduzir a sobrecarga computacional.
Executa a inferência com a API Python da Ultralytics ou através da interface de linha de comandos (CLI). Seguem-se exemplos de predição de imagens novas com YOLOv10:
Exemplofrom ultralytics import YOLO # Carrega o modelo YOLOv10n pré-treinado model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Para veres mais exemplos de utilização, visita a secção Exemplos de utilização.
O YOLOv10 oferece várias variantes de modelo para responder a diferentes casos de utilização:
- YOLOv10n: adequado para ambientes com recursos extremamente limitados
- YOLOv10s: equilibra velocidade e precisão
- YOLOv10m: utilização geral
- YOLOv10b: maior precisão com uma largura aumentada
- YOLOv10l: alta precisão à custa de recursos computacionais
- YOLOv10x: precisão e desempenho máximos
Cada variante foi concebida para diferentes necessidades computacionais e requisitos de precisão, tornando-as versáteis para diversas aplicações. Explora a secção Variantes do modelo para obteres mais informações.
O YOLOv10 é treinado com atribuições duplas consistentes, de modo que a sua cabeça um-para-um produza uma única previsão de melhor qualidade por objeto, eliminando a necessidade de supressão não máxima (NMS) durante a inferência. Por predefinição, a predição e a validação do Ultralytics usam a cabeça um-para-muitos com NMS; define
nms=Falsepara selecionar a cabeça sem NMS e eliminar a etapa de NMS. Para uma explicação detalhada, consulta a secção Atribuições duplas consistentes para treino sem NMS.O YOLOv10 suporta vários formatos de exportação, incluindo TorchScript, ONNX, OpenVINO e TensorRT. No entanto, nem todos os formatos de exportação disponibilizados pelo Ultralytics são atualmente compatíveis com o YOLOv10 devido às suas novas operações. Para obteres detalhes sobre os formatos suportados e instruções de exportação, visita a secção Exportar YOLOv10.
Na altura do seu lançamento, o YOLOv10 superava as versões anteriores do YOLO e outros modelos de última geração em precisão e eficiência. Por exemplo, o YOLOv10s é 1,8 vezes mais rápido do que RT-DETR-R18, com um AP semelhante no conjunto de dados COCO. O YOLOv10b apresenta menos 46% de latência e menos 25% de parâmetros do que YOLOv9-C, com o mesmo desempenho. Podes encontrar benchmarks detalhados na secção Comparações.


Comentários188
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
 Glenn JocherUltralytics(editado)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(editado)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(editado)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(editado)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(editado)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1