Anotasyonlu Bilgisayarlı Görü Verileri için Veri Ön İşleme Teknikleri#
Veri ön işleme, ham ve anotasyonlu görüntüleri bir bilgisayarlı görü modelinin iyi eğitilmek için ihtiyaç duyduğu temiz ve tutarlı girdilere dönüştürür. Ultralytics YOLO26 ile temel piksel işlemleri — RGB dönüşümü, [0, 1] boyutuna ölçekleme ve yeniden boyutlandırma — eğitim hattında otomatik olarak gerçekleştirilir. Böylece geriye veri kümeni doğru biçimde bölmek, sınıfları dengelemek ve artırma yöntemlerini seçmek kalır. Bu kılavuz; yeniden boyutlandırma, normalleştirme, veri kümesini bölme, veri artırma ve keşifsel veri analizi (EDA) gibi temel teknikleri ele alır.
İzle: Gerçek Dünya Senaryolarında Model Doğruluğunu Artırmak İçin Veri Ön İşleme ve Artırma Nasıl Kullanılır 🚀
Bu adım, projenin hedeflerini tanımladıktan ve verileri toplayıp anotasyonladıktan sonra gelir ve bilgisayarlı görü projesi iş akışının başlarında yer alır.
Ön İşleme Neden Önemlidir#
Ön işleme, verilerini hesaplama yükünü azaltan ve model performansını iyileştiren bir biçime dönüştürür. Ham verilerde sık görülen üç sorunu ele alır:
- Gürültü: Verilerdeki ilgisiz veya rastgele değişimler.
- Tutarsızlık: Görüntü boyutları, biçimleri ve kalitesindeki farklılıklar.
- Dengesizlik: Veri kümesindeki sınıf veya kategorilerin eşit olmayan dağılımı.
Ön İşleme Teknikleri#
Temel teknikler yeniden boyutlandırma, normalleştirme, veri kümesini bölme ve artırmadır. YOLO26 ile ilk iki işlem otomatiktir; seçimlerinin en çok önem taşıdığı aşamalar ise bölme ve artırmadır.
Görüntüleri Yeniden Boyutlandırma#
Pek çok model tutarlı bir girdi boyutu gerektirir; bu nedenle yeniden boyutlandırma görüntüleri standartlaştırır ve hesaplama karmaşıklığını azaltır. Yaygın iki enterpolasyon yöntemi şunlardır:
- Bilineer Enterpolasyon: En yakın dört pikselin ağırlıklı ortalamasını alarak piksel değerlerini yumuşatır.
- En Yakın Komşu: Ortalama almadan en yakın piksel değerini kopyalar; daha hızlıdır, ancak daha bloklu bir görüntü oluşturur.
OpenCV ve PIL (Pillow) gibi kütüphaneler bu işlevleri sunar; ancak YOLO26 ile genellikle elle yeniden boyutlandırma yapman gerekmez. imgsz argümanı bunu halleder. Sabit boyutlu kare yolda doğrulama ve çıkarım, en-boy oranını koruyup gri dolguyla (114 değeri) kenar boşlukları ekleyerek görüntüleri imgsz × imgsz girdisine, örneğin 640 × 640 değerine uyarlar. Daha büyük görüntüler sığacak şekilde küçültülür; ölçeği büyütme devre dışıysa daha küçük görüntüler büyütülmez. Varsayılan eğitim yolunda ise mosaic=1.0, dört görüntüyü daha büyük bir tuval üzerinde döşer ve ardından imgsz boyutuna kırpar; son epoch'lar için close_mosaic mozaik yöntemini devre dışı bıraktığında görüntüler kenar boşlukları eklenerek boyutlandırılır ve olduğu gibi bırakılmak yerine rastgele dönüştürülmeye devam eder. Dikdörtgen gruplar (rect=True) ve multi_scale farklı girdi şekilleri kullanır.
Piksel Değerlerini Normalleştirme#
Normalleştirme, piksel değerlerini standart bir aralığa ölçekler; bu da modelin eğitim sırasında daha hızlı yakınsamasına yardımcı olur. Yaygın iki yöntem şunlardır:
- Min-Maks Ölçekleme: Piksel değerlerini 0 ile 1 aralığına ölçekler.
- Z-Skoru Normalleştirmesi: Piksel değerlerini ortalama ve standart sapmaya göre ölçekler.
YOLO26, ön işleme hattının bir parçası olarak normalleştirmeyi otomatik biçimde gerçekleştirir: Görüntüleri RGB'ye dönüştürür ve 255'e bölerek piksel değerlerini [0, 1] aralığına ölçekler (min-maks ölçekleme). YOLO, varsayılan olarak ImageNet tarzı ortalama/standart sapma (z-skoru) normalleştirmesi uygulamaz; bu nedenle elle normalleştirme adımı gerekmez.
Veri Kümesini Bölme#
Verileri eğitim, doğrulama ve test kümelerine bölmek, modeli görülmemiş veriler üzerinde değerlendirmeni ve genelleme başarısını ölçmeni sağlar. Yaygın bir bölme oranı, eğitime %70, doğrulamaya %20 ve teste %10 ayırmaktır. scikit-learn veya TensorFlow gibi araçlar bu işlemi kolaylaştırır.
Bölme işlemi sırasında şu noktaları göz önünde bulundur:
- Sınıf dağılımını koru: Her sınıfın eğitim, doğrulama ve test kümelerinde orantılı biçimde temsil edildiğinden emin ol.
- Sınıfları dengele: Dengesiz veri kümelerinde azınlık sınıfını aşırı örneklemeyi veya çoğunluk sınıfını eksik örneklemeyi düşün; bunu yalnızca eğitim kümesinde uygula.
Herhangi bir artırma veya başka bir ön işleme uygulamadan önce veri kümesini böl ve bu dönüşümleri yalnızca eğitim kümesine uygula. Bölmeden önce artırma yapmak, doğrulama veya test görüntülerindeki bilgilerin eğitimi etkilemesine yol açar; bu da gerçek dünya verilerinde düşen, yanıltıcı derecede yüksek puanlar üretir.
Veri Kümesini Artırma#
Veri artırma, mevcut görüntülerin değiştirilmiş sürümlerini oluşturarak veri kümesinin boyutunu yapay olarak artırır. Aşırı öğrenmeyi azaltmaya ve genelleme başarısını iyileştirmeye yardımcı olur; çeşitli avantajlar sunar:
- Daha dayanıklı modeller: Aydınlatma, yönelim ve ölçekteki değişiklikler modeli gerçek dünya bozulmalarına karşı dayanıklı kılar.
- Ekonomik: Yeni veriler toplayıp etiketlemeden eğitim kümesini genişletirsin.
- Verilerden daha iyi yararlanma: Her anotasyonlu görüntü birden fazla eğitim varyasyonu sağlar.
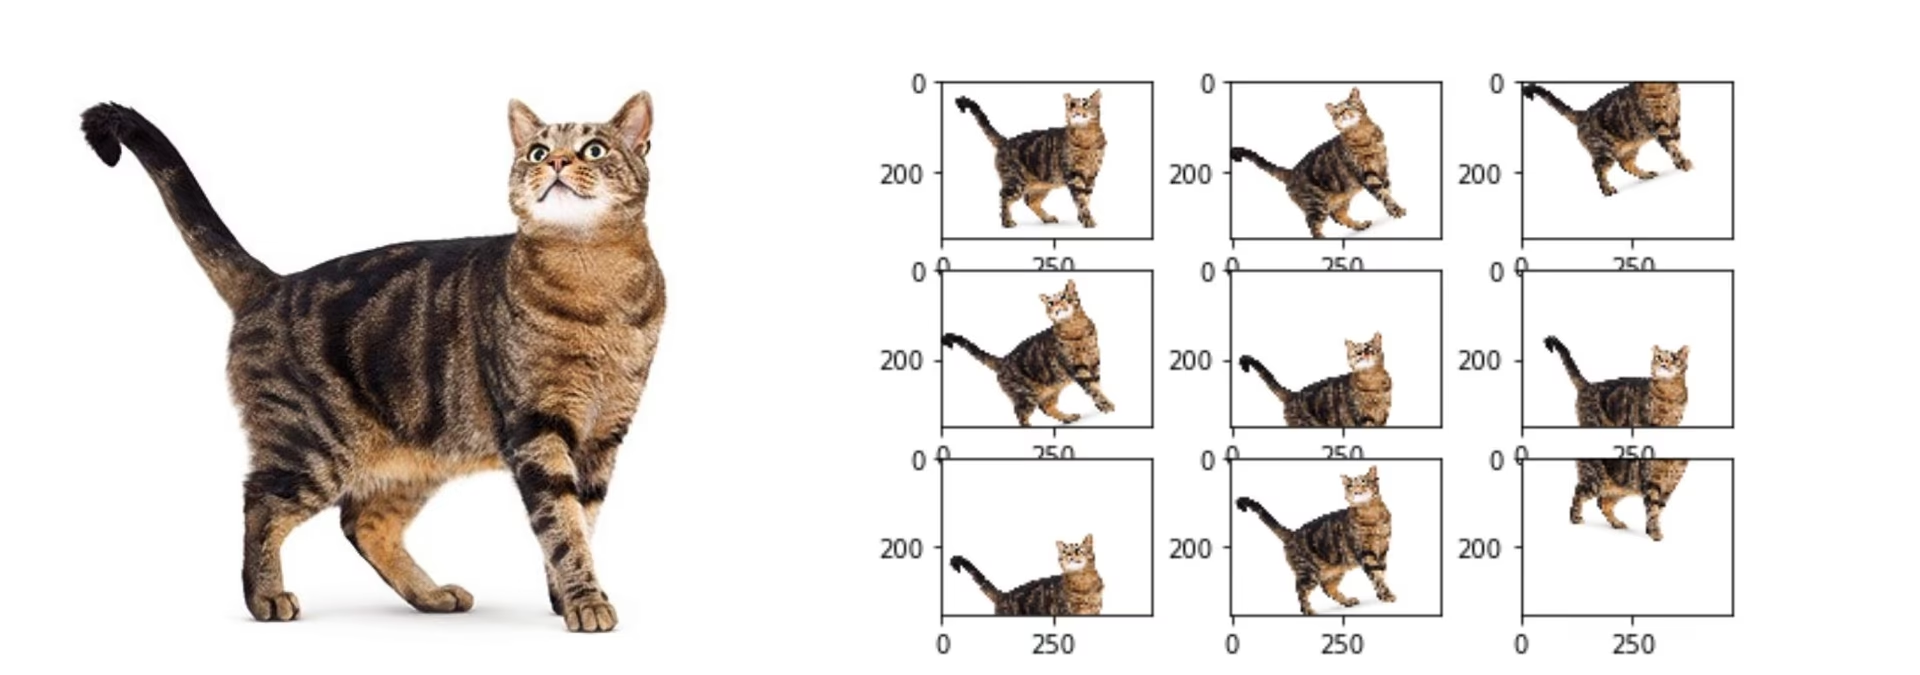
YOLO26 ile artırma gücü, veri kümesi yollar, sınıf adları ve bölmeler gibi meta verileri tanımlayan veri kümesi YAML dosyasını düzenleyerek değil, model.train() öğesine veya eşdeğer CLI bayraklarına iletilen eğitim argümanları üzerinden kontrol edilir. Bunun tek istisnası flip_idx öğesidir: poz veri kümeleri, sol/sağ kilit nokta çiftlerini eşlemek için bunu veri kümesi YAML dosyasında tanımlar; bu olmadığında YOLO, fliplr ve flipud öğelerini tamamen devre dışı bırakır. Yerleşik artırma yöntemleri şunlardır:
- Mosaic, MixUp ve CutMix (
mosaic,mixup,cutmix): Birden fazla görüntüyü tek bir eğitim örneğinde birleştirir. - Çevirme (
fliplr,flipud): Görüntüleri yatay veya dikey olarak yansıtır. - Geometrik dönüşümler (
degrees,translate,scale,shear,perspective): Görüntüleri döndürür, kaydırır, yakınlaştırır ve büker. - HSV renk titreşimi (
hsv_h,hsv_s,hsv_v): Tonu, doygunluğu ve parlaklığı değiştirir. - Kopyala-yapıştır (
copy_paste): Segmentlere ayrılmış nesnelerin ek kopyalarını yapıştırır; varsayılan olarak aynı görüntü içinde yansıtır veyacopy_paste_mode=mixupile başka bir görüntüden alır. - Kanal sırasını değiştirme (
bgr): RGB kanal sırasını BGR olarak değiştirir. - Sınıflandırma dönüşümleri (
auto_augment,erasing): Bir sınıflandırıcıyı eğitirken otomatik artırma politikası uygular ve rastgele silme işlemi gerçekleştirir.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Artırma, veri kümesi YAML dosyasıyla değil, eğitim argümanlarıyla yapılandırılır
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Artırma argümanlarının ve varsayılan değerlerinin tam listesi için artırma ayarları başvurusuna ve özel YOLO veri artırma kılavuzuna bak. albumentations paketi yüklüyse YOLO, Albumentations tabanlı yerleşik artırma yöntemlerini de otomatik olarak etkinleştirir.
Örnek Olay: Araç Algılama için Ön İşleme#
YOLO26 ile trafik görüntülerindeki araçları algılayıp sınıflandırmaya yönelik, sınırlayıcı kutular ve etiketlerle anotasyonlanmış görüntülerden başlayan bir proje düşün. Her ön işleme kararının nasıl göründüğü şöyle:
- Yeniden boyutlandırma: Elle işlem gerekmez; YOLO26 eğitim sırasında
imgszboyutuna yeniden boyutlandırır. - Normalleştirme: Elle işlem gerekmez; YOLO26 piksel değerlerini otomatik olarak
[0, 1]aralığına ölçekler. - Bölme: Veri kümesini %70 eğitim, %20 doğrulama ve %10 test olacak şekilde ayır; bölmeler arasında sınıf dağılımını tutarlı tut.
- Artırma: Trafik sahnelerine uygun eğitim argümanları belirle; örneğin yön değişmezliği için
fliplr, gündüz/gece aydınlatması içinhsv_vve değişen nesne yoğunluğu içinmosaic.
Bu kararlar verildiğinde veri kümesi Keşifsel Veri Analizi (EDA) için hazır olur.
Keşifsel Veri Analizi (EDA)#
EDA, verilerindeki örüntüleri ve dağılımları ortaya çıkarmak için istatistiklerden ve görselleştirmelerden yararlanır; böylece eğitimden önce sınıf dengesizliği veya aykırı değerler gibi sorunları fark etmene yardımcı olur.
İstatistiksel EDA Teknikleri#
İstatistiksel EDA; ortalama, medyan, standart sapma ve aralık gibi temel metriklerle başlar. Bu metrikler, piksel yoğunluğu dağılımları gibi özellikler üzerinde hesaplanır. Veri kümenin kalitesine hızlıca genel bir bakış sunar ve düzensizlikleri erkenden ortaya çıkarır.
Görsel EDA Teknikleri#
Görselleştirmeler; sınıf dengesizliği ve aykırı değerler gibi özet istatistiklerin gözden kaçırdığı örüntüleri ortaya çıkarır. Yaygın araçlar şunlardır:
- Histogramlar ve kutu grafikleri: Piksel değerlerinin dağılımını gösterir ve yoğunluk ya da özellik dağılımlarındaki aykırı değerleri belirler.
- Çubuk grafikler: Her sınıftaki örnek sayısını karşılaştırarak sınıf dengesizliğini ortaya çıkarır.
- Dağılım grafikleri: Görüntü özellikleri veya anotasyonlar arasındaki ilişkileri inceler.
- Isı haritaları: Piksel yoğunluğu dağılımlarını veya anotasyonların görüntülerdeki uzamsal dağılımını görselleştirir.
EDA için Ultralytics Platform#
EDA'yı kod yazmadan yapmak için veri kümeni Ultralytics Platform üzerine yükle. Veri kümesinin Charts sekmesi; bölme dağılımı, en yaygın sınıf sayıları, görüntü genişliği/yüksekliği histogramları ve anotasyon konumlarıyla görüntü boyutlarının 2B ısı haritaları gibi temel EDA görselleştirmelerini otomatik olarak oluşturur. Images sekmesi, anotasyon katmanlarıyla verilerini ızgara, kompakt veya tablo görünümlerinde incelemeni sağlar; böylece kod yazmadan yanlış etiketlenmiş örnekleri veya dengesiz sınıfları kolayca fark edebilirsin.
Sonuç#
Doğru biçimde bölünmüş, normalleştirilmiş ve artırılmış veriler gürültüyü azaltıp genelleme başarısını iyileştirerek ham bir görüntü koleksiyonunu güvenilir bir eğitim kümesine dönüştürür. Veri kümeni ön işleme tabi tuttuktan sonra sıradaki adım modelini eğitmektir. Bu süreçte soruların olursa topluluğa Ultralytics GitHub deposunda veya Ultralytics Discord sunucusunda danış.
Sık Sorulan Sorular#
Ön işleme, verilerinin temiz, tutarlı ve eğitim için optimize edilmiş bir biçimde olmasını sağlar. Ham verilerdeki gürültü, tutarsızlık ve sınıf dengesizliğini ele alan yeniden boyutlandırma, normalleştirme, artırma ve veri kümesini bölme gibi adımlar hesaplama yükünü azaltıp model performansını iyileştirir. Daha geniş iş akışındaki yerini görmek için bilgisayarlı görü projesinin adımlarına bak.
Artırmayı veri kümesi YAML dosyası yerine eğitim argümanlarıyla yapılandır. Her dönüşümün olasılığını ve gücünü ayarlamak için
fliplr,mosaic,hsv_hvedegreesgibi argümanlarımodel.train()öğesine (veya eşdeğer CLI bayraklarına) ilet. Bu argümanlar artırma ayarlarında tanımlanmış ve YOLO veri artırma kılavuzunda açıklanmıştır. Poz veri kümeleri istisnadır:flip_idxkilit noktası eşlemesi veri kümesi YAML dosyasında yer alır; bu eşleme olmadan çevirme devre dışı bırakılır.En yaygın iki teknik min-maks ölçekleme (pikselleri 0 ile 1 aralığına yeniden ölçekleme) ve z-skoru normalleştirmesidir (ortalama ve standart sapmaya göre yeniden ölçekleme). YOLO26 min-maks ölçeklemeyi otomatik olarak uygular — görüntüleri RGB'ye dönüştürür ve piksel değerlerini 255'e böler — bu nedenle elle normalleştirme adımına gerek yoktur. Varsayılan olarak z-skoru normalleştirmesi uygulamaz.
Yaygın bir uygulama, verilerin %70'ini eğitim, %20'sini doğrulama ve %10'unu test için ayırmaktır. Her üç bölmede de sınıf dağılımını koru ve bölme işleminden sonra artırmayı yalnızca eğitim kümesine uygulayarak veri sızıntısından kaçın. scikit-learn veya TensorFlow gibi araçlar bölme işlemini verimli biçimde yapar. Veri kümesini önceki aşamalarda hazırlamak için veri toplama ve anotasyon kılavuzuna bak.
Evet.
imgszargümanı, elle işlem gerektirmeden hedef girdi boyutunu kontrol eder. Sabit boyutlu kare yolda doğrulama ve çıkarım, en-boy oranını koruyarak görüntüleri belirtilen şekle uyarlar; daha büyük görüntüler sığacak şekilde küçültülür, ölçeği büyütme devre dışıysa daha küçük görüntüler büyütülmez. Eğitim sırasında varsayılan mozaik artırma yöntemi, dört görüntüyü döşeyip kırparak hedef boyuta ulaşır. Dikdörtgen gruplar (rect=True) vemulti_scalefarklı girdi şekilleri kullanır. Ayrıntılar için model eğitimi belgelerine bak.