MNIST 数据集#
MNIST(美国国家标准与技术研究院改良数据集)是一个图像分类基准,包含 70,000 张 28x28 的手写数字灰度图像,分为 10 个类别,即数字 0 到 9。该数据集提供预先划分的数据集,其中包含 60,000 张训练图像和 10,000 张测试图像,长期以来一直是评估机器学习和计算机视觉算法的标准基准。若要使用难度更高、对应服装图像的数据集,请参阅相关的 Fashion-MNIST 数据集;若要使用彩色图像,请参阅 CIFAR-10。
在 Ultralytics Platform 上探索 [MNIST],预览样本、查看数据集统计信息,并克隆数据集用于训练。
主要功能#
- MNIST 包含 60,000 张手写数字训练图像和 10,000 张测试图像,总计 70,000 张。
- 每张图像都是一张 28x28 的单数字灰度图片,经过尺寸归一化和抗锯齿处理,以适配 20x20 的方框,并居中放置在 28x28 的画布中。
- 10 个类别涵盖数字 0–9,每个类别的图像数量大致均衡。
- 该数据集提供预先划分的训练集和测试集,因此无需手动或自动划分。
- MNIST 是图像分类和深度学习研究的标准基准。
数据集结构#
MNIST 提供官方的预先划分数据集,因此无需自动或手动划分:
- 类别:10 个(手写数字 0–9)
- 图像总数:70,000 张(28x28 灰度图像)
- 训练集:60,000 张图像
- 测试集:10,000 张图像
MNIST 没有单独的验证文件夹,因此 Ultralytics 默认在训练期间使用包含 10,000 张图像的测试集作为验证集。
每张图像都标注了对应的数字(0–9),因此 MNIST 是适用于分类任务的监督式数据集。
应用场景#
MNIST 广泛用于训练和评估图像分类模型,模型类型从经典的卷积神经网络(CNNs)和支持向量机(SVMs)到现代深度架构都有。MNIST 的小尺寸灰度图像和 10 个数字类别,使其成为快速、可复现的算法对比和计算机视觉实验基准。
一些常见应用包括:
- 对新分类算法进行基准测试
- 用于教授机器学习概念的教育用途
- 图像识别系统原型开发
- 测试模型优化技术
用法#
在 MNIST 上训练 YOLO 分类模型,训练 100 个周期,图像尺寸为 28。首次使用时,数据集会自动下载并缓存;如果你希望完全掌控预处理过程,也可以从 MNIST 数据库获取原始 gzip 压缩包。有关所有可用参数的完整列表,请参阅 Training 页面和图像分类任务指南。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-cls.pt")  # 加载预训练模型(推荐用于训练)

# 训练模型
results = model.train(data="mnist", epochs=100, imgsz=28)Ultralytics 还提供 data="mnist160",这是一个包含 160 张图像的子集,涵盖训练集和测试集中每个数字(0–9)的前八张图像。该子集沿用 MNIST 的目录结构,因此你可以替换数据集,而无需更改其他参数,非常适合 CI 流水线,或在使用完整的 70,000 张图像数据集之前进行健全性检查。
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28示例图像和标注#
MNIST 数据集的样本图像:
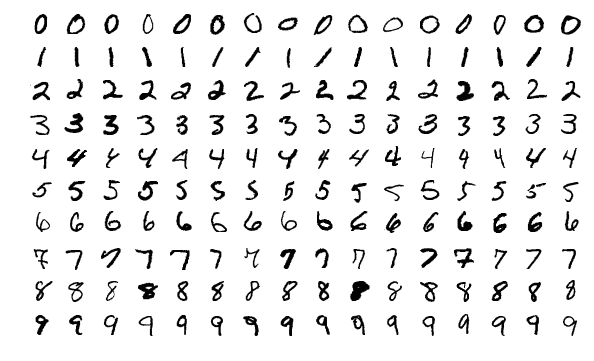
这些样本展示了数据集在 10 个数字类别中涵盖的各种手写风格。
引用与致谢#
如果你在研究或开发工作中使用 MNIST 数据集,请引用以下论文:
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}
我们谨此感谢 Yann LeCun、Corinna Cortes 和 Christopher J.C. Burges 创建并维护 MNIST 数据集,为机器学习和计算机视觉研究社区提供了宝贵资源。有关 MNIST 数据集及其创建者的更多信息,请访问 MNIST 数据集网站。
常见问题#
MNIST 有 10 个类别,即手写数字 0 到 9,总计 70,000 张灰度图像,每张图像为 28x28 像素。该数据集提供预先划分的 60,000 张训练图像和 10,000 张测试图像,每个数字对应的样本数量大致相同。
若要在 MNIST 上训练 Ultralytics YOLO 模型,请使用以下代码片段。首次使用时,数据集会自动下载。有关可用训练参数的详细列表,请参阅 Training 页面。
训练示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-cls.pt") # 加载预训练模型(推荐用于训练) # 训练模型 results = model.train(data="mnist", epochs=100, imgsz=28)MNIST 提供预先划分的 60,000 张训练图像和 10,000 张测试图像。与由 Ultralytics 自动划分的基于文件夹的分类数据集不同,MNIST 直接使用官方划分,默认在训练期间将测试集用作验证集。
MNIST 数据集只包含手写数字,而扩展 MNIST(EMNIST)数据集则同时包含数字和大小写字母。EMNIST 是作为 MNIST 的后继数据集开发的,并采用相同的 28x28 像素格式,因此兼容为原始 MNIST 数据集设计的工具和模型。字符种类更丰富,使 EMNIST 适用于更多类型的机器学习应用。
可以。Ultralytics Platform 让你无需编写大量代码,就能上传数据集、训练图像分类模型并部署模型。它为在云端进行 MNIST 实验提供了便捷方式——相关选项请参阅分类数据集概览。
MNIST 比 CIFAR-10 或 ImageNet 等许多现代数据集简单,因此非常适合初学者和快速实验。更复杂的数据集包含彩色图像和多样的对象类别,挑战性更高;而 MNIST 凭借简单性、小文件体积以及在机器学习算法发展史上的重要地位,仍然很有价值。若要使用结构相同、难度更高的直接替代数据集,请参阅 Fashion-MNIST,其中包含服装而非数字。