Caltech-101-Datensatz
Der Datensatz Caltech-101 ist ein klassischer Benchmark für die Bildklassifizierung. Er umfasst 9.144 Bilder aus 101 Objektkategorien sowie eine Hintergrundklasse. Jede Kategorie enthält etwa 40 bis 800 Bilder realer Objekte – Tiere, Fahrzeuge, Haushaltsgegenstände und Menschen – und bietet damit einen kompakten, aber anspruchsvollen Benchmark für Objekterkennungsmodelle.
Besuche Caltech-101 auf der Ultralytics Platform, um Beispiele in der Vorschau anzuzeigen, Datensatzstatistiken einzusehen und den Datensatz für das Training zu klonen.
Ansehen: So trainierst du ein Bildklassifizierungsmodell mit dem Caltech-101-Datensatz auf der Ultralytics-Plattform
Caltech-101 wird ohne vorgegebene Aufteilung in Trainings- und Validierungsdaten bereitgestellt. Die folgenden Trainingsbefehle teilen die Daten automatisch in 80 % Training und 20 % Validierung auf, sodass keine manuelle Vorbereitung erforderlich ist.
Wichtige Funktionen#
- Caltech-101 umfasst 9.144 Farbbilder aus 101 Objektkategorien sowie einer Klasse
BACKGROUND_Google(insgesamt 102 Klassenordner). - Die Kategorien decken eine große Vielfalt realer Objekte ab, darunter Tiere, Fahrzeuge, Haushaltsgegenstände und Menschen.
- Jede Kategorie enthält etwa 40 bis 800 Bilder, daher sind die Klassen unterschiedlich groß.
- Die Bilder haben unterschiedliche Größen und sind meist etwa 300x200 Pixel groß (mittlere Auflösung).
- Caltech-101 wird häufig als Benchmark für Algorithmen zur Bildklassifizierung und Objekterkennung verwendet.
Datensatzstruktur#
Caltech-101 wird in 102 Ordnern bereitgestellt – einem pro Klasse, mit 101 Objektkategorien und einer Klasse BACKGROUND_Google – und hat keine vorgegebene Aufteilung in Trainings- und Validierungsdaten. Beim Start des Trainings teilt Ultralytics die Bilder automatisch auf, sodass Modelle ohne manuelle Einrichtung mit allen 102 Klassen trainiert werden:
- Klassen: 102 (101 Objektkategorien + 1 Hintergrund)
- Bilder insgesamt: 9.144
- Aufteilung in Training/Validierung: automatisch 80 % / 20 % (≈7.280 Training, ≈1.864 Validierung)
- Bilder pro Klasse: etwa 40 bis 800 (unausgewogen)
Anwendungsfälle#
Caltech-101 wird häufig zum Trainieren und Evaluieren von Bildklassifizierungs- und Objekterkennungsmodellen verwendet, darunter faltende neuronale Netze (CNNs) und Support-Vektor-Maschinen (SVMs). Die große Bandbreite an Kategorien und die klaren, beschrifteten Bilder machen den Datensatz zu einem beliebten Benchmark für Forschung und Prototypentwicklung im Bereich maschinelles Lernen und Computer Vision.
Verwendung#
Trainiere ein YOLO26n-cls-Modell 100 Epochen lang auf Caltech-101 mit einer Bildgröße von 416.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-cls.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="caltech101", epochs=100, imgsz=416)
Beispielbilder und Annotationen#
Der Caltech-101-Datensatz enthält hochwertige Farbbilder verschiedener Objekte und bietet damit eine gut strukturierte Grundlage für Bildklassifizierungsaufgaben. Hier sind einige Beispielbilder aus dem Datensatz:
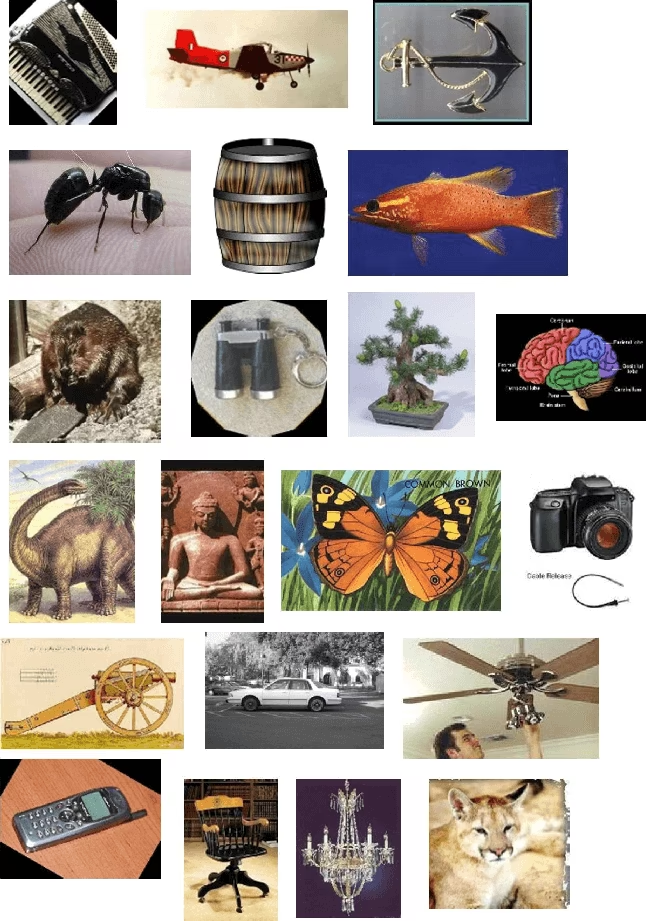
Die Beispiele zeigen die Vielfalt der Kategorien und den natürlichen, zentrierten Bildausschnitt, der für Caltech-101 typisch ist. Damit eignet sich der Datensatz als übersichtlicher Ausgangspunkt für das Training robuster Objekterkennungsmodelle.
Zitate und Danksagungen#
Wenn du den Caltech-101-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Wir möchten Li Fei-Fei, Rob Fergus und Pietro Perona dafür danken, dass sie den Caltech-101-Datensatz erstellt und gepflegt haben und ihn so der Forschungsgemeinschaft für maschinelles Lernen und Computer Vision als wertvolle Ressource zur Verfügung stellen. Weitere Informationen zum Caltech-101-Datensatz und seinen Urhebern findest du auf der Caltech-101-Datensatzwebsite.
Häufig gestellte Fragen#
Der Datensatz Caltech-101 wird häufig zum Trainieren und Bewerten von Modellen für Bildklassifizierung und Objekterkennung verwendet. Er umfasst 9.144 Bilder aus 101 Objektkategorien sowie eine Hintergrundklasse und bietet einen anspruchsvollen Benchmark zur Bewertung von Algorithmen wie faltenden neuronalen Netzen (CNNs) und Support-Vektor-Maschinen (SVMs).
Verwende die nachstehenden Codebeispiele, um ein Ultralytics-YOLO-Modell mit Caltech-101 zu trainieren. Beim ersten Gebrauch wird der Datensatz automatisch heruntergeladen. Die vollständige Liste der Argumente findest du auf der Seite Training des Modells.
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-cls.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101 umfasst 101 Objektkategorien sowie eine
BACKGROUND_Google-Klasse, also insgesamt 102 Klassenordner und 9.144 Bilder. Beim Training mit Ultralytics lernt das Modell alle 102 Klassen. Die Größe der Kategorien ist unausgewogen und reicht von etwa 40 bis 800 Bildern pro Kategorie.Caltech-101 hat keine vordefinierte Aufteilung. Beim ersten Training teilt Ultralytics den Datensatz automatisch im Verhältnis 80 % Training zu 20 % Validierung auf – etwa 7.280 Trainings- und 1.864 Validierungsbilder. Du musst die Aufteilung also nicht manuell erstellen. Wenn du die Aufteilung selbst festlegen möchtest, sortiere die Bilder vor dem Training in die Ordner
train/undval/.Ja. Mit der Ultralytics Platform kannst du Datensätze verwalten, Modelle zur Bildklassifizierung trainieren und bereitstellen, ohne viel programmieren zu müssen. Sie ist eine praktische Möglichkeit, Caltech-101-Experimente in der Cloud auszuführen. Weitere Möglichkeiten findest du in unserer Übersicht über Klassifizierungsdatensätze.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.