Gehirntumor-Datensatz
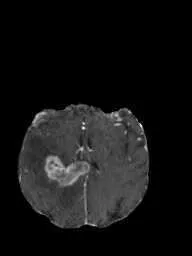
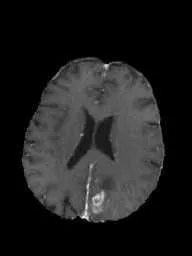
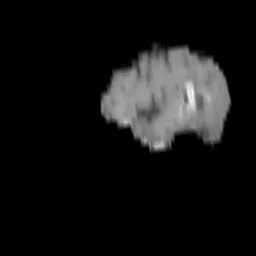
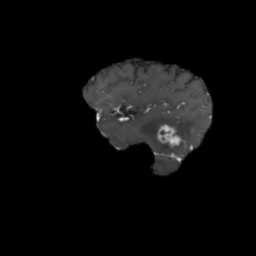

Der Ultralytics-Hirntumordatensatz ist ein Datensatz zur Objekterkennung mit 1.115 Gehirn-MRT-Bildern (994 für das Training und 121 für die Validierung) und 1.180 Begrenzungsrahmen in einer einzelnen Klasse, tumor. Jedes Bild enthält 1 bis 3 Begrenzungsrahmen für Tumoren. Die Validierungsaufteilung umfasst Bilder von 25 identifizierten Patienten, und kein identifizierter Patient kommt in beiden Aufteilungen vor. Mit 4,06 MB ist dies ein kompakter Datensatz zum Erlernen und Prototyping von Computer-Vision-Modellen für Anwendungen im Gesundheitswesen; er ist keine klinisch validierte diagnostische Ressource.
Ansehen: Erkennung von Hirntumoren mit der Ultralytics-Plattform und Ultralytics YOLO26 | Objekterkennung 🚀
Datensatzstruktur#
Der Ultralytics-Hirntumordatensatz enthält 1.115 Gehirn-MRT-Bilder und 1.180 Begrenzungsrahmen in zwei Aufteilungen, die durch die Konfiguration brain-tumor.yaml festgelegt werden:
| Aufteilung | Bilder | Begrenzungsrahmen | Patienten |
|---|---|---|---|
| Trainieren | 994 | 1,057 | 95 mit einer ID sowie 541 Bilder ohne Patienten-ID |
| Validierung | 121 | 123 | 25 |
| Gesamt | 1,115 | 1,180 |
Jedes Bild enthält 1 bis 3 Begrenzungsrahmen der einzigen Klasse tumor, und die Bildgrößen reichen von 192x256 bis 512x512 Pixel. Die Konfiguration definiert keine separate Testaufteilung.
Die Validierungsaufteilung wird anhand der Patienten erstellt. Einige Dateinamen beginnen mit einer fünfstelligen Patienten-ID: Beispielsweise gehört 00097_77.jpg zu Patient 00097. Die Bilder mit den IDs von 25 dieser Patienten bilden die Validierungsaufteilung; die Bilder der übrigen 95 identifizierten Patienten gehören zur Trainingsaufteilung. Somit kommt kein identifizierter Patient in beiden Aufteilungen vor. Die übrigen 541 Bilder haben keine Patienten-ID im Dateinamen und gehören alle zur Trainingsaufteilung.
Der Datensatz wird beim ersten Training automatisch von den GitHub-Assets von Ultralytics heruntergeladen (4,06 MB), sodass kein manueller Download oder keine Vorbereitung erforderlich ist.
Der Datensatz wurde im November 2026 auf eine einzelne Klasse tumor umgestellt. Wenn dein lokaler Ordner brain-tumor/images/train statt 994 nur 893 Bilder enthält, lösche den Ordner brain-tumor in deinem Datensatzverzeichnis (siehe datasets_dir in yolo settings) und aktualisiere das Paket mit pip install -U ultralytics. Die aktuelle Version wird dann beim nächsten Trainingslauf heruntergeladen.
Sieh dir Brain Tumor auf der Ultralytics Platform an, um die Bilder mit ihren Annotationen einzusehen, die Klassenverteilung und Bounding-Box-Heatmaps auf der Registerkarte Charts anzuzeigen und den Datensatz zu klonen, um dein eigenes Modell in der Cloud zu trainieren.
Anwendungsfälle#
Modelle zur Erkennung von Hirntumoren lokalisieren Tumoren in Gehirn-MRT-Bildern. Mit 1.115 Bildern und einem Downloadumfang von 4,06 MB eignet sich der Ultralytics-Hirntumordatensatz für:
- Abläufe erlernen: Den gesamten Zyklus aus Training, Validierung und Vorhersage mit medizinischen Bildern und einem kleinen Datensatz durchlaufen.
- Prototyping: Eine Pipeline zur Tumorlokalisierung entwickeln und testen, bevor zu einem größeren klinischen Datensatz gewechselt wird.
- Auswertung mit identifizierten Patienten: Die Erkennung anhand der 25 Validierungspatienten messen. Da bei 541 Trainingsbildern keine Patienten-ID vorliegt, kann eine Überschneidung mit diesen Patienten nicht ausgeschlossen werden.
- Forschung und Lehre: Erkennungsmodelle vergleichen und medizinische Bildanalyse sowie KI in der Radiologie untersuchen.
Modelle, die mit diesem Datensatz trainiert wurden, sind für Forschung und Lehre bestimmt und nicht für die klinische Diagnose validiert.
YAML-Datei des Datensatzes#
Die Konfiguration brain-tumor.yaml definiert den Datensatzpfad, die Bildordner für Training und Validierung, die einzelne Klasse tumor und die Download-URL. Die Labels verwenden das Ultralytics-YOLO-Format.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipVerwendung#
Um ein YOLO26n-Modell 100 Epochen lang mit Bildgröße 640 auf dem Gehirntumor-Datensatz zu trainieren, verwende die folgenden Codeausschnitte.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Ein Modell laden
model = YOLO("path/to/best.pt") # ein feinabgestimmtes Gehirntumor-Modell laden
# Inferenz mit dem Modell
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Beispielbilder und Annotationen#
Unten siehst du Beispielbilder aus dem Ultralytics-Hirntumordatensatz mit den zugehörigen Annotationen:
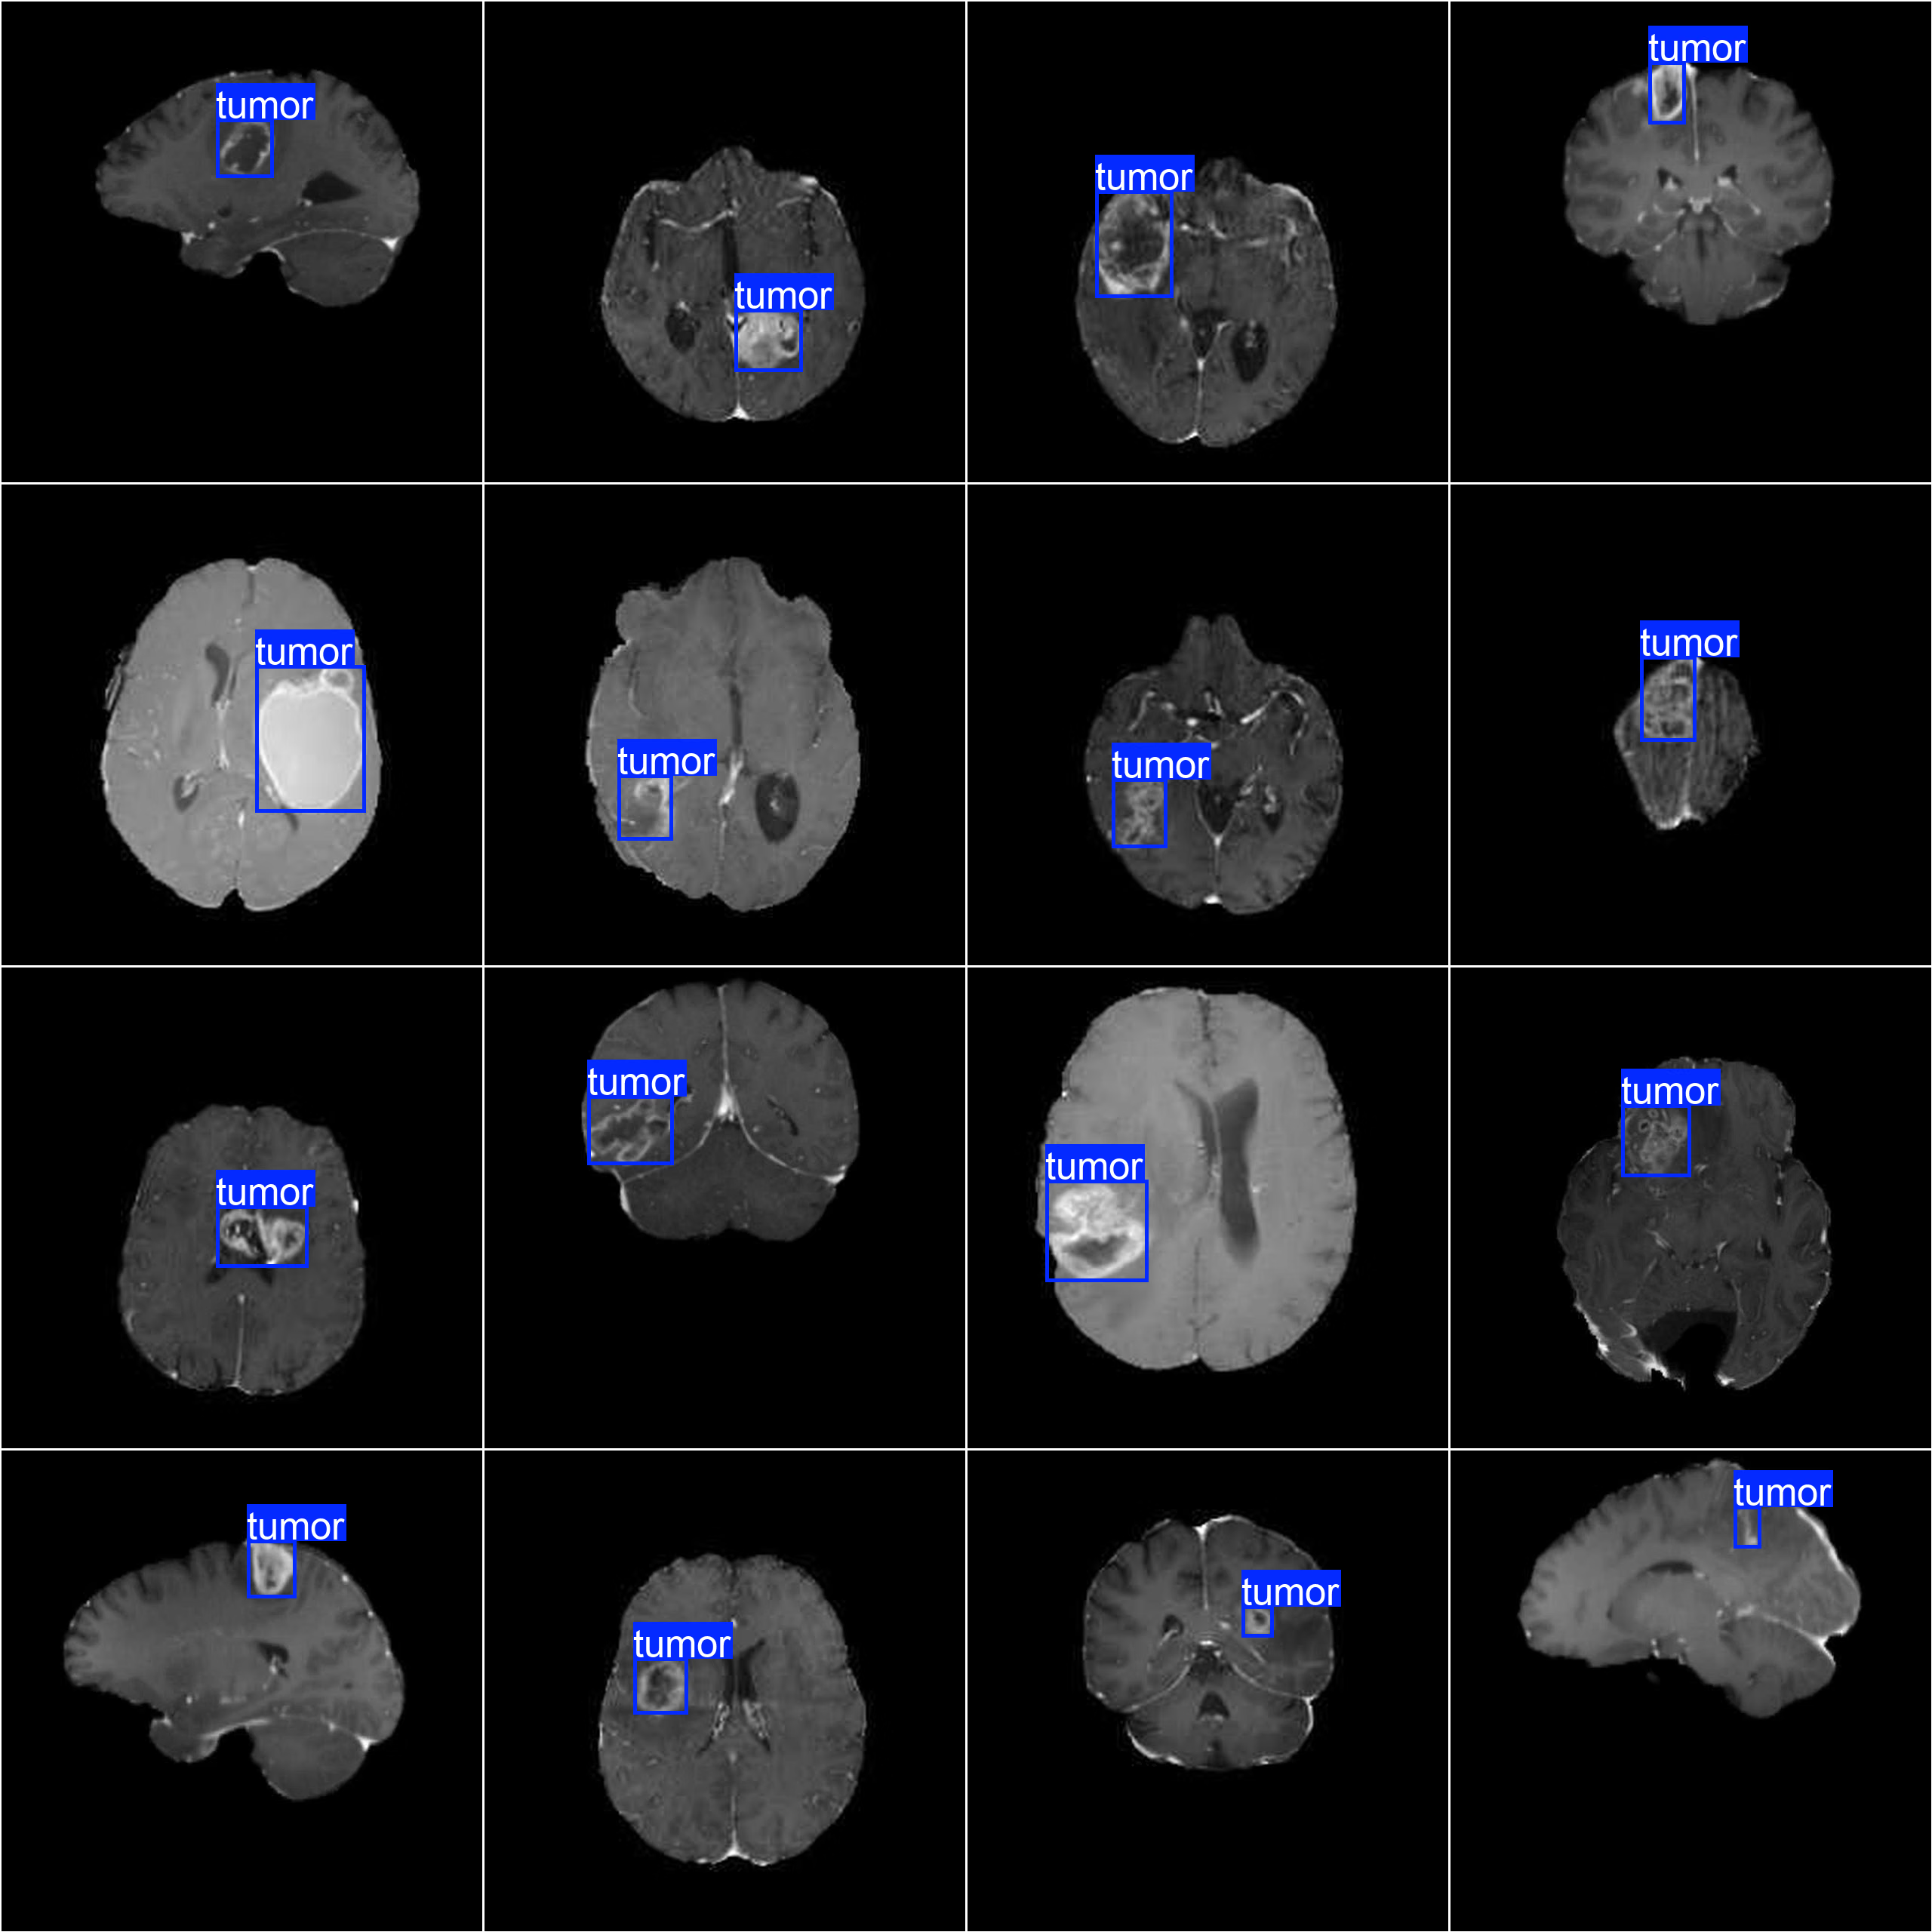
- Annotierte Bilder: Das Raster zeigt 16 Trainingsbilder, jeweils mit einem Begrenzungsrahmen der Klasse
tumorum die Läsion. Größe, Form und Lage der Tumoren variieren im Datensatz, wodurch ein Erkennungsmodell besser generalisieren kann.
Zitate und Danksagungen#
Der Datensatz ist unter der AGPL-3.0-Lizenz verfügbar.
Wenn du den Hirntumordatensatz in deiner Forschungs- oder Entwicklungsarbeit verwendest, zitiere ihn bitte:
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}
Häufig gestellte Fragen#
Der Ultralytics-Hirntumordatensatz umfasst 1.115 Gehirn-MRT-Bilder und 1 Klasse,
tumor: 994 Trainingsbilder mit 1.057 Begrenzungsrahmen und 121 Validierungsbilder mit 123 Begrenzungsrahmen. Jedes Bild enthält 1 bis 3 Begrenzungsrahmen, und es gibt keine separate Testaufteilung. Einzelheiten zu den Aufteilungen findest du unter Datensatzstruktur.Der Ultralytics-Hirntumordatensatz enthält Gehirn-MRT-Bilder und keine CT-Aufnahmen. Die Bildgrößen reichen von 192x256 bis 512x512 Pixel, und jedes Bild ist mit 1 bis 3 Begrenzungsrahmen der Klasse
tumorim Ultralytics-YOLO-Format markiert.Nein, der Ultralytics-Hirntumordatensatz enthält keine tumorfrei aufgenommenen Bilder und keine Negativklasse. Alle 1.115 Bilder haben 1 bis 3 Begrenzungsrahmen der Klasse
tumor. Ein damit trainiertes Modell lernt daher, wo sich ein Tumor befindet, nicht aber, ob eine Aufnahme gesund ist. Modelle, die mit diesem Datensatz trainiert wurden, sind für Forschung und Lehre bestimmt, nicht für die klinische Diagnose.Der Ultralytics-Hirntumordatensatz wird nach Patienten aufgeteilt: Die 121 Validierungsbilder tragen die IDs von 25 Patienten, und kein identifizierter Patient kommt in beiden Aufteilungen vor. Patienten werden anhand des fünfstelligen Präfixes im Dateinamen identifiziert, beispielsweise
00097_77.jpg. Die Trainingsdaten umfassen die übrigen 95 identifizierten Patienten sowie 541 Bilder, deren Dateinamen keine Patienten-ID enthalten.Der Ultralytics-Hirntumordatensatz (4,06 MB) wird beim ersten Training mit
data="brain-tumor.yaml"automatisch von den GitHub-Assets von Ultralytics heruntergeladen, sodass kein manueller Download erforderlich ist. Wenn bereits eine ältere Kopie mit 893 Trainingsbildern auf deinem Datenträger liegt, lösche deren Ordnerbrain-tumorund aktualisiere zuerst das Paketultralytics, damit die aktuelle Version mit einer einzelnen Klasse heruntergeladen wird. Einen weiteren kleinen Datensatz für die medizinische Bildgebung findest du unter Datensatz zur Erkennung medizinischer Pillen.Um YOLO26 mit dem Ultralytics-Hirntumordatensatz zu trainieren, übergib
data="brain-tumor.yaml"an den Trainingsbefehl; der Datensatz wird automatisch heruntergeladen. Die folgenden Beispiele trainieren YOLO26n 100 Epochen lang mit einer Bildgröße von 640:Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Eine detaillierte Liste der verfügbaren Argumente findest du auf der Seite zum Training.
Um mit einem auf dem Ultralytics-Hirntumordatensatz feinabgestimmten YOLO26-Modell Schlussfolgerungen auszuführen, lade deine Gewichte
best.ptund rufe predict für ein Gehirn-MRT-Bild auf. Jedes Ergebnis enthält die Begrenzungsrahmentumormit Konfidenzwerten:Inferenzbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("path/to/best.pt") # ein feinabgestimmtes Gehirntumor-Modell laden # Inferenz mit dem Modell results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Der Ultralytics-Hirntumordatensatz wurde von Ultralytics erstellt und unter der AGPL-3.0-Lizenz veröffentlicht.


Kommentare11
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(bearbeitet)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(bearbeitet)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(bearbeitet)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-