COCO-Pose-Datensatz#
Der Datensatz COCO-Pose erweitert COCO (gewöhnliche Objekte in Kontexten) für die Posenschätzung: 58.945 Bilder aus COCO Keypoints 2017, annotiert mit 156.165 Personen und einem Schema mit 17 Keypoints. Er ist der Standarddatensatz für das Training und den Vergleich von Keypoint-Modellen wie Ultralytics YOLO26. Die aus 8 Bildern bestehende Teilmenge COCO8-Pose verwendet dasselbe Format und ermöglicht schnelle Plausibilitätsprüfungen.
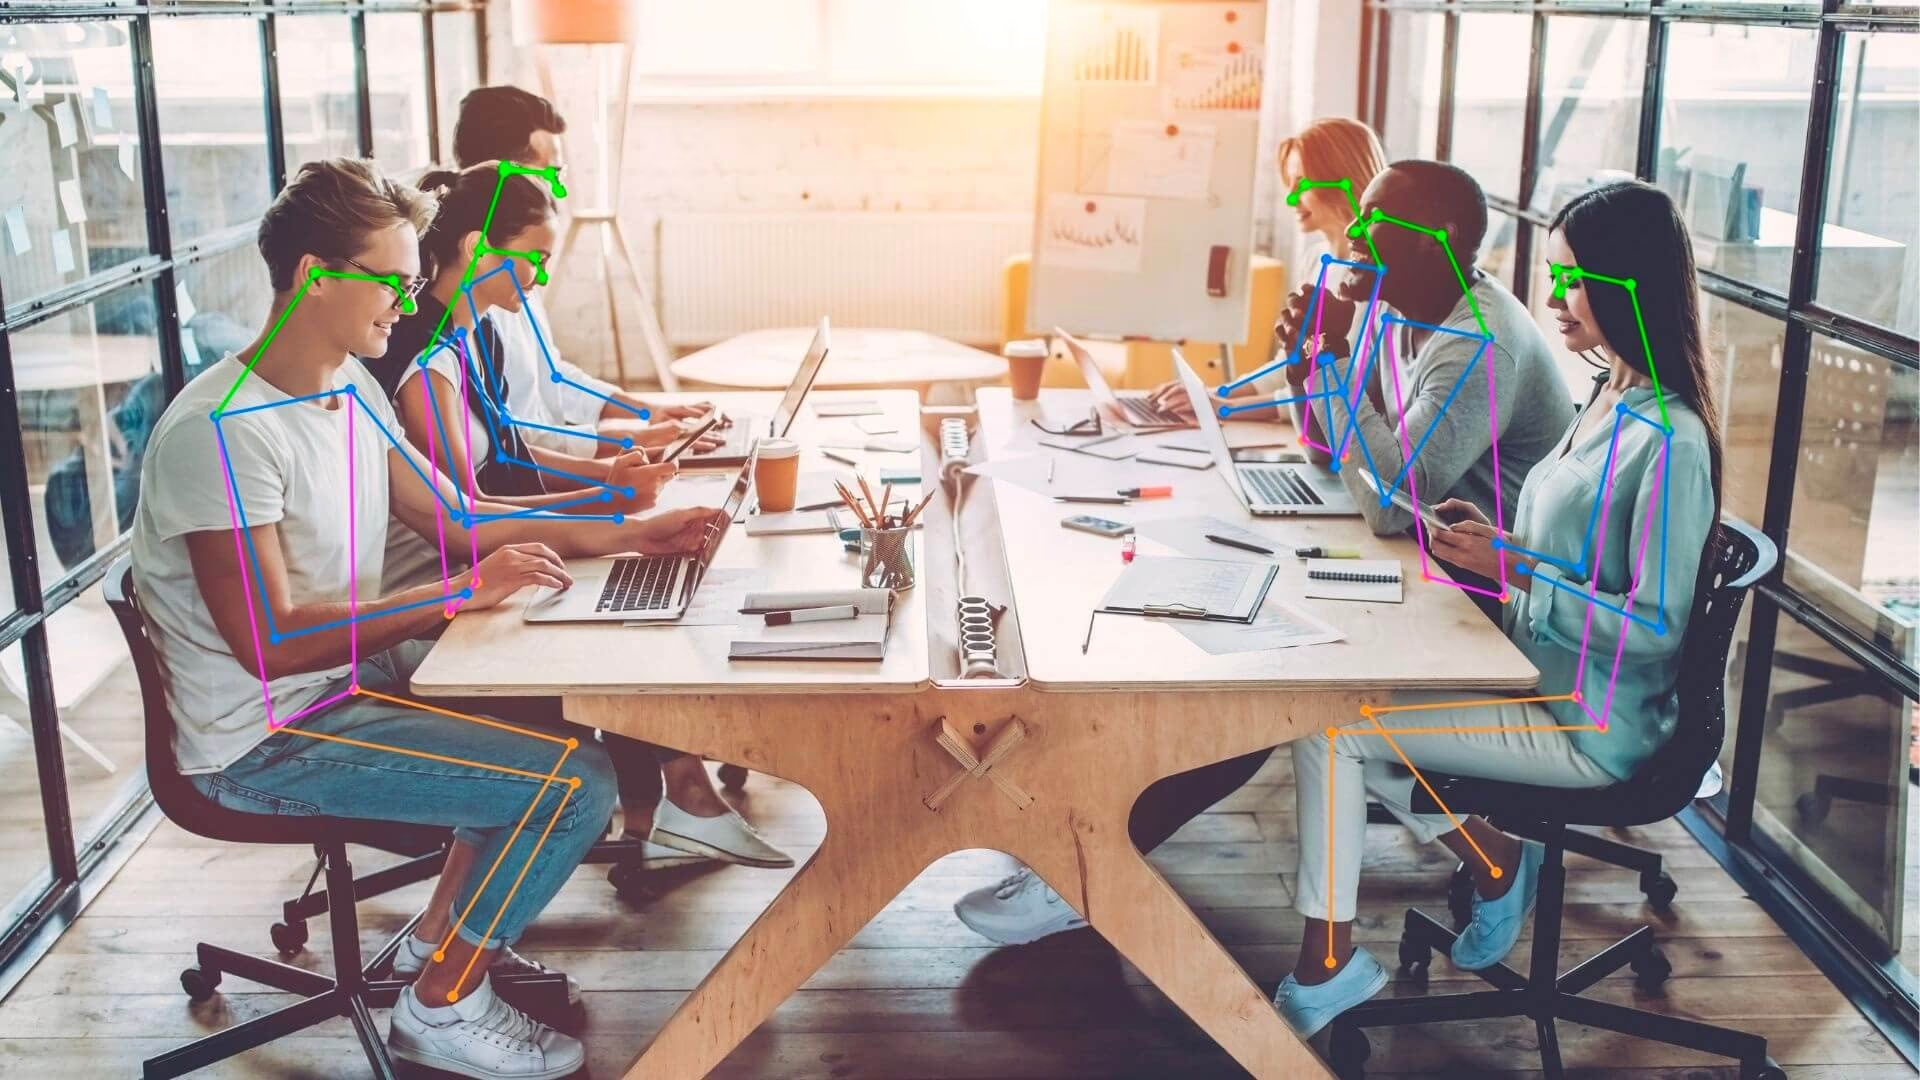
Vortrainierte COCO-Pose-Modelle#
| Modell | Größe (Pixel) | mAPpose 50-95(e2e) | mAPpose 50(e2e) | Geschwindigkeit CPU ONNX (ms) | Geschwindigkeit T4 TensorRT10 (ms) | Parameter (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-pose | 640 | 57.2 | 83.3 | 40.3 ± 0.5 | 1.8 ± 0.0 | 2.9 | 7.6 |
| YOLO26s-pose | 640 | 63.0 | 86.6 | 85.3 ± 0.9 | 2.7 ± 0.0 | 10.4 | 24.1 |
| YOLO26m-pose | 640 | 68.8 | 89.6 | 218.0 ± 1.5 | 5.0 ± 0.1 | 21.5 | 73.3 |
| YOLO26l-pose | 640 | 70.4 | 90.5 | 275.4 ± 2.4 | 6.5 ± 0.1 | 25.9 | 91.7 |
| YOLO26x-pose | 640 | 71.6 | 91.6 | 565.4 ± 3.0 | 12.2 ± 0.2 | 57.6 | 202.3 |
Wichtige Funktionen#
- COCO-Pose baut auf dem Wettbewerb COCO Keypoints 2017 auf, bei dem 1.710.498 einzelne Keypoints für 156.165 annotierte Personen beschriftet werden.
- Für jede Personenannotation werden 17 Keypoint-Typen verwendet – Nase, Augen, Ohren, Schultern, Ellbogen, Handgelenke, Hüften, Knie und Knöchel –, die als Tripel
(x, y, visibility)gespeichert werden. - Wie COCO bietet der Datensatz standardisierte Bewertungsmetriken, darunter die Ähnlichkeit von Objekt-Keypoints (OKS) für Posenschätzungsaufgaben. Dadurch eignet er sich zum Vergleich der Modellleistung.
- Downloadgröße: ~20.2 GB bei der ersten Verwendung (
train2017.zip+val2017.zip+ Beschriftungen). Die 7 GB große Dateitest2017.zipwird nicht automatisch heruntergeladen, da die zugehörigen Bilder zurückgehaltene Ground-Truth-Daten haben und nur für eine test-dev2017-Einreichung benötigt werden.
Datensatzstruktur#
Für das Training und die Validierung umfasst COCO-Pose nur COCO-2017-Bilder mit Personen, die mit Keypoints annotiert sind. Daher sind die beschrifteten Teilmengen kleiner als beim vollständigen COCO-Datensatz. Die YAML-Datei definiert drei Teilmengen:
- Train2017: Diese Teilmenge umfasst 56.599 Bilder aus dem COCO-Datensatz, die für das Training von Posenschätzungsmodellen annotiert wurden.
- Val2017: Diese Teilmenge umfasst 2.346 Bilder, die während des Modelltrainings zur Validierung verwendet werden.
- Test-dev2017: Eine Teilmenge mit 20.288 Bildern aus dem vollständigen Test2017-Datensatz mit 40.670 Bildern, für die die Ground-Truth-Daten zurückgehalten werden. Die YAML-Datei des Datensatzes verweist für diese Teilmenge auf den COCO-Test-dev-Keypoints-Auswertungsserver.
Bei einem Trainingsumfang dieser Größe ist die Ultralytics Platform besonders hilfreich: Sie verwaltet die Rechenressourcen, sodass du Trainingsläufe starten und überwachen kannst, ohne eigene GPUs bereitzustellen.
Anwendungsfälle#
Der COCO-Pose-Datensatz dient speziell zum Trainieren und Bewerten von Modellen für Deep Learning, die Keypoints erkennen und Posen schätzen. Dank der großen Zahl annotierter Bilder und der standardisierten Bewertungsmetriken ist der Datensatz eine wichtige Ressource für Forschende und Praktiker im Bereich Computer Vision, die sich mit menschlichen Posen befassen.
YAML-Datei des Datensatzes#
Zur Definition der Datensatzkonfiguration wird eine YAML-Datei verwendet. Sie enthält Informationen zu den Pfaden, Klassen und weiteren relevanten Merkmalen des Datensatzes. Beim COCO-Pose-Datensatz wird die Datei coco-pose.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco-pose.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 Keypoints dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/pose/coco
# Example usage: yolo train data=coco-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco-pose ← downloads here (20.2 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco-pose # dataset root dir
train: train2017.txt # train images (relative to 'path') 56599 images
val: val2017.txt # val images (relative to 'path') 2346 images
test: test-dev2017.txt # 20288 of 40670 images, submit to https://codalab.lisn.upsaclay.fr/competitions/7403

# Keypoints
kpt_shape: [17, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)
flip_idx: [0, 2, 1, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11, 14, 13, 16, 15]

# Classes
names:
  0: person

# Keypoint names per class
kpt_names:
  0:
    - nose
    - left_eye
    - right_eye
    - left_ear
    - right_ear
    - left_shoulder
    - right_shoulder
    - left_elbow
    - right_elbow
    - left_wrist
    - right_wrist
    - left_hip
    - right_hip
    - left_knee
    - right_knee
    - left_ankle
    - right_ankle

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  dir = Path(yaml["path"])  # dataset root dir

  urls = [f"{ASSETS_URL}/coco2017labels-pose.zip"]
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the CodaLab test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Verwendung#
Um ein YOLO26n-pose-Modell mit einer Bildgröße von 640 über 100 Epochen auf dem COCO-Pose-Datensatz zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-pose.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="coco-pose.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Der COCO-Pose-Datensatz enthält eine vielfältige Auswahl an Bildern mit menschlichen Figuren, die mit Schlüsselpunkten annotiert sind. Hier sind einige Beispielbilder aus dem Datensatz mit den zugehörigen Annotationen:
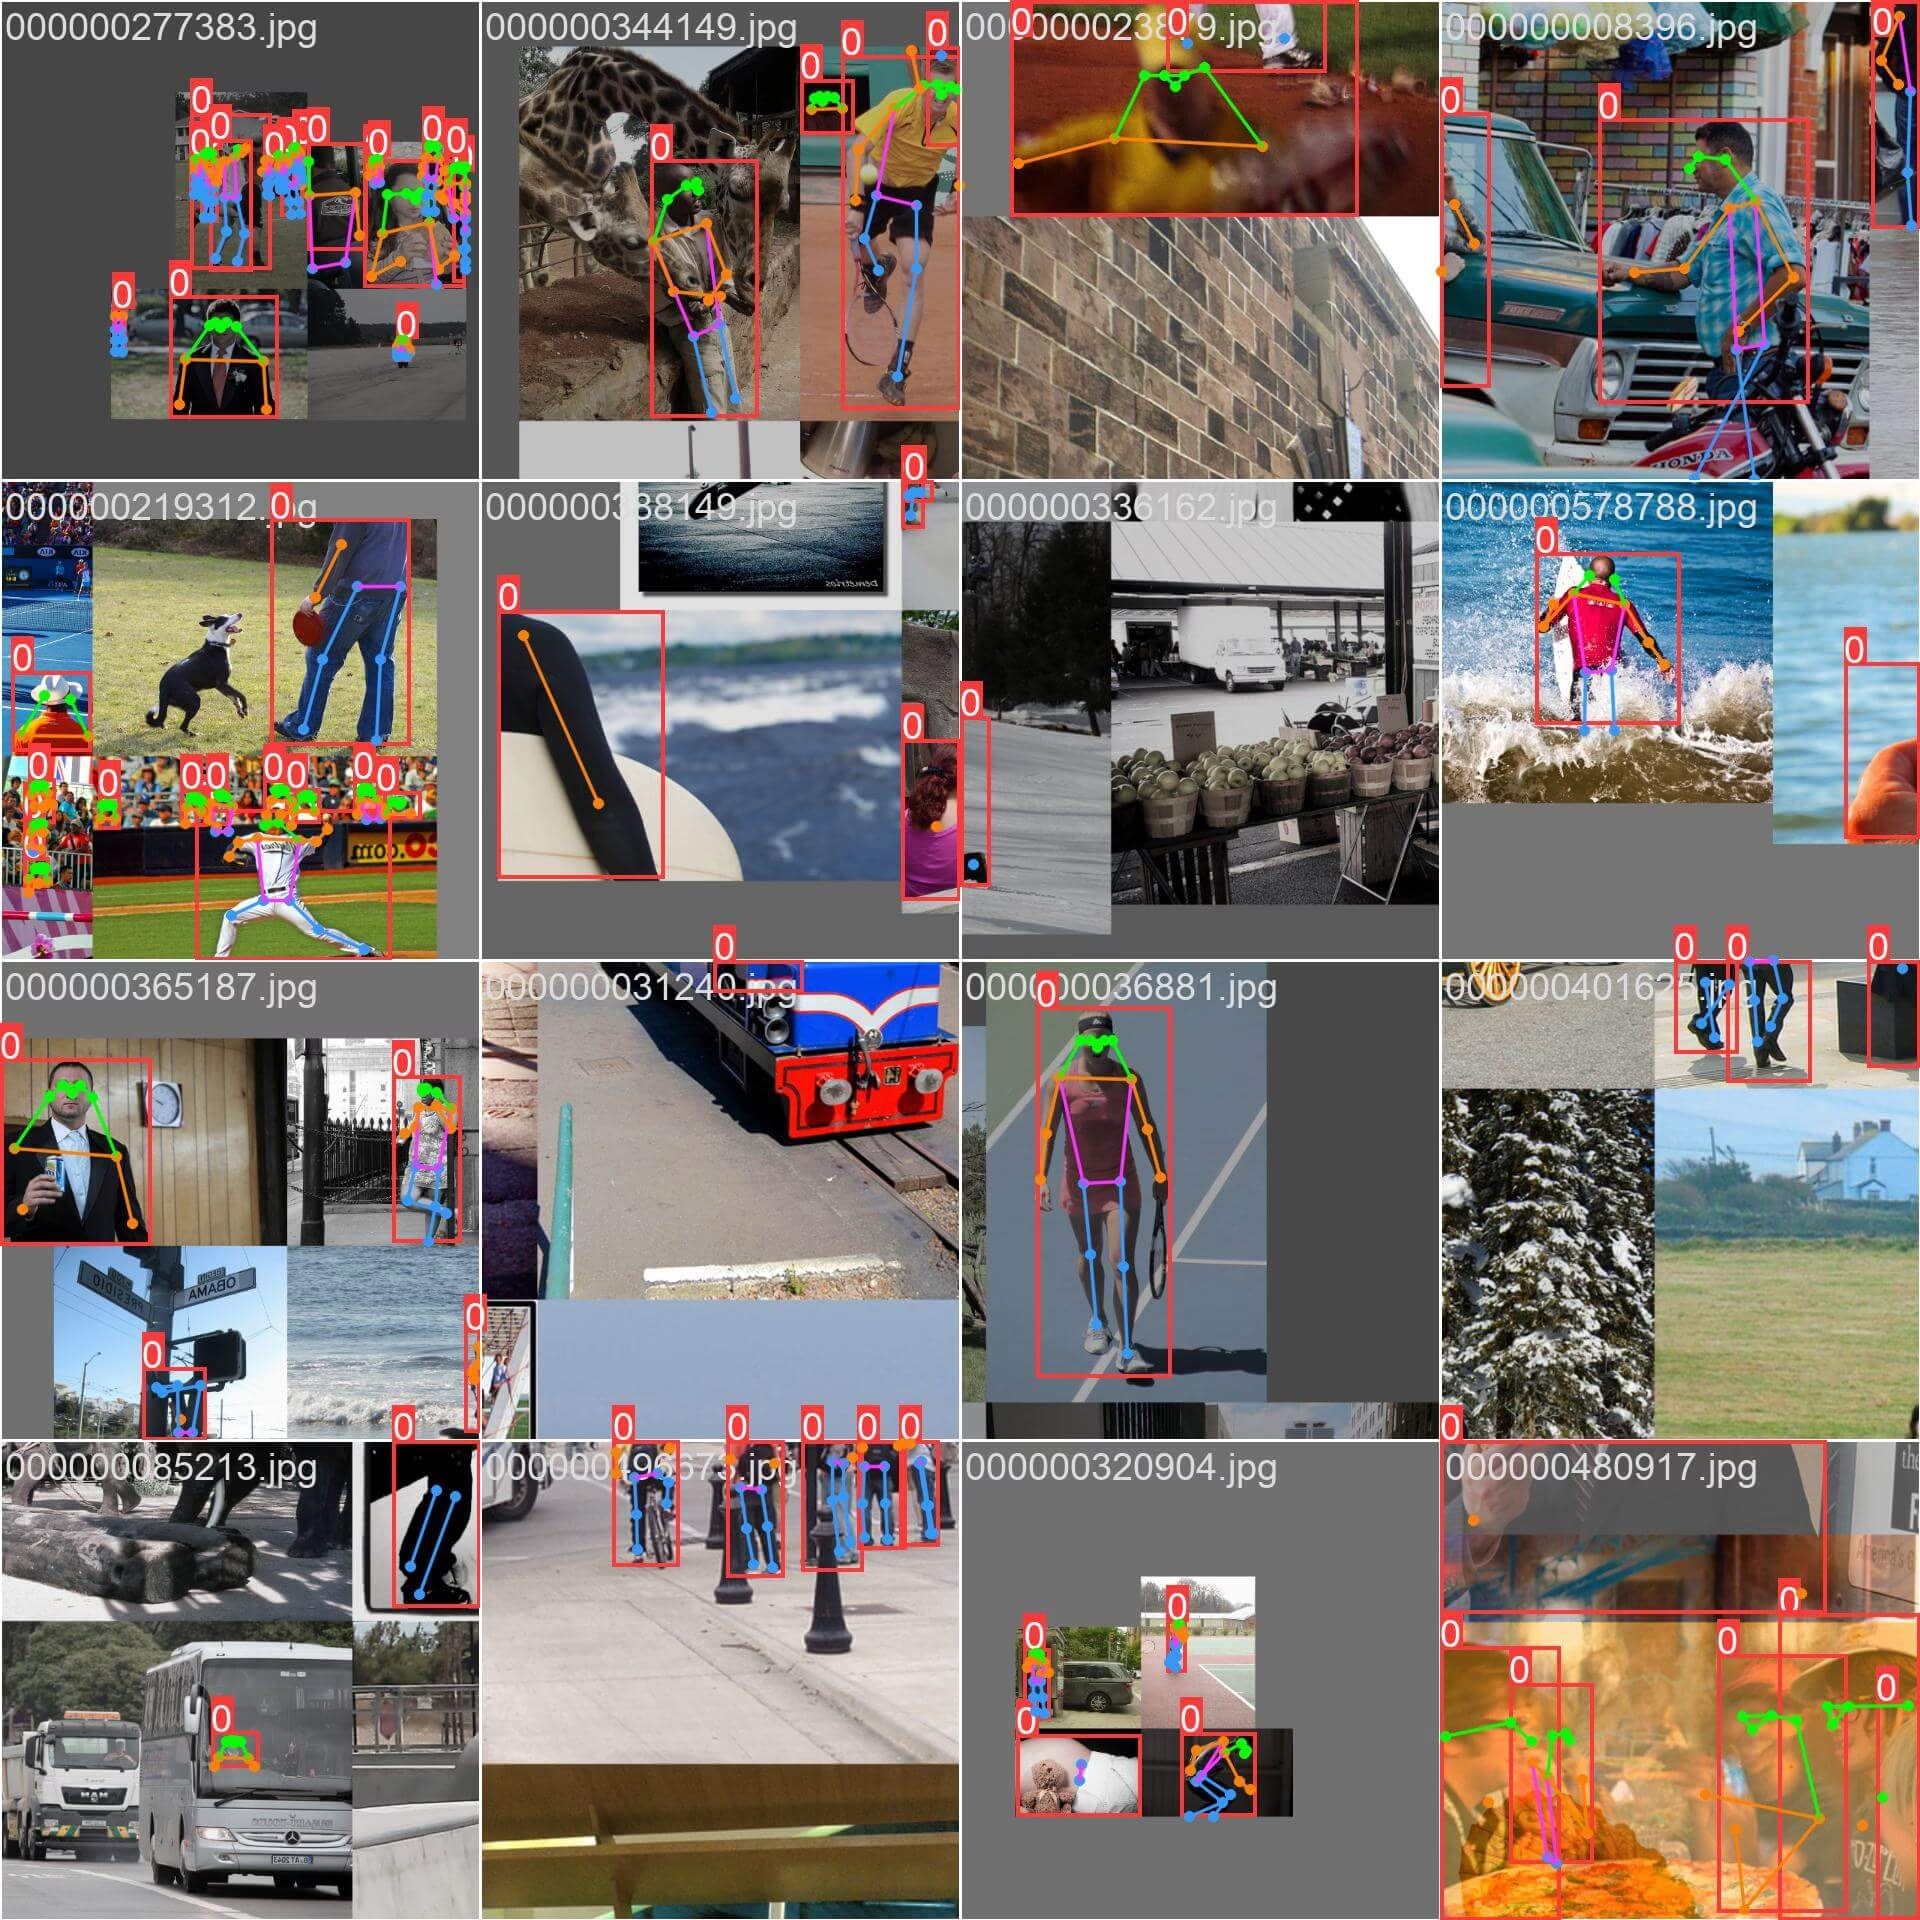
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig kombinierten Datensatzbildern. Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dadurch kann das Modell besser auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte generalisieren.
Das Beispiel veranschaulicht die Vielfalt und Komplexität der Bilder im COCO-Pose-Datensatz sowie die Vorteile des Mosaikverfahrens während des Trainings.
Zitate und Danksagungen#
Wenn du den COCO-Pose-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Wir möchten dem COCO Consortium dafür danken, dass es diese wertvolle Ressource für die Computer-Vision-Community geschaffen hat und pflegt. Weitere Informationen zum COCO-Pose-Datensatz und seinen Urhebern findest du auf der COCO-Datensatz-Website.
Häufig gestellte Fragen#
COCO-Pose stellt die Bilder und Annotationen von COCO Keypoints 2017 im YOLO-Schlüsselpunkteformat bereit. Dabei wird ein Schema mit 17 Schlüsselpunkten für 58.945 Bilder verwendet. Verweise ein beliebiges Ultralytics-YOLO-Pose-Modell mit
data=coco-pose.yamlauf den Datensatz. Auf der Seite Training findest du alle Argumente, die du anschließend anpassen kannst.Lade
yolo26n-pose.ptund rufemodel.train(data="coco-pose.yaml", epochs=100, imgsz=640)auf – im obigen Trainingsbeispiel findest du die vollständigen Python- und CLI-Codeausschnitte. Eine umfassende Liste der Argumente enthält die Trainingsseite.Der COCO-Pose-Datensatz stellt mehrere standardisierte Kennzahlen zur Bewertung von Aufgaben der Pose-Schätzung bereit, ähnlich wie der ursprüngliche COCO-Datensatz. Zu den wichtigsten Kennzahlen gehört die Ähnlichkeit der Objekt-Schlüsselpunkte (OKS), die die Genauigkeit der vorhergesagten Schlüsselpunkte anhand der Ground-Truth-Annotationen bewertet. Diese Kennzahlen ermöglichen gründliche Leistungsvergleiche zwischen verschiedenen Modellen. Für vortrainierte Modelle mit COCO-Pose, etwa YOLO26n-pose, YOLO26s-pose und andere, sind in der Dokumentation spezifische Leistungskennzahlen aufgeführt, zum Beispiel mAPpose50-95 und mAPpose50.
COCO-Pose umfasst zwei annotierte Teilmengen: 56.599 Bilder aus train2017 und 2.346 Bilder aus val2017. Eine dritte Teilmenge, test-dev2017 (20.288 der insgesamt 40.670 Bilder aus test2017), hält die Ground Truth geheim. Die YAML-Datei des Datensatzes verweist auf den COCO-Test-dev-Server zur Bewertung von Schlüsselpunkten. Im Abschnitt Datensatzstruktur oder in der Datei
coco-pose.yamlauf GitHub findest du die genauen Pfade der Teilmengen.COCO-Pose verwendet 17 Arten menschlicher Schlüsselpunkte und übernimmt COCOs standardisierte Kennzahlen, darunter die Ähnlichkeit der Objekt-Schlüsselpunkte (OKS), um Modelle miteinander zu vergleichen. Diese Kombination eignet sich für Anwendungen zur menschlichen Pose-Schätzung, etwa in der Sportanalyse, im Gesundheitswesen und bei der Mensch-Computer-Interaktion. Vortrainierte Gewichte für YOLO26-pose sind unter Vortrainierte COCO-Pose-Modelle aufgeführt.
Weitere Informationen zu Schlüsselpunktemodellen findest du in der Dokumentation zur Aufgabe Pose-Schätzung.