Optimierung der OpenVINO-Inferenz für YOLO#
Einführung#
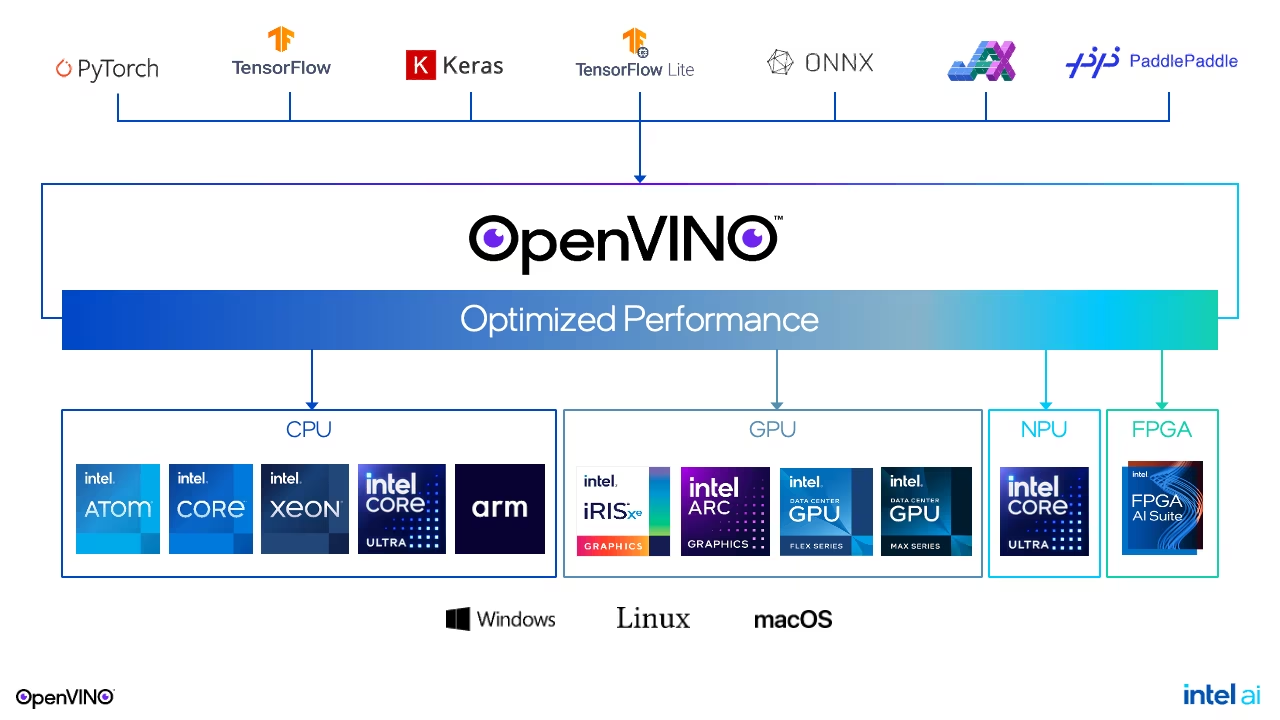
Beim Bereitstellen von Deep-Learning-Modellen, insbesondere für die Objekterkennung wie die Ultralytics-YOLO-Modelle, ist eine optimale Leistung entscheidend. Diese Anleitung erläutert, wie du das OpenVINO-Toolkit von Intel zur Optimierung der Inferenz nutzen kannst, wobei der Schwerpunkt auf Latenz und Durchsatz liegt. Ganz gleich, ob du an Anwendungen für Endverbraucher oder an groß angelegten Bereitstellungen arbeitest: Wenn du diese Optimierungsstrategien verstehst und anwendest, stellst du sicher, dass deine Modelle auf verschiedenen Geräten effizient laufen.
Latenz optimieren#
Die Latenzoptimierung ist entscheidend für Anwendungen, die eine sofortige Antwort eines einzelnen Modells auf eine einzelne Eingabe benötigen, wie es typischerweise bei Anwendungen für Endverbraucher der Fall ist. Ziel ist es, die Verzögerung zwischen der Eingabe und dem Inferenzergebnis zu minimieren. Eine niedrige Latenz zu erreichen, erfordert jedoch sorgfältige Überlegungen, insbesondere bei gleichzeitig ausgeführten Inferenzen oder der Verwaltung mehrerer Modelle.
Wichtige Strategien zur Latenzoptimierung#
- Eine Inferenz pro Gerät: Die einfachste Methode, eine niedrige Latenz zu erreichen, besteht darin, die Verarbeitung auf eine Inferenz gleichzeitig pro Gerät zu beschränken. Zusätzliche gleichzeitige Verarbeitung führt häufig zu höherer Latenz.
- Teilgeräte nutzen: Geräte wie CPUs mit mehreren Sockeln oder GPUs mit mehreren Kacheln können mehrere Anfragen mit minimaler Latenzsteigerung verarbeiten, indem sie ihre internen Teilgeräte nutzen.
- OpenVINO-Leistungshinweise: Wenn du beim Kompilieren des Modells OpenVINOs
ov::LATENCYfür die Eigenschaftov::performance_modeverwendest, wird die Leistungsoptimierung vereinfacht und ist geräteunabhängig sowie zukunftssicher.
Latenz der ersten Inferenz verwalten#
- Modell-Caching: Um zu verhindern, dass Lade- und Kompilierungszeiten des Modells die Latenz erhöhen, solltest du nach Möglichkeit Modell-Caching verwenden. Wenn Caching nicht möglich ist, bieten CPUs im Allgemeinen die kürzesten Ladezeiten für Modelle.
- Modellzuordnung statt Einlesen: Um die Ladezeiten zu verkürzen, hat OpenVINO das Einlesen von Modellen durch deren Zuordnung ersetzt. Liegt das Modell jedoch auf einem Wechseldatenträger oder Netzlaufwerk, kannst du mit
ov::enable_mmap(false)wieder zum Einlesen wechseln. - AUTO-Geräteauswahl: Dieser Modus beginnt die Inferenz auf der CPU und wechselt zu einem Beschleuniger, sobald dieser bereit ist. Dadurch wird die Latenz der ersten Inferenz nahtlos reduziert.
Durchsatz optimieren#
Die Durchsatzoptimierung ist entscheidend für Szenarien, in denen zahlreiche Inferenzanfragen gleichzeitig verarbeitet werden. So wird die Ressourcenauslastung maximiert, ohne die Leistung einzelner Anfragen wesentlich zu beeinträchtigen.
Ansätze zur Durchsatzoptimierung#
-
OpenVINO-Leistungshinweise: Eine allgemeine, zukunftssichere Methode, um den Durchsatz auf verschiedenen Geräten mithilfe von Leistungshinweisen zu steigern.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Explizite Stapelverarbeitung und Streams: Ein detaillierterer Ansatz, bei dem explizite Stapelverarbeitung und Streams zur fortgeschrittenen Leistungsoptimierung eingesetzt werden.
Anwendungen auf hohen Durchsatz auslegen#
Um den Durchsatz zu maximieren, sollten Anwendungen:
- Eingaben parallel verarbeiten und die Fähigkeiten des Geräts vollständig nutzen.
- Den Datenfluss in gleichzeitige Inferenzanfragen aufteilen, die zur parallelen Ausführung eingeplant werden.
- Die Async API mit Rückruffunktionen nutzen, um die Effizienz aufrechtzuerhalten und Leerlauf des Geräts zu vermeiden.
Ausführung auf mehreren Geräten#
Der Mehrgerätemodus von OpenVINO vereinfacht die Skalierung des Durchsatzes, indem er Inferenzanfragen automatisch auf mehrere Geräte verteilt, ohne dass die Anwendung die Geräte verwalten muss.
Leistungssteigerungen in der Praxis#
Die Anwendung von OpenVINO-Optimierungen auf Ultralytics-YOLO-Modelle kann die Leistung erheblich steigern. Wie Benchmarks zeigen, können Nutzende auf Intel-CPUs bis zu dreimal schnellere Inferenzen erzielen. Noch größere Beschleunigungen sind auf dem gesamten Intel-Hardwareangebot möglich, einschließlich integrierter GPUs, dedizierter GPUs und NPUs.
Bei der Ausführung von YOLO26-Modellen auf Intel-Xeon-CPUs sind die für OpenVINO optimierten Versionen beispielsweise hinsichtlich der Inferenzzeit pro Bild durchgehend schneller als ihre PyTorch-Pendants, ohne dass die Genauigkeit darunter leidet.
Praktische Umsetzung#
Um dein Ultralytics-YOLO-Modell für OpenVINO zu exportieren und zu optimieren, kannst du die Funktion Export verwenden:
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")

# Modell ins OpenVINO-Format exportieren
model.export(format="openvino", quantize=16)  # Mit FP16-Präzision exportieren
Nach dem Export kannst du mit dem optimierten Modell Inferenzen ausführen:
# OpenVINO-Modell laden
ov_model = YOLO("yolo26n_openvino_model/")

# Inferenz ausführen (Ultralytics kompiliert OpenVINO-Modelle mit dem Leistungshinweis LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Fazit#
Die Optimierung von Ultralytics-YOLO-Modellen für Latenz und Durchsatz mit OpenVINO kann die Leistung deiner Anwendung deutlich verbessern. Wenn Entwicklerinnen und Entwickler die in dieser Anleitung beschriebenen Strategien sorgfältig anwenden, können sie sicherstellen, dass ihre Modelle effizient laufen und die Anforderungen verschiedener Bereitstellungsszenarien erfüllen. Beachte, dass die Entscheidung zwischen der Optimierung auf Latenz oder Durchsatz von den Anforderungen deiner Anwendung und den Eigenschaften der Bereitstellungsumgebung abhängt.
Ausführliche technische Informationen und die neuesten Aktualisierungen findest du in der OpenVINO-Dokumentation und im Ultralytics-YOLO-Repository. Diese Ressourcen bieten ausführliche Anleitungen, Tutorials und Unterstützung durch die Community, damit du das Beste aus deinen Deep-Learning-Modellen herausholen kannst.
Um sicherzustellen, dass deine Modelle optimal laufen, reicht es nicht aus, Konfigurationen anzupassen. Du musst die Anforderungen deiner Anwendung verstehen und fundierte Entscheidungen treffen. Ganz gleich, ob du Echtzeitreaktionen optimierst oder den Durchsatz bei groß angelegter Verarbeitung maximierst: Die Kombination aus Ultralytics-YOLO-Modellen und OpenVINO bietet Entwicklerinnen und Entwicklern leistungsstarke Werkzeuge zur Bereitstellung leistungsfähiger KI-Lösungen.
Häufig gestellte Fragen#
Die Optimierung von Ultralytics-YOLO-Modellen für geringe Latenz umfasst mehrere wichtige Strategien:
- Eine Inferenz pro Gerät: Beschränke Inferenzen auf eine gleichzeitig pro Gerät, um Verzögerungen zu minimieren.
- Teilgeräte nutzen: Nutze Geräte wie CPUs mit mehreren Sockeln oder GPUs mit mehreren Kacheln, die mehrere Anfragen mit minimaler Latenzsteigerung verarbeiten können.
- OpenVINO-Leistungshinweise: Verwende beim Kompilieren des Modells OpenVINOs
ov::LATENCY, um die Optimierung zu vereinfachen und geräteunabhängig zu gestalten.
Weitere praktische Tipps zur Latenzoptimierung findest du im Abschnitt Latenzoptimierung unserer Anleitung.
OpenVINO steigert den Durchsatz von Ultralytics-YOLO-Modellen, indem es die Ressourcenauslastung der Geräte maximiert, ohne die Leistung zu beeinträchtigen. Zu den wichtigsten Vorteilen gehören:
- Leistungshinweise: Einfache, allgemeine Leistungsoptimierung für verschiedene Geräte.
- Explizite Stapelverarbeitung und Streams: Feinabstimmung für eine fortgeschrittene Leistungsoptimierung.
- Ausführung auf mehreren Geräten: Automatischer Ausgleich der Inferenzlast, der die Verwaltung auf Anwendungsebene vereinfacht.
Beispielkonfiguration:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Weitere Informationen zur Durchsatzoptimierung findest du im Abschnitt Durchsatzoptimierung unserer ausführlichen Anleitung.
Beachte die folgenden Maßnahmen, um die Latenz der ersten Inferenz zu verringern:
- Modell-Caching: Verwende Modell-Caching, um Lade- und Kompilierungszeiten zu verkürzen.
- Modellzuordnung statt Einlesen: Verwende standardmäßig die Zuordnung (
ov::enable_mmap(true)), wechsle aber zum Einlesen (ov::enable_mmap(false)), wenn sich das Modell auf einem Wechseldatenträger oder Netzlaufwerk befindet. - AUTO-Geräteauswahl: Verwende den AUTO-Modus, um die Inferenz auf der CPU zu starten und nahtlos zu einem Beschleuniger zu wechseln.
Ausführliche Strategien zur Verwaltung der Latenz der ersten Inferenz findest du im Abschnitt Latenz der ersten Inferenz verwalten.
Um Latenz und Durchsatz ausgewogen zu optimieren, musst du die Anforderungen deiner Anwendung verstehen:
- Latenzoptimierung: Ideal für Echtzeitanwendungen, die sofortige Antworten erfordern (z. B. Apps für Endverbraucher).
- Durchsatzoptimierung: Am besten geeignet für Szenarien mit vielen gleichzeitigen Inferenzen, bei denen die Ressourcennutzung maximiert werden soll (z. B. groß angelegte Bereitstellungen).
Mit den allgemeinen Leistungshinweisen und Mehrgerätemodi von OpenVINO kannst du die richtige Balance finden. Wähle die passenden OpenVINO-Leistungshinweise entsprechend deinen Anforderungen.
Ja, Ultralytics-YOLO-Modelle sind sehr vielseitig und lassen sich in verschiedene KI-Frameworks integrieren. Dazu gehören:
- TensorRT: Für die Optimierung auf NVIDIA-GPUs befolge die TensorRT-Integrationsanleitung.
- CoreML: Für Apple-Geräte findest du weitere Informationen in unserer Anleitung zum CoreML-Export.
- LiteRT.js: Für Web- und Node.js-Apps findest du weitere Informationen in der LiteRT-Integrationsanleitung und in der LiteRT.js-Weblaufzeitumgebung.
Weitere Integrationen findest du auf der Ultralytics-Integrationsseite.