Thread-sichere Inferenz mit YOLO-Modellen
Um Ultralytics YOLO-Inferenz sicher über Python-Threads hinweg auszuführen, erstelle in jedem Thread ein eigenes YOLO-Modell, statt eine Instanz gemeinsam zu verwenden. Die gemeinsame Verwendung eines einzelnen Modells führt zu Wettlaufsituationen, die seinen internen Zustand beschädigen und unvorhersehbare Ergebnisse verursachen, da das Python-Modul threading die Threads gleichzeitig auf dasselbe Objekt zugreifen lässt. Diese Anleitung erklärt, warum die gemeinsame Nutzung fehlschlägt, zeigt das sichere Muster mit einer Instanz pro Thread und behandelt den Dekorator ThreadingLocked für Fälle, in denen du eine Instanz gemeinsam verwenden musst.
Springe zu den Gründen, warum die gemeinsame Nutzung eines Modells fehlschlägt, zum thread-sicheren Muster oder zum ThreadingLocked-Dekorator.
Ansehen: So führst du threadsichere Inferenz mit Ultralytics YOLO-Modellen in Python aus | Multithreading 🚀
Python-Threading verstehen#
Mit Python-Threads kann dein Programm mehrere Vorgänge gleichzeitig ausführen. Die globale Interpretersperre (GIL) von Python sorgt jedoch dafür, dass jeweils nur ein Thread Python-Bytecode ausführen kann.
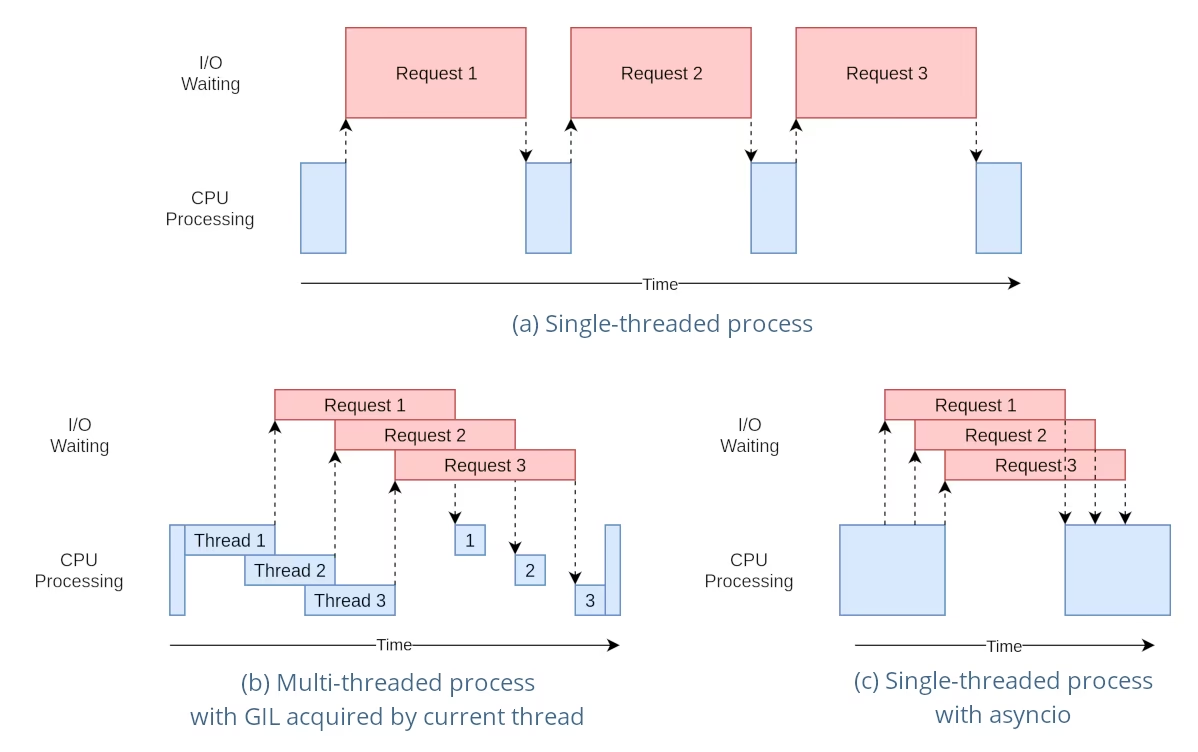
Auch wenn das nach einer Einschränkung klingt, können Threads weiterhin gleichzeitige Verarbeitung ermöglichen, insbesondere bei E/A-gebundenen Vorgängen oder bei Vorgängen, die den GIL freigeben, wie etwa bei den zugrunde liegenden C-Bibliotheken von YOLO.
Die Gefahr gemeinsam genutzter Modellinstanzen#
Wenn du ein YOLO-Modell außerhalb deiner Threads instanziierst und diese Instanz in mehreren Threads gemeinsam verwendest, kann es zu Wettlaufsituationen kommen. Dabei wird der interne Zustand des Modells durch gleichzeitige Zugriffe uneinheitlich verändert. Besonders problematisch ist dies, wenn das Modell oder seine Komponenten Zustände enthalten, die nicht für die Thread-Sicherheit ausgelegt sind.
Nicht thread-sicheres Beispiel: einzelne Modellinstanz#
Bei der Verwendung von Threads in Python solltest du Muster erkennen, die zu Problemen bei der gleichzeitigen Verarbeitung führen können. Folgendes solltest du vermeiden: die gemeinsame Nutzung einer einzelnen YOLO26-Modellinstanz in mehreren Threads.
# Unsicher: Eine einzelne Modellinstanz wird von mehreren Threads gemeinsam verwendet
from threading import Thread

from ultralytics import YOLO

# Das Modell außerhalb des Threads instanziieren
shared_model = YOLO("yolo26n.pt")

def predict(image_path):
    """Predicts objects in an image using a preloaded YOLO model, take path string to image as argument."""
    results = shared_model.predict(image_path)
    # Ergebnisse verarbeiten

# Threads starten, die dieselbe Modellinstanz verwenden
Thread(target=predict, args=("image1.jpg",)).start()
Thread(target=predict, args=("image2.jpg",)).start()
Im obigen Beispiel teilen sich beide Threads shared_model. Jeder Aufruf von predict behält seine eigenen Argumente wie conf, iou und imgsz, aber Aufrufe, die denselben Predictor verwenden, laufen wegen seiner Sperre nacheinander, sodass die Threads kaum von Parallelisierung profitieren. Zustand, der in der Instanz gespeichert ist, etwa der Tracker-Zustand, YOLOE-set_classes-Vokabulare oder Prompts für SAM, FastSAM und YOLOE, wird weiterhin von allen Threads gemeinsam genutzt. Verwende daher für solche Fälle eine eigene Instanz pro Thread.
Sicheres Beispiel: eine eigene Instanz pro Thread#
Mehrere separate Modellinstanzen sind unproblematisch, solange jeder Thread seine eigene Instanz besitzt und sie niemals mit einem anderen Thread teilt. Es spielt keine Rolle, dass die folgenden Instanzen vor dem Start der Threads erstellt werden – unsicher ist nur, eine einzelne Instanz über mehrere Threads hinweg gemeinsam zu verwenden:
# Sicher: Jeder Thread verwendet eine eigene Modellinstanz
from threading import Thread

from ultralytics import YOLO

# Ein Modell pro Thread instanziieren
model_1 = YOLO("yolo26n.pt")
model_2 = YOLO("yolo26n.pt")

def predict(model, image_path):
    """Runs prediction on an image using a specified YOLO model, returning the results."""
    results = model.predict(image_path)
    # Ergebnisse verarbeiten

# Jeder Thread verwendet eine separate, eigene Modellinstanz
Thread(target=predict, args=(model_1, "image1.jpg")).start()
Thread(target=predict, args=(model_2, "image2.jpg")).start()
Da jeder Thread mit seiner eigenen Instanz arbeitet, gibt es keinen gemeinsamen Modellzustand, den die Threads beschädigen könnten. Das Modell wie im nächsten Beispiel innerhalb jedes Threads zu instanziieren, ist einfach der leichteste Weg, um sicherzustellen, dass eine Instanz nicht versehentlich gemeinsam verwendet wird.
Threadsichere Inferenz#
Für eine thread-sichere Inferenz solltest du in jedem Thread ein eigenes YOLO-Modell instanziieren. So erhält jeder Thread eine isolierte Modellinstanz und das Risiko von Wettlaufsituationen entfällt.
Thread-sicheres Beispiel#
So instanziierst du für eine sichere parallele Inferenz in jedem Thread ein YOLO-Modell:
# Sicher: Eine einzelne Modellinstanz in jedem Thread instanziieren
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image using a new YOLO model instance in a thread-safe manner; takes image path as input."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Ergebnisse verarbeiten

# Threads starten, die jeweils eine eigene Modellinstanz haben
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
In diesem Beispiel erstellt jeder Thread eine eigene YOLO-Instanz. Dadurch kann kein Thread den Modellzustand eines anderen Threads beeinflussen. So führt jeder Thread sicher Inferenz aus, ohne unerwartete Wechselwirkungen mit den anderen Threads.
Den ThreadingLocked-Dekorator verwenden#
Ultralytics stellt einen ThreadingLocked-Dekorator bereit, mit dem sich die thread-sichere Ausführung von Funktionen sicherstellen lässt. Der Dekorator verwendet eine Sperre, damit immer nur ein Thread gleichzeitig die dekorierte Funktion ausführen kann.
from ultralytics import YOLO
from ultralytics.utils import ThreadingLocked

# Eine Modellinstanz erstellen
model = YOLO("yolo26n.pt")

# Die Vorhersagefunktion dekorieren, damit sie thread-sicher ist
@ThreadingLocked()
def thread_safe_predict(image_path):
    """Thread-safe prediction using a shared model instance."""
    results = model.predict(image_path)
    return results

# Jetzt kannst du diese Funktion sicher aus mehreren Threads aufrufen
Der Dekorator ThreadingLocked ist besonders nützlich, wenn du eine Modellinstanz über mehrere Threads hinweg gemeinsam verwenden musst, aber sicherstellen möchtest, dass immer nur ein Thread gleichzeitig darauf zugreifen kann.
Wenn du eine einzelne, gesperrte Modellinstanz gemeinsam verwendest, sparst du Speicher, verglichen mit dem Laden eines Modells in jedem Thread. Gleichzeitig verringerst du die Parallelität, weil die Threads durch die Sperre nacheinander arbeiten und warten müssen, bis sie an der Reihe sind. Verwende das Muster mit einer Instanz pro Thread, wenn genügend Speicher vorhanden ist und du maximale Parallelität möchtest. Greife auf ThreadingLocked zurück, wenn der Modellspeicher zum Engpass wird.
Fazit#
Wenn du YOLO-Modelle mit Pythons threading verwendest, gib jedem Thread eine eigene Modellinstanz und verwende niemals dieselbe Instanz in mehreren Threads. Das Modell in dem Thread zu instanziieren, der es verwendet, ist der einfachste Weg, dies sicherzustellen. So vermeidest du Wettlaufsituationen und sorgst für zuverlässige Inferenzaufgaben.
Für anspruchsvollere Anwendungsfälle und zur weiteren Optimierung der Leistung deiner parallelen Inferenz kannst du die prozessbasierte Parallelverarbeitung mit multiprocessing oder eine Aufgabenwarteschlange mit eigenen Worker-Prozessen nutzen.
Häufig gestellte Fragen#
Um Wettlaufsituationen bei der Verwendung von Ultralytics YOLO-Modellen in einer multithreadfähigen Python-Umgebung zu vermeiden, erstelle in jedem Thread eine eigene YOLO-Modellinstanz. Dadurch erhält jeder Thread eine eigene, isolierte Modellinstanz, sodass gleichzeitige Änderungen am Modellzustand vermieden werden.
Beispiel:
from threading import Thread from ultralytics import YOLO def thread_safe_predict(image_path): """Predict on an image in a thread-safe manner.""" local_model = YOLO("yolo26n.pt") results = local_model.predict(image_path) # Ergebnisse verarbeiten Thread(target=thread_safe_predict, args=("image1.jpg",)).start() Thread(target=thread_safe_predict, args=("image2.jpg",)).start()Beachte die folgenden Best Practices, um YOLO-Modellinferenz sicher mit mehreren Threads in Python auszuführen:
- Instanziiere YOLO-Modelle in jedem Thread, statt eine einzelne Modellinstanz über mehrere Threads hinweg gemeinsam zu verwenden.
- Verwende Pythons Modul
multiprocessingfür die parallele Verarbeitung, um Probleme im Zusammenhang mit dem Global Interpreter Lock (GIL) zu vermeiden. - Beachte, dass die zugrunde liegenden C-Bibliotheken von YOLO (PyTorch, OpenCV) den GIL während rechenintensiver Vorgänge automatisch freigeben. Daher können Threads weiterhin gleichzeitig Inferenz ausführen.
- Wenn der Speicherverbrauch eine Rolle spielt, kannst du für gemeinsam genutzte Modellinstanzen den Dekorator
ThreadingLockedverwenden.
Beispiel für das threadsichere Instanziieren eines Modells:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Runs inference in a thread-safe manner with a new YOLO model instance."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Ergebnisse verarbeiten

# Mehrere Threads starten
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Weitere Informationen findest du im Abschnitt Thread-sichere Inferenz.
Jeder Thread sollte eine eigene YOLO-Modellinstanz haben, um Wettlaufsituationen zu verhindern. Wird eine einzelne Modellinstanz von mehreren Threads gemeinsam verwendet, können gleichzeitige Zugriffe zu unvorhersehbarem Verhalten und Änderungen am internen Zustand des Modells führen. Separate Instanzen sorgen für eine Isolation der Threads und machen deine mehrthreadigen Aufgaben zuverlässig und sicher.
Ausführliche Hinweise findest du in den Abschnitten Nicht thread-sicheres Beispiel: einzelne Modellinstanz und Thread-sicheres Beispiel.
Pythons Global Interpreter Lock (GIL) lässt immer nur einen Thread gleichzeitig Python-Bytecode ausführen. Das kann die Leistung mehrthreadiger, CPU-gebundener Aufgaben einschränken. Bei E/A-gebundenen Vorgängen oder Prozessen, die Bibliotheken verwenden, welche den GIL freigeben, wie etwa die zugrunde liegenden C-Bibliotheken von YOLO, ist jedoch weiterhin eine gleichzeitige Verarbeitung möglich. Für eine höhere Leistung kannst du die prozessbasierte Parallelverarbeitung mit Pythons Modul
multiprocessingin Betracht ziehen.Weitere Informationen zu Threads in Python findest du im Abschnitt Python-Threading verstehen.
Ja, Pythons Modul
multiprocessingist sicherer und oft effizienter, wenn du Inferenz mit YOLO-Modellen parallel ausführen möchtest. Bei der prozessbasierten Parallelverarbeitung werden separate Speicherbereiche verwendet. Dadurch wird der Global Interpreter Lock (GIL) umgangen und das Risiko von Problemen bei der gleichzeitigen Verarbeitung verringert. Jeder Prozess arbeitet unabhängig mit einer eigenen YOLO-Modellinstanz.


Kommentare12
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
amani784
I used a YOLOv8 model optimized with TensorRT on an AWS machine with a Tesla T4 GPU to detect people in multiple videos. The model is loaded once per process using an initializer function. To improve performance, I parallelized the video processing using 4 processes from the multiprocessing module, where each process handles one video and performs inference using model.predict() on frames sampled at regular intervals. However, this approach led to a decrease in overall performance, with slower processing time per frame and reduced FPS. Is this normal, and if not, what is the solution?
warptengood
I have a few questions:
- Does the rules about thread-safety apply in the same way to TensorRT/ONNX inference of YOLO?
- Should I have the shared model for all threads when using TensorRT YOLO? (In case the answer for the 1st question is 'No'.)
- Is it true that it is better to have
streamparameter to be set toFalsewhen performing inference on TensorRT (inpredict()) - How
torch.cuda.Stream()affects the performance of multi-threading/multi-processing when used onpredict()/track()functions? - Should I have any sort of warm up for TensorRT inference before utilizing a model in any thread/process? (Like making inference on dummy input)
P.S: I want to thank all the Ultralytics team for their kindness and open-mindedness when it comes to help and support their community. You guys are always eager to help. And I don't care if it is some AI agent that's replying or a real person, I am very grateful for you for what you guys doing :D
 Glenn JocherUltralytics
@KenesYerassyl Thank you for your great questions about thread safety with TensorRT/ONNX models. Let me address each one:
-
Yes, the thread-safety principles apply similarly to TensorRT/ONNX models, but with important distinctions. TensorRT engines have their own memory management which can introduce additional concurrency concerns.
-
For TensorRT models, it's generally safer to use separate engine instances per thread or use a thread locking mechanism like our
ThreadingLockeddecorator. TensorRT engines maintain internal state during inference that can cause issues with concurrent access. -
Setting
stream=Falsefor TensorRT inference is often beneficial as it ensures complete processing of each input before handling another, which can help avoid resource conflicts in multi-threaded environments. -
Using
torch.cuda.Stream()with multi-threading can improve performance by allowing parallel execution of CUDA operations across different streams. However, you need to carefully manage synchronization points to prevent race conditions. Each thread should ideally use a separate CUDA stream. -
Yes, warming up TensorRT models is highly recommended. The first inference typically takes longer due to CUDA context initialization and memory allocations. Running inference on a dummy input before deploying in production or multi-threaded environments ensures consistent performance.
Thank you for your kind words about our team! We're committed to supporting the community with helpful resources and guidance.
-
Thank you very much for such a comprehensive reply!
mrbulb
Hello, is there any example code that uses Python's multiprocessing for YOLO model inference?
 Paula DerrengerUltralytics
@mrbulb for using Python's multiprocessing with YOLO model inference, you should instantiate a separate YOLO model within each process to avoid race conditions. This ensures each process has its own isolated model instance. For detailed guidance, please refer to our Thread-Safe Inference with YOLO Models page. If you need a specific code example, feel free to ask!
farrostaufiqur
how to use results differently for each thread?
- Paula DerrengerUltralytics
To use results differently for each thread, ensure each thread instantiates its own YOLO model instance. This prevents race conditions and ensures thread safety. For more details, please refer to our Thread-Safe Inference with YOLO Models guide.
ghost
Hello. Thanks for the info. I have a question, If I run in two terminals the same python script, but to two different videos, both processes still suffer from GIL ?
- Glenn JocherUltralytics
@cawilchesp running the same Python script in two separate terminals for different videos won't suffer from GIL issues, as each process has its own Python interpreter and memory space. This effectively bypasses the GIL, allowing true parallel execution. For more details, you can check out our guide on thread-safe inference: https://docs.ultralytics.com/guides/yolo-thread-safe-inference/.
abysshal
So what is the best practice for single-threaded processing with asyncio? For example, gunicron+gevent+flask is used to deal with highly concurrent requests, and only one Yolo model instance will be created in each worker process. Here we do not handle threads manually, we only provide the predict function for callback from gevent. Then will the predict function of the same model instance be called again on the next request when it is not completed due to an I/O wait operation on the current request? How we handle this safely? Does it matter if cpu of gpu is used for inference?
- Glenn JocherUltralytics(bearbeitet)
@abysshal when using an asynchronous server like Gunicorn with Gevent and Flask, you're dealing with a cooperative multitasking environment. In such an environment, the context switches occur at well-defined points, typically I/O operations or explicit yield points. This means that your predict function will not be preempted in the middle of execution by another request unless it hits an I/O wait or a yield.
Here's how you can handle this safely:
-
Single Model Instance: Since you're creating only one YOLO model instance per worker process, you need to ensure that the predict function is designed to be re-entrant. This means that if the function is called again while a previous call is waiting for I/O, it should not cause any conflicts or unexpected behavior.
-
Asyncio Compatibility: If you're using asyncio, you should ensure that the predict function and any other code that might run concurrently are compatible with asyncio's event loop. This means using
awaitfor I/O-bound operations and ensuring that any libraries you use within the predict function are also compatible with asyncio. -
Thread Safety: Even though you're not manually handling threads, the underlying implementation of some libraries (like PyTorch) may use threads for certain operations. A single Ultralytics
YOLOmodel instance is not thread-safe, so do not share one instance across threads. Use one instance per thread or worker, or wrap the shared call with theThreadingLockeddecorator (see the thread-safe inference guide). -
Resource Locking: If there are shared resources that need to be accessed or modified during the predict function, you should use appropriate locking mechanisms to prevent race conditions. However, in an async environment, you should use async-compatible locks like
asyncio.Lock. -
CPU vs. GPU Inference: The choice between CPU and GPU can affect performance but should not affect the thread safety or the async behavior of your application. However, if you're using a GPU, you need to ensure that the library you're using for YOLO supports concurrent model inference on the GPU without conflicts.
-
Testing: Test your application under load to ensure that it behaves correctly with concurrent requests. You can use tools like
locustorab(Apache Bench) to simulate high concurrency and check for any race conditions or deadlocks.
In summary, when using Gunicorn with Gevent and Flask, you should ensure that your predict function is re-entrant and compatible with asyncio, use async-compatible locks if necessary, and test your application under load. The choice of CPU or GPU should not affect the thread safety of your application, but you should ensure that your YOLO model library supports concurrent inference on your chosen hardware.
1 -