Google-Cloud-Storage-Integration
Die Integration von Google Cloud Storage verbindet deine GCS-Buckets mit der Ultralytics Platform. Deine Bilder bleiben in deinen Buckets – die Platform indexiert sie direkt dort. So kannst du YOLO-Modelle durchsuchen, annotieren und trainieren, ohne eine Kopie hochzuladen. Wenn KI-Funktionen aktiviert sind, kann die Platform die Bilder außerdem für intelligente Annotation, automatische Annotation, die Suche nach ähnlichen Bildern und Cloud-Training verwenden.
Für Datensätze in Google Cloud Storage ist ein Pro- oder Enterprise-Tarif erforderlich. In kostenlosen Arbeitsbereichen wird die Integration angezeigt und du wirst beim Verbinden zum Upgrade aufgefordert. Auf vorhandene Datensätze in Google Cloud Storage kannst du auch nach Ablauf eines Abonnements weiterhin vollständig zugreifen – nur für neue Verbindungen und Importe ist Pro erforderlich.
Dienstkonto erstellen#
Der Lesezugriff deckt alles außer der Bildgenerierung ab, bei der auch Objekte erstellt werden. Die Platform ändert oder löscht deine Objekte niemals. Erstelle ein dediziertes Dienstkonto:
- Öffne in der Google-Cloud-Konsole IAM & Admin > Service Accounts und erstelle ein Dienstkonto.
- Weise dem Konto für die Buckets, die du verbinden möchtest, die Rolle Storage Object Viewer (
roles/storage.objectViewer) zu. Für die Bildgenerierung musst du außerdem Storage Object Creator (roles/storage.objectCreator) zuweisen. Damit können Objekte erstellt, aber nicht überschrieben oder gelöscht werden. - Öffne das Dienstkonto, wähle Keys > Add key > Create new key, wähle JSON und lade die Schlüsseldatei herunter.
roles/storage.objectViewer deckt alle Aktionen von Platform mit deinen Daten ab, erlaubt aber nicht, die Buckets in einem Projekt aufzulisten. Weise eine Rolle zu, die storage.buckets.list enthält, wenn Platform deine Buckets für dich finden soll. Andernfalls gib beim Verbinden jeden Bucket-Namen manuell ein.
Mit Platform verbinden#
- Gehe zu Settings > Integrations und wähle in der Integrationsliste Google Cloud Storage aus.
- Füge den Inhalt des JSON-Schlüssels für das Dienstkonto ein.
- Klicke auf Find available buckets und wähle dann die Buckets aus, die du verbinden möchtest. Wenn das Dienstkonto Buckets nicht auflisten kann, gib den Namen eines bekannten Buckets manuell ein.
- Klicke auf Connect. Die Platform überprüft vor dem Speichern, ob sie jeden ausgewählten Bucket auflisten und daraus lesen kann, und fragt Google Cloud, ob das Dienstkonto auch Objekte erstellen kann. Es werden keine Daten geschrieben.
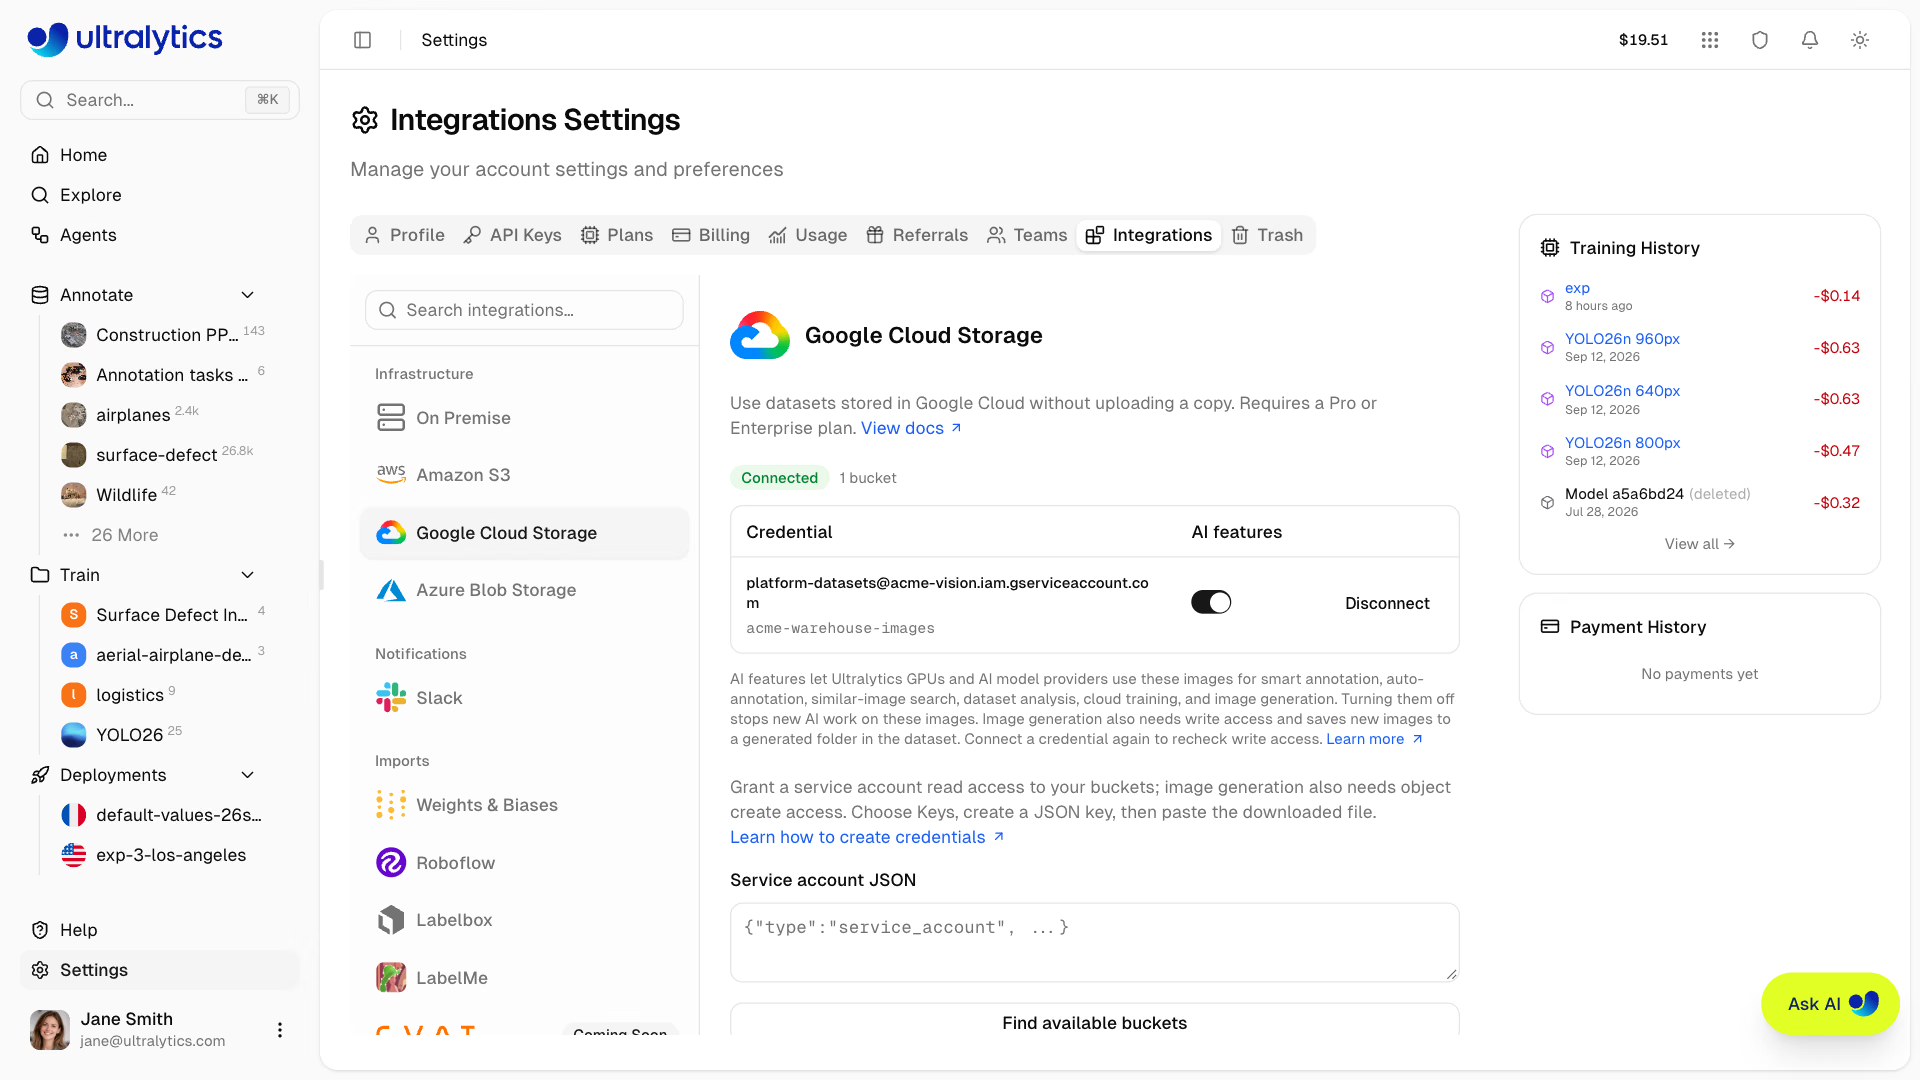
Für jede verbundene Anmeldeinformation gibt es einen Schalter für KI-Funktionen. Nachdem du die Rollen geändert hast, verbinde dasselbe Dienstkonto erneut, um den Schreibzugriff erneut zu überprüfen.
Zum Verbinden von Cloud-Speicher brauchst du die Rolle eines Arbeitsbereichsadmins oder -inhabers. Du kannst bis zu 50 Buckets gleichzeitig hinzufügen. Bei der Suche werden bis zu 300 der für das Dienstkonto sichtbaren Buckets aufgelistet.
Dein Browser liest die eingefügte Schlüsseldatei und sendet nur die drei Felder, die Platform benötigt: client_email, private_key und project_id. Der Rest der JSON-Datei verlässt die Seite nie.
Wenn du später dasselbe Dienstkonto erneut verbindest, werden neue Buckets zur bestehenden Integration hinzugefügt. Gespeicherte Anmeldedaten werden erst ersetzt, wenn mit den neuen Anmeldedaten weiterhin auf alle bereits verbundenen Buckets zugegriffen werden kann. Ist ein Bucket nicht lesbar, wird er in der Fehlermeldung genannt – auch wenn er zuvor mit demselben Dienstkonto verbunden wurde.
Die Anmeldedaten werden im Ruhezustand mit AES-256-GCM verschlüsselt, niemals an den Browser zurückgegeben und niemals für Trainingsaufgaben offengelegt. Um den Zugriff zu widerrufen, lösche den Schlüssel des Dienstkontos in Google Cloud.
KI-Funktionen#
Für jede verbundene Anmeldeinformation gibt es unter Settings > Integrations einen standardmäßig aktivierten Schalter für KI-Funktionen. Solange er aktiviert ist, können Ultralytics-GPUs und KI-Modellanbieter die Bilder dieser Anmeldeinformation für Folgendes verwenden:
- Intelligente SAM-Annotation sowie automatische Annotation einzelner Bilder und im Stapel
- Suche nach ähnlichen Bildern und Clustering-Analyse
- Cloud-Training
- Bildgenerierung für Buckets mit Schreibzugriff
Anbieter von KI-Modellen kommen nur bei der Bilderzeugung zum Einsatz, deren Prompts Google Gemini anhand des Ausgangsbilds erstellt, sowie bei kostenpflichtigen Annotationsmodellen, die mit dem eigenen Anbieterschlüssel deines Arbeitsbereichs ausgeführt werden. Die Platform speichert keine Kopien deiner Bilder: Funktionen lesen sie bei Bedarf ein, beim Cloud-Training werden für die Dauer eines Trainingslaufs temporäre Kopien verwendet und die Suche nach ähnlichen Bildern speichert ein Embedding für jedes Bild, das gelöscht wird, sobald das Bild die Platform verlässt.
Deaktiviere den Schalter, damit die Bilder nicht auf Ultralytics-GPUs und bei KI-Modellanbietern verwendet werden. Dadurch werden keine neuen KI-Aufgaben mehr gestartet; bereits laufende Aufgaben werden abgeschlossen. Bei Datensätzen mit dieser Anmeldeinformation wird dann AI features off angezeigt, zusammen mit einem Link zu diesen Einstellungen. Für jede nicht verfügbare Funktion wird der Grund erläutert. Manuelle Annotation, Freigabe und lokales Training funktionieren weiterhin. Bereits erstellte Beschriftungen, Modelle und Suchergebnisse bleiben erhalten.
Du benötigst die Rolle eines Workspace-Administrators oder -Eigentümers, um den Schalter zu ändern. Du kannst die Einstellung auch über die REST API ändern. Verwende dazu die Integrations-ID, die von GET /api/integrations/buckets zurückgegeben wird:
curl -X PATCH \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"processing": false}' \
https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_IDBildgenerierung#
Ähnliche Bilder generieren funktioniert bei Datensätzen in Google Cloud Storage, deren Bucket das Dienstkonto beschreiben kann, sofern KI-Funktionen aktiviert sind. Hinzugefügte Bilder werden in einen Ordner generated/ innerhalb des Datensatzordners geschrieben und anschließend wie jedes andere indexierte Bild zum Datensatz hinzugefügt. Die Platform erstellt dort nur neue Objekte und überschreibt oder löscht niemals vorhandene Objekte. Wenn für die Aktion Schreibzugriff erforderlich ist, erteile ihn bei Bedarf und verbinde dasselbe Dienstkonto erneut unter Settings > Integrations.
Einen Datensatz aus einem GCS-Bucket erstellen#
- Klicke auf New Dataset und öffne den Tab Cloud.
- Wähle einen verbundenen Bucket aus und navigiere zum Ordner mit deinen Daten.
- Bestätige den Ordner, passe den Datensatznamen an und erstelle den Datensatz.
Platform listet den Ordner einmal auf und indiziert die gefundenen Inhalte:
- Bilder – Objekte mit den Endungen
.jpg,.jpeg,.png,.webpund.avifwerden indiziert. Die Abmessungen werden mit begrenzten Anfragen ausgelesen. Platform speichert keine zweite Kopie des Quellbilds. - Labels – YOLO-
.txt-Begleitdateien werden in Platform-Annotationen umgewandelt. Die Zuordnung erfolgt anhand der üblichen Strukturimages/→labels/oder über gleichgeordnete Dateien im selben Ordner. - Metadaten – Eine YAML-Datei enthält Klassennamen und die Form der Pose-Keypoints, genau wie beim Hochladen eines Archivs. Wenn der Ordner mehrere Dateien enthält, werden
data.yamlunddata.ymlbevorzugt. - Aufgabe – Die Aufgabe wird anhand einer Stichprobe der Labeldateien bestimmt. Segmentierungs-, Pose- und OBB-Ordner werden daher an der Form ihrer Labels erkannt und nicht anhand der im Dialog ausgewählten Aufgabe.
- Aufteilungen – Ordnernamen
train,valundtestim Objektpfad weisen die Aufteilungen automatisch zu.
Der Datensatz funktioniert anschließend wie jeder andere: Du kannst ihn durchsuchen, annotieren, öffentlich oder privat schalten, mit deinem Team teilen und über verwaltetes Training damit trainieren. Originale werden bei Bedarf übertragen und indizierte Bilder werden nicht auf dein Speicherkontingent in Platform angerechnet.
Ein einzelner Import indexiert bis zu 500.000 Objekte sowie Beschriftungs- oder YAML-Dateien mit jeweils bis zu 1 MB. Größere Buckets sollten auf mehrere Datensätze aufgeteilt werden.
Jedes indexierte Bild ist an die Generation seines GCS-Objekts gebunden. Ändert sich ein Objekt, verweigert Platform den Zugriff darauf. Füge neue Objekte hinzu, anstatt vorhandene zu überschreiben.
Fehlgeschlagene Importe#
Wenn ein Import fehlschlägt – etwa wegen eines leeren Ordners, eines Tippfehlers im Pfad oder entzogener Berechtigungen –, wird der Fehler auf der Datensatzseite angezeigt. Editoren können auf Import wiederholen klicken, um den Import mit dem gespeicherten Bucket und Ordner erneut zu starten, oder einen neuen Datensatz mit dem korrigierten Pfad erstellen.
Bei einem erneuten Versuch wird der Ordner neu aufgelistet, statt den Import fortzusetzen: Seit dem ersten Versuch hinzugefügte Objekte werden erfasst, und nicht mehr vorhandene Objekte werden aus dem Datensatz entfernt.
Training#
Bei aktiviertem KI-Funktionen funktioniert das verwaltete Training über den üblichen Trainingsablauf. Für die Dauer des Trainingslaufs verwendet das Training eigene Kopien der angehefteten Bilder, die von der Platform erstellt werden. Deine Google Cloud-Anmeldedaten werden niemals den Trainingsprozessen zugänglich gemacht. Wenn KI-Funktionen deaktiviert sind, erklärt der Trainingsdialog, warum Cloud-Training nicht verfügbar ist, und bietet stattdessen lokales Training an.
Verbindung trennen#
Beim Trennen der Verbindung werden die gespeicherten Anmeldedaten gelöscht, ohne etwas in Google Cloud zu ändern. Aus diesen Buckets erstellte Datensätze bleiben mit ihren Klassen, Beschriftungen und Anmerkungen in deinem Arbeitsbereich, aber ihre Bilder können erst wieder geladen, in der Vorschau angezeigt oder für das Training verwendet werden, wenn dasselbe Dienstkonto erneut verbunden wird. Auch ohne Verbindung kannst du sie umbenennen, ihre Beschriftungen bearbeiten oder sie löschen.
Um die Verbindung zu trennen, gehe zu Einstellungen > Integrationen, wähle Google Cloud Storage aus, klicke neben den Anmeldedaten auf Trennen und bestätige den Vorgang. Wenn du anschließend einen der zugehörigen Datensätze öffnest, wird Google Cloud Storage getrennt mit einem Link zu diesen Einstellungen angezeigt. Nach der erneuten Verbindung ist der Datensatz automatisch wieder verfügbar.
Du kannst die Verbindung auch über die REST API trennen. Verwende dazu die von GET /api/integrations/buckets zurückgegebene Integrations-ID:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Um den Zugriff stattdessen direkt an der Quelle zu widerrufen, lösche den Schlüssel des Dienstkontos in Google Cloud.
Derzeitige Einschränkungen#
Bei Datensätzen in GCS sind Funktionen nicht verfügbar, die eigene Bildkopien in der Platform benötigen: das Klonen von Datensätzen, unveränderliche Versions-Snapshots, das Weichzeichnen von Gesichtern und das Einfügen von Bildern aus anderen Datensätzen. Für intelligente Annotation, automatische Annotation, die Suche nach ähnlichen Bildern, Clustering, Cloud-Training und Bildgenerierung müssen KI-Funktionen aktiviert sein.
Beim Löschen eines Datensatzes auf GCS oder einzelner Bilder daraus werden nur die Verweise von Platform entfernt – deine Objekte bleiben unberührt.
Siehe auch die Integrationen für Amazon S3 und Azure Blob Storage.
Häufig gestellte Fragen#
Nein. Die Platform listet den Bucket einmal auf und indexiert die Bildabmessungen und Beschriftungen, die sie darin findet. Originale werden bei Bedarf zum Durchsuchen und Annotieren übertragen. Wenn KI-Funktionen aktiviert sind, lesen Ultralytics-GPUs die Bilder bei Bedarf ein. Beim verwalteten Training werden für die Dauer eines Trainingslaufs temporäre Kopien verwendet, und bei der Suche nach ähnlichen Bildern wird eine Einbettung jedes Bilds gespeichert, die zusammen mit dem Bild gelöscht wird. Die einzigen Objekte, die die Platform schreibt, sind die von dir hinzugefügten generierten Bilder unter
generated/. Indexierte Bilder werden nicht auf dein Speicherkontingent angerechnet.Ein Datensatz wird bei seiner Erstellung einmal indexiert. Neue Objekte werden erst erfasst, wenn du einen neuen Datensatz erstellst oder einen fehlgeschlagenen Import wiederholst. Jedes indexierte Bild ist an seine Version gebunden. Wird ein Objekt überschrieben, verweigert Platform den Zugriff auf dieses Bild. Füge neue Objekte hinzu, anstatt vorhandene zu ersetzen.
Nur für die Bildgenerierung und nur, wenn das Dienstkonto Objekte erstellen kann und KI-Funktionen aktiviert sind. Die Platform erstellt neue Objekte unter
generated/im Datensatzordner und überschreibt oder löscht niemals vorhandene Objekte.Trenne die Integration unter Settings > Integrations, um die gespeicherten Anmeldedaten zu löschen, oder lösche den Schlüssel des Dienstkontos in Google Cloud. Keine der beiden Aktionen wirkt sich auf die Daten in deinen Buckets aus. Deaktiviere KI-Funktionen, wenn du verhindern möchtest, dass Bilder auf Ultralytics-GPUs verwendet werden, ohne die Verbindung zu trennen.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.