Prácticas recomendadas para la implementación de modelos#
Introducción#
La implementación de modelos es el paso de un proyecto de visión artificial que lleva un modelo de la fase de desarrollo a una aplicación real. Hay varias opciones de implementación de modelos: la implementación en la nube ofrece escalabilidad y facilidad de acceso; la implementación edge reduce la latencia al acercar el modelo a la fuente de datos; y la implementación local garantiza privacidad y control. La elección de la estrategia adecuada depende de las necesidades de tu aplicación y exige equilibrar velocidad, seguridad y escalabilidad.
Ver: Cómo optimizar e implementar modelos de IA: buenas prácticas, resolución de problemas y consideraciones de seguridad
También es importante seguir las prácticas recomendadas al implementar un modelo, ya que la implementación puede influir significativamente en la eficacia y la fiabilidad del rendimiento del modelo. En esta guía, nos centraremos en cómo lograr que la implementación de tu modelo sea fluida, eficiente y segura.
Opciones de implementación de modelos#
A menudo, una vez que se ha entrenado, evaluado y probado un modelo, hay que convertirlo a formatos específicos para implementarlo de forma eficaz en distintos entornos, como la nube, edge o dispositivos locales.
Con YOLO26, puedes exportar tu modelo a distintos formatos según tus necesidades de implementación. Por ejemplo, exportar YOLO26 a ONNX es sencillo e ideal para transferir modelos entre marcos de trabajo. Para descubrir más opciones de integración y garantizar una implementación fluida en distintos entornos, visita nuestro catálogo de integración de modelos.
Elegir un entorno de implementación#
El lugar donde implementes tu modelo de visión artificial depende de varios factores. Cada entorno presenta ventajas y desafíos propios, así que es fundamental elegir el que mejor se adapte a tus necesidades.
Implementación en la nube#
La implementación en la nube es ideal para aplicaciones que necesitan escalar rápidamente y gestionar grandes cantidades de datos. Plataformas como AWS, Google Cloud y Azure facilitan la gestión de tus modelos desde el entrenamiento hasta la implementación. Ofrecen servicios como AWS SageMaker, Google AI Platform y Azure Machine Learning para ayudarte durante todo el proceso.
Sin embargo, la nube puede ser cara, sobre todo si se utilizan muchos datos, y podrías tener problemas de latencia si tus usuarios están lejos de los centros de datos. Para controlar los costes y el rendimiento, es importante optimizar el uso de los recursos y garantizar el cumplimiento de las normas de privacidad de los datos.
Implementación edge#
La implementación edge funciona bien con aplicaciones que requieren respuestas en tiempo real y baja latencia, sobre todo en lugares con acceso a Internet limitado o inexistente. Implementar modelos en dispositivos edge, como teléfonos inteligentes o dispositivos IoT, garantiza un procesamiento rápido y mantiene los datos en el entorno local, lo que mejora la privacidad. La implementación edge también ahorra ancho de banda porque se envían menos datos a la nube.
Sin embargo, los dispositivos edge suelen tener una capacidad de procesamiento limitada, por lo que tendrás que optimizar tus modelos. Herramientas como LiteRT y NVIDIA Jetson pueden ayudarte. A pesar de sus ventajas, mantener y actualizar muchos dispositivos puede resultar complicado.
Implementación local#
La implementación local es la mejor opción cuando la privacidad de los datos es fundamental o el acceso a Internet es poco fiable o inexistente. Ejecutar modelos en servidores locales o equipos de sobremesa te da control total y mantiene tus datos seguros. También puede reducir la latencia si el servidor está cerca del usuario.
Sin embargo, ampliar la implementación local puede ser difícil y el mantenimiento puede llevar mucho tiempo. El uso de herramientas como Docker para la contenerización y Kubernetes para la gestión puede ayudar a que las implementaciones locales sean más eficientes. Es necesario realizar actualizaciones y tareas de mantenimiento con regularidad para que todo funcione correctamente.
Contenerización para simplificar la implementación#
La contenerización es un método eficaz que agrupa tu modelo y todas sus dependencias en una unidad estandarizada llamada contenedor. Esta técnica garantiza un rendimiento uniforme en distintos entornos y simplifica el proceso de implementación.
Ventajas de usar Docker para implementar modelos#
Docker se ha convertido en el estándar del sector para la contenerización en implementaciones de aprendizaje automático por varios motivos:
- Uniformidad del entorno: los contenedores Docker encapsulan tu modelo y todas sus dependencias, y evitan el problema de «en mi máquina funciona» al garantizar un comportamiento uniforme en los entornos de desarrollo, pruebas y producción.
- Aislamiento: los contenedores aíslan las aplicaciones entre sí y evitan conflictos entre distintas versiones de software o bibliotecas.
- Portabilidad: los contenedores Docker pueden ejecutarse en cualquier sistema compatible con Docker, lo que facilita la implementación de tus modelos en distintas plataformas sin modificarlos.
- Escalabilidad: los contenedores se pueden ampliar o reducir fácilmente en función de la demanda, y las herramientas de orquestación, como Kubernetes, pueden automatizar este proceso.
- Control de versiones: puedes asignar versiones a las imágenes Docker, lo que te permite hacer un seguimiento de los cambios y volver a versiones anteriores si es necesario.
Implementación de YOLO26 con Docker#
Para contenerizar tu modelo YOLO26, puedes crear un Dockerfile que especifique todas las dependencias y configuraciones necesarias. Aquí tienes un ejemplo básico:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Este método garantiza que la implementación de tu modelo sea reproducible y uniforme en los entornos de desarrollo, pruebas y producción.
Técnicas de optimización de modelos#
La optimización de tu modelo de visión artificial ayuda a que se ejecute de forma eficiente, sobre todo al implementarlo en entornos con recursos limitados, como los dispositivos edge. Estas son algunas técnicas clave para optimizar tu modelo.
Poda de modelos#
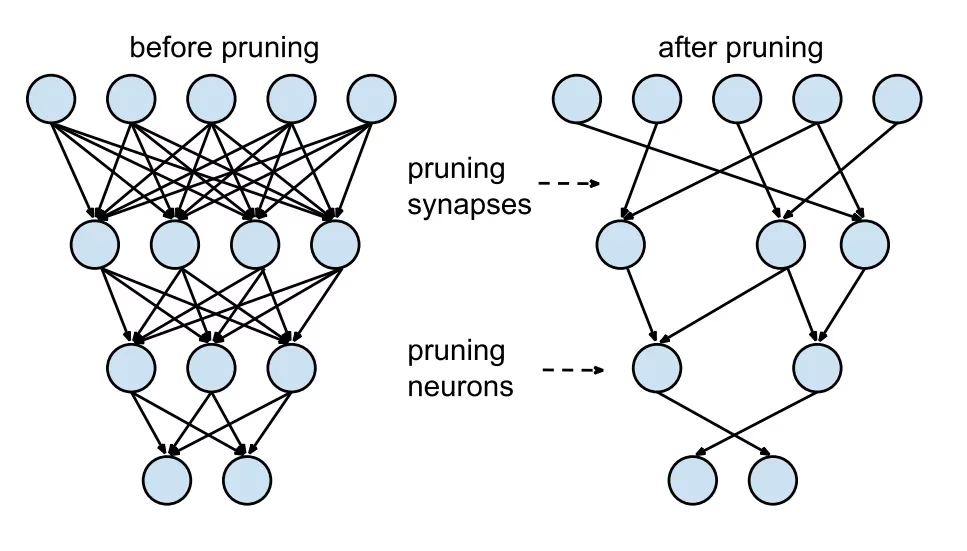
La poda reduce el tamaño del modelo al eliminar los pesos que apenas contribuyen al resultado final. Así, el modelo se vuelve más pequeño y rápido sin que la precisión se vea afectada de forma significativa. La poda consiste en identificar y eliminar parámetros innecesarios, lo que da lugar a un modelo más ligero que necesita menos potencia de cálculo. Es especialmente útil para implementar modelos en dispositivos con recursos limitados.
Cuantización de modelos#
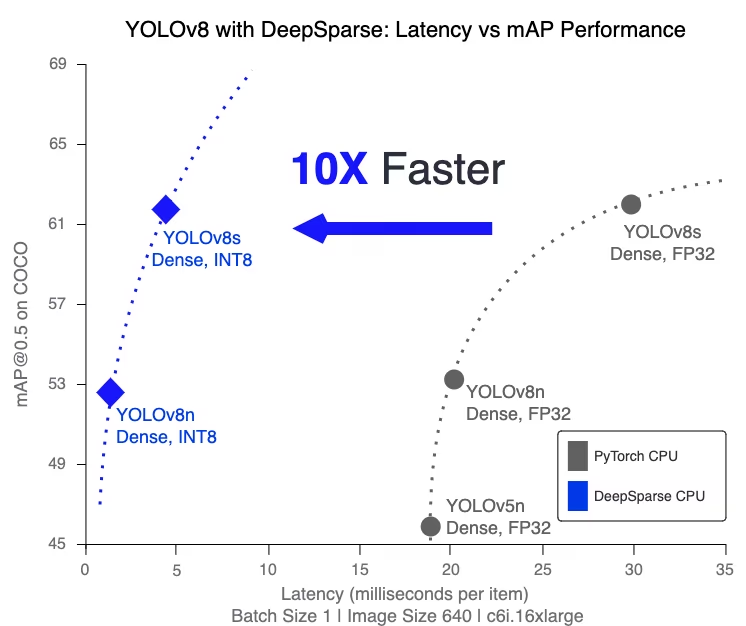
La cuantización convierte los pesos y las activaciones del modelo de una precisión alta (como los números en coma flotante de 32 bits) a una precisión menor (como los números enteros de 8 bits). Al reducir el tamaño del modelo, acelera la inferencia. El entrenamiento consciente de la cuantización (QAT) es un método que entrena el modelo teniendo en cuenta la cuantización y conserva mejor la precisión que la cuantización posterior al entrenamiento. Al gestionar la cuantización durante la fase de entrenamiento, el modelo aprende a adaptarse a una precisión menor y mantiene el rendimiento al tiempo que reduce las necesidades de cálculo.
Destilación de conocimiento#
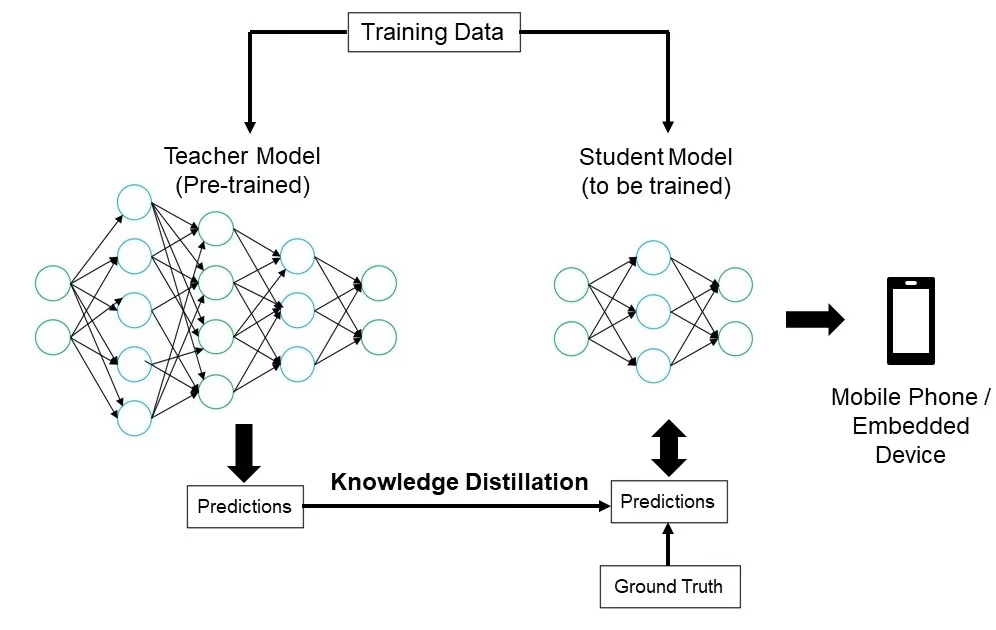
La destilación de conocimiento consiste en entrenar un modelo más pequeño y sencillo (el estudiante) para que imite las salidas de otro más grande y complejo (el profesor). El modelo estudiante aprende a aproximarse a las predicciones del profesor, lo que da lugar a un modelo compacto que conserva gran parte de la precisión del profesor. Esta técnica resulta útil para crear modelos eficientes que puedan implementarse en dispositivos edge con recursos limitados.
Solución de problemas de implementación#
Puede que te encuentres con dificultades al implementar tus modelos de visión artificial, pero conocer los problemas habituales y sus soluciones puede facilitar el proceso. Aquí tienes algunos consejos generales para solucionar problemas y prácticas recomendadas que te ayudarán a afrontar las dificultades de implementación.
Tu modelo pierde precisión después de la implementación#
Que la precisión de tu modelo disminuya después de la implementación puede ser frustrante. Este problema puede deberse a varios factores. Aquí tienes algunos pasos que te ayudarán a identificarlo y resolverlo:
- Comprueba la coherencia de los datos: Comprueba que los datos que procesa tu modelo después de la implementación sean coherentes con los datos con los que se entrenó. Las diferencias en la distribución, la calidad o el formato de los datos pueden afectar significativamente al rendimiento.
- Valida los pasos de preprocesamiento: Comprueba que todos los pasos de preprocesamiento aplicados durante el entrenamiento también se apliquen de forma coherente durante la implementación. Esto incluye cambiar el tamaño de las imágenes, normalizar los valores de píxel y aplicar otras transformaciones a los datos.
- Evalúa el entorno del modelo: Asegúrate de que las configuraciones de hardware y software utilizadas durante la implementación coincidan con las del entrenamiento. Las diferencias en las bibliotecas, las versiones y las capacidades del hardware pueden generar discrepancias.
- Supervisa la inferencia del modelo: Registra las entradas y salidas en distintas fases del flujo de inferencia para detectar anomalías. Esto puede ayudar a identificar problemas como la corrupción de datos o un tratamiento inadecuado de las salidas del modelo.
- Revisa la exportación y conversión del modelo: Vuelve a exportar el modelo y asegúrate de que el proceso de conversión mantenga la integridad de los pesos y la arquitectura del modelo.
- Prueba con un conjunto de datos controlado: Implementa el modelo en un entorno de pruebas con un conjunto de datos que controles y compara los resultados con los de la fase de entrenamiento. Así podrás identificar si el problema está en el entorno de implementación o en los datos.
Al implementar YOLO26, varios factores pueden afectar a la precisión del modelo. La conversión de modelos a formatos como TensorRT implica optimizaciones como la cuantización de pesos y la fusión de capas, que pueden causar pequeñas pérdidas de precisión. Usar FP16 (precisión media) en lugar de FP32 (precisión completa) puede acelerar la inferencia, pero también puede introducir errores de precisión numérica. Además, las limitaciones del hardware, como las del Jetson Nano, con menos núcleos CUDA y un ancho de banda de memoria reducido, pueden afectar al rendimiento.
Las inferencias tardan más de lo esperado#
Al implementar modelos de aprendizaje automático, es importante que se ejecuten de forma eficiente. Si las inferencias tardan más de lo esperado, puede afectar a la experiencia de usuario y a la eficacia de tu aplicación. Aquí tienes algunos pasos que te ayudarán a identificar y resolver el problema:
- Realiza ejecuciones de calentamiento: Las ejecuciones iniciales suelen incluir la sobrecarga de configuración, lo que puede distorsionar las mediciones de latencia. Realiza algunas inferencias de calentamiento antes de medir la latencia. Excluir estas ejecuciones iniciales permite medir el rendimiento del modelo con mayor precisión.
- Optimiza el motor de inferencia: Comprueba que el motor de inferencia esté totalmente optimizado para la arquitectura específica de tu GPU. Usa los controladores y las versiones de software más recientes y adaptados a tu hardware para garantizar el máximo rendimiento y compatibilidad.
- Usa el procesamiento asíncrono: El procesamiento asíncrono puede ayudar a gestionar las cargas de trabajo de forma más eficiente. Usa técnicas de procesamiento asíncrono para gestionar varias inferencias al mismo tiempo, lo que puede ayudar a distribuir la carga y reducir los tiempos de espera.
- Perfila el flujo de inferencia: Identificar los cuellos de botella del flujo de inferencia puede ayudar a localizar el origen de los retrasos. Usa herramientas de perfilado para analizar cada paso del proceso de inferencia, detectar y resolver las fases que causen retrasos significativos, como las capas ineficientes o los problemas de transferencia de datos.
- Usa la precisión adecuada: Usar una precisión superior a la necesaria puede ralentizar la inferencia. Prueba con una precisión menor, como FP16 (precisión media), en lugar de FP32 (precisión completa). Aunque FP16 puede reducir el tiempo de inferencia, ten en cuenta que también puede afectar a la precisión del modelo.
Si tienes este problema al implementar YOLO26, ten en cuenta que YOLO26 ofrece modelos de varios tamaños, como YOLO26n (nano) para dispositivos con menos memoria y YOLO26x (extragrande) para GPU más potentes. Elegir la variante adecuada para tu hardware puede ayudar a equilibrar el uso de memoria y el tiempo de procesamiento.
Ten en cuenta también que el tamaño de las imágenes de entrada afecta directamente al uso de memoria y al tiempo de procesamiento. Las resoluciones más bajas reducen el uso de memoria y aceleran la inferencia, mientras que las resoluciones más altas mejoran la precisión, pero requieren más memoria y capacidad de procesamiento.
Consideraciones de seguridad al implementar modelos#
Otro aspecto importante de la implementación es la seguridad. La seguridad de los modelos implementados es fundamental para proteger los datos confidenciales y la propiedad intelectual. Estas son algunas prácticas recomendadas que puedes seguir para implementar modelos de forma segura.
Transmisión segura de datos#
Es muy importante asegurarse de que los datos enviados entre clientes y servidores estén protegidos para evitar que se intercepten o que accedan a ellos personas no autorizadas. Puedes usar protocolos de cifrado como TLS (seguridad de la capa de transporte) para cifrar los datos durante la transmisión. Aunque alguien los intercepte, no podrá leerlos. También puedes usar el cifrado de extremo a extremo, que protege los datos desde el origen hasta el destino para que nadie pueda acceder a ellos durante el trayecto.
Controles de acceso#
Es fundamental controlar quién puede acceder a tu modelo y a sus datos para evitar usos no autorizados. Usa métodos de autenticación robustos para verificar la identidad de los usuarios o sistemas que intenten acceder al modelo y considera añadir una capa adicional de seguridad con la autenticación multifactor (MFA). Configura el control de acceso basado en roles (RBAC) para asignar permisos en función de los roles de usuario, de modo que cada persona solo tenga acceso a lo que necesita. Mantén registros de auditoría detallados para hacer un seguimiento de todos los accesos y cambios en el modelo y sus datos, y revísalos periódicamente para detectar actividades sospechosas.
Ofuscación del modelo#
Puedes proteger tu modelo frente a la ingeniería inversa o el uso indebido mediante la ofuscación del modelo. Esto consiste en cifrar parámetros del modelo, como los pesos y sesgos de las redes neuronales, para dificultar que personas no autorizadas entiendan o modifiquen el modelo. También puedes ofuscar la arquitectura del modelo cambiando el nombre de las capas y los parámetros o añadiendo capas ficticias, lo que dificulta aún más la ingeniería inversa. Servir el modelo en un entorno seguro, como un enclave seguro o un entorno de ejecución de confianza (TEE), también puede proporcionar una capa adicional de protección durante la inferencia.
Conclusión y próximos pasos#
Hemos repasado algunas prácticas recomendadas para implementar modelos de visión artificial. Si proteges los datos, controlas el acceso y ofuscas los detalles del modelo, puedes proteger la información confidencial y mantener los modelos en funcionamiento sin problemas. También hemos explicado cómo abordar problemas habituales, como la pérdida de precisión y las inferencias lentas, con estrategias como las ejecuciones de calentamiento, la optimización de motores, el procesamiento asíncrono, el perfilado de flujos y la elección de la precisión adecuada.
Después de implementar tu modelo, el siguiente paso es supervisar, mantener y documentar tu aplicación. La supervisión periódica ayuda a detectar y solucionar problemas rápidamente, el mantenimiento mantiene tus modelos actualizados y operativos, y una buena documentación registra todos los cambios y actualizaciones. Estos pasos te ayudarán a alcanzar los objetivos de tu proyecto de visión artificial.
Preguntas frecuentes#
Implementar un modelo de aprendizaje automático, especialmente con Ultralytics YOLO26, requiere seguir varias prácticas recomendadas para garantizar la eficiencia y la fiabilidad. En primer lugar, elige el entorno de implementación que mejor se adapte a tus necesidades: la nube, el edge o un entorno local. Optimiza tu modelo con técnicas como la poda, la cuantización y la destilación de conocimiento para implementarlo de forma eficiente en entornos con recursos limitados. Considera usar la contenedorización con Docker para garantizar la coherencia entre distintos entornos. Por último, asegúrate de que la coherencia de los datos y los pasos de preprocesamiento se ajusten a los de la fase de entrenamiento para mantener el rendimiento. También puedes consultar las opciones de implementación de modelos para ver instrucciones más detalladas.
La resolución de problemas de implementación puede dividirse en unos pocos pasos clave. Si la precisión de tu modelo disminuye después de la implementación, comprueba la coherencia de los datos, valida los pasos de preprocesamiento y asegúrate de que el entorno de hardware y software coincida con el que utilizaste durante el entrenamiento. Si la inferencia es lenta, realiza ejecuciones de calentamiento, optimiza el motor de inferencia, usa el procesamiento asíncrono y perfila el flujo de inferencia. Consulta la guía para solucionar problemas de implementación para obtener instrucciones detalladas sobre estas prácticas recomendadas.
Para optimizar los modelos Ultralytics YOLO26 en dispositivos edge, puedes recurrir a técnicas como la poda para reducir el tamaño del modelo, la cuantización para convertir los pesos a una precisión menor y la destilación de conocimiento para entrenar modelos más pequeños que imiten a otros de mayor tamaño. Estas técnicas garantizan que el modelo se ejecute de forma eficiente en dispositivos con una capacidad de cálculo limitada. Herramientas como LiteRT y NVIDIA Jetson son especialmente útiles para estas optimizaciones. Encontrarás más información sobre estas técnicas en la sección sobre optimización de modelos.
La seguridad es fundamental al implementar modelos de aprendizaje automático. Garantiza la transmisión segura de datos mediante protocolos de cifrado como TLS. Implementa controles de acceso robustos, incluida una autenticación sólida y el control de acceso basado en roles (RBAC). Las técnicas de ofuscación del modelo, como el cifrado de los parámetros del modelo y servir los modelos en un entorno seguro, como un entorno de ejecución de confianza (TEE), ofrecen protección adicional. Consulta las consideraciones de seguridad para conocer las prácticas en detalle.
La elección del entorno óptimo para implementar tu modelo Ultralytics YOLO26 depende de las necesidades específicas de tu aplicación. La implementación en la nube ofrece escalabilidad y facilidad de acceso, por lo que es ideal para aplicaciones con grandes volúmenes de datos. La implementación edge es la mejor opción para aplicaciones de baja latencia que requieren respuestas en tiempo real, y puede utilizar herramientas como LiteRT. La implementación local es adecuada para situaciones que requieren una privacidad y un control estrictos de los datos. Para consultar un resumen completo de cada entorno, visita la sección sobre cómo elegir un entorno de implementación.