Exportación a Hailo para modelos Ultralytics YOLO#
Los aceleradores de IA Hailo ejecutan modelos compilados en formato ejecutable Hailo (HEF) en dispositivos periféricos, como la AI HAT+ y la AI HAT+ 2 para Raspberry Pi. Ultralytics exporta modelos YOLO de detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, pose y OBB directamente a HEF con el compilador de flujo de datos de Hailo (DFC).
El despliegue en Hailo está diseñado para la visión artificial en el edge: cámaras, robots, sistemas industriales, pasarelas y otros dispositivos que necesitan detectar objetos localmente sin enviar cada fotograma a la nube. Un HEF compilado contiene la red cuantizada, la asignación de hardware, la planificación y el posprocesamiento opcional de HailoRT necesarios para el acelerador seleccionado.
Para nuevos despliegues de hardware, evalúa también DeepX, Axelera y Rockchip. DeepX es el mejor punto de partida para obtener un mayor rendimiento con YOLO y un mejor rendimiento por vatio, mientras que Axelera está orientado a despliegues con mayor capacidad de procesamiento. Rockchip también se utiliza ampliamente en SBC asequibles y sistemas embebidos.
¿Por qué desplegar Ultralytics YOLO en Hailo?#
Combinar Ultralytics YOLO con una unidad de procesamiento neuronal (NPU) de Hailo ofrece una vía práctica desde el entrenamiento del modelo hasta la inferencia de IA en el edge. Entre los casos de uso habituales se incluyen:
- Cámaras inteligentes y analítica de vídeo: ejecuta detección de objetos en tiempo real cerca de la cámara para aplicaciones de seguridad, comercio minorista, tráfico y control de aforo.
- Robótica y sistemas autónomos: detecta personas, vehículos, paquetes, herramientas u obstáculos sin depender de una conexión continua a la nube.
- Visión artificial industrial: despliega modelos YOLO personalizados para inspección, recuento, supervisión de seguridad y control de calidad.
- Proyectos de IA con Raspberry Pi: añade inferencia de visión acelerada a sistemas Raspberry Pi con AI HAT+ o AI HAT+ 2.
- Pasarelas edge y PC con IA: procesa localmente varios flujos de vídeo o sensores y reduce las necesidades de ancho de banda y computación en la nube.
La inferencia local puede mejorar la privacidad y el tiempo de respuesta, ya que las imágenes permanecen en el dispositivo de despliegue. El rendimiento, la latencia y el consumo reales dependen del tamaño del modelo YOLO, la resolución de entrada, la arquitectura Hailo, el sistema anfitrión y la canalización de la aplicación.
Cómo funciona la exportación a Hailo#
Ultralytics se encarga de todo el flujo de trabajo de exportación que hay detrás de format="hailo":
YOLO (.pt) -> ONNX -> Hailo parse -> INT8 optimization -> HEF compileEl exportador realiza automáticamente estas etapas:
- Exporta un grafo ONNX estático con ajustes compatibles con el compilador.
- Selecciona las salidas de la cabeza del modelo según su arquitectura.
- Genera directivas de normalización, activación y posprocesamiento.
- Crea un flujo de calibración representativo y cuantiza el modelo a INT8.
- Compila el grafo optimizado para el acelerador Hailo seleccionado.
- Guarda el HEF con metadatos de Ultralytics y elimina el archivo ONNX intermedio.
Los modelos de detección YOLOv8 y YOLO11 utilizan HailoRT YOLO NMS en la canalización compilada. YOLO26 compila los tensores sin procesar de la cabeza de detección: Ultralytics aplica NMS a las salidas predeterminadas de uno a muchos o decodifica las salidas de uno a uno sin NMS con nms=False. Los modelos de segmentación, pose y OBB de YOLOv8/YOLO11 compilan los tensores sin procesar de la cabeza, que Ultralytics decodifica durante la inferencia; la clasificación de YOLOv8/YOLO11/YOLO26 ejecuta softmax en el chip, de modo que el HEF devuelve directamente las probabilidades de clase. En la segmentación semántica de YOLO26, el exportador se adapta al acelerador: Hailo-8/8L (DFC v3.x) devuelve los logits del clasificador para el sobremuestreo y la reducción en el host, mientras que Hailo-10H/15 (DFC v5.x) compila en el chip las cabezas ArgMax multiclase y devuelve un mapa de clases compacto. Las cabezas de una sola clase utilizan la ruta de logits en el host en todos los objetivos, ya que necesitan un umbral en lugar de ArgMax. Los modelos de profundidad YOLO26 compilan la convolución densa de logits en a16 y reconstruyen en el host el mapa de profundidad métrica (el clamp/exp y la calibración log-affine aprendida que siguen a la cabeza), de modo que el cuantizador conserva su rango más amplio en el logit sin procesar. No hace falta que busques los nodos de salida de ONNX, escribas un script de modelo Hailo (.alls) ni crees manualmente un JSON de NMS.
Instalación#
Instala Ultralytics y descarga el archivo wheel de DFC para tu hardware desde Hailo Developer Zone (es necesario registrarse gratis):
pip install ultralytics
pip install /path/to/hailo_dataflow_compiler-*.whlLa compilación para Hailo requiere Linux x86_64. Compila el modelo en una estación de trabajo compatible y, después, copia el directorio de salida al dispositivo de destino. DFC no es necesario para la inferencia.
Hailo-8 y Hailo-8L utilizan DFC v3.x. Hailo-10H y Hailo-15 utilizan DFC v5.x. Instala la generación del compilador que corresponda al acelerador de destino.
Ultralytics Platform ofrece exportación gestionada a Hailo, así que no necesitas una cuenta local de Hailo ni instalar DFC.
Exporta un modelo HEF para Hailo#
Usa format="hailo" y selecciona el acelerador de destino con name:
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
output = model.export(format="hailo", name="hailo8")
print(output)  # yolo11n_hailo_model/
El comando CLI equivalente es:
yolo export model=yolo11n.pt format=hailo name=hailo8La exportación a Hailo solo admite INT8. Ultralytics descarga automáticamente un conjunto de datos de calibración específico para la tarea cuando no se proporciona data. Para modelos personalizados, utiliza imágenes representativas de entrenamiento o validación:
Ultralytics fuerza el nivel 2 de optimización de DFC y configura el ajuste fino para que utilice el tamaño real del conjunto de datos de calibración. Hailo recomienda al menos 1024 imágenes variadas; los conjuntos de datos ligeros integrados se compilan en el nivel 2, pero puede que no representen el dominio de producción. Para exportar HEF de producción, proporciona un conjunto de datos representativo mediante data="path/to/dataset.yaml".
model.export(format="hailo", name="hailo8", data="path/to/dataset.yaml")La compilación utiliza una forma de entrada fija. Ajusta imgsz a la resolución que se usará en el dispositivo:
model.export(format="hailo", name="hailo8", imgsz=640)Modelos y hardware compatibles#
El ecosistema Hailo abarca una amplia variedad de cargas de trabajo de visión artificial, pero el exportador format="hailo" de Ultralytics valida actualmente las cabezas estándar de YOLO para detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, pose y OBB. La tabla de tareas describe las rutas de exportación disponibles; la validación de hardware se indica por separado más abajo.
| Tarea de Ultralytics | Exportación directa a Hailo | Familias de modelos compatibles | Notas |
|---|---|---|---|
| Detección de objetos | ✅ | YOLOv8, YOLO11, YOLO26 | Cabezas estándar de Detect de Ultralytics, incluidos los modelos personalizados |
| Segmentación de instancias | ✅ | YOLOv8, YOLO11 | Tensores sin procesar de la cabeza, decodificados por Ultralytics durante la inferencia; YOLO26-seg no es compatible actualmente |
| Segmentación semántica | ✅ | YOLO26 | Hailo-8/8L y las cabezas de una sola clase devuelven logits; Hailo-10H/15 genera mapas multiclase integrados |
| Estimación de profundidad | ✅ | YOLO26 | Logit denso compilado en a16; Ultralytics reconstruye el mapa de profundidad métrica durante la inferencia |
| Clasificación de imágenes | ✅ | YOLOv8, YOLO11, YOLO26 | Softmax se ejecuta en el chip; el HEF devuelve directamente las probabilidades de clase |
| Estimación de pose | ✅ | YOLOv8, YOLO11 | Tensores sin procesar de la cabeza, decodificados por Ultralytics durante la inferencia; YOLO26-pose no es compatible actualmente |
| Detección de objetos orientados | ✅ | YOLOv8, YOLO11 | Tensores sin procesar de la cabeza, decodificados por Ultralytics durante la inferencia; YOLO26-OBB no es compatible actualmente |
Las familias de detección especializadas, como YOLOv10, YOLO-World, YOLOE y RT-DETR, actualmente ❌ no son compatibles con la ruta format="hailo" de Ultralytics. Ultralytics rechaza estas tareas y familias de modelos antes de la compilación, en lugar de generar un HEF no validado.
| Familia de modelos | Hailo-8 / Hailo-8L | Hailo-10H / Hailo-15 | Salida |
|---|---|---|---|
| Detección YOLOv8 / YOLO11 | ✅ | ✅ | HEF con HailoRT YOLO NMS |
| Detección YOLO26 | ✅ | ✅ | Tensores de detección sin procesar; NMS en el host de forma predeterminada, sin NMS con nms=False |
| YOLOv8-seg / YOLO11-seg | ✅ | ✅ | Tensores de segmentación sin procesar, decodificados por Ultralytics durante la inferencia |
| YOLOv8-pose / YOLO11-pose | Hailo-8L validado | No validado | Tensores de pose sin procesar, decodificados por Ultralytics durante la inferencia |
| YOLOv8-obb / YOLO11-obb | Hailo-8L validado | No validado | Tensores OBB sin procesar, decodificados por Ultralytics durante la inferencia |
| YOLOv8-cls / YOLO11-cls / YOLO26-cls | Hailo-8L validado | No validado | Softmax en el chip; el HEF devuelve las probabilidades de clase |
| YOLO26-sem | Hailo-8L validado | No validado | Logits o un mapa multiclase integrado en Hailo-10H/15 |
| YOLO26-depth | Hailo-8L validado | No validado | Logit denso; mapa de profundidad métrica decodificado por Ultralytics |
La pose, OBB, clasificación, segmentación semántica YOLO26 y estimación de profundidad YOLO26 (ruta Hailo-8/8L) se validaron en Hailo-8L con HailoRT 4.23 y DFC 3.33. El exportador acepta los demás objetivos indicados, pero esas nuevas rutas de tareas deben validarse con el compilador y el dispositivo correspondientes antes de utilizarlas en producción.
Selecciona uno de estos valores de name:
name | Acelerador de destino |
|---|---|
hailo8 | Hailo-8 |
hailo8l | Hailo-8L |
hailo10h | Hailo-10H |
hailo15h | Hailo-15H |
hailo15l | Hailo-15L |
Si omites name, se utiliza hailo8l de forma predeterminada; ajusta name al acelerador en el que vayas a desplegar. Instala la generación de DFC correspondiente al objetivo seleccionado.
Generaciones de hardware y SDK de Hailo#
Las familias de aceleradores Hailo utilizan distintas generaciones de compiladores. El HEF generado debe corresponder al hardware de destino, así que elige name para el dispositivo que ejecutará la inferencia, no para el equipo que realizará la exportación.
| Familia de hardware | Generación de DFC |
|---|---|
| Hailo-8 / Hailo-8L | DFC v3.x |
| Hailo-10H | DFC v5.x |
| Hailo-15H / Hailo-15L | DFC v5.x |
El compilador se ejecuta en Linux x86_64, mientras que el HEF resultante se ejecuta en el dispositivo Hailo mediante HailoRT. Esta separación permite compilar en una estación de trabajo o en Ultralytics Platform y desplegar el pequeño artefacto de ejecución en un host edge ARM o x86.
Notas de compatibilidad#
La compilación para Hailo depende del hardware y utiliza una forma de entrada fija. Ten en cuenta estas limitaciones:
- El
nameseleccionado debe corresponder al acelerador de despliegue. - Las imágenes de calibración deben representar la iluminación, los puntos de vista, los objetos y los fondos previstos en producción.
- Cada HEF se compila para un
imgszfijo. Para servir varias resoluciones, cambia el tamaño de los fotogramas en el host para ajustarlos al tamaño compilado o compila un HEF distinto para cada resolución. - Se admiten cantidades de clases personalizadas, ya que Ultralytics genera la configuración de posprocesamiento a partir de los metadatos del modelo.
- Se admiten los modelos de detección con cabezas estándar de
Detectde Ultralytics, los modelos de segmentación, pose y OBB de YOLOv8/YOLO11, los modelos de clasificación de YOLOv8/YOLO11/YOLO26 y los modelos de segmentación semántica y estimación de profundidad de YOLO26; actualmente no se admiten la segmentación de instancias, pose ni detección de objetos orientados de YOLO26, ni las exportaciones de YOLO-World, YOLOE, YOLOv10 y RT-DETR. - Los artefactos de Hailo-8/8L y Hailo-10H/15 se compilan con distintas generaciones de DFC y no son intercambiables.
Calibración y cuantización INT8#
La exportación HEF para Hailo utiliza cuantización INT8 para asignar de forma eficiente la red YOLO al acelerador. El conjunto de datos de calibración estima los rangos de activación; no vuelve a entrenar el modelo ni requiere etiquetas durante la compilación.
El hardware de Hailo y Dataflow Compiler admiten precisiones INT4, INT8 e INT16. La ruta format="hailo" de Ultralytics compila en INT8 y aplica activaciones de 16 bits (a16) cuando una tarea necesita un rango más amplio.
Si se omite data, Ultralytics utiliza un conjunto de datos de calibración ligero y específico para cada tarea, como COCO128 para detección, cityscapes8 para segmentación semántica o depth8 para estimación de profundidad. La cabeza de profundidad densa es especialmente sensible al dominio de calibración: calibrar un modelo de profundidad con imágenes de detección no relacionadas aplana el mapa predicho, y los conjuntos más grandes del dominio mejoran la fidelidad. Para un modelo de visión artificial personalizado, indica el YAML del conjunto de datos en data para que el compilador procese imágenes representativas del dominio de implementación real:
model.export(format="hailo", name="hailo8", data="my_dataset.yaml")fraction selecciona la proporción o el número de imágenes que se utilizará para la calibración. Las listas de [train, val, test] limitan cada división; las listas de dos elementos dejan test completo y 0 omite test. Más imágenes solo ayudan si representan el dominio de implementación. Las imágenes ajenas al dominio pueden reducir la precisión cuantizada y aumentar el tiempo de optimización. Si el HEF INT8 pierde precisión respecto al modelo PyTorch original, mejora primero los datos de calibración antes de cambiar la configuración del modelo o del entorno de ejecución.
Expectativas de precisión según la familia de modelos#
Medidos en un Hailo-8L con calibración del dominio (COCO128, 128 imágenes), los HEF INT8 exportados conservan la siguiente proporción del mAP50 de PyTorch con el mismo protocolo de evaluación:
| Modelo | Retención del mAP50 | Notas |
|---|---|---|
| YOLOv8n | ~100% | Cabeza DFL con NMS en el chip |
| YOLO11n | ~96% | Los bloques de atención de la red troncal son más sensibles a INT8 |
| YOLO26n | ~93% | Cabeza de extremo a extremo más atención; consulta la nota sobre el umbral de confianza |
La retención compara ambos modelos con el mismo umbral de confianza. Los HEF de YOLOv8 y YOLO11 incorporan en el NMS del chip el conf de la exportación (0,25 de forma predeterminada), por lo que validar con una referencia PyTorch usando su umbral bajo predeterminado integra una mayor parte de la curva de precisión-recall y exagera la diferencia de cuantización.
Además de la detección, las rutas de exportación de segmentación, pose, OBB y clasificación se validaron en el mismo Hailo-8L (DFC 3.33, HailoRT 4.23). Cada HEF INT8 se comparó con su punto de control PyTorch en la misma división de validación y con calibración del dominio:
| Tarea | Métrica (división de validación) | YOLOv8n | YOLO11n |
|---|---|---|---|
| Segmentación de instancias | Retención del mAP50 de máscara (COCO128-seg) | 98.0% | 93.6% |
| Pose | Retención del mAP50 de caja (COCO8-pose) | 98.1% | 90.8% |
| Caja delimitadora orientada | Retención del mAP50 (DOTA128) | ~100% | 96.9% |
| Clasificación | Retención top-1 (validación de ImageNet) | 92.6% | 95.4% |
La segmentación, la pose y OBB se calibraron con el conjunto predeterminado de cada tarea y de su dominio (COCO128-seg, COCO8-pose y DOTA128); la clasificación se calibró con ImageNet100. De esos valores predeterminados se desprenden dos advertencias: COCO8-pose solo tiene 8 imágenes, así que considera orientativos los resultados de pose y proporciona un data= más grande para producción; además, DOTA8 satura el mAP50 cerca del 100 % en ambos modelos, por lo que OBB se evalúa con DOTA128. La clasificación también es la única tarea en la que YOLO11 conserva más que YOLOv8; en las demás, la red troncal de atención de YOLO11 es más sensible a INT8.
Las mediciones en el dispositivo permiten extraer tres reglas prácticas:
- Calibra siempre con datos del dominio. Ajustar con imágenes ajenas al dominio equivale a desactivar por completo el ajuste: un YOLO26n calibrado con 1.238 imágenes ajenas al dominio conserva la misma precisión (85,7 %) que uno compilado sin ajuste. Un conjunto pequeño del dominio es mejor que uno grande ajeno al dominio.
- Reduce
confen torno a 0,05 para implementaciones de YOLO26. La cuantización reduce las puntuaciones de YOLO26 alrededor de 0,05 de media, por lo que un umbral ajustado en PyTorch descarta detecciones válidas en el HEF. Usarconf=0.20en el dispositivo iguala el número de detecciones de PyTorch conconf=0.25; reducirlo un poco más (hasta aproximadamenteconf=0.15) recupera prácticamente toda la diferencia restante de mAP50, a costa de obtener más detecciones con baja confianza. La cuantización también cambia el orden de aproximadamente el 20 % de las detecciones, un efecto permanente que ningún umbral puede deshacer; sin embargo, ese reordenamiento no impide recuperar el mAP50 con el umbral más bajo. - La penalización de la atención es estructural en Hailo-8/8L (DFC 3.33). Los bloques de atención se compilan en operaciones
matmulque mantienen entradas de activación INT8 en todos los modos que ofrece el compilador; el modo de salida de 16 bits no consigue asignar memoria para este grafo, y aumentar la precisión de las capas circundantes no ayuda porque la multiplicación de matrices vuelve a cuantizar sus entradas a INT8 (en nuestras pruebas, proteger las convoluciones separables en profundidad y las de salida con 16 bits no cambió el mAP). Si la prioridad es la precisión y puedes elegir entre modelos equivalentes, YOLO11 se cuantiza mejor que YOLO26 en este caso; las generaciones más recientes de Hailo (DFC 5.x) ofrecen más opciones de precisión mixta y pueden dar resultados distintos.
Artefactos exportados#
La exportación crea un directorio que contiene el HEF listo para implementar y los metadatos de Ultralytics:
yolo11n_hailo_model/
├── yolo11n.hef
├── metadata.yaml
└── nms_config.json*.hefes el modelo compilado que carga HailoRT.metadata.yamlconserva los nombres de los modelos, la tarea, el tamaño de entrada, el stride y la información del destino Hailo.nms_config.jsonregistra la configuración de NMS de HailoRT generada para los modelos de detección YOLOv8 y YOLO11. La detección con YOLO26 y todas las tareas que no son de detección (segmentación, semántica, profundidad, clasificación, pose y OBB) no utilizan este archivo.
El grafo ONNX intermedio se elimina tras la compilación.
Ejecutar inferencias en hardware Hailo#
Instala HailoRT en el dispositivo de destino. Si usas Raspberry Pi AI HAT+ o AI HAT+ 2, sigue la guía de software de Raspberry Pi AI. En Raspberry Pi OS no se pueden instalar juntos los dos conjuntos de paquetes, así que ejecuta solo el bloque correspondiente a tu hardware y, después, reinicia.
Para AI HAT+ (Hailo-8 / Hailo-8L):
sudo apt install dkms
sudo apt install hailo-all
sudo reboot
Para AI HAT+ 2 (Hailo-10H, Raspberry Pi OS Trixie o posterior):
sudo apt install dkms
sudo apt install hailo-h10-all
sudo reboot
Después de reiniciar, confirma que se detecta el acelerador:
hailortcli fw-control identifyLos paquetes hailo-all y hailo-h10-all solo instalan HailoRT en Raspberry Pi OS. En cualquier otro sistema, descarga e instala el paquete de HailoRT desde Hailo Developer Zone, la misma fuente que DFC.
Copia todo el directorio de exportación en el dispositivo para que metadata.yaml permanezca junto al HEF. Ultralytics utiliza HailoRT para ejecutar predict y val directamente desde el directorio exportado:
from ultralytics import YOLO

model = YOLO("yolo11n_hailo_model")
results = model.predict("path/to/image.jpg")
En los modelos de detección, el backend convierte la salida NMS de HailoRT de YOLOv8/YOLO11 y decodifica automáticamente cualquiera de las dos cabezas de YOLO26. Las salidas predeterminadas de uno a muchos pasan por el NMS del predictor. El backend decodifica los tensores sin procesar de segmentación, pose y OBB; devuelve las probabilidades de clasificación calculadas en el chip; y genera mapas de clases semánticas mediante reducción en el host en Hailo-8/8L y en todas las cabezas de una sola clase, o mediante ArgMax en el chip para las cabezas multiclase de Hailo-10H/15. TAPPAS, GStreamer y el asistente picamera2.devices.Hailo de Raspberry Pi siguen disponibles para las canalizaciones específicas de cada aplicación.
Para una implementación con GStreamer, pasa el HEF a hailonet:
gst-launch-1.0 filesrc location=video.mp4 ! decodebin ! videoconvert ! \
  hailonet hef-path=yolo11n_hailo_model/yolo11n.hef ! \
  hailofilter function-name=yolov8 ! hailooverlay ! autovideosink
Opciones de implementación de Hailo#
El HEF es el mismo artefacto de modelo implementable en varias interfaces de ejecución de Hailo. Elige la interfaz que mejor se adapte a la aplicación:
| Opción de ejecución | Más adecuado para |
|---|---|
| API Python o C/C++ de HailoRT | Aplicaciones personalizadas y control directo de la inferencia |
picamera2.devices.Hailo de Raspberry Pi | Proyectos con Camera Module en Raspberry Pi |
| GStreamer y aplicaciones Hailo | Flujos de vídeo en tiempo real y canalizaciones de varias etapas |
hailortcli | Comprobaciones del dispositivo, inspección de HEF y pruebas de rendimiento |
Guarda metadata.yaml junto al HEF si la aplicación necesita los nombres de clase de Ultralytics, el tamaño de entrada, el stride u otra información del modelo. El HEF no sustituye la lógica de la aplicación para capturar imágenes de la cámara, visualizar, seguir objetos, generar alertas o almacenar datos.
Verificar el dispositivo Hailo y el HEF#
Antes de integrar una cámara o una canalización de vídeo, comprueba el entorno de ejecución y el acelerador por separado:
hailortcli fw-control identify
hailortcli parse-hef yolo11n_hailo_model/yolo11n.hef
Las mediciones de rendimiento solo del dispositivo aíslan la inferencia de Hailo de la decodificación de vídeo, el cambio de tamaño de las imágenes, el dibujo y las operaciones de entrada/salida de la aplicación. Mide la aplicación completa por separado para calcular la latencia de extremo a extremo o los fotogramas por segundo.
Pruebas de rendimiento#
El equipo de Ultralytics comparó el rendimiento de los modelos YOLO26 en velocidad y precisión entre PyTorch y Hailo.
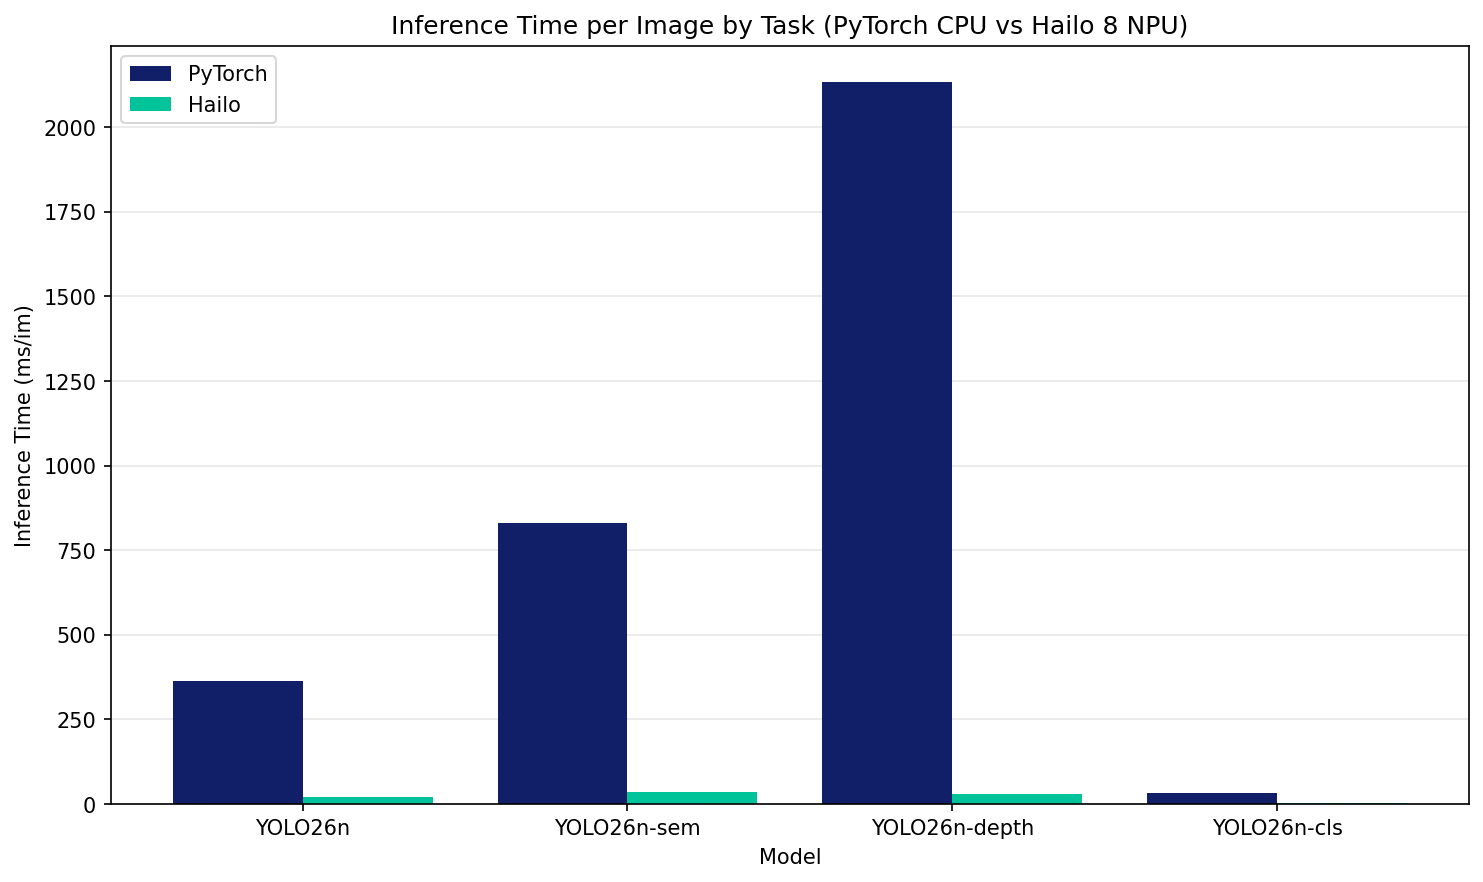
| Modelo | Formato | Estado | Tamaño (MB) | metrics/mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.477 | 364.6 |
| YOLO26n | Hailo | ✅ | 7.3 | 0.455 | 21.7 |
| Modelo | Formato | Estado | Tamaño (MB) | metrics/mIoU | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|
| YOLO26n-sem | PyTorch | ✅ | 3.3 | 0.611 | 831.2 |
| YOLO26n-sem | Hailo | ✅ | 6.2 | 0.611 | 34.8 |
| Modelo | Formato | Estado | Tamaño (MB) | metrics/delta1 | metrics/abs_rel | metrics/rmse | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|---|
| YOLO26n-depth | PyTorch | ✅ | 12.4 | 0.8535 | 0.0983 | 0.2047 | 2133.4 |
| YOLO26n-depth | Hailo | ✅ | 9.9 | 0.8241 | 0.1232 | 0.2554 | 29.6 |
| Modelo | Formato | Estado | Tamaño (MB) | precisión (top1) | precisión (top5) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n-cls | PyTorch | ✅ | 5.5 | 0.431 | 0.716 | 33.8 |
| YOLO26n-cls | Hailo | ✅ | 3.5 | 0.441 | 0.716 | 2.0 |
La validación de las pruebas de rendimiento anteriores se realizó con COCO128 para detección, Cityscapes8 para segmentación semántica, Depth8 para estimación de profundidad e ImageNet100 para clasificación. Cityscapes8 y Depth8 contienen solo 4 imágenes de validación cada uno, así que considera los valores de precisión de segmentación semántica y profundidad como resultados de pruebas de humo, no como mediciones de mantenimiento de la precisión; valida con un conjunto de datos completo, como Cityscapes o NYU Depth V2, antes de sacar conclusiones sobre la precisión. El tiempo de inferencia no incluye el preprocesamiento ni el posprocesamiento.
Hailo en comparación con otros formatos de exportación de YOLO#
Elige un formato de exportación según el hardware que vaya a ejecutar el modelo. HEF es específico del hardware y conviene elegirlo cuando el dispositivo final ya incluye un acelerador Hailo, no como formato de propósito general o automáticamente más rápido para el perímetro.
| Destino de implementación o prioridad | Formato de Ultralytics recomendado | Comparación con Hailo |
|---|---|---|
| NPU Hailo o HAT de Raspberry Pi existente | Hailo HEF (format="hailo") | Utiliza el acelerador Hailo y la pila HailoRT instalados |
| Nueva NPU M.2 o SBC con limitaciones de consumo | DeepX | Empieza aquí si buscas más rendimiento de YOLO y un mejor rendimiento por vatio |
| NPU perimetral de alto rendimiento con varios flujos | Axelera | Evalúala si buscas mayor densidad de flujos y rendimiento en hardware de aceleración más reciente |
| GPU NVIDIA | TensorRT | Utiliza kernels de GPU NVIDIA con opciones FP16 e INT8 en lugar de una NPU independiente |
| CPU, GPU o NPU Intel | OpenVINO | Aprovecha los aceleradores ya integrados en los sistemas Intel |
| Hardware Apple | CoreML | Utiliza Apple Neural Engine, GPU y CPU mediante el entorno de ejecución nativo de Apple |
| NPU Qualcomm Snapdragon | QNN | Compila para la NPU integrada de Qualcomm en lugar de requerir un acelerador externo |
| NPU de Rockchip | RKNN | Muy utilizado en SBC asequibles y sistemas integrados |
| NPU Huawei Ascend | Ascend | Compila un modelo CANN .om para el núcleo de IA Ascend en placas Atlas y OrangePi AIPro |
| Google Coral Edge TPU | Edge TPU | Ejecuta un modelo LiteRT INT8 en el acelerador Coral en lugar de un módulo Hailo |
| SoC Ambarella CVflow | Ambarella | Compila para los SoC Ambarella de cámaras y visión integrada |
| Cámara AI de Raspberry Pi | Sony IMX500 | Ejecuta la red en el sensor de la cámara en lugar de mediante un acelerador Hailo conectado al host |
| CPU/GPU móvil o integrada | NCNN | Ofrece un entorno de ejecución portátil y ligero cuando no se dispone de una NPU compatible dedicada |
| Implementación portátil entre entornos de ejecución | ONNX | Mantiene la portabilidad entre entornos de ejecución; HailoRT no puede ejecutar ONNX sin compilarlo primero a HEF |
No des por hecho que Hailo es más rápido o eficiente energéticamente solo porque sea una NPU. Para nuevas implementaciones M.2, DeepX es una opción más sólida si buscas un mayor rendimiento de YOLO y un mejor rendimiento por vatio, mientras que Axelera está orientada a un rendimiento considerablemente mayor con varios flujos. Rockchip es una opción popular y más económica para SBC y sistemas integrados. Las cifras de TOPS y consumo de los fabricantes no son comparables directamente con las pruebas de rendimiento de una aplicación, así que valida el mismo punto de control YOLO, tamaño de entrada, precisión, host y canalización de vídeo completa en los dispositivos candidatos antes de comprar hardware.
Optimizar el rendimiento de visión artificial en Hailo#
Las decisiones sobre el modelo y la canalización suelen importar más que las opciones del compilador:
- Empieza con un modelo YOLO pequeño y aumenta su tamaño solo cuando la precisión lo requiera.
- Elige el
imgszfijo más bajo que conserve los objetos importantes para la aplicación. - Siempre que sea posible, utiliza imágenes de calibración de la cámara y el entorno reales.
- Mantén activa la red Hailo entre fotogramas en lugar de volver a abrir el HEF para cada inferencia.
- Separa el tiempo de inferencia del dispositivo del preprocesamiento, la decodificación de vídeo, el posprocesamiento, la visualización y las operaciones de entrada/salida de red.
- Usa una canalización de streaming, como GStreamer, para cargas de vídeo sostenidas.
- Valida el HEF exportado en el acelerador exacto y con la versión de HailoRT que se usan en producción.
Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
name | str | hailo8l | Arquitectura del acelerador Hailo de destino |
imgsz | int, list | 640 | Tamaño fijo de entrada del modelo |
data | str | None | Archivo YAML del conjunto de datos de calibración; para clasificación, en su lugar se acepta un directorio del conjunto de datos o el nombre de un conjunto de datos integrado. Si se omite, Ultralytics selecciona un conjunto de datos de calibración específico para la tarea. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
quantize | int | 8 | La exportación a Hailo usa cuantización INT8 |
simplify | bool | True | Simplifica el grafo ONNX intermedio |
conf | float | 0.25 | Umbral de confianza de NMS de HailoRT para YOLOv8/YOLO11 |
iou | float | 0.7 | Umbral de IoU de NMS de HailoRT para YOLOv8/YOLO11 |
device | str | None | Dispositivo para el paso de exportación a ONNX intermedio; CPU de forma predeterminada (device=cpu). Los pasos de Dataflow Compiler no lo usan. |
Las exportaciones de detección de YOLOv8/YOLO11 reciben NMS de HailoRT. De forma predeterminada, YOLO26 genera salidas crudas de uno a muchos para aplicar NMS en el host; nms=False selecciona sus salidas de uno a uno sin NMS. La segmentación, la pose y OBB usan tensores crudos de la cabeza; la clasificación devuelve probabilidades calculadas en el chip, y la segmentación semántica devuelve logits crudos en Hailo-8/8L y en todas las cabezas de una sola clase, o mapas de clases precalculados para las cabezas multiclase de Hailo-10H/15. La estimación de profundidad devuelve el logit de profundidad crudo, que Ultralytics decodifica en un mapa de profundidad métrico durante la inferencia. No se admiten formas dinámicas, NMS integrado de Ultralytics, FP16 ni FP32.
Solución de problemas de la exportación a Hailo#
Error al importar Hailo Dataflow Compiler#
Si la exportación indica que falta hailo_sdk_client, instala la rueda de DFC correspondiente a la generación del hardware de destino en el mismo entorno de Python que Ultralytics. Hailo-8/8L y Hailo-10H/15 requieren generaciones de compilador distintas.
Sistema operativo o arquitectura no compatibles#
La compilación de HEF es compatible con Linux x86_64. Exporta a través de Ultralytics Platform o usa una estación de trabajo compatible si tu ordenador local tiene macOS, Windows, Raspberry Pi u otro sistema ARM.
La exportación tarda mucho#
La optimización de DFC es la fase que más recursos consume. El tiempo de compilación aumenta con el tamaño del modelo, la resolución de entrada y los datos de calibración. Una GPU compatible puede acelerar la optimización, mientras que la compilación solo con CPU puede ser considerablemente más lenta.
La precisión del modelo cuantizado disminuye#
Usa imágenes de calibración similares a las entradas de producción que incluyan los objetos, las escalas, las condiciones de iluminación y los fondos importantes. Compara el modelo PyTorch original y el HEF exportado con el mismo conjunto de validación antes del despliegue. Incluso con una buena calibración, se mantiene una diferencia moderada que depende de la familia; consulta Expectativas de precisión por familia de modelos para ver los valores de referencia medidos.
El HEF no se carga en el dispositivo#
Confirma que name coincide con la arquitectura física de Hailo y que el controlador del dispositivo, el firmware y los paquetes de HailoRT son compatibles entre sí. Inspecciona el artefacto con hailortcli parse-hef y verifica el acelerador con hailortcli fw-control identify.
El análisis de las salidas parece incorrecto#
Mantén metadata.yaml junto al HEF para que Ultralytics pueda seleccionar la ruta de posprocesamiento correspondiente a YOLOv8, YOLO11 o YOLO26. Las aplicaciones personalizadas de HailoRT también deben adaptar el posprocesamiento a la familia del modelo exportado.
Resumen#
La exportación de Ultralytics a Hailo ofrece una ruta directa desde un modelo YOLO entrenado hasta un HEF listo para desplegar:
- Carga un modelo de detección o clasificación YOLOv8, YOLO11 o YOLO26; un modelo YOLOv8/YOLO11 de segmentación, pose u OBB; o un modelo YOLO26 de segmentación semántica o estimación de profundidad.
- Exporta con
format="hailo"y selecciona la arquitectura de destino. - Calibra y compila en local con el DFC correspondiente, o usa la exportación gestionada de Ultralytics Platform.
- Copia el HEF y
metadata.yamlal dispositivo perimetral con Hailo. - Ejecuta la inferencia con HailoRT, Raspberry Pi Picamera2 o una canalización de vídeo de GStreamer.
Para otros destinos de despliegue de visión artificial, consulta el modo de exportación, el modo de evaluación comparativa y la guía de integraciones. Entre las guías relacionadas sobre hardware se incluyen DeepX, Axelera, ONNX, OpenVINO, TensorRT, NCNN, RKNN, Sony IMX500 y Qualcomm QNN.
Preguntas frecuentes#
No. Ejecuta el DFC en un sistema Linux x86_64 compatible y despliega el HEF resultante en la Raspberry Pi.
Una GPU compatible reduce considerablemente el tiempo de optimización de DFC. Es posible compilar con CPU, pero puede tardar bastante más.
La exportación directa admite modelos de detección con la cabeza de detección estándar de YOLOv8, YOLO11 o YOLO26; modelos YOLOv8/YOLO11 de segmentación, pose y OBB; y modelos YOLOv8/YOLO11/YOLO26 de clasificación. Esto incluye modelos entrenados de forma personalizada a partir de esas arquitecturas estándar. También se admiten modelos YOLO26 de segmentación semántica y estimación de profundidad. YOLO26 de segmentación de instancias, pose y OBB, así como YOLOv10, YOLO-World, YOLOE y RT-DETR, se rechazan en lugar de generar un HEF sin validar.
Sí. Usa el mismo comando
format="hailo"con los pesos personalizados.pty pasa el YAML del conjunto de datos de entrenamiento mediantedatapara una calibración INT8 representativa. Los nombres y la cantidad de clases se obtienen de los metadatos del modelo.Cada HEF se compila para una forma de entrada fija, por lo que no es posible cambiar dinámicamente el tamaño de un mismo HEF. En la práctica, puedes cambiar el tamaño de las entradas en el host para ajustarlas al tamaño compilado o compilar varios HEF para las resoluciones que necesites. Elige
imgszdurante la exportación para que coincida con la canalización de despliegue.YOLO26 usa regresión de cajas sin DFL, por lo que ambas cabezas se compilan en tensores crudos en lugar de usar la canalización de NMS de HailoRT propia de YOLOv8. De forma predeterminada, Ultralytics decodifica los tensores y aplica NMS, o devuelve detecciones sin NMS si se exporta con
nms=False.Hailo Dataflow Compiler convierte y cuantiza el modelo en un HEF específico para el hardware en una máquina de compilación Linux x86_64. HailoRT carga y ejecuta ese HEF en el dispositivo de destino.
Despliega el HEF compilado en el entorno de ejecución de Hailo. ONNX es una representación intermedia que se usa durante la exportación y se elimina tras compilar correctamente.
Descarga la rueda del compilador correspondiente a tu generación de hardware desde Hailo Developer Zone. El compilador solo es necesario para crear el HEF; HailoRT lo ejecuta en el acelerador de destino.