Exportación a Qualcomm QNN para modelos Ultralytics YOLO#
Para implementar modelos de visión artificial en dispositivos Qualcomm Snapdragon se necesita un formato de modelo adaptado al entorno de ejecución Qualcomm AI Engine Direct (QNN). Exportar modelos Ultralytics YOLO al formato QNN permite ejecutar inferencias aceleradas en el propio dispositivo, mediante CPU Snapdragon, GPU Adreno y hardware NPU Hexagon presente en miles de millones de teléfonos móviles, portátiles, sistemas de automoción y dispositivos IoT. Esta guía explica cómo exportar YOLO a Qualcomm QNN e implementarlo para obtener inferencias rápidas y de bajo consumo en hardware Snapdragon.
El complemento oficial de Ultralytics para Flutter ofrece compatibilidad opcional con QNN para inferencias de cámara en tiempo real y predicciones de imágenes individuales en las siete tareas de YOLO26. Activa el entorno de ejecución QNN y añade su dependencia de ONNX Runtime, tal como se describe en el README del complemento. Para la implementación en iOS, consulta el SDK de Ultralytics YOLO para iOS y la integración con CoreML.
Exporta los modelos de clasificación en imgsz=224. Exporta los modelos de detección, segmentación, segmentación semántica, profundidad, pose y OBB en imgsz=640. Este estándar 224/640 es común a los recursos móviles oficiales de QNN, LiteRT y CoreML. Los recursos v73 y v81 listos para ejecutar para las siete tareas nano están publicados en la versión yolo-flutter-app v0.6.6.
¿Qué es Qualcomm QNN?#
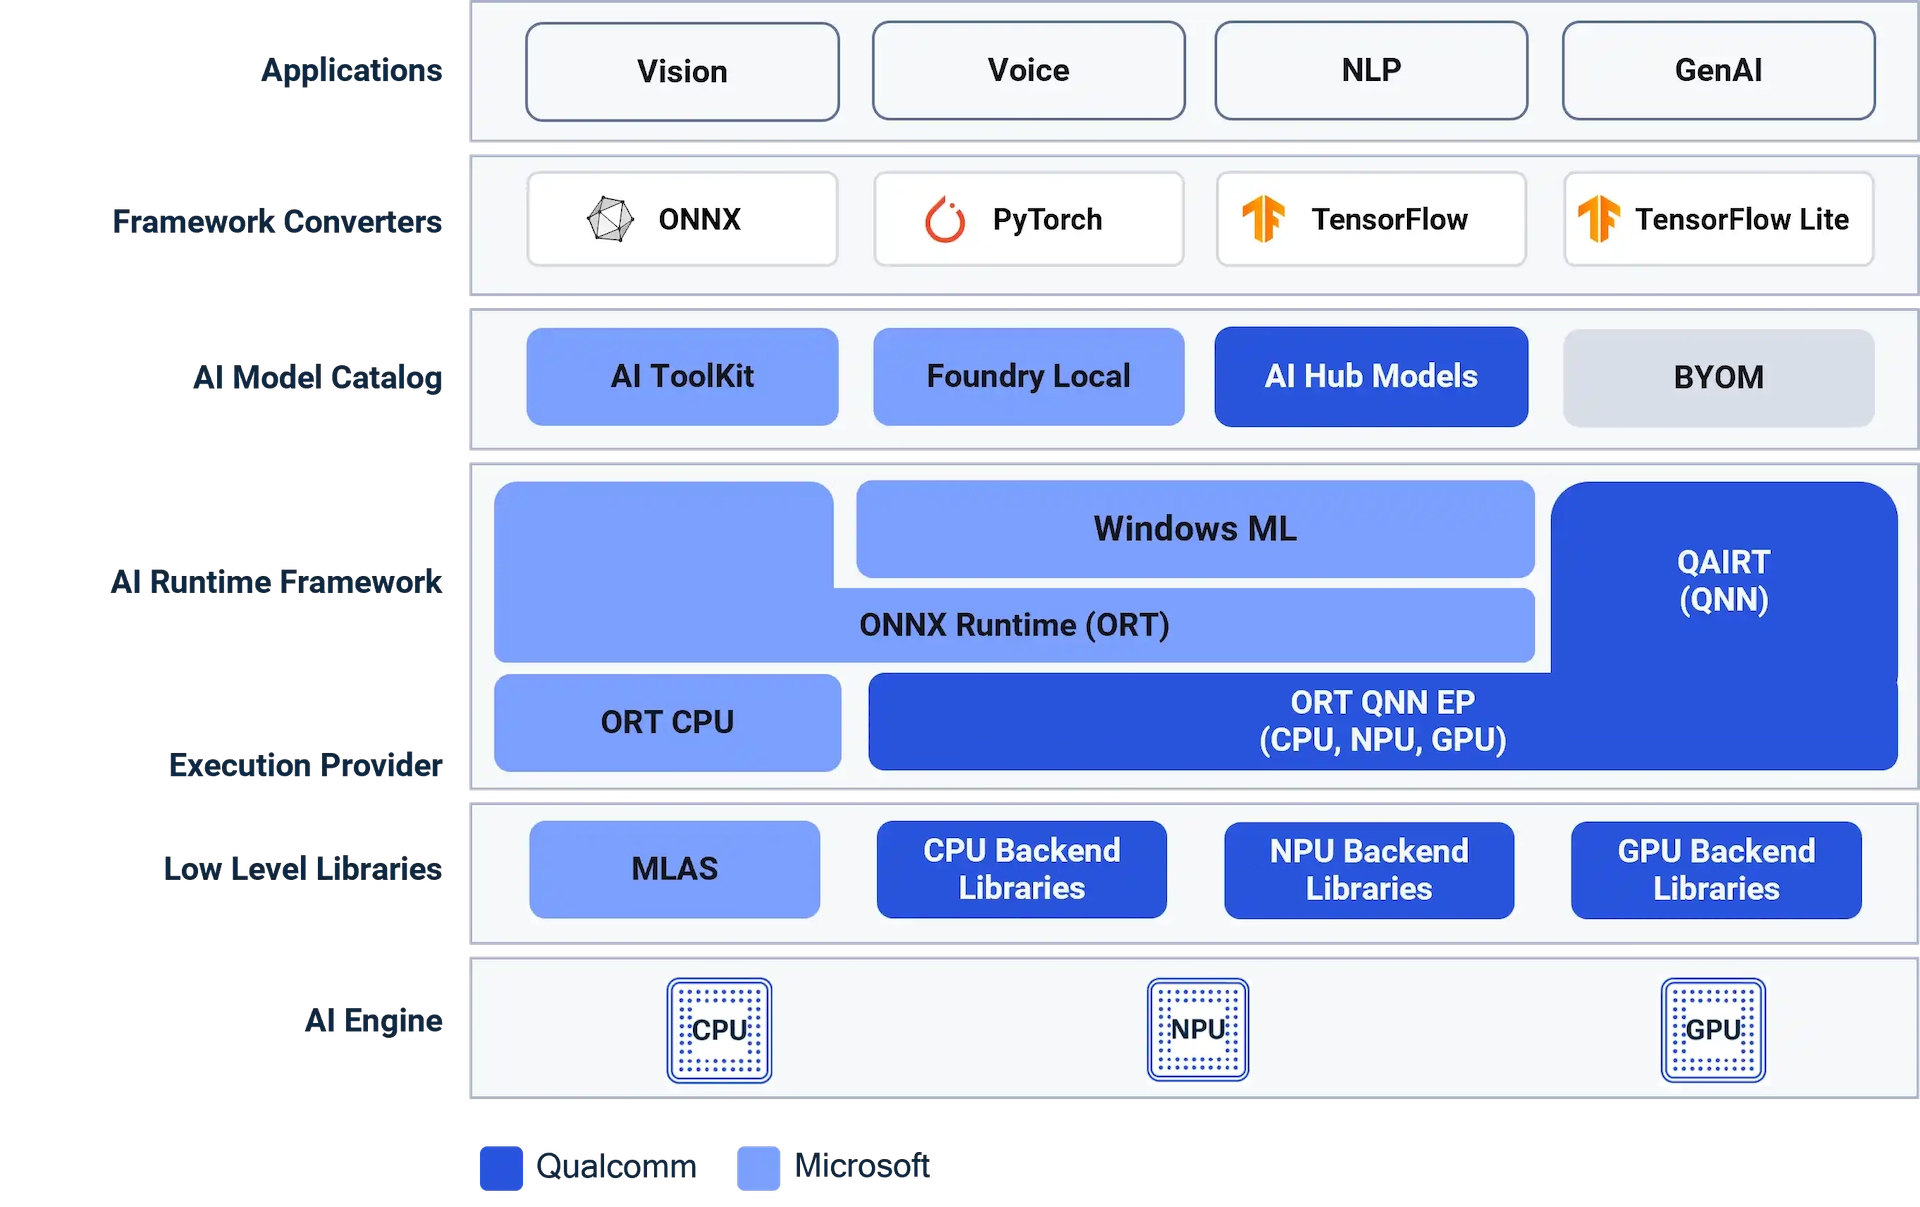
Qualcomm AI Engine Direct — conocido habitualmente como QNN y distribuido como parte del SDK Qualcomm AI Runtime (QAIRT) — es la pila de inferencia de bajo nivel de Qualcomm para procesadores Snapdragon. Ofrece una API unificada con bibliotecas específicas para cada backend, dirigidas a la CPU Snapdragon, la GPU Adreno y el procesador tensorial Hexagon (HTP), la unidad de procesamiento de redes neuronales (NPU) dedicada que incorporan los SoC Snapdragon modernos. QNN proporciona a los desarrolladores acceso a toda la pila de estos aceleradores de IA Snapdragon y es el sucesor moderno del antiguo SDK Snapdragon Neural Processing Engine (SNPE). Impulsa la IA en el propio dispositivo en las plataformas móviles Snapdragon 8 Gen 2, 8 Gen 3 y 8 Elite, los portátiles Snapdragon X y los productos de automoción y XR.
¿Por qué exportar a Qualcomm QNN?#
Snapdragon es la plataforma de computación móvil más extendida del mundo. Exportar Ultralytics YOLO al formato Qualcomm QNN permite aprovechar el hardware de IA dedicado de estos dispositivos:
- Aceleración de la NPU Hexagon: Ejecutar YOLO en el procesador tensorial Hexagon ofrece un rendimiento muy superior y un consumo menor que la inferencia en CPU, algo ideal para la inferencia en tiempo real y la visión artificial siempre activa en Snapdragon.
- En el dispositivo y sin conexión: La inferencia QNN se ejecuta íntegramente en el dispositivo Snapdragon, así que no hay comunicaciones de ida y vuelta con la nube, la latencia se mantiene baja y los datos nunca salen del dispositivo.
- Eficiencia de la cuantización: La exportación QNN cuantiza YOLO con pesos INT8 y activaciones de 16 bits, el equilibrio entre precisión y rendimiento preferido por la NPU Hexagon. Así reduce el tamaño del modelo y maximiza los fotogramas por segundo en hardware alimentado por batería.
- Un formato para muchos dispositivos: Una única exportación a Qualcomm QNN es compatible con la CPU Snapdragon, la GPU Adreno y la NPU Hexagon de las familias Snapdragon 8 Gen 2, 8 Gen 3 y 8 Elite, entre otras.
- Pila de IA de Qualcomm lista para producción: QNN (Qualcomm AI Engine Direct / QAIRT) es el entorno de ejecución de IA actual de Qualcomm para dispositivos, recibe mantenimiento activo y es la alternativa recomendada a SNPE.
Formato de exportación QNN#
Ultralytics compila los modelos YOLO a QNN localmente mediante el proveedor de ejecución QNN de ONNX Runtime (el paquete onnxruntime-qnn, instalable con pip, que incluye las bibliotecas QAIRT). El exportador convierte el modelo a ONNX, lo cuantiza con datos de calibración para obtener activaciones de 16 bits y pesos INT8 (el equilibrio recomendado para la NPU Hexagon) y, a continuación, inicializa una sesión de ONNX Runtime con el almacenamiento en caché del binario de contexto activado; esto compila el grafo cuantizado en un binario de contexto QNN integrado en <model>_qnn.onnx. No hace falta una cuenta de Qualcomm, subir archivos a la nube ni descargar un SDK por separado.
A diferencia de Qualcomm AI Hub, basado en la nube, que compila y perfila modelos en dispositivos Snapdragon alojados por Qualcomm y requiere una cuenta de Qualcomm, la exportación QNN de Ultralytics se ejecuta íntegramente en tu propio equipo con una sola llamada a export(format="qnn", imgsz=640) (imgsz=224 para clasificación). Obtienes el mismo destino de ejecución QNN/QAIRT — CPU Snapdragon, GPU Adreno y NPU Hexagon — sin registrarte, límites de carga ni tiempos de espera, y se integra directamente en el flujo de trabajo de exportación estándar de YOLO.
El archivo *_qnn.onnx exportado es autónomo: incluye el binario de contexto QNN y metadatos de ONNX, como los nombres de las clases, el tamaño de imagen y la tarea.
Funciones principales de los modelos QNN#
- Cuantización: El modelo se cuantiza con activaciones de 16 bits y pesos INT8 mediante el flujo QDQ de ONNX Runtime QNN y un conjunto de datos de calibración, el equilibrio entre precisión y rendimiento recomendado para la NPU Hexagon. Más información sobre la cuantización de modelos.
- Compilación íntegramente local: El binario de contexto se genera por completo en tu equipo anfitrión, sin cuenta de Qualcomm, token de API ni cargas a la nube.
- Aceleración completa de Snapdragon: Ejecuta inferencias en la NPU Hexagon (HTP), la GPU Adreno o la CPU mediante un único entorno de ejecución unificado.
- Amplia compatibilidad con dispositivos: Compatible con la amplia gama de plataformas Snapdragon que se encuentran en teléfonos, PC (Windows en Snapdragon), automoción, XR y productos integrados.
- Binario de contexto precompilado: Distribuir un binario de contexto minimiza la compilación del grafo en el dispositivo y reduce la latencia de carga del modelo en el dispositivo de destino.
- Resultado autónomo: El archivo ONNX exportado incluye el binario de contexto QNN precompilado y metadatos para facilitar la implementación.
Rendimiento medido#
Teléfono Android#
Hardware: Xiaomi 17 con 12 GB de memoria LPDDR5X y Android 16 / API 36. Su Snapdragon 8 Elite Gen 5 de 3 nm (SM8850) cuenta con una CPU Qualcomm Oryon de 8 núcleos (2 núcleos Prime de hasta 4,6 GHz y 6 núcleos Performance de hasta 3,62 GHz), GPU Adreno y NPU Hexagon (HTP v81).
| Modelo | Tarea | tamaño (píxeles) | CPU w8a32 LiteRT (ms) | GPU w8a32 LiteRT (ms) | NPU QNN W8A16 (ms) |
|---|---|---|---|---|---|
| YOLO26n | Detección | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | Segmentación | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | Semántica | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | Profundidad | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | Clasificar | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | Pose | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- Los valores de velocidad son latencias de ráfaga de una sola imagen: la media de 15 ejecuciones tras 3 ejecuciones de calentamiento en
bus.jpg, medida con el arnés de pruebas de rendimiento en el dispositivo0.6.10del complemento de Flutter y los recursos estandarizadosv0.6.6. El orden de los backends fue rotando entre tareas en una única secuencia. Los registros nativos confirmaron que todas las filas de CPU utilizaron LiteRT CPU/XNNPACK, todas las filas de GPU delegaron el grafo completo a LiteRT OpenCL (LITERT_CL) y todas las filas de NPU utilizaron el backend QNN Hexagon HTP. - El registro detallado de las pruebas de rendimiento está disponible en el documento de rendimiento de Flutter.
- Compara otros dispositivos Android en la integración con LiteRT y dispositivos Apple en la integración con CoreML.
Portátil con Windows en Snapdragon#
Esta prueba histórica utilizó binarios QNN v73 anteriores a la estandarización; la segmentación semántica y OBB utilizaron entradas de 1024 px. Se ejecutó en un portátil Lenovo con 32 GB de memoria y Windows 11. Su Snapdragon X Elite (X1E78100) cuenta con una CPU Qualcomm Oryon de 12 núcleos, GPU Adreno y NPU Hexagon (HTP v73); no se registró el modelo exacto de Lenovo. Esta comparación de Windows en Snapdragon ejecuta la referencia nativa de CPU PyTorch FP32 con la que empiezan la mayoría de los desarrolladores de equipos de sobremesa frente a la ruta ONNX Runtime QNN Hexagon HTP. Cada celda muestra el tiempo de ejecución total de model.predict() y, debajo, los tiempos comunicados de preprocesamiento / inferencia / posprocesamiento; el total puede incluir la sobrecarga del framework ajena a estas tres etapas. Los valores de CPU corresponden a PyTorch FP32 (torch==2.10.0+cpu) y los de NPU, a ONNX Runtime QNN (onnxruntime-qnn==2.2.0, pesos INT8 / activaciones de 16 bits).
| Modelo | Tarea | tamaño (píxeles) | CPU PT FP32 (ms) | NPU Hexagon QNN W8A16 (ms) |
|---|---|---|---|---|
| YOLO26n | Detección | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | Segmentación | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | Semántica | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | Clasificar | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | Pose | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Los valores de Speed son latencias de ráfaga de una sola imagen: la media de 100 ejecuciones tras 10 ejecuciones de calentamiento en
bus.jpg, medidas contime.perf_counter()alrededor de la llamada completa amodel.predict()en un dispositivo que ha recuperado su temperatura normal (ultralytics==8.4.67, Python 3.12.10). - La NPU Hexagon es aproximadamente 2-4 veces más rápida que la referencia de CPU con PyTorch en las tareas de 640-1024 px (~3.4 veces en detección); la diferencia se reduce a ~1.3 veces en el clasificador de 224 px, donde domina la sobrecarga fija del preprocesamiento frente a la pequeña carga de trabajo.
Tareas compatibles#
La exportación de Qualcomm QNN es compatible con las siete tareas de Ultralytics. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esas cabezas.
| Tarea | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detectar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semántica | ❌ | ❌ | ✅ |
| Profundidad | ❌ | ❌ | ✅ |
| Clasificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportar a QNN: convertir tu modelo YOLO#
Exporta un modelo Ultralytics YOLO al formato QNN para implementarlo en hardware de Qualcomm. El binario de contexto se finaliza para una arquitectura Hexagon Tensor Processor (HTP) de destino o un SoC compatible, que se selecciona con el argumento name, el mismo argumento que se usa para seleccionar un chip al exportar a RKNN.
Destinos HTP compatibles#
Indica la arquitectura de destino o el SoC mediante name (por ejemplo, name="73" o name="iq-8275"). La compatibilidad depende del destino HTP, por lo que las filas de Snapdragon de abajo muestran plataformas representativas, no una lista exhaustiva de todos los SoC. Los dispositivos Dragonwing se indican explícitamente.
| Estado | name | Hexagon HTP | Dispositivo o plataforma de ejemplo |
|---|---|---|---|
| ✅ Compatible | 68 | v68 | Snapdragon 888 |
| ✅ Compatible | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ Compatible | 73 | v73 | Snapdragon 8 Gen 2, X Elite (predeterminado) |
| ✅ Compatible | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ Compatible | 79 | v79 | Snapdragon 8 Elite |
| ✅ Compatible | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ Compatible | iq-8275 o qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275 (modelo QNN SoC 82) |
| ❌ No compatible | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 no puede usar la exportación de Ultralytics a binario de contexto QNN porque ONNX Runtime no expone su DSP v66 como destino HTP sin conexión. Aun así, puedes integrar por separado una exportación ONNX estándar con un proveedor de ejecución de CPU o GPU compatible con el BSP de la placa.
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)La exportación QNN usa el paquete onnxruntime-qnn. A partir de la versión 2.4.0, publica wheels precompiladas para Windows (x64 y ARM64) y Linux (x86-64 y ARM64) con Python 3.11 o posterior; macOS no es un sistema anfitrión QNN compatible. La generación del binario de contexto QNN se ejecuta en un sistema anfitrión x64 y no requiere un dispositivo Snapdragon para el proceso de exportación.
Instalación#
Para instalar los paquetes necesarios, ejecuta:
# Install the required package for YOLO
pip install ultralytics
El paquete onnxruntime-qnn (que proporciona el proveedor de ejecución QNN de ONNX Runtime e incluye las bibliotecas QAIRT) se instala automáticamente en la primera exportación. Para obtener instrucciones detalladas y recomendaciones sobre el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes algún problema al instalar los paquetes necesarios para YOLO, consulta nuestra guía de problemas frecuentes, donde encontrarás soluciones y consejos.
Uso#
El formato QNN es compatible con los modos Export, Predict y Validate. La inferencia y la validación se ejecutan en hardware Qualcomm Snapdragon mediante el proveedor de ejecución QNN de ONNX Runtime (el mismo paquete onnxruntime-qnn que se usa para la exportación). Exporta tu modelo y, después, cárgalo en un dispositivo Snapdragon para ejecutar la inferencia o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# # Exportar al formato Qualcomm QNN (INT8, aplicado automáticamente) para el destino HTP v73 predeterminado
model.export(format="qnn", name="73", imgsz=640) # usa imgsz=224 para clasificaciónfrom ultralytics import YOLO
# # Cargar el modelo QNN exportado (en un dispositivo Snapdragon con onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # Cargar el modelo QNN exportado (en un dispositivo Snapdragon con onnxruntime-qnn)
model = YOLO("yolo26n_qnn.onnx")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'qnn' | Formato de destino del modelo exportado, que define la compatibilidad con el entorno de ejecución Qualcomm QNN. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un entero para imágenes cuadradas o una tupla (height, width). |
batch | int | 1 | Especifica el tamaño de lote del modelo de exportación, que se integra en el binario de contexto QNN generado. |
name | str | '73' | Arquitectura Hexagon HTP de destino (68, 69, 73, 75, 79 o 81) o SoC compatible (iq-8275 o qcs8275). El binario de contexto se finaliza para este destino. |
quantize | int o str | 'w8a16'/auto | Precisión de cuantización. La exportación QNN HTP se cuantiza con pesos INT8 y activaciones de 16 bits ('w8a16') y se activa automáticamente si no se especifica. Sustituye a las opciones obsoletas half/int8. |
simplify | bool | True | Simplifica el grafo ONNX intermedio con onnxslim. |
opset | int | None | Especifica la versión del conjunto de operaciones de ONNX para el grafo ONNX intermedio. Si no se establece, se utiliza la última versión compatible. |
data | str | None | Archivo YAML del conjunto de datos usado para la calibración INT8; en clasificación, en su lugar se indica un directorio del conjunto de datos o el nombre de un conjunto de datos integrado. Si lo omites, Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para el paso de exportación ONNX: GPU (device=0) o CPU (device=cpu). |
La exportación QNN cuantiza el modelo con activaciones de 16 bits y pesos INT8 —el equilibrio recomendado entre precisión y rendimiento para la NPU Hexagon— mediante el flujo de cuantización QDQ de ONNX Runtime, con imágenes de calibración de data. quantize='w8a16' se aplica automáticamente.
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
Estructura de salida#
Tras una exportación correcta, se crea un archivo ONNX autónomo:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
El archivo yolo26n_qnn.onnx incorpora el binario de contexto QNN y ONNX Runtime lo carga con el proveedor de ejecución QNN en el dispositivo Snapdragon. También contiene metadatos del modelo, como los nombres de las clases, el tamaño de imagen y la tarea, en ONNX metadata_props.
Implementar modelos YOLO QNN exportados#
Los modelos QNN se ejecutan en hardware Qualcomm compatible, lo que facilita la implementación de modelos en el dispositivo. En un dispositivo compatible con onnxruntime-qnn instalado, ejecuta directamente el modelo exportado con la API de Ultralytics (yolo predict/yolo val; consulta Uso más arriba): Ultralytics carga el binario de contexto HTP mediante el proveedor de ejecución QNN de ONNX Runtime.
Para tus propias canalizaciones, también puedes cargar directamente el ONNX del binario de contexto con ONNX Runtime. onnxruntime-qnn es un proveedor de ejecución (EP) de complemento, así que regístralo durante la ejecución:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# # En el dispositivo Snapdragon, registra el EP del complemento QNN y selecciona sus dispositivos
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
Como el binario de contexto QNN está precompilado, la sesión se carga rápidamente sin recompilar el grafo en el dispositivo.
Requisitos de Linux y del BSP de Yocto#
La placa de destino debe proporcionar un entorno de ejecución de Qualcomm y un BSP mutuamente compatibles. Para la inferencia HTP, esto incluye el proveedor de ejecución QNN de ONNX Runtime, libQnnSystem.so, libQnnHtp.so, las bibliotecas stub y skeleton de HTP v75 para IQ-8275, compatibilidad con FastRPC en espacio de usuario, como libcdsprpc.so, el firmware DSP y los controladores FastRPC/kernel correspondientes. La biblioteca skeleton debe poder localizarse mediante la ruta de bibliotecas DSP del BSP.
Estos componentes del dispositivo de destino proceden del BSP del fabricante de la placa, habilitado para QAIRT/QNN; no están integrados en el modelo exportado. La ejecución en GPU requiere, en cambio, libQnnGpu.so y la pila de controladores de espacio de usuario Adreno correspondiente. La salida format=qnn de Ultralytics es un binario de contexto específico para HTP, por lo que la implementación en GPU o CPU debe partir de una exportación ONNX estándar y no del archivo *_qnn.onnx precompilado.
Flujo de trabajo recomendado#
- Entrena tu modelo con el modo Train de Ultralytics
- Exporta al formato QNN mediante
model.export(format="qnn", name="iq-8275", imgsz=640)en una plataforma compatible (usaimgsz=224para clasificación). - Implementa el archivo
*_qnn.onnxexportado en tu dispositivo Qualcomm. - Ejecuta la inferencia con ONNX Runtime y el proveedor de ejecución QNN usando el backend HTP.
Aplicaciones en el mundo real#
Los modelos YOLO que se ejecutan en hardware Qualcomm Snapdragon son adecuados para una amplia variedad de aplicaciones de IA en el edge:
- Smartphones: Detección de objetos en tiempo real y comprensión de escenas en aplicaciones de cámara y fotografía con aceleración de NPU.
- Windows en Snapdragon: visión artificial en el dispositivo en PC Copilot+ sin transferir las tareas a la nube.
- Automoción: supervisión del conductor, detección de ocupantes y funciones ADAS en las plataformas Snapdragon Digital Chassis.
- XR y wearables: percepción de bajo consumo y baja latencia para gafas inteligentes y visores de AR/VR.
- IoT y robótica: inferencia visual eficiente en cámaras, drones y sistemas integrados con tecnología Snapdragon.
Resumen#
En esta guía has aprendido a exportar localmente modelos Ultralytics YOLO al formato Qualcomm QNN con el proveedor de ejecución QNN de ONNX Runtime. La canalización de exportación convierte tu modelo a ONNX y, después, lo compila en un binario de contexto QNN en tu equipo anfitrión, sin necesidad de una cuenta de Qualcomm ni de la nube. El resultado es un archivo *_qnn.onnx optimizado para CPU Snapdragon, GPU Adreno y hardware NPU Hexagon mediante el entorno de ejecución QNN/QAIRT.
La combinación de Ultralytics YOLO y la pila de IA en el dispositivo de Qualcomm ofrece una solución eficaz para ejecutar cargas de trabajo avanzadas de visión artificial en todo el amplio ecosistema Snapdragon.
Para otros destinos de implementación móvil y en el dispositivo, consulta las guías de exportación relacionadas con ONNX, CoreML, NCNN, LiteRT, ExecuTorch, RKNN, Sony IMX500 y TensorRT. Para comparar formatos antes de publicar, usa el modo Benchmark. Consulta la documentación del modo Export y la página de la guía de integraciones para ver la lista completa de formatos y opciones.
Preguntas frecuentes#
Puedes exportar tu modelo mediante
export(format="qnn", imgsz=640)(imgsz=224para clasificación) o los argumentos equivalentes de la CLI. Primero, la exportación crea un modelo ONNX y, después, lo compila localmente en un binario de contexto QNN mediante el proveedor de ejecución QNN de ONNX Runtime. El paqueteonnxruntime-qnnse instala automáticamente en la primera exportación.Ejemplofrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # usa imgsz=224 para clasificaciónNo. La exportación QNN se ejecuta íntegramente en tu equipo local mediante el paquete
onnxruntime-qnn, que incluye las bibliotecas QAIRT. No necesitas una cuenta de Qualcomm, un token de API ni acceso a la red.Qualcomm AI Hub es el servicio en la nube de Qualcomm para compilar, crear perfiles y comparar modelos en dispositivos Snapdragon alojados, y requiere una cuenta de Qualcomm. La exportación QNN de Ultralytics se dirige al mismo entorno de ejecución QNN/QAIRT (CPU Snapdragon, GPU Adreno y NPU Hexagon), pero compila el binario de contexto localmente con el proveedor de ejecución QNN de ONNX Runtime: sin cuenta, sin subir archivos y sin colas. Es la forma más rápida de pasar de un modelo
.pta una compilación lista para Snapdragon directamente desde el flujo de exportación estándar de YOLO.onnxruntime-qnn2.4.0 y versiones posteriores proporciona wheels precompiladas para Windows (x64 y ARM64) y Linux (x86-64 y ARM64) con Python 3.11 o posterior; macOS no es un sistema anfitrión QNN compatible. La generación del binario de contexto se ejecuta en un sistema anfitrión x64 y no requiere un dispositivo Snapdragon físico.Exporta mediante
model.export(format="qnn", imgsz=640)(imgsz=224para clasificación), copia el archivo resultanteyolo26n_qnn.onnxa tu dispositivo Snapdragon y ejecutayolo predict model=yolo26n_qnn.onnx source=image.jpg(oyolo val). Ultralytics carga el binario de contexto mediante el proveedor de ejecución QNN de ONNX Runtime y lo ejecuta en la NPU Hexagon; consulta Implementar modelos YOLO QNN exportados.QNN (Qualcomm AI Engine Direct, parte del SDK QAIRT) es la pila de inferencia actual de Qualcomm y el reemplazo recomendado para el antiguo SDK Snapdragon Neural Processing Engine (SNPE). Las nuevas implementaciones deben usar QNN.
Sí, en un dispositivo Qualcomm Snapdragon con
onnxruntime-qnninstalado:YOLO("yolo26n_qnn.onnx")carga el binario de contexto mediante el proveedor de ejecución QNN y ejecutapredict/val, como con cualquier otro formato. En un sistema anfitrión x86 sin hardware QNN, el modelo no se puede ejecutar porque el binario de contexto está diseñado para la NPU Snapdragon.La exportación crea un archivo ONNX autónomo con el binario de contexto (por ejemplo,
yolo26n_qnn.onnx), que incluye los nombres de las clases, el tamaño de imagen, la tarea y otros metadatos del modelo en ONNXmetadata_props.