Estimación monocular de profundidad con Ultralytics YOLO#
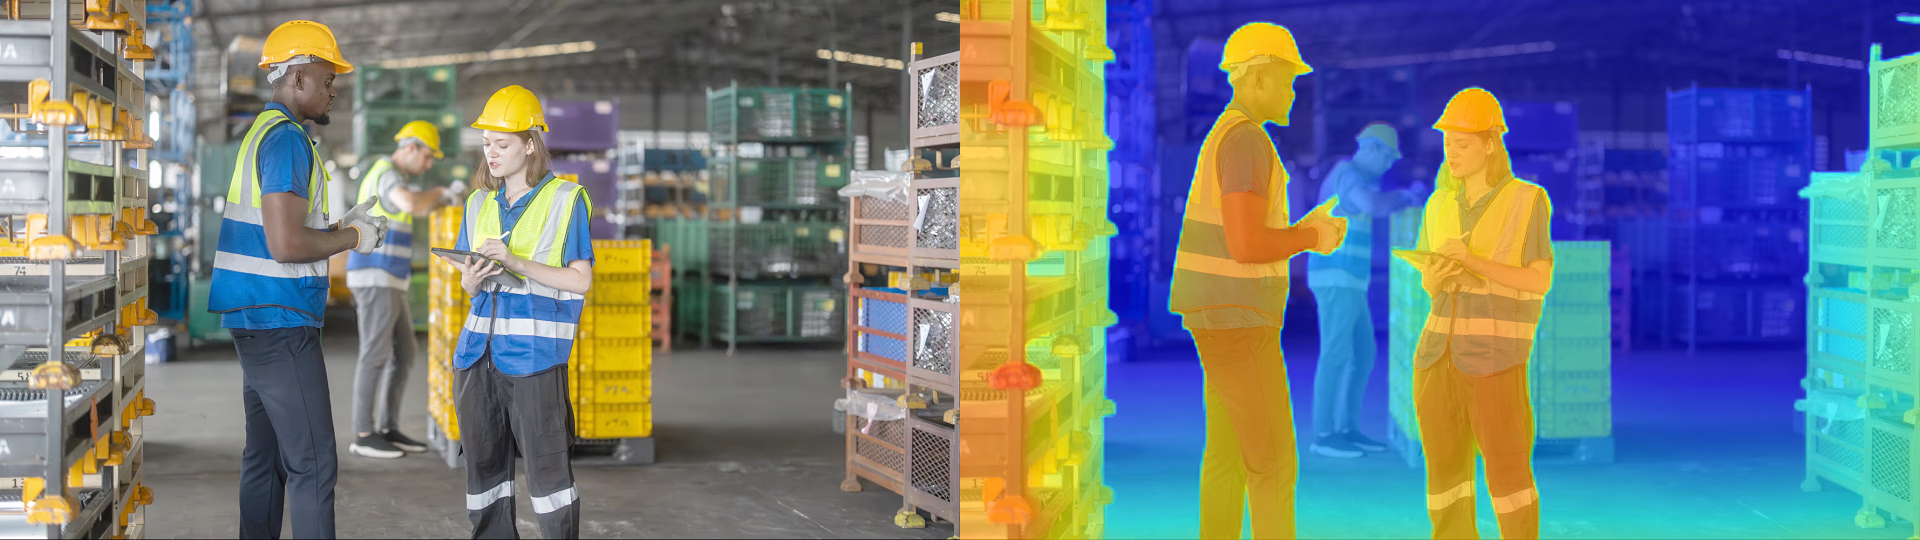
La estimación monocular de profundidad predice un mapa de profundidad por píxel a partir de una única imagen RGB. Cada píxel de salida contiene un valor de profundidad en metros que representa la distancia estimada desde la cámara hasta ese punto de la superficie.
La salida de un modelo de profundidad es un mapa denso de valores float con forma (H, W), alineado con la imagen de entrada. Esta representación por píxel hace que la estimación monocular de profundidad sea idónea para la reconstrucción de escenas 3D, la navegación robótica, la creación de contenido de RA/RV y cualquier aplicación que requiera información sobre la disposición espacial a partir de una sola cámara.
Ver: Estimación monocular de profundidad con Ultralytics YOLO26 | Tutorial de Python | Vision AI 🚀
Usa task=depth o la tarea CLI yolo depth para la estimación monocular de profundidad. Los archivos de modelos de profundidad YOLO26 usan el sufijo -depth, como yolo26n-depth.pt.
Modelos#
A continuación se muestran modelos de profundidad YOLO26 preentrenados con una amplia combinación de varios conjuntos de datos (interiores + exteriores, ~2.19M imágenes). Las columnas de métricas corresponden a la partición de prueba Eigen de NYU Depth V2.
Los modelos se descargan automáticamente desde la versión más reciente de Ultralytics al usarlos por primera vez.
| Modelo | tamaño (píxeles) | delta1NYU | abs_relNYU | rmseNYU | Velocidad CPU ONNX (ms) | Velocidad T4 TensorRT10 (ms) | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU es la fracción de píxeles cuya profundidad predicha está dentro de un factor de 1.25 respecto a la referencia, en la partición de prueba Eigen de NYU Depth V2 (654 imágenes), con TTA multiescala + volteo horizontal y alineación por mínimos cuadrados en el espacio logarítmico.
- La precisión a escala única sin TTA se puede reproducir con
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0(sustituyemodel=por cada tamaño), que usa una alineación por mediana (solo escala) y obtiene puntuaciones más bajas: delta1 0.783 (n), 0.793 (s), 0.840 (m), 0.853 (l), 0.860 (x). - abs_rel es el error relativo absoluto medio entre los valores de profundidad predichos y los de referencia.
- rmse es la raíz del error cuadrático medio, en metros.
- Velocidad es la latencia de inferencia únicamente (sin incluir el preprocesamiento ni el posprocesamiento) a
imgsz=768,batch=1, expresada como media ± desviación estándar de las ejecuciones cronometradas tras el calentamiento. CPU ONNX es ONNX Runtime fp32 en una CPU Intel Xeon de 32 núcleos (Skylake); T4 TensorRT10 es TensorRT fp16 en una Tesla T4. - params y FLOPs se miden a 768×768, la resolución de entrenamiento de los pesos publicados.
Consulta la versión preliminar no publicada de YOLO27 para ver los resultados preliminares de NYU Depth V2.
Velocidad comparada con Depth Anything V2#
Depth Anything V2 es una referencia abierta muy utilizada para la estimación monocular de profundidad. Su Transformer de visión DINOv2 y el decodificador DPT requieren muchos recursos de cálculo, por lo que, en la misma Tesla T4 con TensorRT fp16, el modelo Depth Anything V2 más pequeño publicado es más lento que todos los modelos de profundidad YOLO26, incluido YOLO26x-depth, que tiene más del doble de parámetros.
A ~768 px — imgsz=768 para YOLO26, la resolución con la que se entrenan sus pesos publicados, y 770 px para Depth Anything V2, cuyo backbone DINOv2 requiere un múltiplo de su tamaño de parche de 14:
| Modelo | params (M) | FLOPs (B) | T4 TensorRT10 (ms) | FPS | Aceleración frente a V2 Small | Aceleración frente a V2 Base |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
A ~640 px — imgsz=640 y 644 px, respectivamente — el orden no cambia y YOLO26n-depth es 5.9× más rápido que Depth Anything V2 Small:
| Modelo | T4 TensorRT10 (ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- La latencia corresponde únicamente a la inferencia,
batch=1, TensorRT fp16 en una Tesla T4, con el mismo entorno de pruebas que la tabla de modelos anterior, pero con dos decimales; los FPS son el inverso de la latencia sin redondear. Las columnas de Aceleración dividen las latencias de Depth Anything V2 Small (20.99 ms) y Base (55.40 ms) por la latencia de YOLO26. - Depth Anything V2 Small y Base son los checkpoints ViT-S y ViT-B publicados.
- La comparación solo abarca la latencia: aquí no se evalúan las dos familias de modelos con un protocolo de precisión común.
Rango de profundidad y cabezal de profundidad logarítmica#
El cabezal de profundidad predice exp(logit) — sin límite (~0.02–150 m) — y desacopla la forma de la escena de la escala absoluta: la red predice un campo de profundidad logarítmica relativa, y los metros absolutos se establecen mediante una transformación independiente de dos parámetros (exp(a·log d + b)), que se obtiene durante la evaluación, mediante una calibración ligera o con ajuste fino. La alternativa habitual, un cabezal sigmoid × max_depth acotado, incorpora un límite máximo fijo en la arquitectura, por lo que cualquier profundidad superior a max_depth se recorta, lo que impide entrenar con escenas de mayor alcance y predecirlas.
Prueba A/B controlada: mismos datos, mismo programa, solo cambia el cabezal. Entrenamiento desde cero de ambos cabezales con una combinación idéntica de datos interiores (≤10 m) y exteriores (≤80 m):
| Cabezal | Rango de salida | δ1 de validación en rangos mixtos | Comportamiento durante el entrenamiento |
|---|---|---|---|
sigmoid × max_depth (10 m) | acotado: 0–10 m | 0.221 | se estanca en la época 1 |
log (sin límite) | 0–~150 m | 0.367 (+66%) | mejora durante todo el entrenamiento |
El cabezal acotado no puede representar la mayoría de los píxeles exteriores, que están a más de 10 m, por lo que deja de mejorar casi de inmediato; el cabezal log aprende a partir del rango completo.
El problema que resuelve: ajuste fino en un único conjunto de datos, desglosado por rango. El ajuste fino de un cabezal acotado (10 m) en conjuntos de datos individuales funciona cuando los datos están dentro del límite y falla cuando lo superan:
| Conjunto de datos | Rango de profundidad | δ1 del cabezal acotado |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | principalmente ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌ (abs_rel ≈ 7.0: desajuste de escala 80/10) |
| vKITTI2 | 80 m | 0.04 ❌ |
El fallo se produce exactamente en el límite máximo. El cabezal log no tiene ese límite.
Modelos publicados: rendimiento en distintos rangos. La familia de cabezales log publicada, evaluada en benchmarks que abarcan desde 10 m (NYU, iBims-1) hasta 80 m (KITTI), con δ1 alineada por escala:
| Evaluación comparativa | Intervalo | YOLO26x-depth (log) | versión anterior con límite |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| Media | — | 0.819 | 0.799 |
Ambas columnas se reproducen tal como se publicaron. El resto de las filas se puntúan con el protocolo TTA y de mínimos cuadrados logarítmicos descrito en las páginas de sus conjuntos de datos, que el validador de este repositorio no implementa; por tanto, la fila de KITTI no se puede volver a medir en las mismas condiciones. La página de KITTI muestra cifras medidas en la partición Eigen canónica de 652 fotogramas.
Las mayores mejoras se observan en los benchmarks exteriores de mayor alcance (KITTI, ETH3D), justo donde más perjudica un límite fijo de 10 m, y se mantiene el rendimiento en interiores.
Entrenar#
Entrena YOLO26n-depth con el conjunto de datos Depth8 durante 100 épocas con un tamaño de imagen de 640. Consulta la página de configuración para ver la lista completa de argumentos disponibles.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-depth.yaml")  # Crea un modelo nuevo a partir de YAML
model = YOLO("yolo26n-depth.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # Crea el modelo a partir de YAML y transfiere los pesos

# Entrenar el modelo
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)
Consulta los detalles completos del modo train en la página de entrenamiento. También puedes entrenar modelos de profundidad con el entrenamiento en la nube de Ultralytics Platform.
Formato del conjunto de datos#
Los conjuntos de datos de estimación de profundidad emparejan cada imagen RGB con un mapa de profundidad PNG uint16 escalado o un mapa de profundidad NPY de coma flotante en metros. Por defecto, los valores PNG se expresan en milímetros; los conjuntos de datos que usan otra convención definen depth_scale en su YAML. El cargador obtiene la ruta de profundidad sustituyendo el componente images por depth; da prioridad a .png y, si no está disponible, usa .npy.
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
Por ejemplo, a la imagen images/train/scene_001.jpg le corresponde un mapa de profundidad en depth/train/scene_001.png. Consulta la guía de conjuntos de datos de estimación de profundidad para ver la especificación completa del formato.
Ajuste fino con tus propios datos#
Al adaptar un modelo de profundidad preentrenado a un conjunto de datos personalizado, reduce la tasa de aprendizaje y usa el optimizador AdamW. Los ajustes predeterminados del optimizador están pensados para entrenar desde cero; si los aplicas a un modelo de profundidad que ya ha convergido, pueden sobrescribir el conocimiento preentrenado y degradar los resultados, especialmente si haces el ajuste fino en un único dominio.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # partir de pesos preentrenados

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100 veces por debajo del valor predeterminado desde cero
    warmup_bias_lr=1e-4,  # mantén también suave el calentamiento
)
Consejos adicionales:
- La ampliación de datos se controla mediante los argumentos estándar (
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v); la deformación geométrica y los volteos se aplican de forma idéntica al mapa de profundidad emparejado. Para ver la receta exacta utilizada con los pesos YOLO26-Depth publicados, inspecciona eltrain_argsalmacenado en el punto de control; consulta Inspección de los argumentos de entrenamiento de un punto de control de YOLO26. mosaic,mixup,cutmixycopy_pasteno están implementados para la profundidad. El cargador del conjunto de datos de profundidad establece automáticamente estas probabilidades en 0, por lo que pasarlas no tiene ningún efecto. Estas ampliaciones no son compatibles porque combinan varias imágenes, lo que produciría mapas de profundidad emparejados no válidos.- Cualquier intervalo de profundidad funciona directamente. Los modelos con cabeza
logpredicen una profundidad sin límites, por lo que se adaptan a datos de corto alcance (macro) o de largo alcance (exteriores/conducción) sin cambios. Al establecermax_depth:en el YAML del conjunto de datos (en metros), se limita qué píxeles GT cuentan para las métricas de validación. - Mantén el rendimiento general. Si necesitas que el modelo siga siendo preciso en escenas que no estén en el conjunto de entrenamiento, mezcla una pequeña proporción (~5–10 %) de imágenes variadas de propósito general en los datos de entrenamiento; esto reduce sustancialmente el olvido durante el ajuste fino.
- Entrena desde cero (
model=yolo26s-depth.yaml) solo si tu dominio es muy distinto y tienes un conjunto de datos grande; en ese caso, el valor predeterminadooptimizer=autoes adecuado, ya que no hay pesos preentrenados que conservar.
Calibración de la escala de profundidad#
La cabeza de profundidad separa la forma (la estructura relativa de la escena) de la escala (los metros absolutos). Si un modelo ya produce una buena profundidad relativa en tus escenas, pero los valores absolutos no son correctos para tu cámara, puedes corregir la escala en segundos con model.calibrate(): un ajuste de forma cerrada, solo de escala, de la transformación log-afín de la cabeza frente a un pequeño conjunto etiquetado, que solo se conserva si mejora δ1 en la validación cruzada con datos reservados, sin entrenamiento por gradiente ni cambios en los pesos de la red, por lo que no puede degradar la estructura relativa.
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# Ajusta la escala con una partición etiquetada (bastan ~100 imágenes o más) y, después, persístela
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
La calibración necesita la profundidad real de referencia para realizar el ajuste, por lo que se ejecuta en una partición etiquetada; no puede hacerse durante la inferencia a ciegas. Ajusta y evalúa los mismos píxeles que usan las métricas de validación: se excluye la profundidad GT igual o superior al valor max_depth del YAML del conjunto de datos (100 m de forma predeterminada). Úsala cuando la profundidad relativa ya sea buena y solo falle la escala/el alcance; si la estructura relativa en sí necesita cambiar para tu dominio, ajusta el modelo en su lugar.
El entrenamiento lo hace automáticamente: al terminar model.train(...), los mejores puntos de control y los últimos se calibran con el conjunto de validación para que generen directamente una profundidad con escala métrica.
Los puntos de control yolo26*-depth.pt publicados ya incluyen esta calibración, ajustada con la mezcla de validación del preentrenamiento. Se trata de una única escala global para todos los dominios, así que, para obtener la profundidad absoluta más precisa en una cámara o tipo de escena concretos, ejecuta model.calibrate() con una pequeña partición etiquetada de tus propios datos; esto sustituye el ajuste integrado.
Obtener profundidad de referencia sin una cámara de profundidad#
Si tu cámara no tiene sensor de profundidad, aun así puedes calibrarla. La calibración ajusta una única escala global e ignora los píxeles con profundidad 0, así que bastan unos pocos puntos medidos por imagen.
-
Recopila imágenes. Toma entre 50 y 150 imágenes con la cámara a la resolución y con los ajustes del objetivo que usarás en producción, y guárdalas en
dataset/images/val/. La calibración lee la particiónval. -
Anota la profundidad. Usa uno de los dos métodos siguientes. Ambos escriben un mapa de profundidad por imagen en
dataset/depth/val/, con el formato del conjunto de datos.
Mide la distancia a unos pocos puntos de cada imagen con un telémetro láser o una cinta métrica, sobre superficies planas y alejadas de los bordes de los objetos, y registra la ubicación en píxeles de cada punto en points.csv:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
A continuación, escribe los mapas de profundidad y deja en 0 todos los píxeles no medidos. Cada punto se dibuja como un pequeño círculo para que se conserve al redimensionarlo a imgsz:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
Un telémetro mide la distancia en línea recta hasta un punto, mientras que los mapas de profundidad almacenan la distancia a lo largo del eje de visión de la cámara. Ambas medidas coinciden en el centro de la imagen y difieren aproximadamente un 3,5 % a 15° del centro; por eso, mide puntos cerca del centro o convierte cada lectura con meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) usando los parámetros intrínsecos de tu cámara.
-
Escribe el YAML del conjunto de datos como
calib.yaml.depth_scale: 100lee los PNG en centímetros de los puntos medidos y se ignora para los mapas NPY:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
Calibra y guarda; después, carga
yolo26s-depth-calibrated.ptpara predecir o exportar:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
En las pruebas con yolo26s-depth.pt y 150 imágenes por cámara, la calibración publicada se desvió entre un 4 % y un 46 % del ajuste de escala con valores de referencia completos para NYU, KITTI y una cámara con un objetivo estrecho. La calibración con 5 puntos medidos por imagen se acercó a ese ajuste con una diferencia inferior al 1 %, y con las etiquetas de DA3METRIC-LARGE, con una diferencia inferior al 7 %. Añadir imágenes ayuda más que añadir puntos por imagen: 150 imágenes con 1 punto cada una se acercaron con una diferencia de aproximadamente el 3 %, mientras que 20 imágenes con 5 puntos cada una presentaron variaciones de hasta el 9 %.
Validar#
Valida la precisión de un modelo YOLO26n-depth entrenado en un conjunto de datos de estimación de profundidad. Pasa data explícitamente para que la validación use el YAML del conjunto de datos previsto. Los pesos publicados se entrenan con imgsz=768 en imágenes estiradas hasta formar un cuadrado, en lugar de imágenes ajustadas con bandas de relleno; por eso, valida y predice con ese tamaño para obtener la máxima precisión. La predicción, la validación y model.calibrate() estiran la entrada de la misma manera.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-depth.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Valida el modelo
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # fracción de píxeles dentro del umbral δ=1.25
metrics.abs_rel  # error relativo absoluto medio
metrics.rmse  # raíz del error cuadrático medio (metros)
metrics.silog # error logarítmico invariante a la escalaPredecir#
Usa un modelo YOLO26n-depth entrenado para ejecutar predicciones en imágenes.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-depth.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Haz predicciones con el modelo
results = model("https://ultralytics.com/images/bus.jpg")  # haz una predicción sobre una imagen

# Accede a los resultados
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor -> NumPy float32, forma (H, W), metros
Consulta todos los detalles del modo predict en la página de predicción.
Resultados de salida#
La estimación de profundidad de YOLO devuelve un objeto Results por imagen. Cada resultado almacena un mapa de profundidad denso de tipo float para toda la imagen.
| Atributo | Tipo | Forma | Descripción |
|---|---|---|---|
result.depth | DepthMap | (H,W) | Mapa de profundidad denso por píxel. |
result.depth.data | torch.Tensor | (H,W) | Valores de profundidad en metros; llama a .cpu().numpy() para NumPy. |
result.boxes | - | - | No hay cajas de instancias. |
result.masks | - | - | No hay máscaras de instancias. |
Para consultar los campos Results específicos de cada tarea, visita la sección resultados de predicción por tarea.
Profundidad por objeto con segmentación de instancias#
Combina la segmentación de instancias con la profundidad para estimar a qué distancia está cada objeto detectado. Ejecuta ambos modelos en la misma imagen con retina_masks=True para que las máscaras compartan la resolución de la imagen original del mapa de profundidad y, después, calcula la mediana de los píxeles de profundidad válidos dentro de cada máscara.
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
            print(f"{seg.names[int(cls)]}: {values.median():.2f} m")
La mediana es robusta frente a los píxeles del fondo en los bordes de las máscaras, pero describe la superficie visible del objeto, no su centro, y su precisión depende de la escala de profundidad del modelo (consulta Calibrar la escala de profundidad).
Aplicar color al mapa de profundidad#
El mapa de profundidad sin procesar es una matriz float de un solo canal en metros: útil para los cálculos, pero difícil de interpretar directamente. Para convertirlo en una imagen en color, usa la función auxiliar colorize_depth de ultralytics.utils.plotting, que transforma la matriz de profundidad (H, W) en una imagen BGR uint8 de (H, W, 3) (los píxeles no válidos <= 0 se muestran en negro).
result.plot() ya superpone esta representación en color a la imagen de entrada con los valores predeterminados (cmap="jet", mode="disparity"); llama directamente a colorize_depth cuando quieras una imagen de profundidad en color independiente o una tabla de colores o normalización distintas.
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# Aplica color con los objetos cercanos en tonos cálidos y guarda
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# Fija el intervalo en 0-20 m para que el mismo color represente la misma distancia en todos los fotogramas
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# Superposición combinada directamente desde el objeto Results (usa cmap="jet", mode="disparity")
result.save("depth_overlay.png")
Todas las tablas de colores van de tonos fríos/oscuros a cálidos/brillantes. mode determina qué extremo representa lo cercano, y vmin/vmax fijan el intervalo entre fotogramas para que un color siempre represente la misma distancia.
| Argumento | Valor | Descripción |
|---|---|---|
cmap | jet (predeterminado) | Alto contraste, de azul a verde y rojo; es la paleta que usa result.plot(). |
cmap | inferno | De negro a morado, naranja y amarillo. Uniforme desde el punto de vista perceptivo, apta para personas con daltonismo y legible en escala de grises. |
cmap | spectral | De rojo a amarillo, verde y azul (Spectral_r de matplotlib). |
mode | disparity (predeterminado) | Normaliza la profundidad inversa (1/d) entre los percentiles 2 y 98; los tonos cálidos indican lo cercano y se absorben los valores atípicos lejanos. |
mode | metric | Normaliza la profundidad en metros de forma lineal entre vmin y vmax; los tonos cálidos indican lo lejano, por lo que los colores reflejan la distancia real. |
Exportar#
Exporta un modelo YOLO26n-depth a otro formato, como ONNX, CoreML, etc.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-depth.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Exporta el modelo
model.export(format="onnx")
Los formatos de exportación disponibles para la estimación de profundidad con YOLO26 se muestran en la tabla siguiente. Puedes exportar a cualquier formato mediante el argumento format, por ejemplo, format='onnx' o format='engine'. Puedes predecir o validar directamente con los modelos exportados, por ejemplo, yolo predict model=yolo26n-depth.onnx. Cuando termine la exportación, se mostrarán ejemplos de uso para tu modelo.
| Formato | Argumento format | Modelo | Metadatos | Argumentos |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None usa de forma predeterminada salidas sin procesar para NMS externa. Establece nms=False para seleccionar una cabeza sin NMS disponible; los formatos no compatibles recurren a su ruta de salida nativa. Las entradas nms anteriores identifican los formatos que pueden integrar NMS con nms=True.
Consulta todos los detalles de export en la página Exportar.
Preguntas frecuentes#
Prepara imágenes RGB emparejadas y mapas de profundidad PNG de 16 bits o NPY de coma flotante en metros; después, crea un YAML del conjunto de datos que apunte a tu directorio
images/. El cargador encuentra automáticamente los archivos de profundidad sustituyendoimagespordepthen la ruta; da prioridad a.pngy recurre a.npysi no está disponible.Parte de pesos preentrenados y usa una tasa de aprendizaje baja con AdamW para que el ajuste fino conserve lo que el modelo ya sabe (consulta Ajuste fino con tus propios datos para saber por qué):
Ejemplofrom ultralytics import YOLO # Carga un modelo YOLO26 de profundidad preentrenado model = YOLO("yolo26s-depth.pt") # Ajusta el modelo con un conjunto de datos de profundidad personalizado results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )Consulta la página de Configuración para ver más argumentos disponibles.
La validación de la estimación de profundidad muestra el conjunto de métricas utilizado por Depth Anything y otros trabajos relacionados con la profundidad monocular:
- delta1 / delta2 / delta3 — fracción de píxeles en los que la proporción entre la profundidad predicha y la profundidad real de referencia (o su inversa) es inferior a 1.25, 1.25² y 1.25³, respectivamente. Cuanto más alto, mejor.
- abs_rel — error relativo absoluto medio. Cuanto más bajo, mejor.
- rmse — raíz del error cuadrático medio en metros. Cuanto más bajo, mejor.
- silog — error logarítmico invariante a la escala. Cuanto más bajo, mejor.
Cada predicción se alinea por la mediana con su valor real de referencia por imagen, cada métrica se calcula para esa imagen y, después, se promedian los resultados por imagen en el conjunto de validación; así, todas las imágenes tienen el mismo peso, independientemente del número de píxeles de profundidad válidos que contengan. Se omiten las imágenes con menos de 10 píxeles GT válidos, que no se incluyen en ese promedio, porque no tiene sentido alinear la mediana de un puñado de píxeles; las predicciones no finitas se evalúan en los límites de profundidad. Esto coincide con el promedio por muestra y el mínimo de 10 píxeles utilizados por Depth Anything V2.
El mapa de profundidad se almacena como
torch.Tensorcon forma(H, W), donde cada valor es la profundidad predicha en metros (usaresult.depth.data.cpu().numpy()para obtener una matrizfloat32de NumPy). Accede a él medianteresult.depth.datadespués de ejecutar la predicción. El mapa está alineado con la resolución de la imagen de entrada.Ultralytics YOLO26 incluye configuraciones YAML de conjuntos de datos integradas para varios conjuntos de datos de estimación de profundidad, como NYU Depth V2, KITTI, Hypersim, SUN RGB-D y ARKitScenes. Consulta la Guía de conjuntos de datos de estimación de profundidad para ver la lista completa y los detalles de formato.
Valida un modelo YOLO26 de profundidad preentrenado indicando el YAML del conjunto de datos que se utilizará para la evaluación:
Ejemplofrom ultralytics import YOLO # Cargar un modelo preentrenado model = YOLO("yolo26n-depth.pt") # Valida el modelo metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)Exporta un modelo YOLO26 de profundidad a ONNX con Python o la CLI:
Ejemplofrom ultralytics import YOLO # Cargar un modelo preentrenado model = YOLO("yolo26n-depth.pt") # Exporta el modelo al formato ONNX model.export(format="onnx")Encontrarás más detalles sobre la exportación a distintos formatos en la página de Exportación.