Segmentación semántica con Ultralytics YOLO#
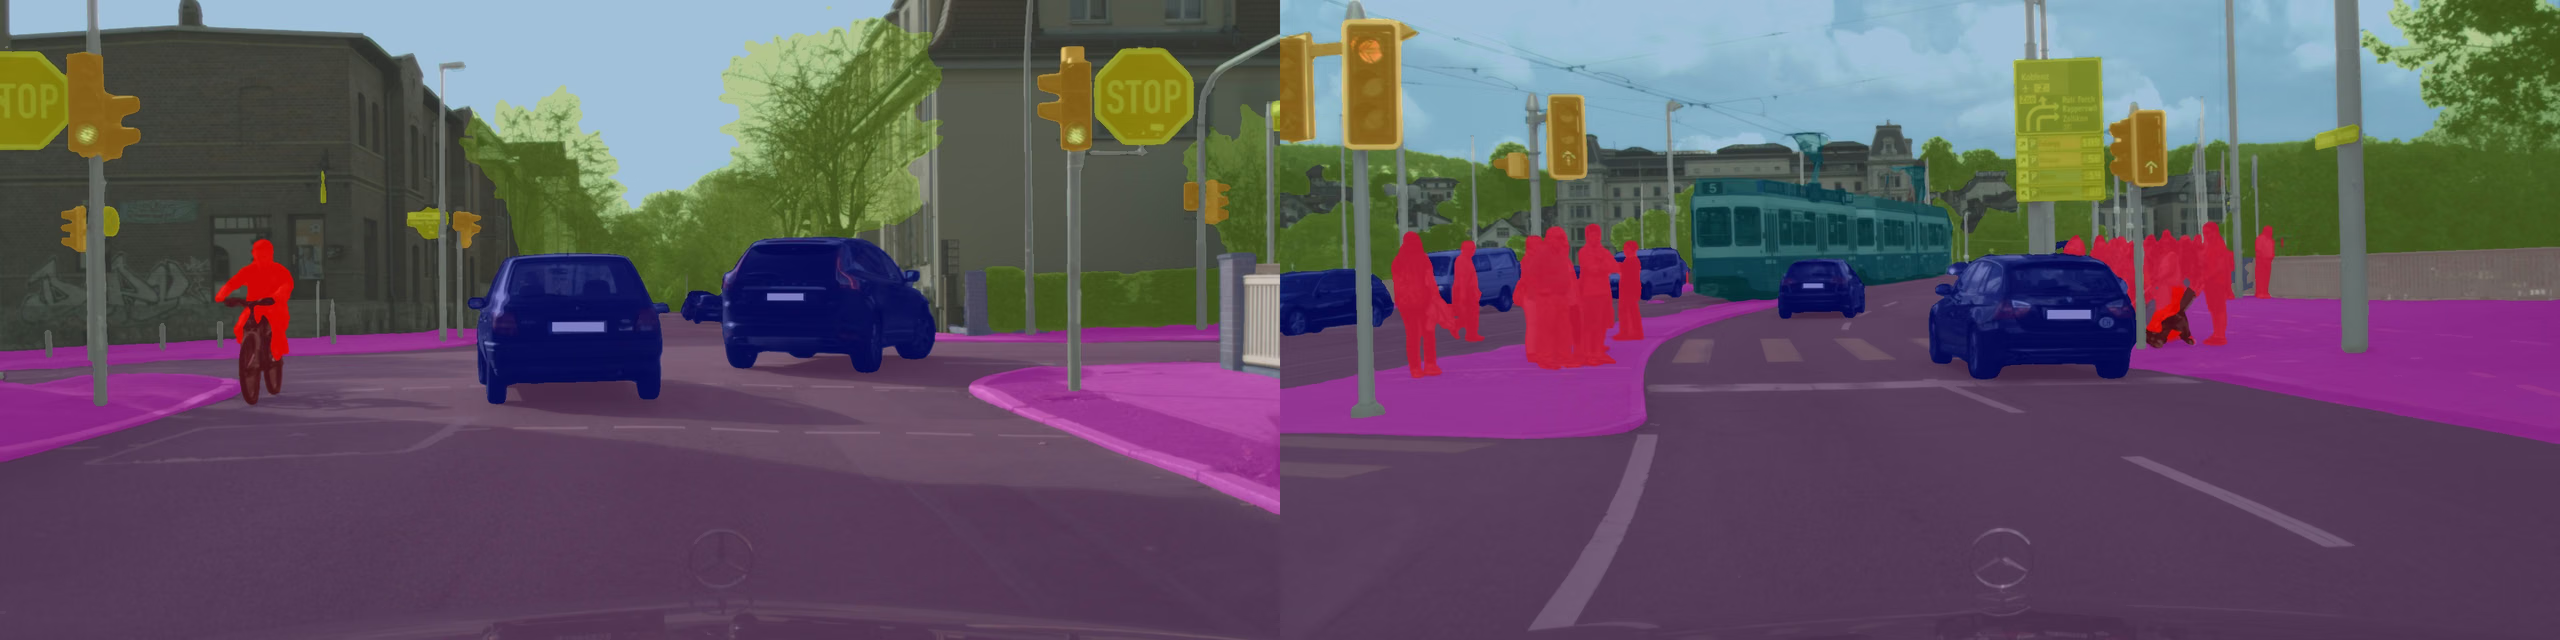
La segmentación semántica asigna una etiqueta de clase a cada píxel de una imagen y genera un mapa de clases denso que abarca toda la escena. A diferencia de la segmentación de instancias, que separa los objetos individuales, la segmentación semántica agrupa todos los píxeles de una misma clase, independientemente del número de objetos distintos que haya.
Ver: Segmentación semántica con Ultralytics YOLO26 | Tutorial de inicio rápido
El resultado de un modelo de segmentación semántica es un único mapa de clases de alto por ancho, donde el valor de cada píxel corresponde a un ID de clase predicho. Esto hace que la segmentación semántica sea ideal para tareas de interpretación de escenas, como la conducción autónoma, el diagnóstico por imagen y la cartografía de la cubierta terrestre.
Usa task=semantic o la tarea de CLI yolo semantic para la segmentación semántica. Los archivos de modelos de segmentación semántica YOLO26 usan el sufijo -sem, como yolo26n-sem.pt.
Modelos#
A continuación se muestran los modelos YOLO26 Semantic preentrenados con el conjunto de datos Cityscapes.
Los modelos se descargan automáticamente desde la versión más reciente de Ultralytics al usarlos por primera vez.
| Modelo | tamaño (píxeles) | mIoUval | Velocidad RTX3090 PyTorch (ms) | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem | 1024 × 2048 | 78.3 | 4.4 ± 0.0 | 1.6 | 23.8 |
| YOLO26s-sem | 1024 × 2048 | 80.8 | 8.4 ± 0.0 | 6.5 | 91.0 |
| YOLO26m-sem | 1024 × 2048 | 82.0 | 19.9 ± 0.1 | 14.3 | 305.5 |
| YOLO26l-sem | 1024 × 2048 | 82.9 | 26.5 ± 0.1 | 17.8 | 388.2 |
| YOLO26x-sem | 1024 × 2048 | 83.6 | 48.9 ± 0.2 | 40.1 | 866.9 |
- Los valores de mIoUval corresponden a un único modelo y una única escala en el conjunto de validación de Cityscapes.
Reprodúcelos conyolo semantic val data=cityscapes.yaml device=0 imgsz=2048 - Las métricas de velocidad son promedios calculados con las imágenes de validación de Cityscapes en una instancia RTX3090.
Reprodúcelas conyolo semantic val data=cityscapes.yaml batch=1 device=0|cpu imgsz=2048 - Los valores de parámetros y FLOPs corresponden al modelo fusionado tras
model.fuse(), que combina las capas Conv y BatchNorm. Los puntos de control preentrenados conservan la arquitectura de entrenamiento completa y pueden mostrar valores más altos.
A continuación se muestran los modelos YOLO26 Semantic preentrenados con el conjunto de datos ADE20K.
| Modelo | tamaño (píxeles) | mIoUval | Velocidad RTX3090 PyTorch (ms) | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|
| YOLO26n-sem-ade20k | 640 | 38.8 | 3.9 ± 0.2 | 1.6 | 4.5 |
| YOLO26s-sem-ade20k | 640 | 45.6 | 4.2 ± 0.3 | 6.5 | 17.5 |
| YOLO26m-sem-ade20k | 640 | 47.4 | 4.7 ± 0.3 | 14.4 | 59.6 |
| YOLO26l-sem-ade20k | 640 | 49.7 | 8.3 ± 0.2 | 17.9 | 75.2 |
| YOLO26x-sem-ade20k | 640 | 51.5 | 9.9 ± 0.3 | 40.2 | 168.4 |
- Los valores de mIoUval corresponden a un único modelo y una única escala en el conjunto de validación de ADE20K.
Reprodúcelos conyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml device=0 imgsz=640, sustituyendoyolo26n-sem-ade20k.ptpor el punto de controlyolo26*-sem-ade20k.ptque quieras. - Las métricas de velocidad son promedios calculados con las imágenes de validación de ADE20K en una instancia RTX3090.
Reprodúcelas conyolo semantic val model=yolo26n-sem-ade20k.pt data=ade20k.yaml batch=1 device=0|cpu imgsz=640, sustituyendoyolo26n-sem-ade20k.ptpor el punto de controlyolo26*-sem-ade20k.ptque quieras. - Los valores de parámetros y FLOPs corresponden al modelo fusionado tras
model.fuse(), que combina las capas Conv y BatchNorm. Los puntos de control preentrenados conservan la arquitectura de entrenamiento completa y pueden mostrar valores más altos.
Consulta la vista previa no publicada de YOLO27 para ver resultados preliminares de mIoU en Cityscapes.
Entrenar#
Entrena YOLO26n-sem con el conjunto de datos Cityscapes8 durante 100 épocas con un tamaño de imagen de 1024. Consulta la página de Configuración para ver la lista completa de argumentos disponibles.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-sem.yaml")  # Crea un modelo nuevo a partir de YAML
model = YOLO("yolo26n-sem.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)
model = YOLO("yolo26n-sem.yaml").load("yolo26n-sem.pt")  # Crea el modelo a partir de YAML y transfiere los pesos

# Entrenar el modelo
results = model.train(data="cityscapes8.yaml", epochs=100, imgsz=1024)
Consulta la página Entrenamiento para ver todos los detalles del modo train. También puedes entrenar modelos de segmentación semántica con el entrenamiento en la nube de Ultralytics Platform.
Formato del conjunto de datos#
Los conjuntos de datos de segmentación semántica usan imágenes de máscaras de un solo canal, normalmente PNG, donde el valor de cada píxel representa un ID de clase. Los píxeles con valor 255 se tratan como «ignorar» y se excluyen del cálculo de la pérdida. El YAML del conjunto de datos debe especificar las rutas a las imágenes y a sus correspondientes directorios de máscaras. Los conjuntos de datos con etiquetas de polígonos YOLO se entrenan directamente; las etiquetas se convierten en máscaras sobre la marcha (consulta más abajo ¿Puedo usar datos de segmentación de instancias?). Consulta la Guía de conjuntos de datos de segmentación semántica para ver los detalles del formato. Entre los conjuntos de datos compatibles se incluyen Cityscapes y ADE20K. Puedes gestionar y etiquetar conjuntos de datos semánticos con la anotación de Ultralytics Platform.
Validar#
Valida la precisión del modelo YOLO26n-sem entrenado con un conjunto de datos de segmentación semántica. Pasa data explícitamente para que la validación use el YAML del conjunto de datos previsto.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-sem.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Valida el modelo
metrics = model.val(data="cityscapes.yaml")
metrics.miou  # intersección media sobre unión
metrics.pixel_accuracy # precisión global por píxelPredecir#
Usa un modelo YOLO26n-sem entrenado para hacer predicciones sobre imágenes.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-sem.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Haz predicciones con el modelo
results = model("https://ultralytics.com/images/bus.jpg")  # haz una predicción sobre una imagen

# Accede a los resultados
for result in results:
    semantic_mask = result.semantic_mask.data  # mapa de clases, forma (H,W), tipo de datos entero seleccionado según el número de clases
Consulta todos los detalles del modo predict en la página de predicción.
Resultados de salida#
La segmentación semántica de YOLO devuelve un objeto Results por imagen. Cada resultado almacena un único mapa de clases denso para toda la imagen, en lugar de una lista de máscaras de objetos. Los píxeles con la misma clase predicha comparten el mismo ID de clase, aunque pertenezcan a objetos distintos.
| Atributo | Tipo | Forma | Descripción |
|---|---|---|---|
result.semantic_mask | SemanticMask | (H,W) | Mapa de clases denso. |
result.semantic_mask.data | torch.uint8torch.int16torch.int32 | (H,W) | ID de clase; el tipo de dato se selecciona según el número de clases. |
result.masks | - | - | No hay máscaras de instancias. |
result.boxes | - | - | No hay cajas ni niveles de confianza de instancias. |
Para consultar los campos Results específicos de cada tarea, visita la sección resultados de predicción por tarea.
La segmentación semántica predice un mapa de clases denso y, después, redimensiona ese mapa a la forma de la imagen para su visualización y uso posterior. Por eso, las estructuras muy finas, como las marcas de carril, las líneas de las pistas, los postes o los cables, pueden verse escalonadas cuando la inferencia se ejecuta con un imgsz muy inferior a la resolución original de la imagen. Si los límites se ven irregulares, primero vuelve a probar el modelo nativo .pt de PyTorch con un imgsz mayor, como 1024, 1280 o el valor práctico más cercano al tamaño de la imagen de origen. Usa modelos exportados solo después de confirmar que el resultado de .pt es aceptable, ya que las entradas de menor resolución no pueden recuperar detalles finos que no estuvieran presentes en el mapa de clases predicho.
Segmentación de instancias frente a segmentación semántica#
| Aspecto | Segmentación de instancias (task="segment") | Segmentación semántica (task="semantic") |
|---|---|---|
| Objetivo de la predicción | Segmentar cada objeto detectado por separado | Asignar un ID de clase a cada píxel |
| Campo de salida | result.masks | result.semantic_mask |
| Datos principales | result.masks.data | result.semantic_mask.data |
| Forma | (N,H,W) | (H,W) |
| Valores de píxel | Valores de máscara binaria: 0 o 1 | ID de clase: 0, 1, 2, ... |
| Tipo de datos | torch.uint8 | torch.uint8torch.int16torch.int32 |
| Objetos de la misma clase | Se mantienen como instancias separadas | Se fusionan en la misma región de clase |
| Polígonos | Sí, mediante result.masks.xy y result.masks.xyn | No se generan polígonos de forma predeterminada |
| Cajas y confianza | Sí, mediante result.boxes | No hay cajas ni puntuaciones de confianza por instancia |
| Uso habitual | Recuento, seguimiento, recorte y medición a nivel de objeto | Etiquetado denso de escenas, zonas transitables, cubierta terrestre y regiones médicas |
Exportar#
Exporta un modelo YOLO26n-sem a otro formato, como ONNX, CoreML, etc.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-sem.pt")  # carga un modelo oficial
model = YOLO("path/to/best.pt")  # cargar un modelo personalizado

# Exporta el modelo
model.export(format="onnx")
Los formatos de exportación disponibles para la segmentación semántica YOLO26 aparecen en la tabla siguiente. Puedes exportar a cualquier formato con el argumento format, es decir, format='onnx' o format='engine'. También puedes hacer predicciones o validar directamente con modelos exportados, por ejemplo, yolo predict model=yolo26n-sem.onnx. Cuando termine la exportación, se mostrarán ejemplos de uso de tu modelo.
| Formato | Argumento format | Modelo | Metadatos | Argumentos |
|---|---|---|---|---|
| PyTorch | - | yolo26n-sem.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-sem.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-sem.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-sem_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-sem.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-sem.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-sem.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-sem_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-sem.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-sem_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-sem.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-sem_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-sem.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-sem_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-sem_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-sem_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-sem_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-sem_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-sem_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-sem_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-sem_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-sem_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-sem_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None usa de forma predeterminada salidas sin procesar para NMS externa. Establece nms=False para seleccionar una cabeza sin NMS disponible; los formatos no compatibles recurren a su ruta de salida nativa. Las entradas nms anteriores identifican los formatos que pueden integrar NMS con nms=True.
Consulta todos los detalles de export en la página Exportar.
Preguntas frecuentes#
Para entrenar un modelo de segmentación semántica YOLO26 con un conjunto de datos personalizado, tienes que preparar imágenes de máscara PNG en las que el valor de cada píxel represente un ID de clase (0, 1, 2, ...) y los píxeles con valor 255 se ignoren durante el entrenamiento. Crea un archivo YAML del conjunto de datos que apunte a los directorios de imágenes y máscaras y, después, entrena el modelo:
Ejemplofrom ultralytics import YOLO # Carga un modelo YOLO26 de segmentación semántica preentrenado model = YOLO("yolo26n-sem.pt") # Entrenar el modelo results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=1024)Consulta la página de Configuración para ver más argumentos disponibles.
La segmentación de instancias y la segmentación semántica son tareas a nivel de píxel, pero se diferencian en un aspecto clave:
- La segmentación semántica asigna una etiqueta de clase a cada píxel, pero no distingue entre objetos individuales de la misma clase. Por ejemplo, todos los coches de una escena comparten la misma etiqueta de clase.
- La segmentación de instancias identifica cada objeto individual por separado y genera máscaras distintas para cada objeto, aunque pertenezcan a la misma clase.
La segmentación semántica es más adecuada para tareas de comprensión de escenas, como la conducción autónoma y la cartografía de la cobertura del suelo, mientras que se prefiere la segmentación de instancias cuando es importante contar o seguir objetos individuales.
Sí. Si tu conjunto de datos usa etiquetas poligonales de Ultralytics YOLO (un
.txtpor imagen), omitemasks_dirdel YAML del conjunto de datos y asegúrate de que no haya ninguna carpetamasks/junto a tus imágenes en la raíz del conjunto de datos (su mera presencia activa el modo de máscara PNG, incluso si no se ha definidomasks_dir). A continuación, el cargador convierte los polígonos en máscaras semánticas por imagen sobre la marcha. En los conjuntos de datos multiclase (N > 1), se añade automáticamente una clasebackgroundadicional anames. En los conjuntos de datos de una sola clase (N == 1), el entrenamiento se mantiene en 1 clase: la clase que declares se convierte en1en la máscara y los píxeles no cubiertos pasan a ser0. Consulta la guía de conjuntos de datos de segmentación semántica para obtener más información.Ultralytics YOLO26 incluye configuraciones integradas para varios conjuntos de datos de segmentación semántica:
- Cityscapes: escenas urbanas con 19 clases, muy utilizado en la investigación sobre conducción autónoma.
- ADE20K: un conjunto de datos de análisis de escenas a gran escala con 150 clases.
También puedes usar cualquier conjunto de datos personalizado que proporcione anotaciones de máscaras PNG cuyos valores de píxel correspondan a ID de clase.
Valida un modelo YOLO26 de segmentación semántica preentrenado con el YAML del conjunto de datos utilizado para la evaluación:
Ejemplofrom ultralytics import YOLO # Cargar un modelo preentrenado model = YOLO("yolo26n-sem.pt") # Valida el modelo metrics = model.val(data="cityscapes.yaml") print("Mean IoU:", metrics.miou) print("Pixel Accuracy:", metrics.pixel_accuracy)Estos pasos te proporcionarán métricas de validación como la intersección sobre unión media (mIoU) y la precisión por píxel, que son medidas estándar para evaluar el rendimiento de la segmentación semántica.
Exporta un modelo YOLO26 de segmentación semántica al formato ONNX con comandos de Python o CLI:
Ejemplofrom ultralytics import YOLO # Cargar un modelo preentrenado model = YOLO("yolo26n-sem.pt") # Exporta el modelo al formato ONNX model.export(format="onnx")Encontrarás más detalles sobre la exportación a distintos formatos en la página de Exportación.