Dataset CIFAR-100#
Le dataset CIFAR-100 (Institut canadien de recherches avancées) est une référence d’évaluation pour la classification d’images, composée de 60 000 images couleur de 32x32 pixels réparties équitablement entre 100 classes fines (600 images chacune), elles-mêmes regroupées en 20 superclasses générales. Créé par Alex Krizhevsky, il est fourni avec une partition prédéfinie de 50 000 images d’entraînement et 10 000 images de test, ce qui en fait le pendant plus difficile et plus fin du dataset CIFAR-10.
Explore CIFAR-100 sur Ultralytics Platform pour prévisualiser des échantillons, examiner les statistiques du dataset et le cloner pour l’entraînement.
Fonctionnalités clés#
- CIFAR-100 contient 60 000 images couleur de 32x32 pixels, réparties équitablement entre 100 classes.
- Chaque classe contient exactement 600 images — 500 pour l’entraînement et 100 pour les tests — le dataset est donc parfaitement équilibré.
- Les 100 classes fines sont regroupées en 20 superclasses générales pour une classification de plus haut niveau.
- Le jeu de données est fourni avec une partition entraînement/test prédéfinie ; aucune division manuelle ou automatique n’est donc nécessaire.
- CIFAR-100 est une référence d’évaluation standard pour la classification d’images fine et la recherche en reconnaissance d’objets.
Structure du jeu de données#
CIFAR-100 est fourni avec une partition officielle prédéfinie, aucune division automatique ou manuelle n’est donc nécessaire :
- Classes : 100 classes fines, regroupées en 20 superclasses générales
- Total des images : 60 000 (couleur, 32x32)
- Jeu d’entraînement : 50 000 images (500 par classe)
- Jeu de test : 10 000 images (100 par classe)
CIFAR-100 ne possède pas de dossier de validation distinct ; Ultralytics utilise donc par défaut le jeu de test de 10 000 images comme partition de validation pendant l’entraînement. L’entraînement avec data="cifar100" permet d’apprendre les 100 classes fines.
Applications#
CIFAR-100 est largement utilisé pour entraîner et évaluer des modèles de classification d’images, depuis les réseaux neuronaux convolutifs classiques (CNNs) et les machines à vecteurs de support (SVMs) jusqu’aux architectures profondes modernes. Ses 100 classes fines et sa petite taille d’image en font une référence exigeante pour la recherche en apprentissage automatique, la comparaison d’algorithmes et l’expérimentation en vision par ordinateur.
Utilisation#
Entraîne un modèle YOLO sur CIFAR-100 pendant 100 époques, avec une taille d’image de 32. Pour consulter la liste complète des arguments disponibles, consulte la page Entraînement et le guide de la tâche de classification d’images.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar100", epochs=100, imgsz=32)
Exemples d’images et d’annotations#
Exemples d’images du dataset CIFAR-100 :
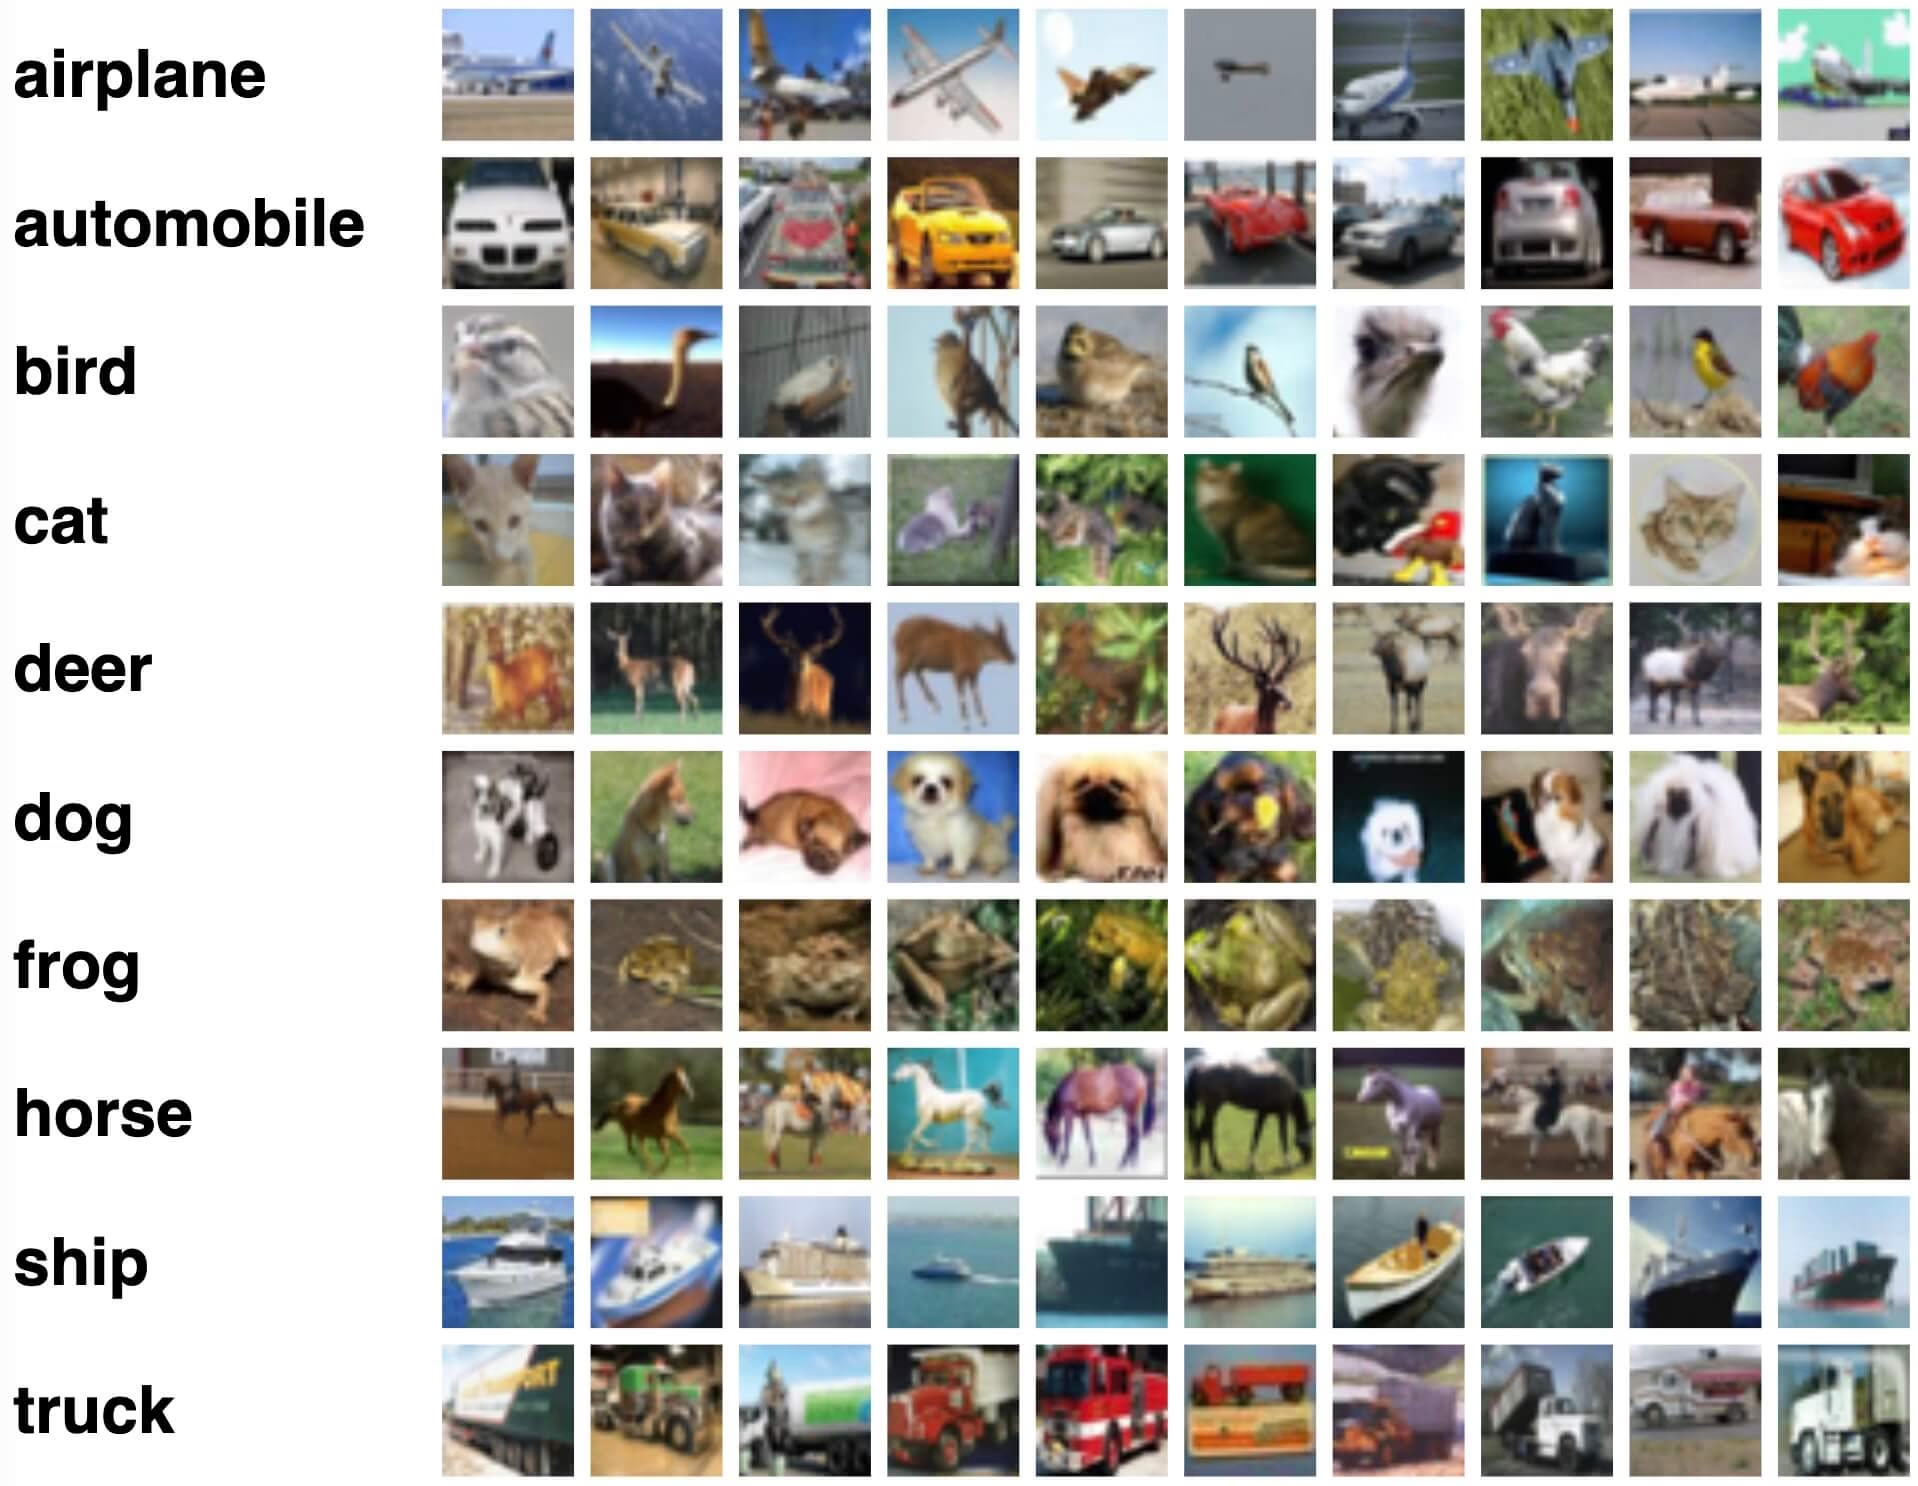
Les échantillons illustrent la diversité des objets du dataset CIFAR-100, soulignant l’intérêt d’un dataset varié pour entraîner des modèles robustes de classification d’images.
Citations et remerciements#
Si tu utilises le dataset CIFAR-100 dans tes travaux de recherche ou de développement, merci de citer l’article suivant :
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Nous souhaitons remercier Alex Krizhevsky pour avoir créé et maintenu le dataset CIFAR-100 en tant que ressource précieuse pour la communauté de recherche en apprentissage automatique et en vision par ordinateur. Pour plus d’informations sur le dataset CIFAR-100 et son créateur, consulte le site web du dataset CIFAR-100.
FAQ#
Le dataset CIFAR-100 est largement utilisé pour entraîner et évaluer des modèles de classification d’images fine et de reconnaissance d’objets. Il contient 60 000 images couleur de 32x32 pixels réparties entre 100 classes regroupées en 20 superclasses, ce qui en fait une référence plus exigeante que CIFAR-10 pour des algorithmes tels que les réseaux de neurones convolutifs (CNNs) et les machines à vecteurs de support (SVMs), ainsi que pour évaluer des modèles d’apprentissage profond construits avec Ultralytics YOLO.
CIFAR-100 compte 100 classes fines — comme la pomme, le dauphin, l’érable, la moto et la fusée — avec exactement 600 images chacune, soit 60 000 images au total. Ces 100 classes sont également regroupées en 20 superclasses générales (par exemple, la superclasse des arbres comprend l’érable, le chêne, le palmier, le pin et le saule). L’entraînement avec
data="cifar100"utilise les 100 classes fines.CIFAR-100 est fourni avec une partition prédéfinie de 50 000 images d’entraînement et 10 000 images de test, avec exactement 500 images d’entraînement et 100 images de test par classe. Contrairement aux datasets de classification fondés sur des dossiers, qu’Ultralytics divise automatiquement, la partition officielle de CIFAR-100 est utilisée telle quelle et le jeu de test sert par défaut de partition de validation pendant l’entraînement.
Oui. Ultralytics Platform te permet de gérer des datasets, d’entraîner des modèles de classification d’images et de les déployer sans codage intensif. C’est une solution pratique pour réaliser des expériences CIFAR-100 dans le cloud, et tu peux découvrir d’autres options dans notre aperçu des datasets de classification.
Pour entraîner un modèle Ultralytics YOLO sur CIFAR-100, utilise les extraits de code ci-dessous. Le dataset est téléchargé automatiquement lors de la première utilisation. Pour consulter la liste complète des arguments, consulte la page Entraînement du modèle.