Jeu de données SKU-110K
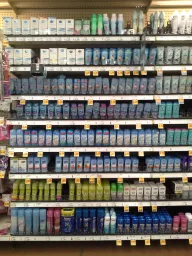
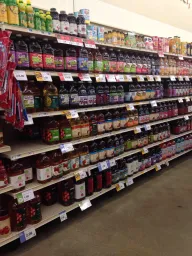
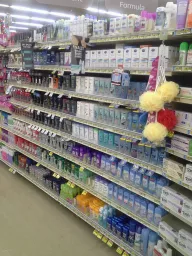
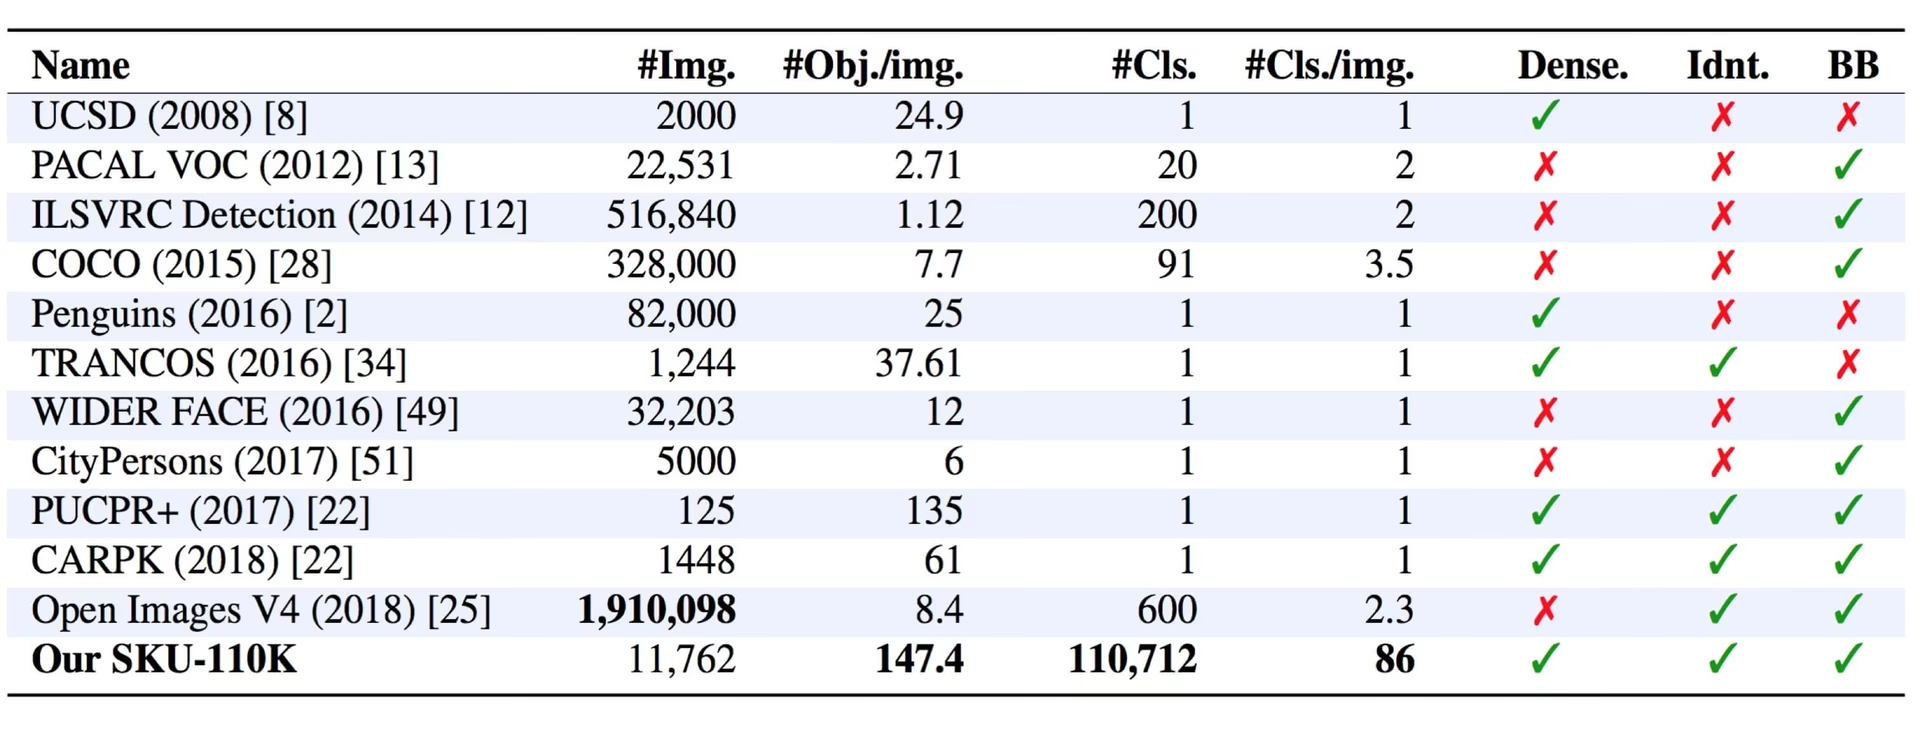
Le jeu de données SKU-110K est un jeu de données de détection d’objets à classe unique, composé de 11 743 images de rayons de magasins densément garnis, réparties en 8 219 images d’entraînement, 588 de validation et 2 936 de test. Chaque produit est annoté avec une boîte englobante dans une seule classe, object — le nom fait référence aux plus de 110 000 unités de gestion des stocks uniques (SKUs) représentées dans les scènes, et non à 110 000 classes de détection. Créé par Eran Goldman et ses collègues pour l’article CVPR 2019 Precise Detection in Densely Packed Scenes, il compte plus de 1,7 million de produits annotés — environ 147 par image — ce qui en fait un banc d’essai exigeant pour les modèles de vision par ordinateur dans les environnements de vente au détail très encombrés.
Regarder : Comment entraîner Ultralytics YOLO26 pour détecter tous les produits sur une étagère de magasin | SKU-110K 🛒
Fonctionnalités clés#
- Détection à classe unique : Chaque produit est associé à une boîte englobante dans une seule classe,
object(names: {0: object}) — les annotations ne comportent aucune catégorie par SKU. - Densité extrême d’objets : Les images de rayons de magasins du monde entier contiennent en moyenne environ 147 produits très rapprochés, souvent similaires, voire identiques.
- Grande échelle : Plus de 110 000 SKU uniques et plus de 1,7 million de boîtes englobantes annotées sur 11 743 images mettent à l’épreuve les détecteurs d’objets de pointe.
Structure du jeu de données#
Le jeu de données SKU-110K est réparti en trois sous-ensembles, qui partagent tous la classe unique object :
| Partition | Images | Description |
|---|---|---|
| Entraînement | 8,219 | Images et annotations destinées à l’entraînement du modèle |
| Validation | 588 | Images mises à part pour l’évaluation pendant l’entraînement |
| Test | 2,936 | Images destinées à l’évaluation finale du modèle entraîné |
Applications#
Le jeu de données SKU-110K est largement utilisé pour entraîner et évaluer des modèles d’apprentissage profond dans des tâches de détection d’objets, notamment dans des scènes densément peuplées comme les rayons de magasins. Ses applications comprennent :
- Gestion des stocks et automatisation du commerce de détail
- Reconnaissance de produits sur les plateformes de commerce électronique
- Vérification de la conformité des planogrammes
- Systèmes de caisse en libre-service en magasin
- Prélèvement et tri robotisés dans les entrepôts
Pour annoter tes propres images de rayons, entraîner et gérer des jeux de données de détection en vente au détail dans ton navigateur, exécute l’ensemble du flux de travail avec Ultralytics Platform.
Fichier YAML du jeu de données#
Le fichier SKU-110K.yaml définit la configuration du jeu de données — les chemins d’accès, les noms de classes et d’autres métadonnées. Il est maintenu dans le dépôt Ultralytics à l’adresse https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelUtilisation#
SKU-110K se télécharge automatiquement lors de ton premier entraînement et nécessite environ 13,6 Go d’espace disque disponible pour ses 11 743 images. Le script de téléchargement récupère également les annotations d’origine et les convertit au format YOLO, ce qui peut prendre quelques minutes.
Pour entraîner un modèle YOLO26n sur le jeu de données SKU-110K pendant 100 époques, avec une taille d’image de 640, tu peux utiliser les extraits de code suivants.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Données et annotations d’exemple#
Les images SKU-110K montrent des produits densément disposés sur de vrais rayons de magasins, où des dizaines d’articles presque identiques sont côte à côte. Voici un exemple d’image avec ses annotations :
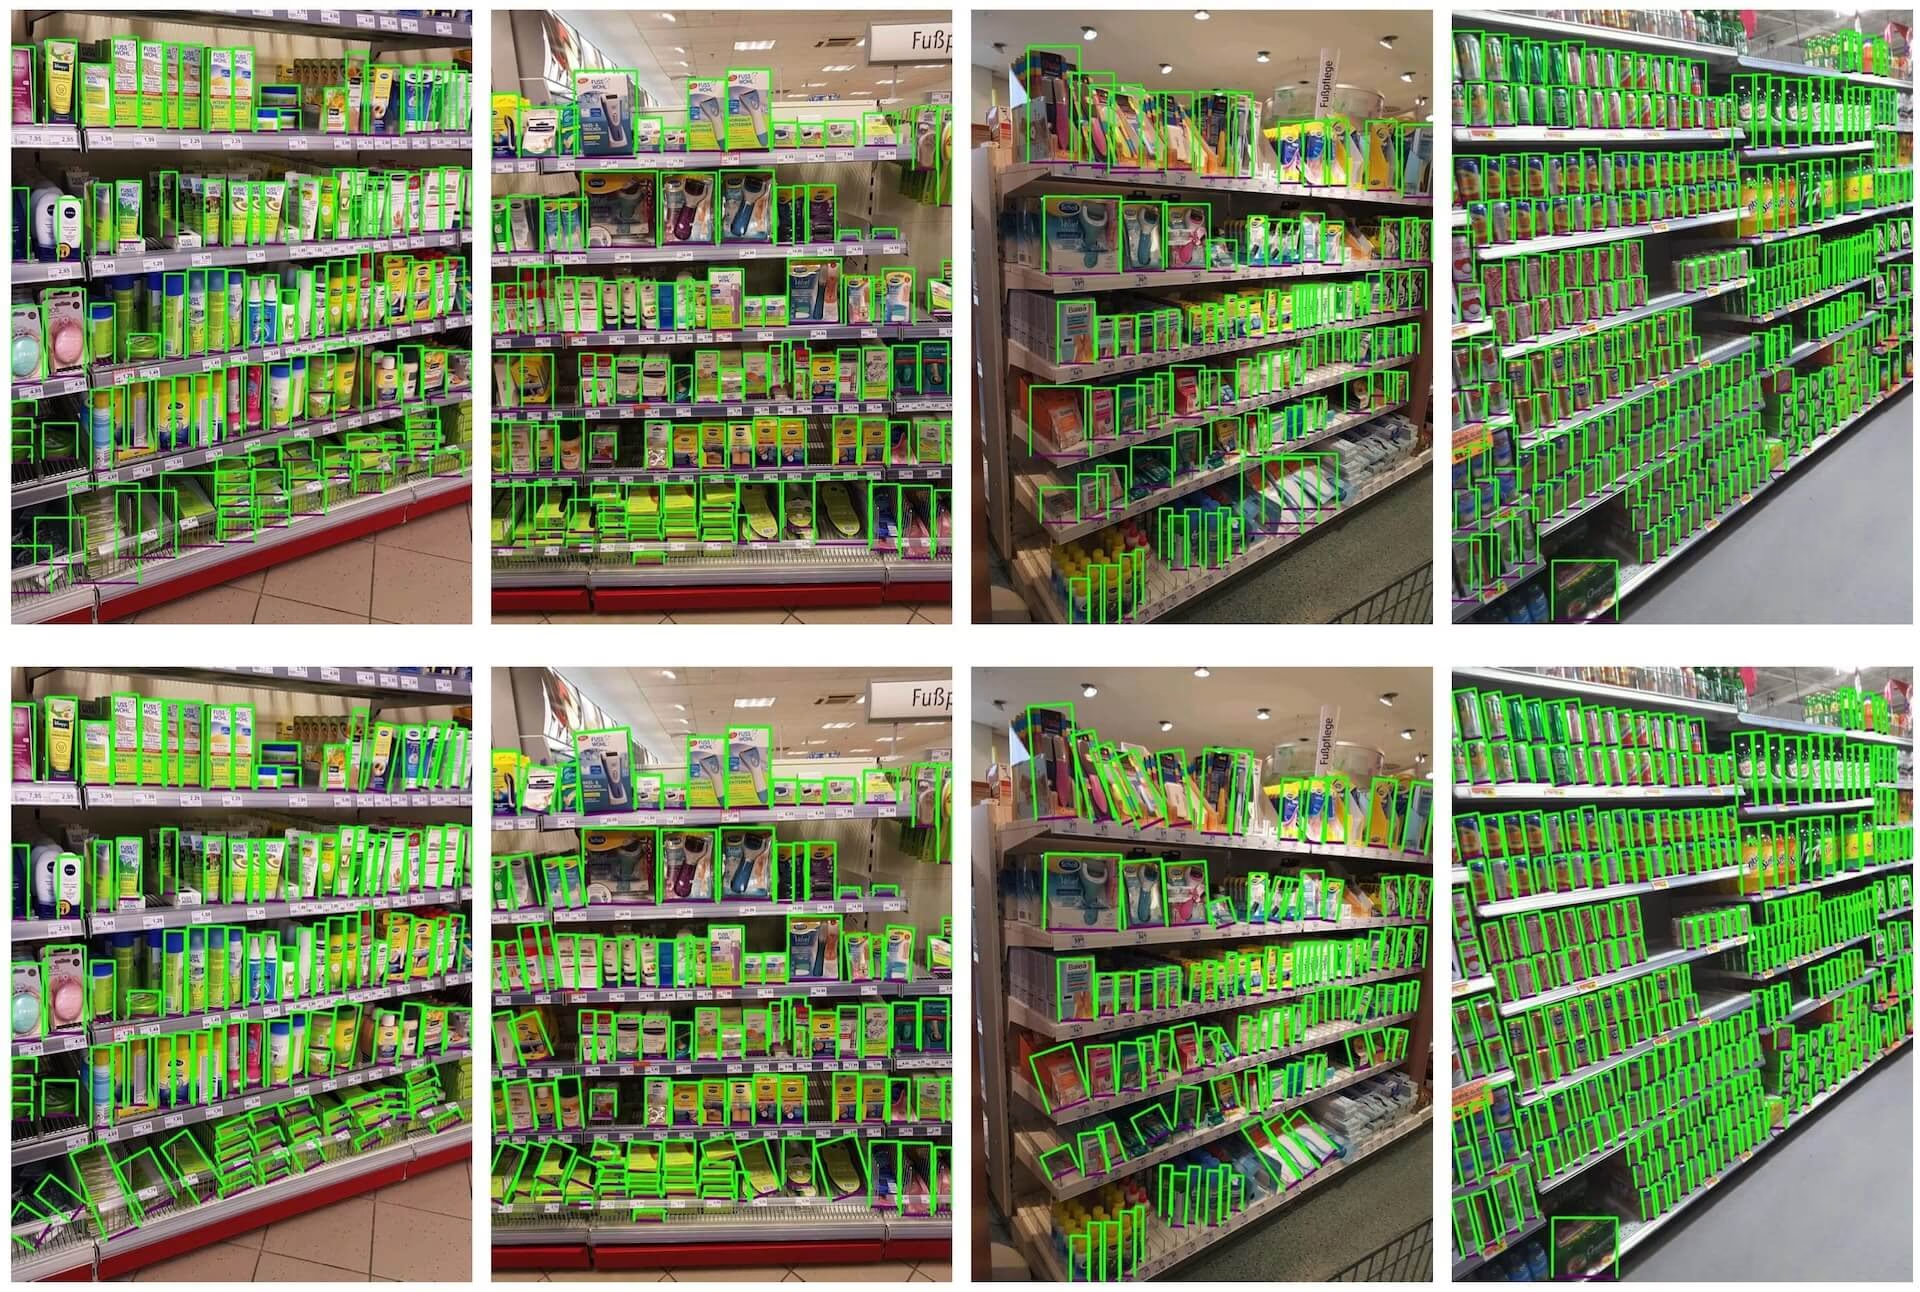
- Image d’un rayon de magasin densément garni : Cette image illustre un exemple d’objets densément disposés dans un rayon de magasin. Les objets sont annotés par des boîtes englobantes appartenant à la classe unique
object.
La disposition dense des produits rend SKU-110K particulièrement utile au développement de solutions de vision par ordinateur robustes axées sur la vente au détail, car le nombre élevé d’objets par image pousse les détecteurs bien au-delà des bancs d’essai habituels.
Citations et remerciements#
Si tu utilises le jeu de données SKU-110K dans tes travaux de recherche ou de développement, cite l’article suivant :
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Nous remercions Eran Goldman et ses collègues d’avoir créé et maintenu le jeu de données SKU-110K, une ressource précieuse pour la communauté de recherche en vision par ordinateur. Pour en savoir plus sur le jeu de données SKU-110K et ses créateurs, consulte le dépôt GitHub du jeu de données SKU-110K.
FAQ#
Le jeu de données SKU-110K est un jeu de données de détection d’objets à classe unique, composé de 11 743 images de rayons de magasin densément garnis, créé par Eran Goldman et ses collègues pour leur article présenté à CVPR 2019. Chaque produit est annoté avec une BBox
object, et les images couvrent plus de 110 000 références uniques (SKU). Il constitue ainsi une référence solide pour détecter des objets dans des scènes encombrées et créer des systèmes de vision par ordinateur pour le commerce de détail.Non. SKU-110K comporte une seule classe : chaque produit est annoté par une boîte englobante appartenant à la classe
object(names: {0: object}). Le « 110K » du nom désigne le nombre d’unités de gestion des stocks uniques (SKUs) représentées dans les images, et non le nombre de classes de détection.Le jeu de données SKU-110K contient 11 743 images — 8 219 pour l’entraînement, 588 pour la validation et 2 936 pour le test — et une seule classe de détection,
object. Consulte la section Structure du jeu de données et la configurationSKU-110K.yamlpour en savoir plus.SKU-110K pèse environ 13,6 Go et se télécharge automatiquement lors de ton premier entraînement avec
data="SKU-110K.yaml"— aucun téléchargement manuel n’est nécessaire. Pour découvrir des jeux de données plus petits, consulte la présentation des jeux de données de détection.L’entraînement d’un modèle YOLO26 sur le jeu de données SKU-110K est simple. Voici un exemple d’entraînement d’un modèle YOLO26n pendant 100 époques avec une taille d’image de 640 :
Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle model = YOLO("yolo26n.pt") # charger un modèle préentraîné (recommandé pour l’entraînement) # Entraîner le modèle results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Commentaires6
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.