Jeu de données Dog-Pose
Introduction#
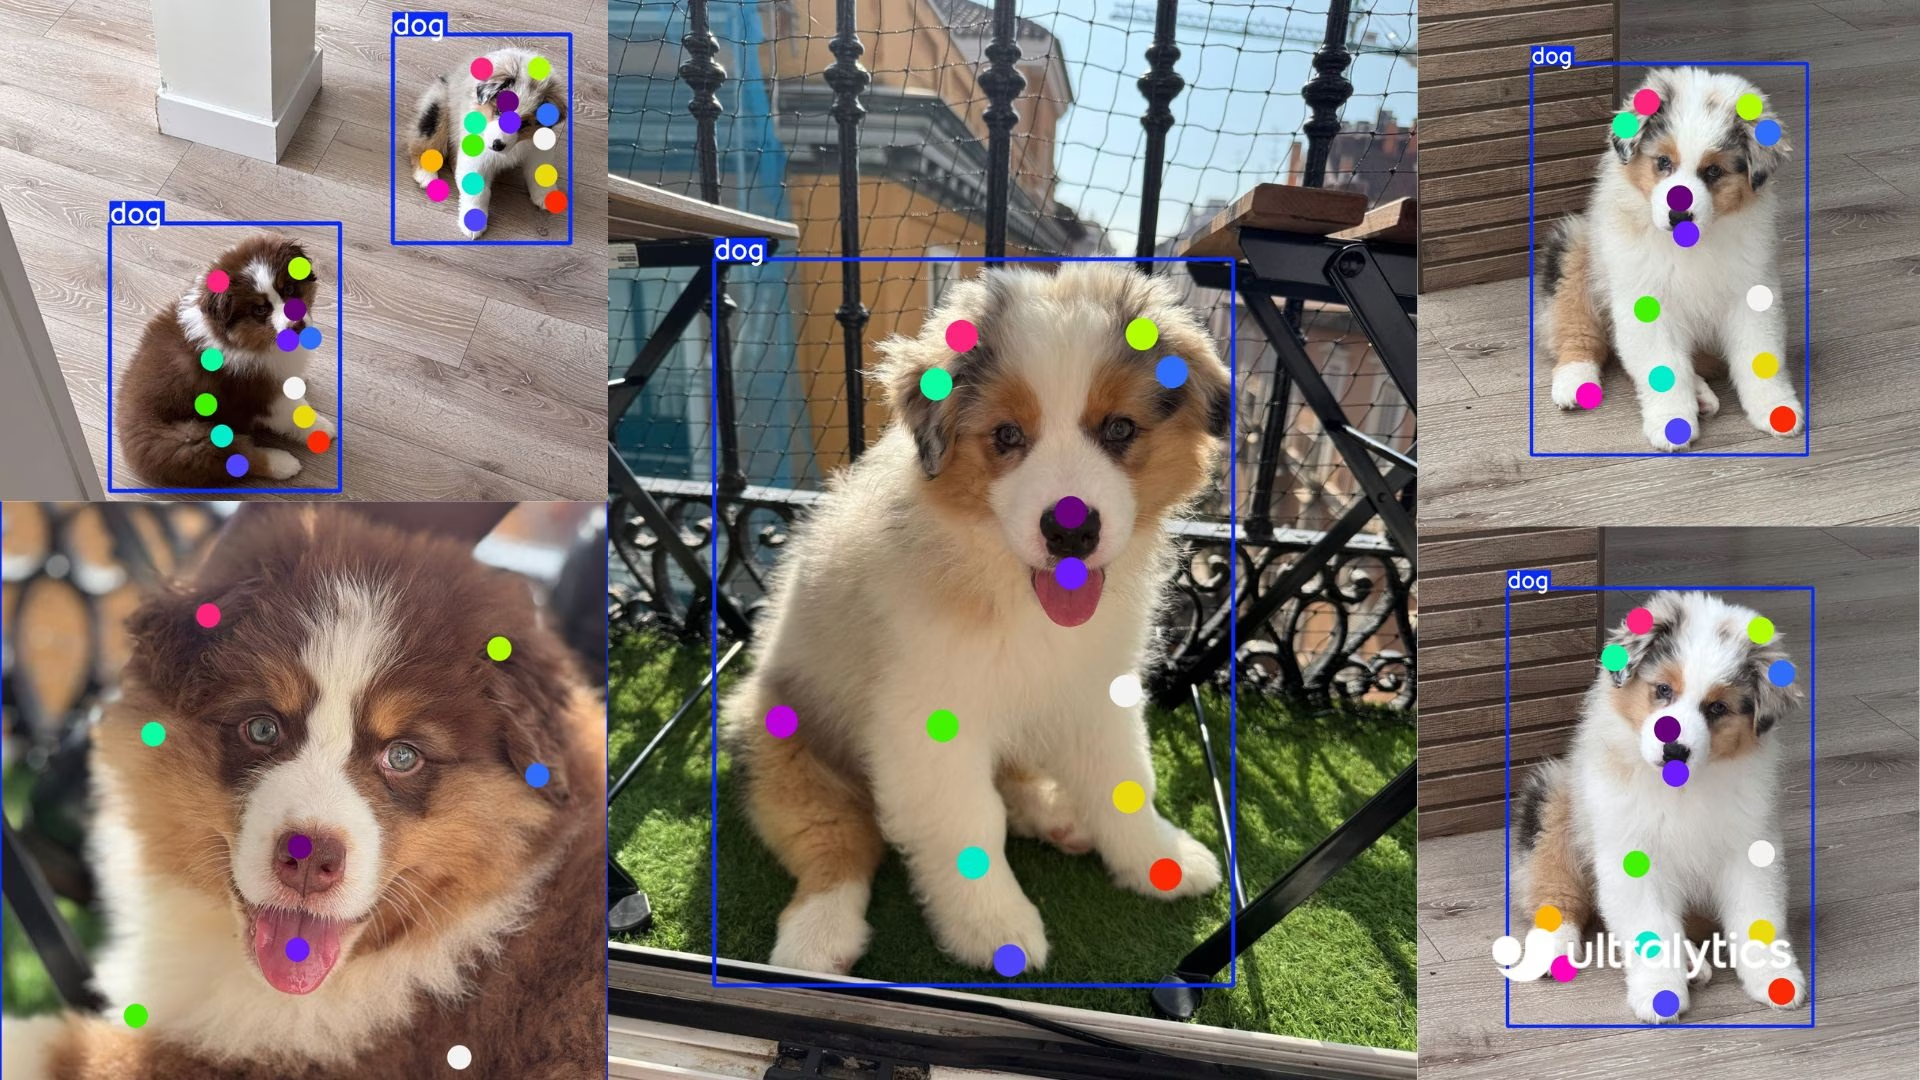
Le jeu de données Dog-Pose d’Ultralytics est un jeu d’estimation de pose conçu pour l’estimation des points clés des chiens. Il comprend 6,773 images d’entraînement et 1,703 images de validation.
Regarder : Comment entraîner un modèle Ultralytics YOLO sur le jeu de données d’estimation de pose de chiens de Stanford | Tutoriel étape par étape
Chaque image annotée comprend 24 points clés avec 3 dimensions par point clé (x, y, visibilité), ce qui permet la recherche et les applications d’estimation de la pose canine.
Pour une race particulière ou une autre espèce, la plateforme Ultralytics gère le téléversement, l’annotation et l’entraînement d’un modèle personnalisé à points clés sur tes propres données, sans que tu aies à gérer l’infrastructure.
Structure du jeu de données#
-
Nombre total d’images : 8 476 (6 773 train / 1 703 val), avec les fichiers d’annotation correspondants au format YOLO.
-
Points clés : 24 par chien, sous forme de triplets
(x, y, visibility). -
Taille du téléchargement : ~337 Mo.
-
Arborescence :
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
Fichier YAML du jeu de données#
Un fichier YAML sert à définir la configuration du jeu de données. Il comprend les chemins, les détails des points clés et d’autres informations pertinentes. Pour le jeu de données Dog-Pose, le fichier dog-pose.yaml est disponible à l’adresse https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipUtilisation#
Pour entraîner un modèle YOLO26n-pose sur le jeu de données Dog-Pose pendant 100 époques, avec une taille d’image de 640, tu peux utiliser les extraits de code suivants.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-pose.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)
Exemples d’images et annotations#
Voici quelques exemples d’images du jeu de données Dog-Pose, accompagnées de leurs annotations correspondantes :
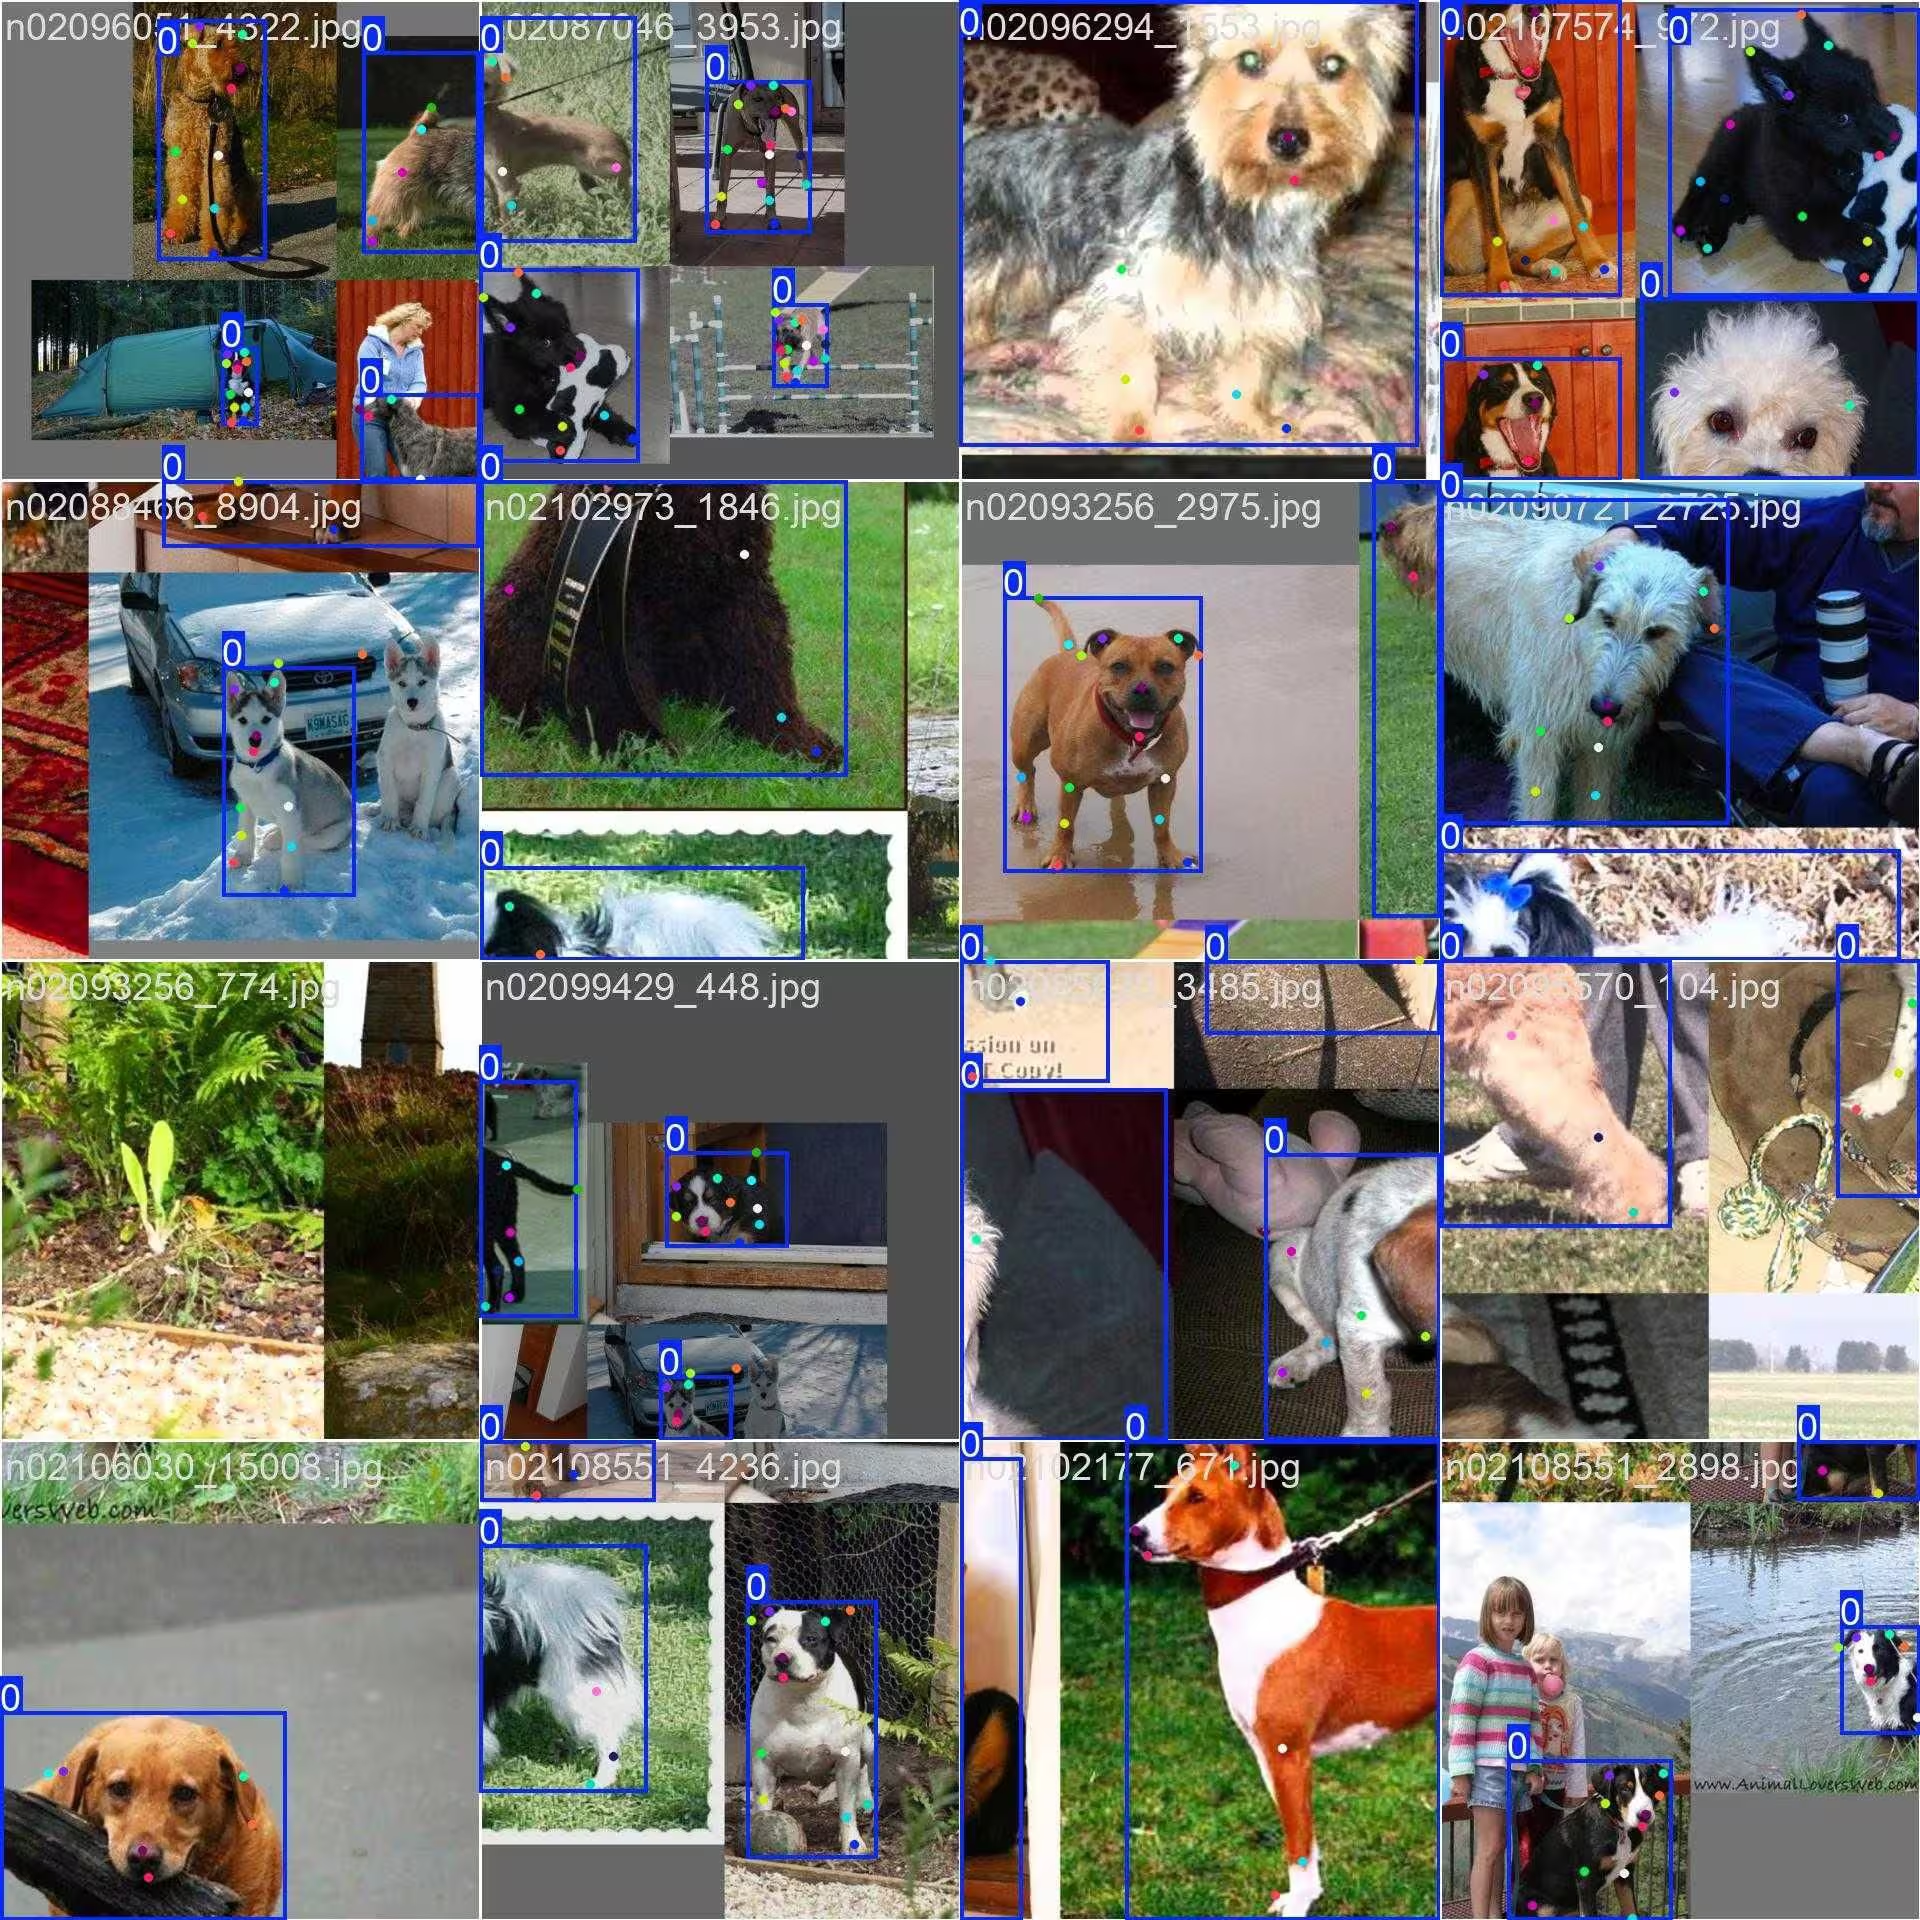
- Image en mosaïque : cette image montre un lot d’entraînement composé d’images du jeu de données assemblées en mosaïque. La mosaïque est une technique utilisée pendant l’entraînement qui combine plusieurs images en une seule afin d’augmenter la variété des objets et des scènes dans chaque lot d’entraînement. Elle aide le modèle à mieux généraliser à différentes tailles d’objets, proportions et contextes.
L’exemple illustre la variété et la complexité des images du jeu de données Dog-Pose, ainsi que les avantages de la mosaïque pendant l’entraînement.
Citations et remerciements#
Si tu utilises le jeu de données Dog-Pose dans le cadre de tes travaux de recherche ou de développement, cite l’article suivant :
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
Nous tenons à remercier l’équipe de Stanford d’avoir créé et maintenu cette précieuse ressource pour la communauté de la vision par ordinateur. Pour en savoir plus sur le jeu de données Dog-Pose et ses créateurs, consulte le site web du jeu de données Stanford Dogs.
FAQ#
Le jeu de données Dog-Pose comprend 6,773 images d’entraînement et 1,703 images de validation annotées avec 24 points clés pour l’estimation de la pose des chiens. Il est conçu pour entraîner et valider des modèles avec Ultralytics YOLO26, et permet des applications comme l’analyse du comportement animal, le suivi des animaux de compagnie et les études vétérinaires. Ses annotations détaillées le rendent particulièrement adapté au développement de modèles précis d’estimation de la pose canine.
Charge
yolo26n-pose.ptet appellemodel.train(data="dog-pose.yaml", epochs=100, imgsz=640)— consulte l’exemple d’entraînement ci-dessus pour voir tous les extraits Python et CLI, et la page Entraînement du modèle pour une liste complète des paramètres.Avec un total de 8 476 images (6 773 pour l’entraînement / 1 703 pour la validation) couvrant une grande variété de races et de poses de chiens, et 24 points clés en 3 dimensions (x, y, visibilité) par annotation, le jeu de données Dog-Pose offre aux modèles la couverture de situations réelles nécessaire à des applications telles que le suivi des animaux de compagnie et l’analyse du comportement.
La mosaïque combine plusieurs images Dog-Pose en une seule image d’entraînement, ce qui augmente la variété des postures, des tailles et des arrière-plans de chiens que le modèle voit à chaque étape. Elle améliore ainsi la généralisation à de nouveaux contextes et à de nouvelles échelles, tout en réduisant le surapprentissage. Pour voir des exemples d’images, consulte la section Exemples d’images et annotations.
Le fichier YAML du jeu de données Dog-Pose se trouve à l’adresse https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. Il définit la configuration du jeu de données, notamment les chemins, les classes, les détails des points clés et d’autres informations pertinentes. Le fichier YAML spécifie 24 points clés avec 3 dimensions par point clé, ce qui le rend adapté aux tâches d’estimation de pose détaillées.
Pour utiliser ce fichier avec les scripts d’entraînement YOLO26, indique-le dans ta commande d’entraînement comme expliqué dans la section Utilisation. Le jeu de données sera téléchargé automatiquement lors de sa première utilisation, ce qui simplifie la configuration.
Pour en savoir plus sur les modèles à points clés, consulte la documentation de la tâche Estimation de pose.


Commentaires12
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(modifié)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(modifié)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!