Integrazione con Google Cloud Storage
L'integrazione Google Cloud Storage collega i tuoi bucket GCS alla Ultralytics Platform. Le immagini restano nei tuoi bucket: la Platform le indicizza direttamente, così puoi consultarle, annotarle e addestrare modelli YOLO senza caricarne una copia. Con le funzionalità AI attive, la Platform può anche usarle per l'annotazione intelligente, l'annotazione automatica, la ricerca di immagini simili e l'addestramento nel cloud.
I dataset Google Cloud Storage richiedono un piano Pro o Enterprise. Gli spazi di lavoro Free mostrano l'integrazione e invitano a passare a un piano superiore al momento della connessione. Se un abbonamento termina, i dataset Google Cloud Storage esistenti restano completamente accessibili: solo le nuove connessioni e importazioni richiedono Pro.
Crea un account di servizio#
L'accesso in lettura copre tutto, tranne la generazione di immagini, che crea anche oggetti. La Platform non modifica né elimina mai i tuoi oggetti. Crea un account di servizio dedicato:
- Nella console Google Cloud, vai a IAM & Admin > Service Accounts e crea un account di servizio.
- Assegna il ruolo Storage Object Viewer (
roles/storage.objectViewer) ai bucket che vuoi collegare. Per la generazione di immagini, assegna anche Storage Object Creator (roles/storage.objectCreator), che crea oggetti ma non può sovrascriverli né eliminarli. - Apri l'account di servizio, seleziona Keys > Add key > Create new key, scegli JSON e scarica il file della chiave.
roles/storage.objectViewer copre tutte le operazioni che Platform esegue sui tuoi dati, ma non consente di elencare i bucket di un progetto. Se vuoi che Platform individui i bucket al posto tuo, aggiungi un ruolo che includa storage.buckets.list; altrimenti, inserisci manualmente il nome di ogni bucket durante la connessione.
Connettiti a Platform#
- Vai a Settings > Integrations e seleziona Google Cloud Storage nell'elenco delle integrazioni.
- Incolla il contenuto della chiave JSON dell'account di servizio.
- Fai clic su Find available buckets, quindi seleziona i bucket da collegare. Se l'account di servizio non può elencare i bucket, inserisci manualmente il nome di un bucket che conosci.
- Fai clic su Connetti. Prima di salvare qualsiasi dato, la Platform verifica di poter elencare e leggere ogni bucket selezionato e chiede a Google Cloud se l'account di servizio può anche creare oggetti. Non viene scritto nulla.
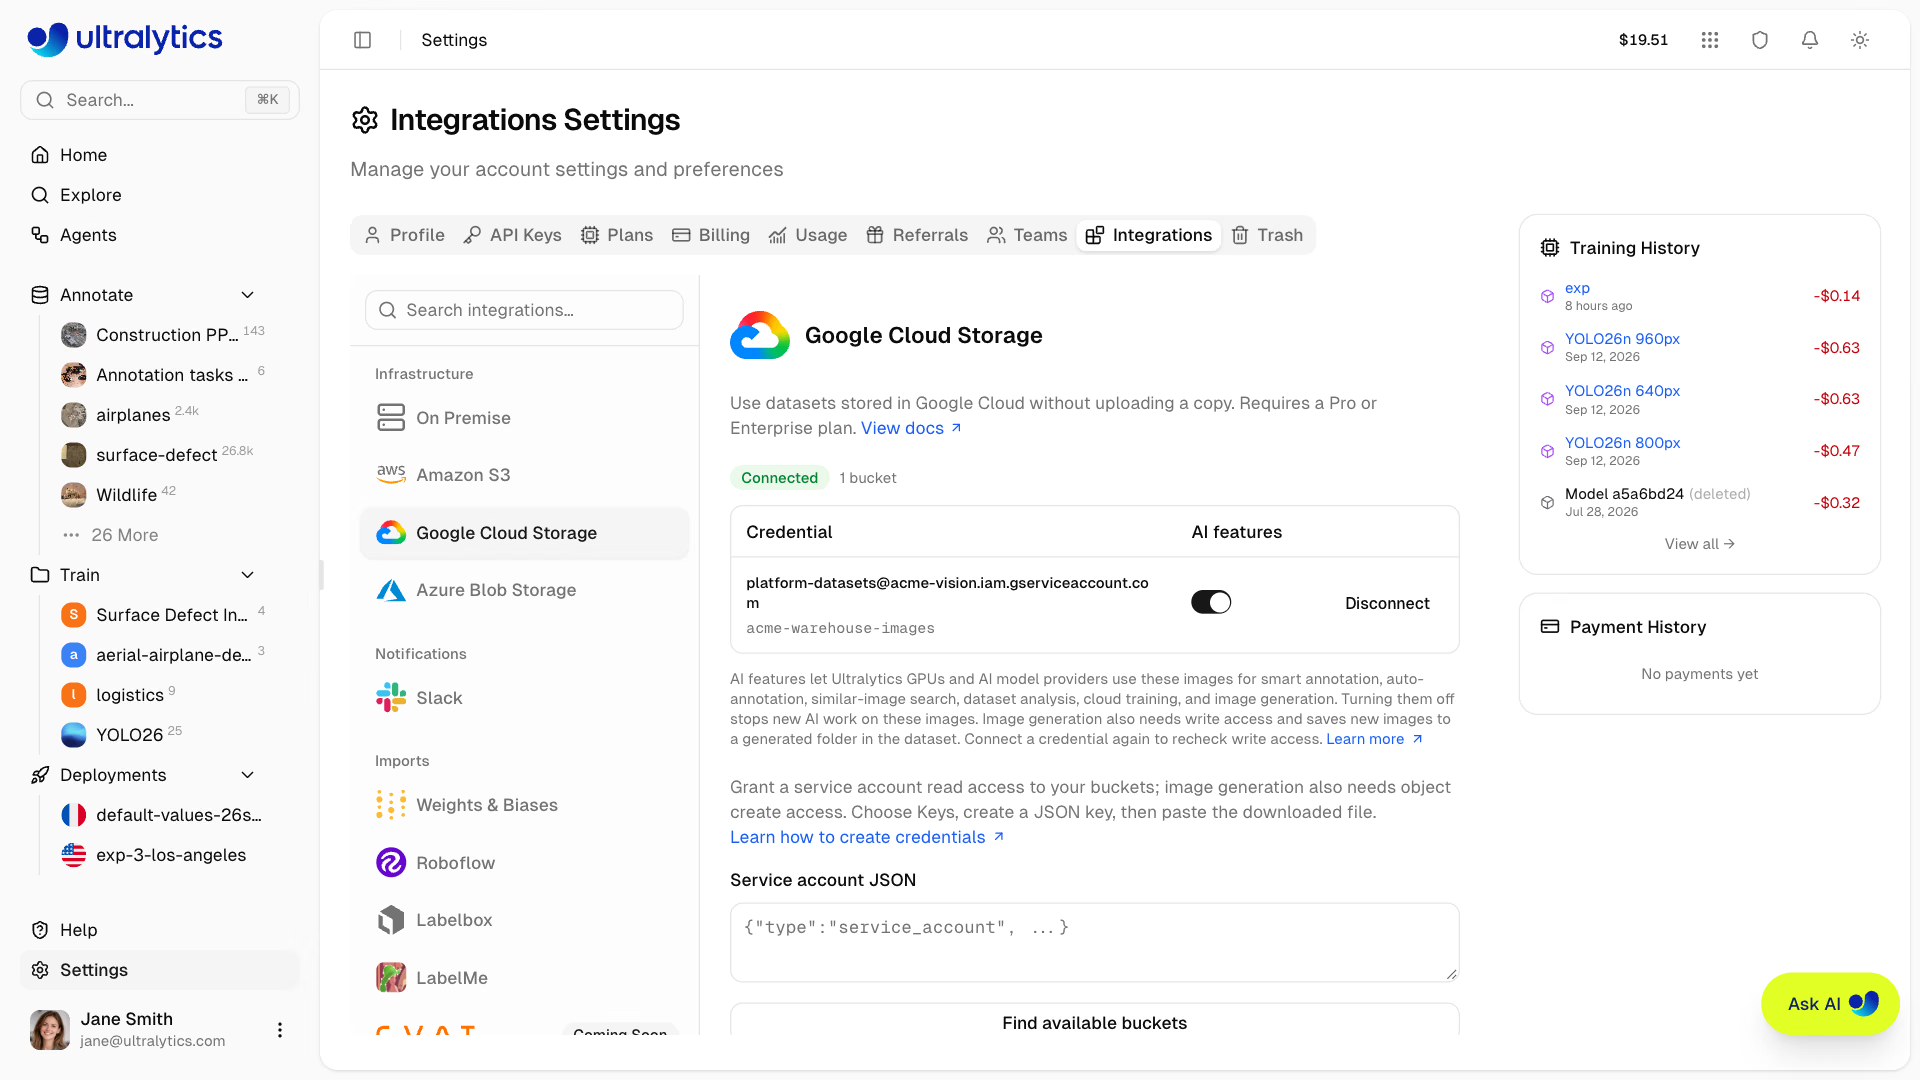
Ogni credenziale connessa include un interruttore per le funzionalità AI. Dopo aver modificato i ruoli, riconnetti lo stesso account di servizio per verificare nuovamente l'accesso in scrittura.
Per collegare lo spazio di archiviazione cloud, devi avere il ruolo di amministratore o proprietario dello spazio di lavoro. Puoi aggiungere fino a 50 bucket alla volta e l'individuazione ne elenca fino a 300 tra quelli accessibili all'account di servizio.
Il browser legge il file della chiave incollato e invia solo i tre campi necessari a Platform: client_email, private_key e project_id. Il resto del JSON non lascia mai la pagina.
Se in seguito riconnetti lo stesso account di servizio, i nuovi bucket vengono aggiunti all'integrazione esistente. Una credenziale salvata viene sostituita solo se quella nuova può ancora leggere tutti i bucket già collegati. Se non è possibile leggere un bucket, l'errore ne indica il nome, inclusi quelli collegati in precedenza con lo stesso account di servizio.
Le credenziali sono crittografate a riposo con AES-256-GCM, non vengono mai restituite al browser né esposte ai carichi di lavoro di addestramento. Per revocare l'accesso, elimina la chiave dell'account di servizio in Google Cloud.
Funzionalità AI#
Ogni credenziale connessa include un interruttore Funzionalità AI in Impostazioni > Integrazioni, attivo per impostazione predefinita. Quando è attivo, le GPU Ultralytics e i provider di modelli AI possono usare le immagini associate a quella credenziale per:
- Annotazione intelligente SAM e annotazione automatica di immagini singole e in batch
- Ricerca di immagini simili e analisi di clustering
- Addestramento nel cloud
- Generazione di immagini, nei bucket con accesso in scrittura
I provider di modelli AI intervengono solo nella generazione di immagini, per la quale Google Gemini pianifica i prompt a partire dall'immagine sorgente, e nei modelli di annotazione a pagamento, che funzionano con la chiave del provider del tuo workspace. Platform non conserva copie delle tue immagini: le funzionalità le leggono su richiesta, il training nel cloud usa copie temporanee per la durata di un'esecuzione e la ricerca di immagini simili conserva un embedding per ogni immagine, che viene eliminato quando l'immagine lascia Platform.
Disattiva l'interruttore per impedire alle GPU Ultralytics e ai provider di modelli AI di accedere alle immagini. La disattivazione interrompe l'avvio di nuove attività AI; quelle già in corso vengono completate. I dataset che usano quella credenziale mostrano quindi Funzionalità AI disattivate, con un link a queste impostazioni, e ogni funzionalità non disponibile ne spiega il motivo. L'annotazione manuale, la condivisione e l'addestramento locale continuano a funzionare, e le etichette, i modelli e i risultati di ricerca già creati vengono mantenuti.
Per modificare l'interruttore, ti serve il ruolo di amministratore o proprietario del workspace. Puoi impostarlo anche tramite la REST API, usando l'ID dell'integrazione restituito da GET /api/integrations/buckets:
curl -X PATCH \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"processing": false}' \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
Generazione di immagini#
La funzione Genera immagini simili è disponibile per i dataset Google Cloud Storage il cui bucket consente all'account di servizio di scrivere, mentre le funzionalità AI sono attive. Le immagini aggiunte vengono salvate in una cartella generated/ all'interno della cartella del dataset, quindi aggiunte al dataset come qualsiasi altra immagine indicizzata. La Platform crea nuovi oggetti in quella cartella e non sovrascrive né elimina mai quelli esistenti. Se l'azione segnala che serve l'accesso in scrittura, concedilo se necessario e riconnetti lo stesso account di servizio in Impostazioni > Integrazioni.
Crea un dataset da un bucket GCS#
- Fai clic su New Dataset e apri la scheda Cloud.
- Scegli un bucket collegato e individua la cartella che contiene i tuoi dati.
- Conferma la cartella, modifica il nome del dataset e crealo.
Platform elenca la cartella una volta e indicizza gli elementi trovati:
- Immagini — vengono indicizzati gli oggetti
.jpg,.jpeg,.png,.webpe.avif; le dimensioni vengono lette tramite richieste con limiti. Platform non conserva una seconda copia dell'immagine originale. - Etichette — i file associati YOLO
.txtvengono analizzati e convertiti in annotazioni Platform, abbinate usando la struttura standardimages/→labels/o come elementi adiacenti nella stessa cartella. - Metadati — un file YAML fornisce i nomi delle classi e la struttura dei punti chiave della posa, proprio come un caricamento di archivio. Se la cartella ne contiene diversi, vengono preferiti
data.yamledata.yml. - Attività — l'attività viene determinata da un campione dei file di etichette, quindi le cartelle di segmentazione, posa e OBB vengono riconosciute in base alla struttura delle etichette, non all'attività scelta nella finestra di dialogo.
- Suddivisioni — i nomi di cartella
train,valetestnel percorso dell'oggetto assegnano automaticamente le suddivisioni.
Il dataset funziona quindi come qualsiasi altro: puoi sfogliarlo e annotarlo, renderlo pubblico o privato, condividerlo con il tuo team e addestrare modelli usando l'addestramento gestito. Gli originali vengono trasmessi su richiesta e le immagini indicizzate non consumano la quota di spazio di archiviazione di Platform.
Una singola importazione indicizza fino a 500.000 oggetti e file di etichette o YAML fino a 1 MB ciascuno. I bucket più grandi vanno suddivisi in più dataset.
Ogni immagine indicizzata è associata alla generazione del relativo oggetto GCS e Platform blocca l'accesso in caso di modifiche all'oggetto. Aggiungi nuovi oggetti invece di sovrascrivere quelli esistenti.
Importazioni non riuscite#
Se un'importazione non riesce — per una cartella vuota, un errore di battitura nel percorso o permessi revocati — il dataset mostra l'errore nella propria pagina. Gli editor possono fare clic su Riprova importazione per riavviarla usando il bucket e la cartella salvati, oppure creare un nuovo dataset che punti al percorso corretto.
Un nuovo tentativo elenca nuovamente la cartella invece di riprendere da dove si era interrotto: gli oggetti aggiunti dopo il primo tentativo vengono inclusi, mentre quelli che non sono più presenti vengono rimossi dal dataset.
Addestramento#
L'addestramento gestito segue il normale flusso di addestramento quando le funzionalità AI sono attive. Per la durata dell'esecuzione, l'addestramento usa copie delle immagini fissate create dalla Platform; le tue credenziali Google Cloud non vengono mai esposte ai carichi di lavoro di addestramento. Se le funzionalità AI sono disattivate, la finestra di dialogo dell'addestramento spiega perché l'addestramento nel cloud non è disponibile e propone invece quello locale.
Disconnetti una connessione#
La disconnessione elimina le credenziali salvate senza modificare nulla in Google Cloud. I dataset creati a partire da questi bucket rimangono nel tuo workspace con le relative classi, etichette e annotazioni, ma le immagini non possono essere caricate, visualizzate in anteprima o usate per l'addestramento finché non viene riconnesso lo stesso account di servizio. Anche mentre sono disconnessi, puoi rinominare i dataset, modificare le etichette o eliminarli.
Per disconnettere, vai a Impostazioni > Integrazioni, seleziona Google Cloud Storage, fai clic su Disconnetti accanto alla credenziale e conferma. Quando apri uno dei dataset associati, viene mostrato Google Cloud Storage disconnesso con un link a queste impostazioni; il dataset torna disponibile automaticamente una volta effettuata la riconnessione.
Puoi anche disconnetterti tramite la REST API, usando l'ID dell'integrazione restituito da GET /api/integrations/buckets:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Per revocare l'accesso direttamente alla fonte, elimina la chiave dell'account di servizio in Google Cloud.
Limitazioni attuali#
I dataset basati su GCS non supportano le funzionalità che richiedono copie delle immagini di proprietà della Platform: clonazione dei dataset, istantanee di versione immutabili, sfocatura dei volti e incollamento di immagini da altri dataset. L'annotazione intelligente, l'annotazione automatica, la ricerca di immagini simili, il clustering, l'addestramento nel cloud e la generazione di immagini richiedono che le funzionalità AI siano attive.
L'eliminazione di un dataset collegato a GCS o di singole immagini al suo interno rimuove solo i riferimenti di Platform: gli oggetti non vengono mai modificati.
Consulta anche le integrazioni Amazon S3 e Azure Blob Storage.
Domande frequenti#
No. La Platform elenca il bucket una volta e indicizza le dimensioni e le etichette delle immagini che trova. Gli originali vengono trasmessi quando necessario per la consultazione e l'annotazione. Con le funzionalità AI attive, le GPU Ultralytics li leggono quando necessario, l'addestramento gestito usa copie temporanee per la durata dell'esecuzione e la ricerca di immagini simili conserva un embedding per ogni immagine, che viene eliminato insieme all'immagine. Gli unici oggetti che la Platform scrive sono le immagini generate che aggiungi, in
generated/. Le immagini indicizzate non vengono conteggiate nella tua quota di archiviazione.Un dataset viene indicizzato una sola volta, al momento della creazione. I nuovi oggetti non vengono acquisiti finché non crei un nuovo dataset o riprovi un'importazione non riuscita; inoltre, ogni immagine indicizzata è associata alla propria versione, quindi la sovrascrittura di un oggetto fa sì che Platform blocchi l'accesso a quell'immagine. Aggiungi nuovi oggetti invece di sostituire quelli esistenti.
Solo per la generazione di immagini, e solo quando l'account di servizio può creare oggetti e le funzionalità AI sono attive. La Platform crea nuovi oggetti in
generated/nella cartella del dataset e non sovrascrive né elimina mai quelli esistenti.Disconnetti l'integrazione in Impostazioni > Integrazioni per eliminare le credenziali salvate, oppure elimina la chiave dell'account di servizio in Google Cloud. Nessuna delle due azioni modifica i dati nei tuoi bucket. Per impedire alle GPU Ultralytics di accedere alle immagini senza disconnettere l'integrazione, disattiva le funzionalità AI.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.