어노테이션된 컴퓨터 비전 데이터의 전처리 기법#
데이터 전처리는 원시 어노테이션 이미지를 컴퓨터 비전 모델이 효과적으로 학습하는 데 필요한 깔끔하고 일관된 입력으로 변환합니다. Ultralytics YOLO26에서는 RGB 변환, [0, 1]로 스케일링, 크기 조정 등 핵심 픽셀 연산이 학습 파이프라인에서 자동으로 실행되므로, 남은 작업은 데이터셋을 올바르게 분할하고 클래스 균형을 맞추며 증강을 선택하는 것입니다. 이 가이드에서는 크기 조정, 정규화, 데이터셋 분할, 데이터 증강, 탐색적 데이터 분석(EDA) 등 필수 기법을 다룹니다.
시청: 데이터 전처리 및 증강으로 실제 환경에서 모델 정확도를 높이는 방법 🚀
이 단계는 프로젝트 목표를 정의하고 데이터를 수집하고 어노테이션한 후에 진행되며, 컴퓨터 비전 프로젝트 워크플로의 초기 단계에 해당합니다.
전처리가 중요한 이유#
전처리는 계산 부하를 줄이고 모델 성능을 개선하는 형식으로 데이터를 변환합니다. 원시 데이터의 일반적인 문제 세 가지를 해결합니다.
- 노이즈: 데이터에 포함된 관련 없는 변화 또는 무작위 변동입니다.
- 불일치: 이미지 크기, 형식, 품질의 차이입니다.
- 불균형: 데이터셋에서 클래스 또는 카테고리가 균등하게 분포하지 않은 상태입니다.
전처리 기법#
주요 기법은 크기 조정, 정규화, 데이터셋 분할, 증강입니다. YOLO26에서는 앞의 두 가지가 자동으로 처리되며, 분할과 증강에서 사용자의 선택이 가장 중요합니다.
이미지 크기 조정#
많은 모델은 일관된 입력 크기를 요구하므로, 이미지 크기를 조정하면 이미지가 균일해지고 계산 복잡도가 줄어듭니다. 흔히 사용되는 보간 방법은 다음 두 가지입니다.
- 쌍선형 보간: 가장 가까운 픽셀 네 개의 가중 평균을 계산해 픽셀 값을 부드럽게 만듭니다.
- 최근접 이웃: 평균을 계산하지 않고 가장 가까운 픽셀 값을 복사합니다. 더 빠르지만 이미지가 더 블록처럼 보입니다.
OpenCV와 PIL(Pillow) 같은 라이브러리에서 이러한 함수를 제공하지만, YOLO26에서는 일반적으로 이미지를 직접 크기 조정하지 않습니다. imgsz 인수가 이를 처리합니다. 고정 크기 정사각형 경로에서는 검증과 추론 시 종횡비를 유지하면서 이미지를 imgsz × imgsz 입력 크기(예: 640 × 640)에 맞춰 레터박스 처리하고 회색(값 114)으로 패딩합니다. 큰 이미지는 크기에 맞게 축소하며, 스케일 업이 비활성화된 경우 작은 이미지는 확대하지 않습니다. 기본 학습 경로에서는 mosaic=1.0이 대신 네 장의 이미지를 더 큰 캔버스에 타일 형태로 배치한 다음 imgsz 크기로 자릅니다. 마지막 에포크에서 close_mosaic가 모자이크를 비활성화하면 이미지는 레터박스 처리된 후에도 변환 없이 그대로 전달되는 것이 아니라 무작위 변환을 거칩니다. 직사각형 배치(rect=True)와 multi_scale은 서로 다른 입력 형태를 사용합니다.
픽셀 값 정규화#
정규화는 픽셀 값을 표준 범위로 스케일링하여 학습 중 모델이 더 빠르게 수렴하도록 돕습니다. 흔히 사용되는 기법은 다음 두 가지입니다.
- 최솟값-최댓값 스케일링: 픽셀 값을 0~1 범위로 스케일링합니다.
- Z-점수 정규화: 평균과 표준편차를 기준으로 픽셀 값을 스케일링합니다.
YOLO26은 전처리 파이프라인의 일부로 정규화를 자동 처리합니다. 이미지를 RGB로 변환하고 픽셀 값을 255로 나누어 [0, 1] 범위로 스케일링합니다(최솟값-최댓값 스케일링). YOLO는 기본적으로 ImageNet 방식의 평균/표준편차(Z-점수) 정규화를 적용하지 않으므로, 수동으로 정규화할 필요가 없습니다.
데이터셋 분할#
데이터를 학습, 검증, 테스트 세트로 분할하면 보지 않은 데이터에서 모델을 평가하고 일반화 성능을 측정할 수 있습니다. 일반적인 분할 비율은 학습 70%, 검증 20%, 테스트 10%입니다. scikit-learn이나 TensorFlow 같은 도구를 사용하면 간편하게 분할할 수 있습니다.
데이터를 분할할 때는 다음 사항을 고려하세요.
- 클래스 분포 유지: 학습, 검증, 테스트 세트 전반에서 각 클래스가 비례에 맞게 포함되도록 하세요.
- 클래스 균형 조정: 불균형 데이터셋에서는 소수 클래스를 오버샘플링하거나 다수 클래스를 언더샘플링하는 방법을 고려하세요. 단, 학습 세트에서만 적용해야 합니다.
증강이나 기타 전처리를 적용하기 전에 데이터셋을 분할하고, 이러한 변환은 학습 세트에만 적용하세요. 분할 전에 증강하면 검증 또는 테스트 이미지의 정보가 학습에 영향을 주어 점수가 실제보다 높게 나타나고 실제 데이터에서는 성능이 급격히 떨어질 수 있습니다.
데이터셋 증강#
데이터 증강은 기존 이미지를 변형해 새 버전을 생성함으로써 데이터셋의 크기를 인위적으로 늘립니다. 과적합을 줄이고 일반화 성능을 높이는 데 도움이 되며, 다음과 같은 이점이 있습니다.
- 더 강건한 모델: 조명, 방향, 크기의 변화를 적용하면 실제 환경의 왜곡에 대한 모델의 내성이 높아집니다.
- 비용 효율성: 새 데이터를 수집하고 라벨링하지 않고도 학습 세트를 확장할 수 있습니다.
- 데이터 활용도 향상: 어노테이션된 이미지 하나에서 여러 학습용 변형을 생성할 수 있습니다.
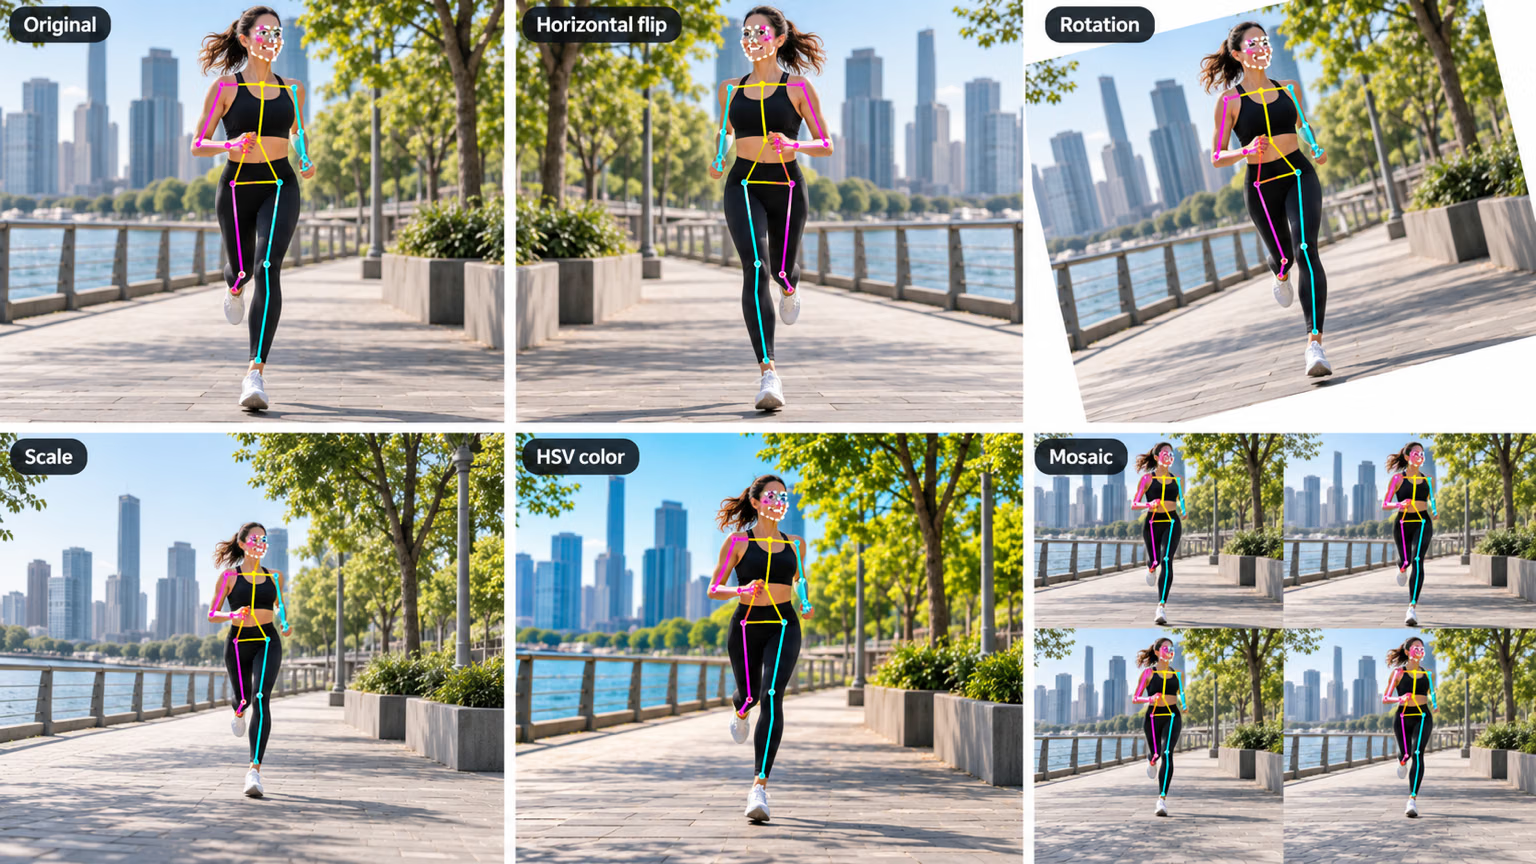
YOLO26에서는 데이터셋 메타데이터(경로, 클래스 이름, 분할 정보 등)를 정의하는 데이터셋 YAML을 편집하는 것이 아니라, model.train() 또는 해당 CLI 플래그에 전달하는 학습 인수를 통해 증강 강도를 제어합니다. 유일한 예외는 flip_idx입니다. 포즈 데이터셋은 왼쪽/오른쪽 키포인트 쌍을 매핑하기 위해 데이터셋 YAML에 이를 선언하며, 이 값이 없으면 YOLO가 fliplr와 flipud를 모두 비활성화합니다. 내장 증강에는 다음이 포함됩니다.
- 모자이크, MixUp, CutMix (
mosaic,mixup,cutmix): 여러 이미지를 하나의 학습 샘플로 결합합니다. - 플립 (
fliplr,flipud): 이미지를 가로 또는 세로로 반전합니다. - 기하학적 변환 (
degrees,translate,scale,shear,perspective): 이미지를 회전, 이동, 확대/축소, 왜곡합니다. - HSV 색상 지터 (
hsv_h,hsv_s,hsv_v): 색조, 채도, 밝기를 변경합니다. - 복사-붙여넣기 (
copy_paste): 분할된 객체의 복사본을 추가로 붙여넣습니다. 기본적으로 같은 이미지 안에서 반전해 붙여넣거나,copy_paste_mode=mixup을 사용해 다른 이미지에서 가져옵니다. - 채널 교환 (
bgr): RGB 채널 순서를 BGR로 바꿉니다. - 분류 변환 (
auto_augment,erasing): 분류기를 학습할 때 자동 증강 정책과 무작위 지우기를 적용합니다.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 증강은 데이터셋 YAML이 아니라 학습 인수로 설정합니다.
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
증강 인수 전체 목록과 기본값은 증강 설정 참조 문서와 전용 YOLO 데이터 증강 가이드를 참조하세요. albumentations 패키지가 설치되어 있으면 YOLO가 Albumentations 기반 내장 증강도 자동으로 활성화합니다.
사례 연구: 차량 탐지를 위한 전처리#
바운딩 박스와 라벨이 지정된 이미지로 시작해 YOLO26을 사용하여 교통 이미지에서 차량을 탐지하고 분류하는 프로젝트를 생각해 보겠습니다. 각 전처리 결정을 어떻게 적용하는지 살펴보세요.
- 크기 조정: 수동 작업이 필요하지 않습니다. YOLO26이 학습 중
imgsz크기로 조정합니다. - 정규화: 수동 작업이 필요하지 않습니다. YOLO26이 픽셀 값을 자동으로
[0, 1]범위로 스케일링합니다. - 분할: 클래스 분포를 분할 세트마다 일관되게 유지하면서 데이터셋을 학습 70%, 검증 20%, 테스트 10%로 나눕니다.
- 증강: 교통 장면에 적합한 학습 인수를 설정합니다. 예를 들어 방향 변화에 불변성을 부여하려면
fliplr, 주간/야간 조명에 대응하려면hsv_v, 다양한 객체 밀도에 대응하려면mosaic를 설정합니다.
이러한 결정을 내리면 데이터셋은 탐색적 데이터 분석(EDA)을 수행할 준비가 됩니다.
탐색적 데이터 분석(EDA)#
EDA는 통계와 시각화를 통해 데이터의 패턴과 분포를 파악하고, 학습 전에 클래스 불균형이나 이상치 같은 문제를 발견하도록 돕습니다.
통계적 EDA 기법#
통계적 EDA는 평균, 중앙값, 표준편차, 범위 등 기본 지표를 계산하는 것부터 시작합니다. 이러한 지표는 픽셀 강도 분포와 같은 속성을 대상으로 계산합니다. 데이터셋 품질을 빠르게 파악하고 불규칙성을 조기에 발견하는 데 도움이 됩니다.
시각적 EDA 기법#
시각화는 요약 통계로는 파악하기 어려운 클래스 불균형이나 이상치 등의 패턴을 보여 줍니다. 일반적으로 사용하는 도구는 다음과 같습니다.
- 히스토그램과 상자 그림: 픽셀 값의 분포를 보여 주고 강도 또는 특징 분포의 이상치를 표시합니다.
- 막대 차트: 클래스별 예시 수를 비교해 클래스 불균형을 보여 줍니다.
- 산점도: 이미지 특징이나 어노테이션 간의 관계를 살펴봅니다.
- 히트맵: 픽셀 강도 분포 또는 이미지 전체의 어노테이션 위치 분포를 시각화합니다.
EDA를 위한 Ultralytics Platform#
코드 없이 EDA를 수행하려면 데이터셋을 Ultralytics Platform에 업로드하세요. 데이터셋의 Charts 탭에서 분할 분포, 상위 클래스 개수, 이미지 너비/높이 히스토그램, 어노테이션 위치와 이미지 크기의 2D 히트맵 등 주요 EDA 시각화를 자동으로 생성합니다. Images 탭에서는 어노테이션 오버레이를 표시해 그리드, 컴팩트, 표 보기로 데이터를 살펴볼 수 있으므로 코드를 작성하지 않고도 라벨이 잘못 지정된 예시나 불균형한 클래스를 쉽게 찾아낼 수 있습니다.
결론#
데이터를 올바르게 분할하고 정규화 및 증강하면 노이즈가 줄고 일반화 성능이 향상되어 원시 이미지 모음이 신뢰할 수 있는 학습 세트로 바뀝니다. 데이터셋 전처리를 마쳤다면 다음 단계는 모델 학습입니다. 진행 중 궁금한 점이 있으면 Ultralytics GitHub 리포지토리 또는 Ultralytics Discord 서버에서 커뮤니티에 문의하세요.
자주 묻는 질문#
전처리는 데이터를 깔끔하고 일관되게 정리하여 학습에 최적화된 형식으로 만듭니다. 원시 데이터의 노이즈, 불일치, 클래스 불균형을 해결하고 크기 조정, 정규화, 증강, 데이터셋 분할 등을 수행하면 계산 부하를 줄이고 모델 성능을 개선할 수 있습니다. 전체 워크플로에서 전처리가 어느 단계에 해당하는지는 컴퓨터 비전 프로젝트 단계를 참조하세요.
데이터셋 YAML이 아니라 학습 인수로 증강을 설정하세요.
fliplr,mosaic,hsv_h,degrees등의 인수를model.train()또는 해당 CLI 플래그로 전달해 각 변환의 확률과 강도를 설정할 수 있습니다. 이 인수는 증강 설정에 정의되어 있으며 YOLO 데이터 증강 가이드에 설명되어 있습니다. 포즈 데이터셋은 예외입니다. 포즈 데이터셋의flip_idx키포인트 매핑은 데이터셋 YAML에 있으며, 이 매핑이 없으면 플립이 비활성화됩니다.가장 일반적인 두 가지 기법은 최솟값-최댓값 스케일링(픽셀을 0~1 범위로 재조정)과 Z-점수 정규화(평균과 표준편차를 기준으로 재조정)입니다. YOLO26은 이미지를 RGB로 변환하고 픽셀 값을 255로 나누어 최솟값-최댓값 스케일링을 자동 적용하므로 수동으로 정규화할 필요가 없습니다. 기본적으로 Z-점수 정규화는 적용하지 않습니다.
일반적으로 학습 70%, 검증 20%, 테스트 10%로 분할합니다. 세 분할 전체에서 클래스 분포를 유지하고, 분할한 후에 학습 세트에만 증강을 적용하여 데이터 누수를 방지하세요. scikit-learn이나 TensorFlow 같은 도구를 사용하면 효율적으로 분할할 수 있습니다. 데이터셋 사전 준비에 대한 내용은 데이터 수집 및 어노테이션 가이드를 참조하세요.
예.
imgsz인수로 목표 입력 크기를 제어하므로 수동 작업이 필요하지 않습니다. 고정 크기 정사각형 경로에서는 검증과 추론 시 지정된 형태에 맞춰 이미지의 종횡비를 유지하며 레터박스 처리합니다. 큰 이미지는 크기에 맞게 축소하며, 스케일 업이 비활성화된 경우 작은 이미지는 확대하지 않습니다. 학습 중에는 기본 모자이크 증강이 이미지 네 장을 타일 형태로 배치한 후 자르는 방식으로 목표 크기를 맞춥니다. 직사각형 배치(rect=True)와multi_scale는 서로 다른 입력 형태를 사용합니다. 자세한 내용은 모델 학습 문서를 참조하세요.