Conjunto de dados Caltech-256#
O conjunto de dados Caltech-256 é um benchmark clássico de classificação de imagens com 30.607 imagens que abrangem 256 categorias de objetos, além de uma classe de fundo. Cada categoria contém pelo menos 80 imagens de objetos do mundo real — animais, veículos, objetos domésticos e pessoas — tornando-o um sucessor maior e mais desafiador do Caltech-101 para modelos de reconhecimento de objetos.
Explora o Caltech-256 na Ultralytics Platform para pré-visualizar amostras, consultar as estatísticas do conjunto de dados e cloná-lo para treino.
O Caltech-256 é fornecido sem uma divisão predefinida entre treino e validação. Os comandos de treino abaixo dividem-no automaticamente em 80% para treino e 20% para validação, pelo que não é necessária qualquer preparação manual.
Principais funcionalidades#
- O Caltech-256 contém 30.607 imagens a cores distribuídas por 256 categorias de objetos, além de uma classe de fundo
257.clutter(257 pastas de classes no total). - As categorias abrangem uma grande variedade de objetos do mundo real, incluindo animais, veículos, objetos domésticos e pessoas.
- Cada categoria contém pelo menos 80 imagens, enquanto a maior contém até cerca de 800, pelo que os tamanhos das classes são desequilibrados.
- As imagens têm tamanhos e resoluções variáveis.
- O Caltech-256 é amplamente utilizado para avaliar comparativamente algoritmos de classificação de imagens e reconhecimento de objetos.
Estrutura do Conjunto de Dados#
O Caltech-256 é distribuído como 257 pastas — uma por classe, abrangendo 256 categorias de objetos, além de uma classe de fundo 257.clutter — sem uma divisão predefinida entre treino e validação. Quando inicias o treino, a Ultralytics particiona automaticamente as imagens para que os modelos treinem em todas as 257 classes, sem qualquer configuração manual:
- Classes: 257 (256 categorias de objetos + 1 de fundo)
- Total de imagens: 30.607
- Divisão treino/validação: automática, 80% / 20% (≈24.385 para treino, ≈6.222 para validação)
- Imagens por classe: pelo menos 80 (desequilibradas, até cerca de 800)
Aplicações#
O conjunto de dados Caltech-256 é amplamente utilizado para treinar e avaliar modelos de classificação de imagens e reconhecimento de objetos, incluindo redes neuronais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs). O elevado número de categorias e as imagens de alta qualidade fazem dele um benchmark popular para investigação e prototipagem em aprendizagem automática e visão computacional.
Utilização#
Treina um modelo YOLO no Caltech-256 durante 100 épocas, com um tamanho de imagem de 416. Para consultar a lista completa de argumentos disponíveis, vê a página de Treino e o guia da tarefa de classificação de imagens.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)
Imagens de exemplo e anotações#
O conjunto de dados Caltech-256 contém imagens a cores de alta qualidade de vários objetos, fornecendo um conjunto de dados bem estruturado para tarefas de classificação de imagens. Eis alguns exemplos de imagens do conjunto de dados (créditos):
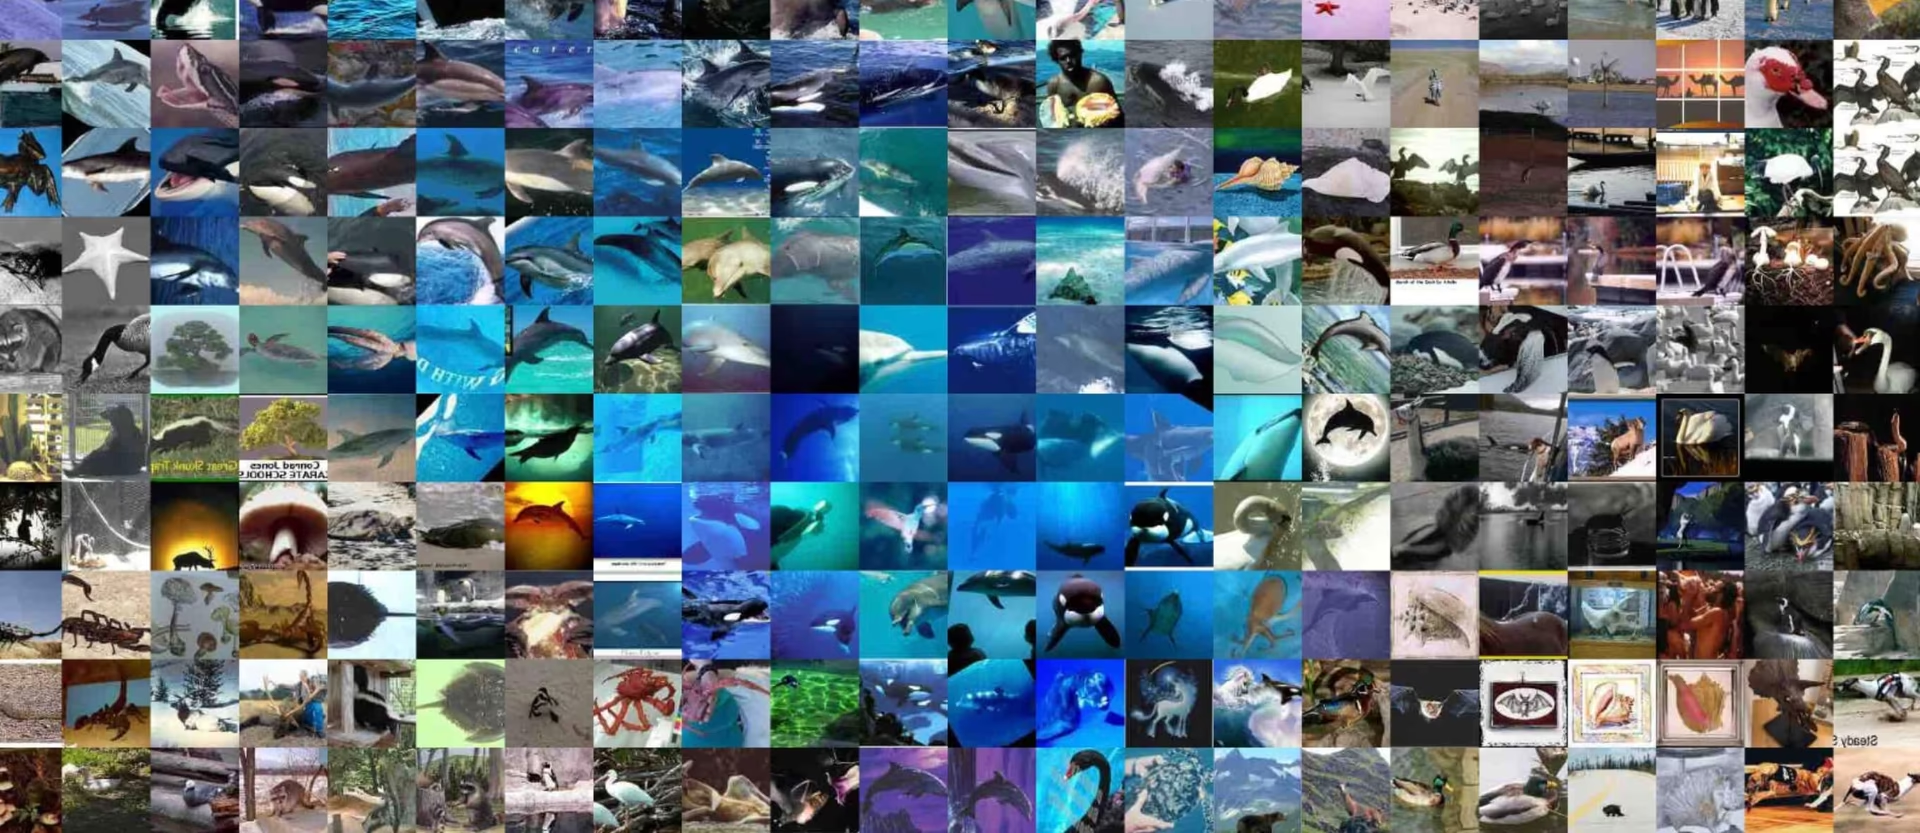
As amostras mostram a diversidade e a complexidade dos objetos no conjunto de dados Caltech-256, destacando o valor de um conjunto de dados diversificado para treinar modelos robustos de reconhecimento de objetos.
Citações e agradecimentos#
Se utilizares o conjunto de dados Caltech-256 no teu trabalho de investigação ou desenvolvimento, cita o seguinte artigo:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Gostaríamos de agradecer a Gregory Griffin, Alex Holub e Pietro Perona por criarem e manterem o conjunto de dados Caltech-256 como um recurso valioso para a comunidade de investigação em aprendizagem automática e visão computacional. Para obteres mais informações sobre o conjunto de dados Caltech-256 e os seus criadores, visita o site do conjunto de dados Caltech-256.
Perguntas frequentes#
O conjunto de dados Caltech-256 é amplamente utilizado para treinar e avaliar comparativamente modelos de classificação de imagens e reconhecimento de objetos. Contém 30.607 imagens distribuídas por 256 categorias de objetos, além de uma classe de fundo, fornecendo um benchmark maior e mais desafiador do que o Caltech-101 para algoritmos como redes neuronais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs).
Para treinares um modelo Ultralytics YOLO no Caltech-256, utiliza os fragmentos de código abaixo. O conjunto de dados é descarregado automaticamente na primeira utilização. Para consultar a lista completa de argumentos, vê a página de Treino do modelo.
Exemplo de treinofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)O Caltech-256 contém 256 categorias de objetos, além de uma classe de fundo
257.clutter, totalizando 257 pastas de classes e 30.607 imagens. Quando treinas com a Ultralytics, o modelo aprende todas as 257 classes. Cada categoria contém pelo menos 80 imagens, mas os tamanhos das classes são desequilibrados, sendo que a maior contém até cerca de 800 imagens.O Caltech-256 não tem uma divisão predefinida. Na primeira vez que treinares, a Ultralytics divide-o automaticamente em 80% para treino e 20% para validação — cerca de 24.385 imagens de treino e 6.222 de validação —, pelo que não precisas de criar as divisões manualmente. Para controlares a divisão, organiza as imagens nas pastas
train/eval/antes do treino.Sim. A Ultralytics Platform permite gerir conjuntos de dados, treinar modelos de classificação de imagens e implementá-los sem programação extensa. É uma forma conveniente de executar experiências com o Caltech-256 na nuvem, e podes explorar mais opções na nossa visão geral dos conjuntos de dados de classificação.