Conjunto de dados CIFAR-100#
O conjunto de dados CIFAR-100 (Instituto Canadense de Pesquisa Avançada) é uma referência de classificação de imagens, com 60.000 imagens coloridas de 32x32 pixels distribuídas igualmente entre 100 classes detalhadas (600 imagens cada), agrupadas em 20 superclasses abrangentes. Criado por Alex Krizhevsky, ele inclui uma divisão predefinida de 50.000 imagens de treinamento e 10.000 imagens de teste, tornando-se uma versão mais difícil e detalhada do conjunto de dados CIFAR-10.
Explore o CIFAR-100 na Ultralytics Platform para visualizar amostras, consultar estatísticas do conjunto de dados e cloná-lo para treinamento.
Principais funcionalidades#
- O CIFAR-100 contém 60.000 imagens coloridas de 32x32 pixels, divididas igualmente em 100 classes.
- Cada classe contém exatamente 600 imagens — 500 para treinamento e 100 para teste —, portanto o conjunto de dados é perfeitamente equilibrado.
- As 100 classes detalhadas são agrupadas em 20 superclasses abrangentes para classificação em níveis mais gerais.
- O conjunto de dados inclui uma divisão predefinida entre treinamento e teste, portanto não é necessário fazer uma divisão manual ou automática.
- O CIFAR-100 é uma referência padrão para pesquisas em classificação de imagens detalhada e reconhecimento de objetos.
Estrutura do conjunto de dados#
O CIFAR-100 inclui uma divisão oficial predefinida, portanto não é necessário fazer uma partição automática ou manual:
- Classes: 100 classes detalhadas, agrupadas em 20 superclasses abrangentes
- Total de imagens: 60.000 (coloridas, 32x32)
- Conjunto de treinamento: 50.000 imagens (500 por classe)
- Conjunto de teste: 10.000 imagens (100 por classe)
O CIFAR-100 não tem uma pasta de validação separada, então, por padrão, a Ultralytics usa o conjunto de teste de 10.000 imagens como divisão de validação durante o treinamento. O treinamento com data="cifar100" aprende as 100 classes detalhadas.
Aplicações#
O CIFAR-100 é amplamente usado para treinar e avaliar modelos de classificação de imagens, desde as clássicas redes neurais convolucionais (CNNs) e máquinas de vetores de suporte (SVMs) até arquiteturas profundas modernas. As suas 100 classes detalhadas e o tamanho reduzido das imagens fazem dele um benchmark exigente para investigação em aprendizagem automática, comparação de algoritmos e experiências de visão computacional.
Uso#
Treina um modelo YOLO com o CIFAR-100 durante 100 épocas, com um tamanho de imagem de 32. Para consultar a lista completa dos argumentos disponíveis, vê a página de treino e o guia da tarefa de classificação de imagens.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-cls.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="cifar100", epochs=100, imgsz=32)
Imagens de exemplo e anotações#
Imagens de exemplo do conjunto de dados CIFAR-100:
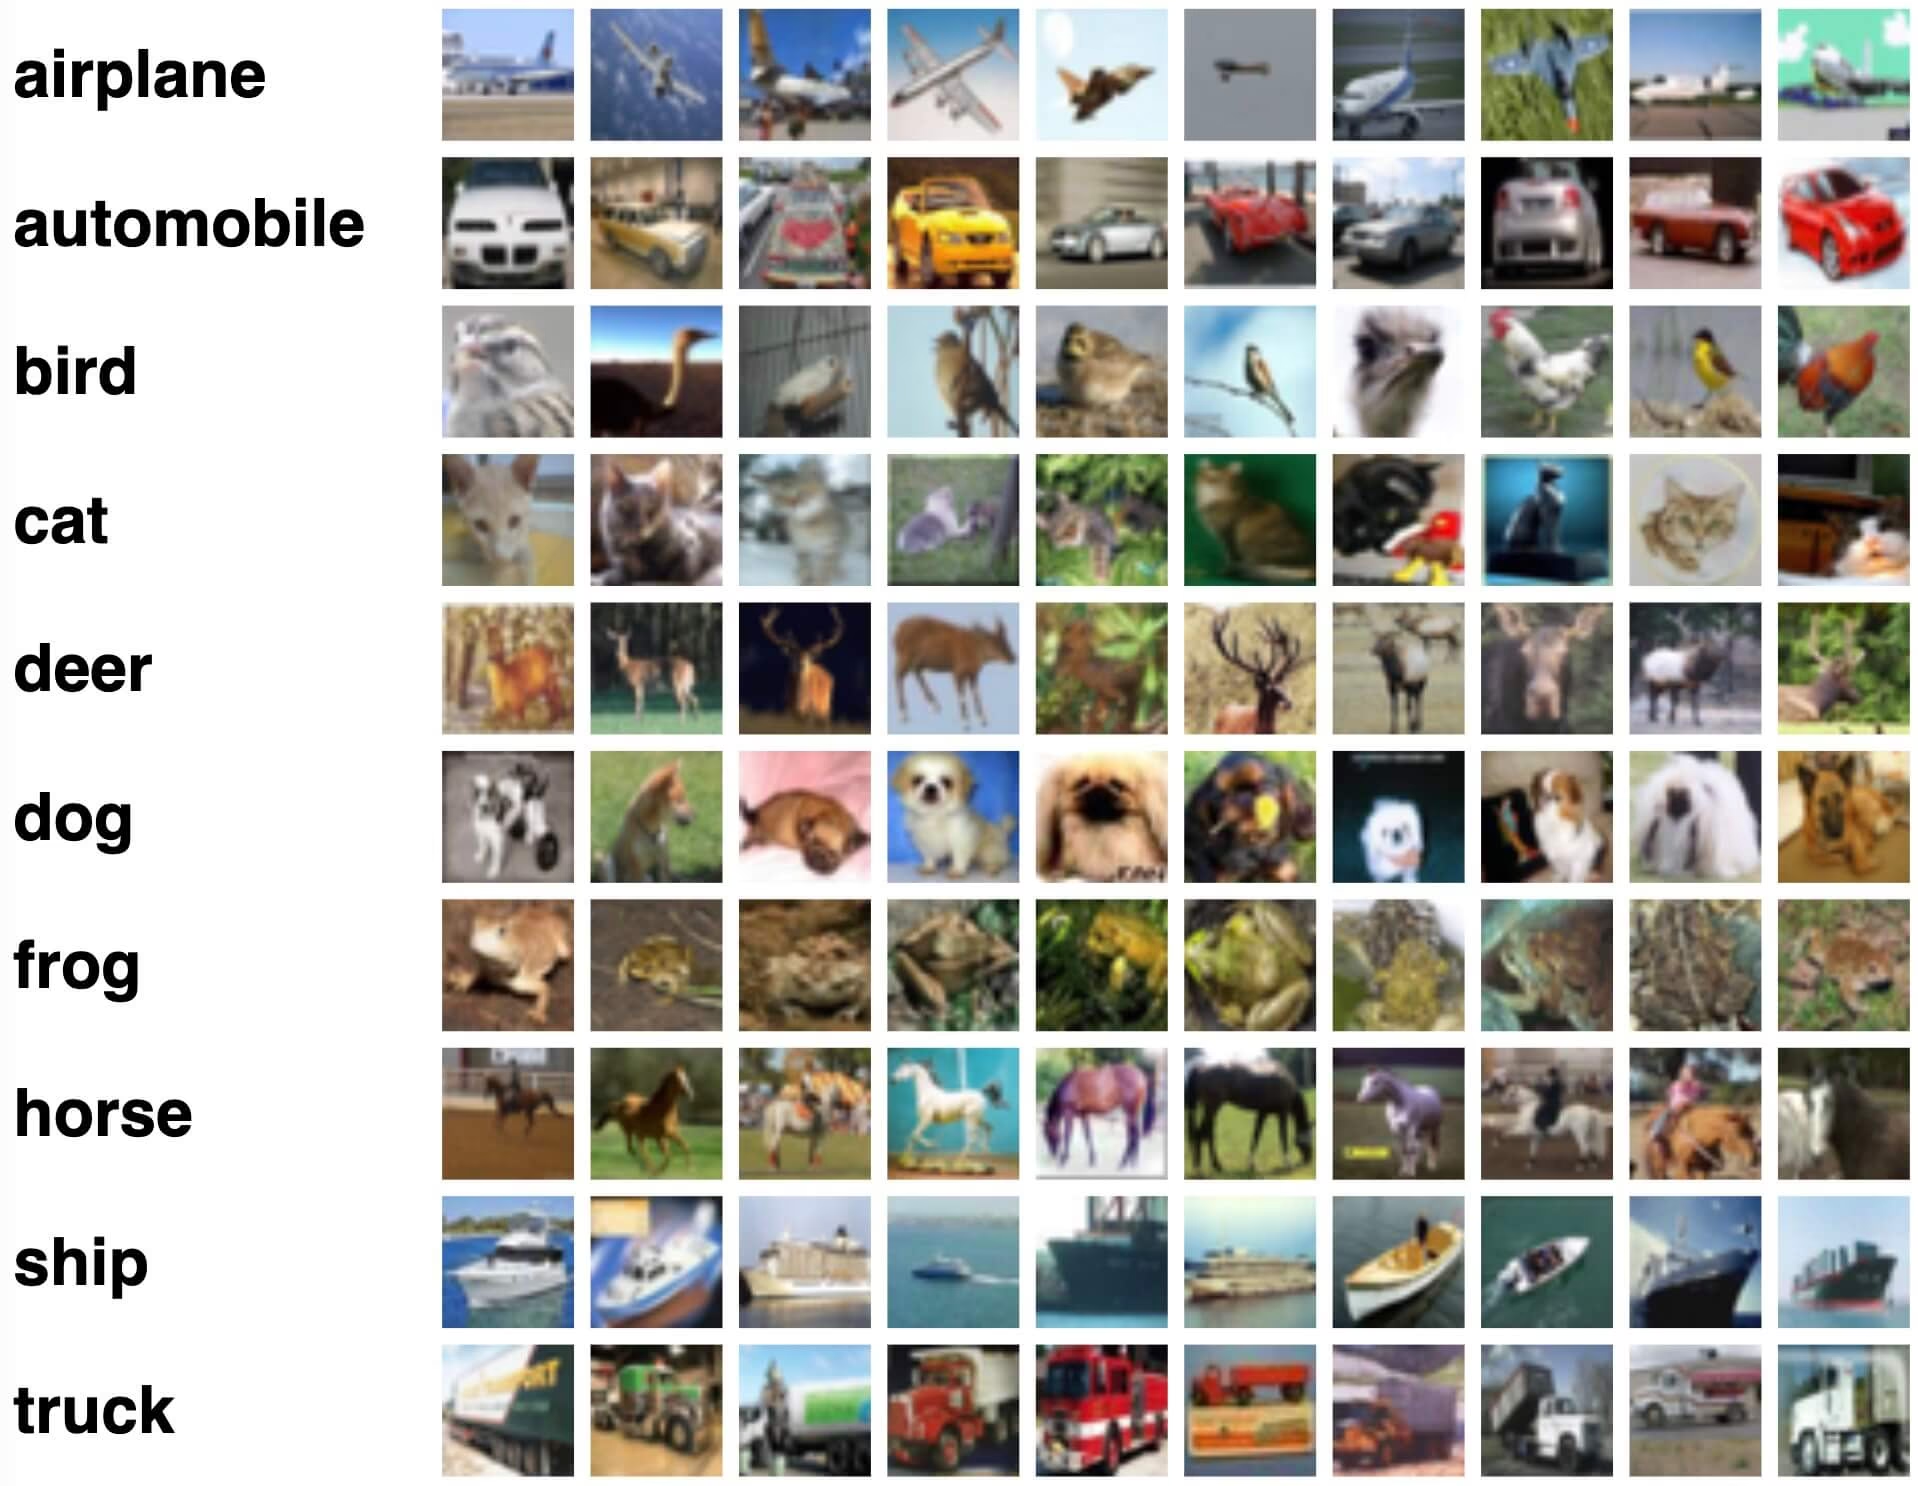
Os exemplos mostram a diversidade dos objetos no conjunto de dados CIFAR-100, realçando o valor de um conjunto de dados variado para treinar modelos robustos de classificação de imagens.
Citações e agradecimentos#
Se usares o conjunto de dados CIFAR-100 no teu trabalho de investigação ou desenvolvimento, cita o seguinte artigo:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Gostaríamos de reconhecer Alex Krizhevsky pela criação e manutenção do conjunto de dados CIFAR-100, um recurso valioso para a comunidade de investigação em aprendizagem automática e visão computacional. Para obteres mais informações sobre o conjunto de dados CIFAR-100 e o seu criador, visita o site do conjunto de dados CIFAR-100.
Perguntas frequentes#
O conjunto de dados CIFAR-100 é amplamente usado para treinar e avaliar benchmarks de modelos de classificação de imagens detalhada e reconhecimento de objetos. Contém 60 000 imagens a cores de 32x32, distribuídas por 100 classes agrupadas em 20 superclasses, o que o torna um benchmark mais exigente do que o CIFAR-10 para algoritmos como as redes neurais convolucionais (CNNs) e as máquinas de vetores de suporte (SVMs), bem como para avaliar modelos de aprendizagem profunda criados com o Ultralytics YOLO.
Para treinar um modelo Ultralytics YOLO com o CIFAR-100, usa os seguintes excertos de código. O conjunto de dados é transferido automaticamente na primeira utilização. Para consultar a lista completa dos argumentos, vê a página de treino do modelo.
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n-cls.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="cifar100", epochs=100, imgsz=32)O CIFAR-100 tem 100 classes detalhadas — como maçã, golfinho, bordo, motocicleta e foguete — com exatamente 600 imagens cada, num total de 60 000 imagens. Estas 100 classes estão também agrupadas em 20 superclasses abrangentes (por exemplo, a superclasse das árvores inclui bordo, carvalho, palmeira, pinheiro e salgueiro). O treino com
data="cifar100"usa as 100 classes detalhadas.O CIFAR-100 inclui uma divisão predefinida de 50 000 imagens de treino e 10 000 imagens de teste, com exatamente 500 imagens de treino e 100 de teste por classe. Ao contrário dos conjuntos de dados de classificação baseados em pastas, que o Ultralytics divide automaticamente, a partição oficial do CIFAR-100 é usada tal como está, e o conjunto de teste serve, por predefinição, como conjunto de validação durante o treino.
Sim. A Ultralytics Platform permite-te gerir conjuntos de dados, treinar modelos de classificação de imagens e implementá-los sem programação extensiva. É uma forma prática de executar experiências com o CIFAR-100 na cloud, e podes explorar mais opções na nossa visão geral dos conjuntos de dados de classificação.