Conjunto de dados Dog-Pose
Introdução#
O conjunto de dados Dog-Pose da Ultralytics é um conjunto de dados de estimativa de pose selecionado para estimar pontos-chave de cães, com 6.773 imagens de treinamento e 1.703 imagens de validação.
Assista: Como treinar um modelo Ultralytics YOLO no conjunto de dados Stanford Dog Pose Estimation | Tutorial passo a passo
Cada imagem anotada inclui 24 pontos-chave com 3 dimensões por ponto-chave (x, y, visibilidade), contribuindo para a investigação e as aplicações de estimativa de pose canina.
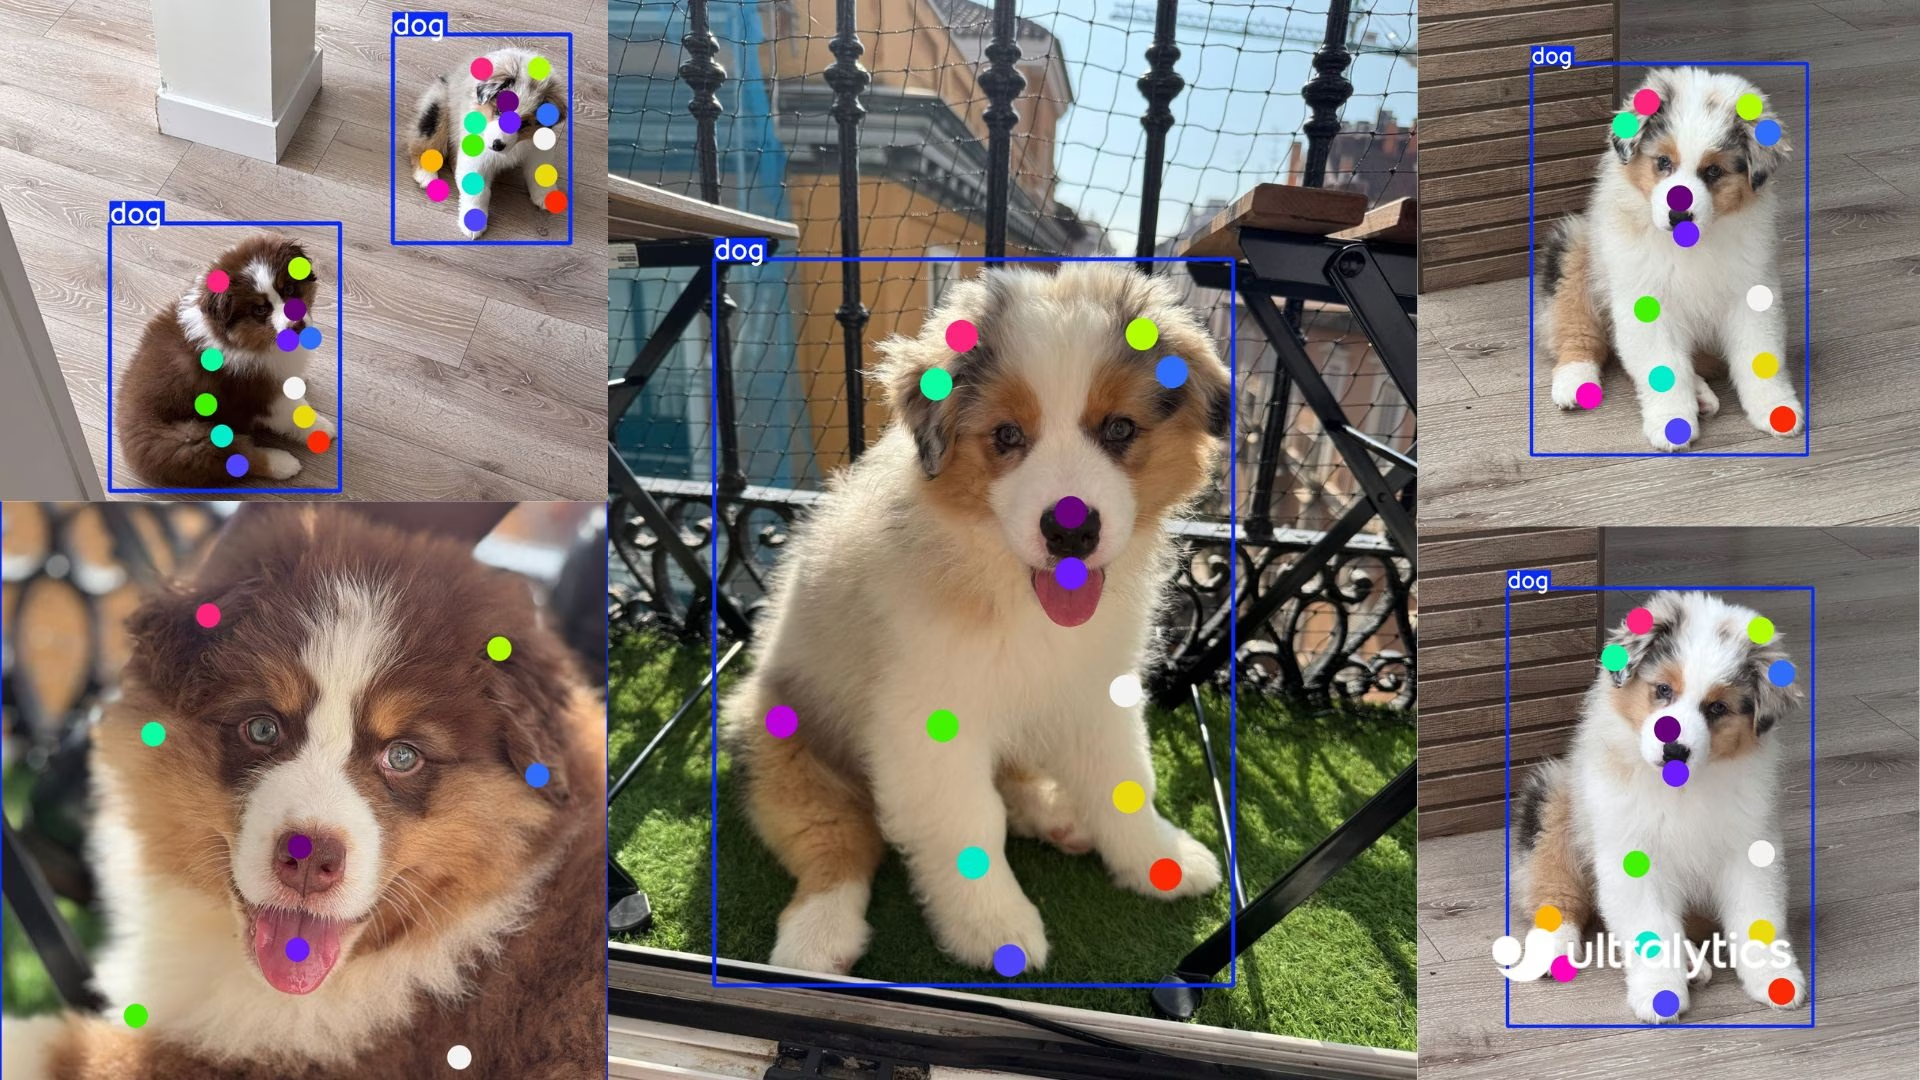
Para trabalhar com uma raça específica ou outro animal, a plataforma Ultralytics permite carregar, rotular e treinar um modelo personalizado de pontos-chave com seus próprios dados, sem precisar gerenciar a infraestrutura.
Estrutura do conjunto de dados#
-
Total de imagens: 8,476 (6,773 train / 1,703 val), com arquivos de rótulo correspondentes no formato YOLO.
-
Pontos-chave: 24 por cão, com trios
(x, y, visibility). -
Tamanho do download: ~337 MB.
-
Estrutura:
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
YAML do conjunto de dados#
Um arquivo YAML é usado para definir a configuração do conjunto de dados. Ele inclui caminhos, detalhes dos pontos-chave e outras informações relevantes. No caso do conjunto de dados Dog-Pose, o arquivo dog-pose.yaml está disponível em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipUso#
Para treinar um modelo YOLO26n-pose no conjunto de dados Dog-Pose por 100 épocas, com tamanho de imagem 640, você pode usar os seguintes trechos de código.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-pose.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
Aqui estão alguns exemplos de imagens do conjunto de dados Dog-Pose, junto com suas anotações correspondentes:
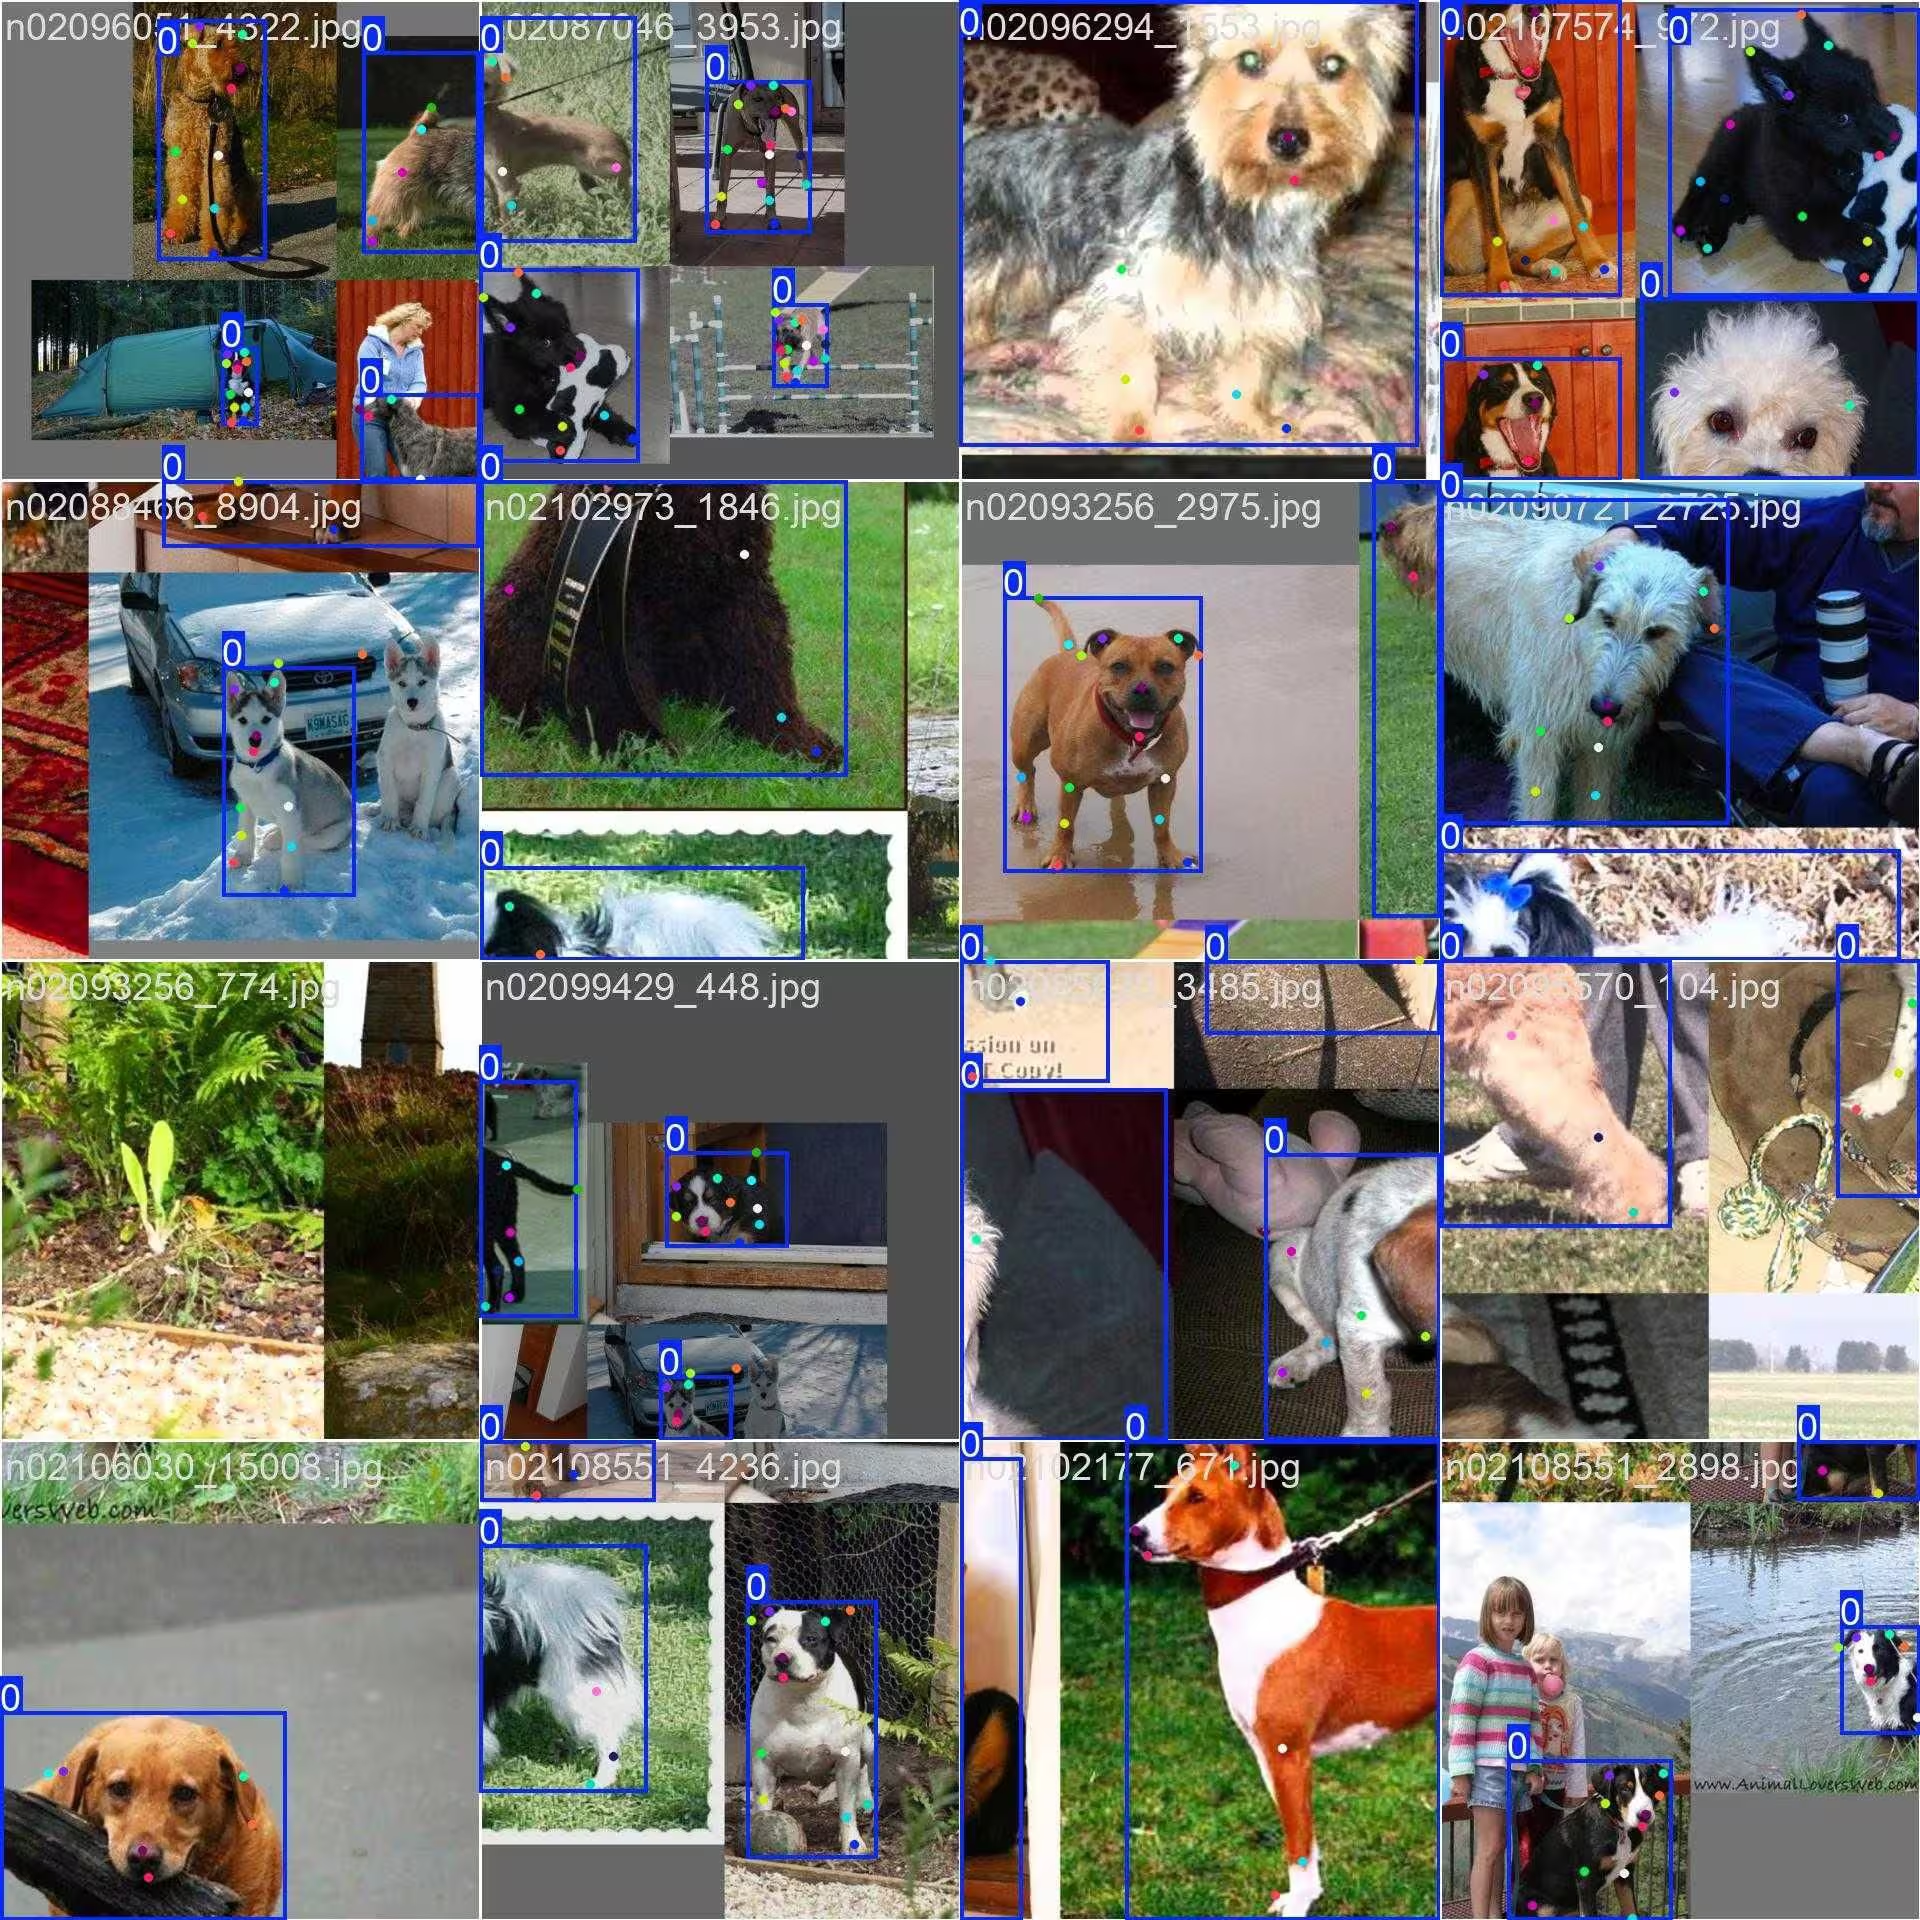
- Imagem em mosaico: esta imagem mostra um lote de treinamento composto por imagens do conjunto de dados organizadas em mosaico. A criação de mosaicos é uma técnica usada durante o treinamento que combina várias imagens numa só para aumentar a variedade de objetos e cenas em cada lote de treinamento. Isso ajuda a melhorar a capacidade do modelo de generalizar para diferentes tamanhos de objetos, proporções e contextos.
O exemplo mostra a variedade e a complexidade das imagens no conjunto de dados Dog-Pose e os benefícios do uso de mosaicos durante o processo de treinamento.
Citações e agradecimentos#
Se você usar o conjunto de dados Dog-Pose em sua pesquisa ou trabalho de desenvolvimento, cite o artigo a seguir:
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
Gostaríamos de agradecer à equipe de Stanford por criar e manter esse valioso recurso para a comunidade de visão computacional. Para saber mais sobre o conjunto de dados Dog-Pose e seus criadores, visite o site do conjunto de dados Stanford Dogs.
Perguntas frequentes#
O conjunto de dados Dog-Pose inclui 6.773 imagens de treino e 1.703 imagens de validação anotadas com 24 pontos-chave para a estimativa de pose de cães. Foi concebido para treinar e validar modelos com o Ultralytics YOLO26, permitindo aplicações como a análise do comportamento animal, a monitorização de animais de estimação e estudos veterinários. As anotações detalhadas tornam-no adequado para desenvolver modelos precisos de estimativa de pose canina.
Carregue
yolo26n-pose.pte chamemodel.train(data="dog-pose.yaml", epochs=100, imgsz=640)— consulte o Exemplo de treinamento acima para ver os trechos completos de Python e CLI, e a página de Treinamento do modelo para obter uma lista abrangente de argumentos.Com 8.476 imagens no total (6.773 para treinamento / 1.703 para validação), abrangendo uma ampla variedade de raças e poses de cães, e 24 pontos-chave em 3 dimensões (x, y, visibilidade) por anotação, o conjunto de dados Dog-Pose oferece aos modelos a cobertura de cenários do mundo real necessária para aplicações como monitoramento de animais de estimação e análise de comportamento.
O uso de mosaicos combina várias imagens Dog-Pose em uma única imagem de treinamento, aumentando a variedade de poses, tamanhos e planos de fundo de cães que o modelo vê a cada etapa. Isso melhora a generalização para novos contextos e escalas e reduz o sobreajuste. Para ver exemplos de imagens, consulte a seção Imagens de amostra e anotações.
O arquivo YAML do conjunto de dados Dog-Pose pode ser encontrado em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. Esse arquivo define a configuração do conjunto de dados, incluindo caminhos, classes, detalhes dos pontos-chave e outras informações relevantes. O YAML especifica 24 pontos-chave com 3 dimensões por ponto-chave, o que o torna adequado para tarefas detalhadas de estimativa de pose.
Para usar este ficheiro com os scripts de treino YOLO26, indica-o no comando de treino conforme mostrado na secção Utilização. O conjunto de dados será transferido automaticamente na primeira utilização, simplificando a configuração.
Para saber mais sobre modelos de pontos-chave, consulte a documentação da tarefa de Estimativa de pose.


Comentários12
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(editado)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(editado)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!