Práticas recomendadas e dicas de aprendizado de máquina para treinar modelos
Introdução#
Uma das etapas mais importantes ao trabalhar em um projeto de visão computacional é o treinamento do modelo. Antes de chegar a esta etapa, você precisa definir seus objetivos e coletar e anotar seus dados. Depois de pré-processar os dados para garantir que estejam limpos e consistentes, você pode começar a treinar seu modelo.
O treinamento de modelos é o processo de ensinar seu modelo a reconhecer padrões visuais e fazer previsões com base nos seus dados, e influencia diretamente a precisão da sua aplicação. Este guia aborda práticas recomendadas, técnicas de otimização e dicas para solucionar problemas, ajudando você a treinar seus modelos de visão computacional com eficiência.
Ver: Dicas de treino de modelos | Como lidar com grandes conjuntos de dados | Tamanho do lote, utilização da GPU e precisão mista
Como treinar um modelo de aprendizado de máquina#
Um modelo de visão computacional é treinado ajustando seus parâmetros internos para minimizar erros. Inicialmente, o modelo recebe um grande conjunto de imagens rotuladas. Ele faz previsões sobre o conteúdo dessas imagens, e as previsões são comparadas com os rótulos ou conteúdos reais para calcular os erros. Esses erros mostram o quanto as previsões do modelo se afastam dos valores verdadeiros.
Durante o treinamento, o modelo faz previsões de forma iterativa, calcula erros e atualiza seus parâmetros por meio de um processo chamado retropropagação. Nesse processo, o modelo ajusta seus parâmetros internos (pesos e vieses) para reduzir os erros. Ao repetir esse ciclo muitas vezes, o modelo melhora gradualmente sua precisão. Com o tempo, ele aprende a reconhecer padrões complexos, como formas, cores e texturas.
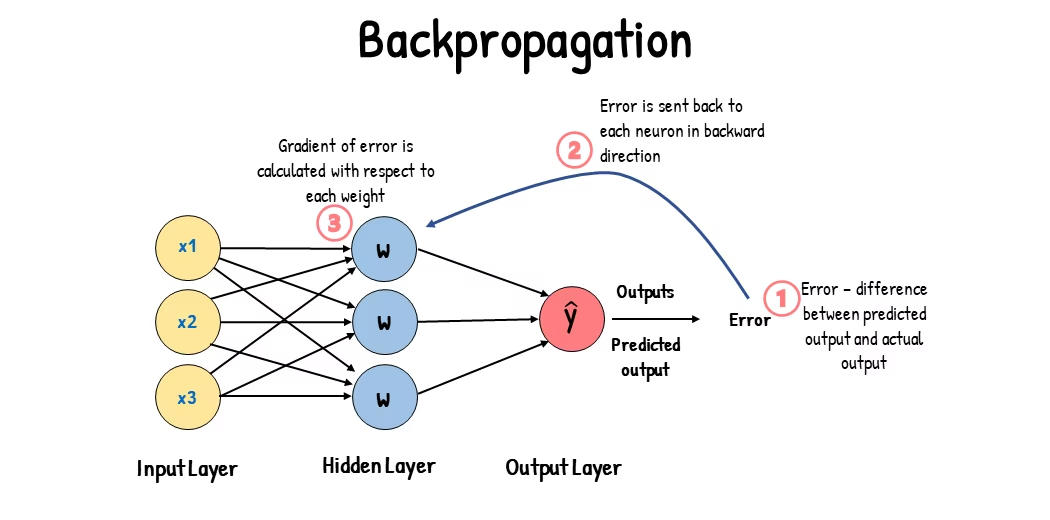
Esse processo de aprendizado permite que o modelo de visão computacional execute várias tarefas, incluindo detecção de objetos, segmentação de instâncias, segmentação semântica e classificação de imagens. O objetivo final é criar um modelo capaz de generalizar o que aprendeu para imagens novas e ainda não vistas, de modo que possa interpretar dados visuais com precisão em aplicações do mundo real.
Agora que sabemos o que acontece nos bastidores quando treinamos um modelo, vamos ver os pontos que devemos considerar ao treinar um modelo.
Treinamento com grandes conjuntos de dados#
Há alguns aspectos diferentes a considerar ao planejar o uso de um conjunto de dados grande para treinar um modelo. Por exemplo, você pode ajustar o tamanho do lote, controlar a utilização da GPU, optar pelo treinamento multiescala etc. Vamos analisar cada uma dessas opções em detalhes.
Tamanho do lote e utilização da GPU#
Ao treinar modelos com grandes conjuntos de dados, é essencial usar a GPU com eficiência. O tamanho do lote é um fator importante. Ele corresponde ao número de amostras de dados que um modelo de aprendizado de máquina processa em uma única iteração de treinamento. Usando o maior tamanho de lote compatível com sua GPU, você pode aproveitar ao máximo os recursos dela e reduzir o tempo de treinamento do modelo. No entanto, é importante evitar ficar sem memória da GPU. Se ocorrerem erros de memória, reduza o tamanho do lote gradualmente até que o modelo treine sem problemas.
Assista: Como acelerar a inferência do Ultralytics YOLO26 em 2× com processamento em lote | Python e GPU | MLOps 🚀
No YOLO26, podes definir o parâmetro batch nos argumentos do modo Train de acordo com a capacidade da tua GPU. Num único acelerador, batch=-1 analisa o perfil do modelo e escolhe um tamanho do lote que visa uma utilização da memória de cerca de 60%; uma fração como batch=0.70 visa uma proporção diferente. As execuções com várias GPUs requerem um tamanho de lote global explícito de, no mínimo, o número de dispositivos. Em CPU e Apple silicon, o AutoBatch emite um aviso e recorre a batch=16.
Treinamento com subconjuntos#
O treino com subconjuntos é uma estratégia prática que consiste em treinar o modelo com um conjunto menor de dados representativo do conjunto de dados maior. Pode poupar tempo e recursos, especialmente durante o desenvolvimento e os testes iniciais do modelo. Se tens pouco tempo ou estás a experimentar diferentes configurações do modelo, o treino com subconjuntos é uma boa opção.
No caso do YOLO26, você pode implementar o treinamento de subconjuntos com o parâmetro fraction. Use uma proporção como fraction=0.1 para 10% dos dados de treinamento, um número inteiro como fraction=300 para exatamente 300 imagens de treinamento ou uma lista de [train, val, test], como fraction=[300, 100, 0], para limitar cada divisão e ignorar as imagens de teste. Listas com dois itens, como [300, 100], mantêm a divisão de teste completa. Os conjuntos de dados NDJSON selecionam registros igualmente espaçados antes de baixá-los, portanto, execuções repetidas reutilizam exatamente o mesmo subconjunto. Os conjuntos de dados de classificação organizados em pastas de imagens também selecionam amostras igualmente espaçadas. Para outros conjuntos de dados organizados em pastas de imagens, fraction seleciona as primeiras N imagens na ordem dos caminhos de imagem, não uma amostra aleatória; portanto, faça a curadoria manual dos subconjuntos quando a ordenação puder excluir fontes ou classes. Ao preparar as divisões de treino e validação, mantenha os grupos de quase duplicatas inteiramente dentro de uma única divisão.
Treinamento multiescala#
O treinamento multiescala é uma técnica que melhora a capacidade de generalização do modelo, treinando-o com imagens de tamanhos variados. Seu modelo pode aprender a detectar objetos em diferentes escalas e distâncias e se tornar mais robusto.
Ao treinar o YOLO26, podes ativar a aumentação de escala definindo o parâmetro scale. Este parâmetro ajusta o tamanho das imagens de treino por um fator especificado, simulando objetos a diferentes distâncias. Por exemplo, definir scale=0.5 aplica aleatoriamente às imagens de treino um zoom com um fator entre 0,5 e 1,5 durante o treino. A configuração deste parâmetro permite que o modelo veja imagens em várias escalas e melhore a sua capacidade de deteção com diferentes tamanhos de objetos e cenários.
A Ultralytics também oferece suporte ao treinamento multiescala com tamanho de imagem por meio do parâmetro multi_scale. Diferentemente de scale, que aplica zoom às imagens e depois adiciona preenchimento ou recorta de volta para imgsz, multi_scale altera o próprio imgsz a cada lote (arredondado para o stride do modelo). Por exemplo, com imgsz=640 e multi_scale=0.25, o tamanho de treinamento é selecionado entre 480 e 800 em intervalos de stride (por exemplo, 480, 512, 544, ..., 800), enquanto multi_scale=0.0 mantém um tamanho fixo.
Armazenamento em cache#
O armazenamento em cache é uma técnica importante para melhorar a eficiência do treinamento de modelos de aprendizado de máquina. Ao armazenar imagens pré-processadas na memória, o cache reduz o tempo que a GPU passa esperando o carregamento de dados do disco. O modelo pode receber dados continuamente, sem atrasos causados por operações de E/S do disco.
O armazenamento em cache durante o treinamento de YOLO26 pode ser controlado pelo parâmetro cache:
cache=True: Armazena as imagens do conjunto de dados na RAM, proporcionando o acesso mais rápido, mas aumentando o uso de memória.cache='disk': Armazena as imagens no disco. É mais lento que a RAM, mas mais rápido do que carregar dados novos a cada vez.cache=False: Desativa o armazenamento em cache e depende totalmente da E/S do disco, sendo a opção mais lenta.
Treinamento com precisão mista#
O treino de precisão mista usa tipos de ponto flutuante de 16 bits (FP16) e 32 bits (FP32): FP16 para cálculos mais rápidos e FP32 para manter a precisão quando necessário. A maioria das operações da rede neural é executada em FP16 para beneficiar de cálculos mais rápidos e de um menor consumo de memória. No entanto, mantém-se uma cópia principal dos pesos do modelo em FP32 para garantir a exatidão durante as atualizações dos pesos. Assim, podes trabalhar com modelos maiores ou tamanhos de lote maiores dentro dos mesmos limites de hardware.
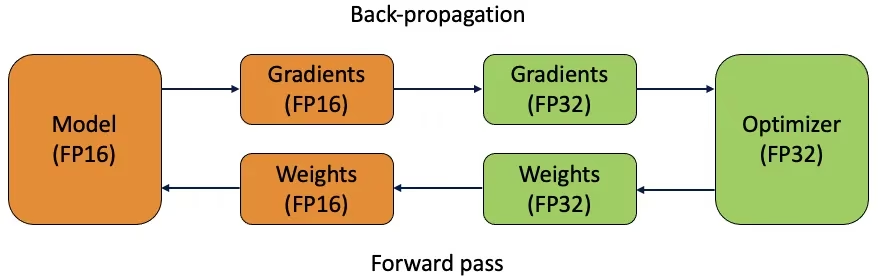
Para implementar o treinamento com precisão mista, você precisa modificar seus scripts de treinamento e garantir que seu hardware (como as GPUs) ofereça suporte a esse recurso. Muitas bibliotecas modernas de aprendizado profundo, como PyTorch e TensorFlow, oferecem suporte integrado à precisão mista.
O treino de precisão mista é simples no YOLO26: o AMP já está ativado por predefinição (amp=True). Numa GPU CUDA, o YOLO verifica as capacidades uma única vez no início do treino e recorre ao FP32 completo se a verificação falhar; em CPU e no silício da Apple, o AMP é ignorado por completo. Define amp=False para forçar o FP32 ou amp="bf16" para treinar em bfloat16 nas GPUs compatíveis.
Pesos pré-treinados#
Usar pesos pré-treinados é uma forma eficaz de acelerar o processo de treino do modelo. Os pesos pré-treinados provêm de modelos já treinados com grandes conjuntos de dados, o que dá ao teu modelo um avanço inicial. A aprendizagem por transferência adapta modelos pré-treinados a tarefas novas e relacionadas. Ajustar um modelo pré-treinado consiste em começar com estes pesos e continuar o treino com o teu conjunto de dados específico. Este método reduz o tempo de treino e, muitas vezes, melhora o desempenho, porque o modelo já tem uma compreensão sólida das características básicas.
Os pesos pré-treinados vêm do argumento model, então model=yolo26n.pt já começa com pesos COCO. O parâmetro pretrained controla se esses pesos são mantidos (True, padrão), descartados (False) ou substituídos por outro ponto de verificação (pretrained=path/to/best.pt). Definir pretrained=True em um modelo *.yaml não baixa os pesos por conta própria. Consulte Como ajustar YOLO a um conjunto de dados personalizado para ver o fluxo de trabalho completo de aprendizado por transferência.
Outras técnicas a considerar ao lidar com um conjunto de dados grande#
Há algumas outras técnicas que você pode considerar ao lidar com um conjunto de dados grande:
- Agendadores da taxa de aprendizado: A implementação de agendadores da taxa de aprendizado ajusta dinamicamente a taxa de aprendizado durante o treinamento. Uma taxa de aprendizado bem ajustada pode impedir que o modelo ultrapasse os mínimos e melhorar a estabilidade. Ao treinar YOLO26, o parâmetro
lrfajuda a gerenciar o agendamento da taxa de aprendizado, definindo a taxa de aprendizado final como uma fração da taxa inicial. Para comportamentos não expostos por nenhum argumento, como taxas de aprendizado por camada ou recorte de gradiente, crie uma subclasse do treinador. - Treino distribuído: Para lidar com grandes conjuntos de dados, o treino distribuído reduz o tempo de treino ao repartir a carga de trabalho por várias GPUs ou máquinas. Esta abordagem é particularmente valiosa para projetos empresariais com recursos computacionais substanciais.
- Formato de memória channels-last: O treinamento com CUDA usa automaticamente o layout de memória NHWC, que é mais rápido, no PyTorch 1.11 e versões posteriores, exceto no Windows, onde as medições indicaram desempenho mais lento. Defina
channels_last=Truepara forçá-lo ouchannels_last=Falsepara manter NCHW; no PyTorch 1.10 e versões anteriores, em CPU e em MPS, NCHW continua sendo o padrão.
Número de épocas de treinamento#
Ao treinar um modelo, uma época corresponde a uma passagem completa por todo o conjunto de dados de treinamento. Durante uma época, o modelo processa cada exemplo do conjunto de treinamento uma vez e atualiza seus parâmetros com base no algoritmo de aprendizado. Em geral, são necessárias várias épocas para que o modelo aprenda e refine seus parâmetros ao longo do tempo.
Uma pergunta comum é como determinar por quantas épocas treinar o modelo. Um bom ponto de partida são 300 épocas. Se o modelo começar a apresentar sobreajuste logo no início, você pode reduzir o número de épocas. Se o sobreajuste não ocorrer após 300 épocas, você pode estender o treinamento para 600, 1200 ou mais épocas.
No entanto, o número ideal de épocas pode variar de acordo com o tamanho do conjunto de dados e os objetivos do projeto. Conjuntos de dados maiores podem exigir mais épocas para que o modelo aprenda de forma eficaz, enquanto conjuntos menores podem precisar de menos épocas para evitar sobreajuste. Com YOLO26, você pode definir o parâmetro epochs no script de treinamento.
Parada antecipada#
A parada antecipada é uma técnica valiosa para otimizar o treinamento do modelo. Monitorando o desempenho da validação, você pode interromper o treinamento quando o modelo parar de melhorar. Assim, é possível economizar recursos computacionais e evitar sobreajuste.
O processo envolve definir um parâmetro de paciência, que determina quantas épocas aguardar por uma melhora nas métricas de validação antes de interromper o treinamento. Se o desempenho do modelo não melhorar durante esse período, o treinamento é interrompido para evitar desperdício de tempo e recursos.
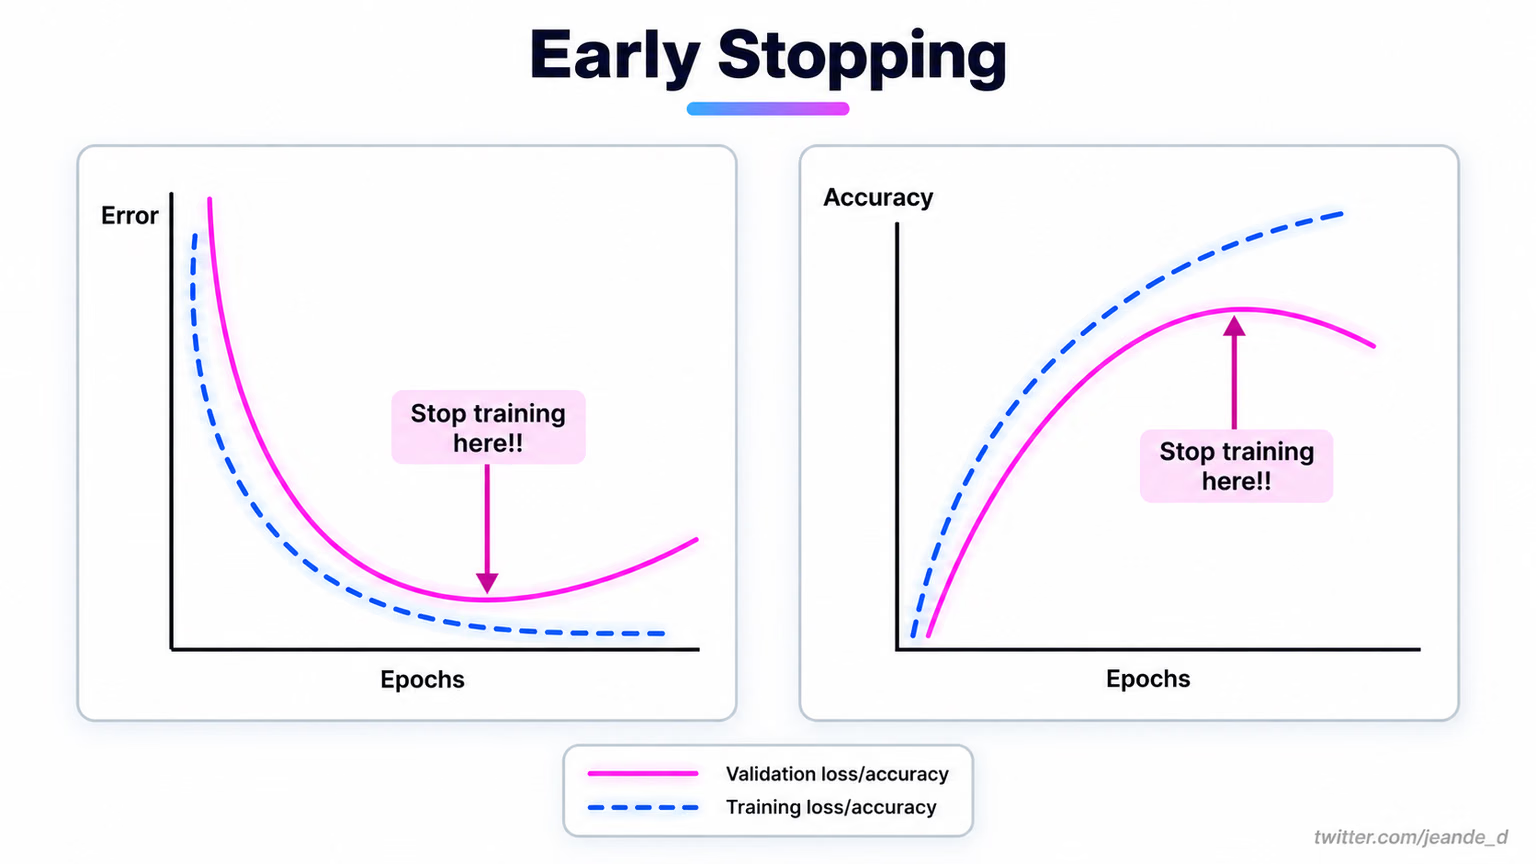
No YOLO26, podes ativar a paragem antecipada definindo o parâmetro patience na configuração do treino. Por exemplo, patience=5 significa que o treino será interrompido se as métricas de validação não melhorarem durante 5 épocas consecutivas. Isto mantém o treino eficiente e evita cálculos desnecessários.
Escolhendo entre treinamento na nuvem e local#
Há duas opções para treinar seu modelo: treinamento na nuvem e treinamento local.
O treino na nuvem oferece escalabilidade e hardware potente, sendo ideal para lidar com grandes conjuntos de dados e modelos complexos. Plataformas como Google Cloud, AWS e Azure dão acesso a pedido a GPUs e TPUs de alto desempenho, acelerando o treino e permitindo experiências com modelos maiores. A Ultralytics Platform também oferece treino gerido na nuvem para modelos YOLO. No entanto, o treino na nuvem pode ser caro, sobretudo durante períodos prolongados, e a transferência de dados pode aumentar os custos e a latência.
O treinamento local oferece mais controle e personalização, permitindo adaptar o ambiente às suas necessidades específicas e evitar custos contínuos com a nuvem. Ele pode ser mais econômico em projetos de longo prazo e, como os dados permanecem nas suas instalações, é mais seguro. No entanto, o hardware local pode ter limitações de recursos e exigir manutenção, o que pode prolongar o treinamento de modelos grandes.
Como selecionar um otimizador#
Um otimizador é um algoritmo que ajusta os pesos da sua rede neural para minimizar a função de perda, que mede o desempenho do modelo. Em termos simples, o otimizador ajuda o modelo a aprender ajustando seus parâmetros para reduzir os erros. Escolher o otimizador certo afeta diretamente a velocidade e a precisão com que o modelo aprende.
Você também pode ajustar os parâmetros do otimizador para melhorar o desempenho do modelo. Ajustar a taxa de aprendizado define o tamanho dos passos ao atualizar os parâmetros. Para obter estabilidade, você pode começar com uma taxa de aprendizado moderada e reduzi-la gradualmente ao longo do tempo para melhorar o aprendizado a longo prazo. Além disso, definir o momentum determina quanta influência as atualizações anteriores têm sobre as atualizações atuais. Um valor comum para o momentum é cerca de 0,9. Em geral, esse valor oferece um bom equilíbrio.
Otimizadores comuns#
Os diferentes otimizadores têm vários pontos fortes e fracos. Eis alguns otimizadores comuns.
-
SGD (Descida do Gradiente Estocástica):
- Atualiza os parâmetros do modelo usando o gradiente da função de perda em relação aos parâmetros.
- É simples e eficiente, mas pode convergir lentamente e ficar preso em mínimos locais.
-
Adam (Estimativa Adaptativa de Momentos):
- Combina as vantagens do SGD com momentum e do RMSProp.
- Ajusta a taxa de aprendizado de cada parâmetro com base em estimativas do primeiro e do segundo momentos dos gradientes.
- É adequado para dados ruidosos e gradientes esparsos.
- É eficiente e, em geral, exige menos ajustes. Para treinamentos mais curtos, o
optimizer=autodo YOLO26 seleciona o AdamW, que é estreitamente relacionado, em vez do próprio Adam.
-
RMSProp (Propagação da Raiz do Quadrado Médio):
- Ajusta a taxa de aprendizado de cada parâmetro dividindo o gradiente por uma média móvel das magnitudes dos gradientes recentes.
- Ajuda a lidar com o problema do desaparecimento do gradiente e é eficaz para redes neurais recorrentes.
-
MuSGD (híbrido Muon + SGD):
- Combina atualizações no estilo SGD com comportamentos inspirados no Muon para melhorar a estabilidade do treinamento em larga escala.
- É uma boa opção quando você quer a capacidade de generalização do SGD, mas precisa de uma convergência mais suave do que a do SGD básico.
- É especialmente relevante para receitas de treinamento do YOLO26; se não tiver certeza, comece com
optimizer=autoe compare com o MuSGD no seu conjunto de dados.
No YOLO26, o parâmetro optimizer permite escolher entre vários otimizadores, incluindo SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam e RMSProp. Também podes defini-lo como auto para selecionar automaticamente um otimizador com base no número de iterações de treino (AdamW para execuções mais curtas e MuSGD acima de 10.000 iterações).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDConecte-se à comunidade#
Fazer parte de uma comunidade de entusiastas de visão computacional pode ajudar você a resolver problemas e aprender mais rápido. Veja algumas formas de se conectar, obter ajuda e compartilhar ideias.
Recursos da comunidade#
- Problemas no GitHub: acesse o repositório do YOLO26 no GitHub e use a aba Issues para fazer perguntas, relatar bugs e sugerir recursos. A comunidade e os mantenedores são muito ativos e estão prontos para ajudar.
- Servidor do Ultralytics no Discord: entre no servidor do Ultralytics no Discord para conversar com outros usuários e desenvolvedores, obter suporte e compartilhar suas experiências.
Usar estes recursos vai ajudar-te a resolver desafios e a manter-te a par das últimas tendências e práticas da comunidade de visão computacional.
Principais conclusões#
Treinar modelos de visão computacional implica seguir boas práticas, otimizar as estratégias e resolver os problemas à medida que surgem. Técnicas como ajustar o tamanho dos lotes, treinar com precisão mista e começar com pesos pré-treinados podem melhorar o desempenho dos modelos e acelerar o treino. Métodos como o treino com subconjuntos e a paragem antecipada ajudam-te a poupar tempo e recursos. Manter o contacto com a comunidade e acompanhar as novas tendências vai ajudar-te a continuar a melhorar as tuas competências de treino de modelos.
Perguntas frequentes#
Para melhorar a utilização da GPU, define o parâmetro
batchcom o tamanho máximo suportado pela tua GPU. Num único acelerador,batch=-1analisa o perfil do modelo e visa uma utilização da memória de cerca de 60%. Em CPU e Apple silicon, recorre abatch=16, enquanto as execuções com várias GPUs requerem um tamanho de lote global explícito de, no mínimo, o número de dispositivos. Para mais informações, consulta os argumentos do modo Train.O treinamento de precisão mista usa tipos de ponto flutuante de 16 bits (FP16) e 32 bits (FP32) para equilibrar velocidade computacional e precisão. No YOLO26, ele é ativado por padrão por meio de
amp=True; definaamp=Falsepara forçar FP32. O AMP é ignorado em CPU e no Apple silicon.O treinamento multiescala melhora o desempenho do modelo usando imagens de vários tamanhos, o que permite que ele generalize melhor para diferentes escalas e distâncias. O YOLO26 oferece dois parâmetros distintos para isso.
scale=0.5seleciona um fator de zoom entre 0,5 e 1,5 e, em seguida, adiciona preenchimento ou recorta a imagem para voltar a umimgszfixo, enquantomulti_scale=0.25varia o próprioimgsza cada lote, em etapas de stride. Para consultar as configurações e saber mais, veja a documentação do modo Train.O uso de pesos pré-treinados pode acelerar bastante o treinamento e melhorar a precisão do modelo, aproveitando um modelo que já conhece características visuais fundamentais. Carregue-os com o argumento
model, como emmodel=yolo26n.pt; em seguida,pretraineddetermina se esses pesos serão mantidos (True, o padrão), descartados (False) ou substituídos por outro checkpoint (pretrained=path/to/best.pt, a forma de transferir pesos para uma compilaçãomodel=*.yaml). Saiba mais na documentação do modo Train.O número de épocas corresponde às passagens completas pelo conjunto de dados de treinamento durante o treinamento do modelo. Um ponto de partida típico são 300 épocas. Se o modelo começar a apresentar sobreajuste cedo, você pode reduzir esse número. Por outro lado, se não houver sobreajuste, você pode estender o treinamento para 600, 1200 ou mais épocas. Para definir esse valor no YOLO26, use o parâmetro
epochsno seu script de treinamento. Para mais recomendações sobre como determinar o número ideal de épocas, consulte esta seção sobre o número de épocas.


Comentários12
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(editado)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.