Набор данных Roboflow 100#
Roboflow 100, спонсируемый Intel, — новаторский бенчмарк для обнаружения объектов. Он включает 100 разнообразных наборов данных. Этот бенчмарк специально создан для проверки адаптивности моделей компьютерного зрения, таких как модели Ultralytics YOLO, в разных областях, включая здравоохранение, аэрофотосъёмку и видеоигры.
Основные особенности#
- Разнообразие областей: включает 100 наборов данных из семи различных областей: аэрофотосъёмка, видеоигры, микроскопия, подводный мир, документы, электромагнитные данные и реальный мир.
- Масштаб: бенчмарк включает 224,714 изображений с 805 классами; на разметку данных ушло более 11,170 часов.
- Стандартизация: все изображения предварительно обработаны и приведены к размеру 640x640 пикселей для единообразной оценки.
- Чистая оценка: бенчмарк помогает устранить неоднозначность классов и отфильтровывает недостаточно представленные классы, чтобы обеспечить более чистую оценку модели.
- Аннотации: включает ограничивающие рамки объектов, подходящие для обучения и оценки моделей обнаружения объектов с помощью таких метрик, как mAP.
Структура набора данных#
Набор данных Roboflow 100 разделён на семь категорий, каждая из которых содержит уникальную подборку наборов данных, изображений и классов:
- Аэрофотосъёмка: 7 наборов данных, 9,683 изображения, 24 класса.
- Видеоигры: 7 наборов данных, 11,579 изображений, 88 классов.
- Микроскопия: 11 наборов данных, 13,378 изображений, 28 классов.
- Подводный мир: 5 наборов данных, 18,003 изображения, 39 классов.
- Документы: 8 наборов данных, 24,813 изображения, 90 классов.
- Электромагнитные данные: 12 наборов данных, 36,381 изображение, 41 класс.
- Реальный мир: 50 наборов данных, 110,615 изображений, 495 классов.
Такая структура предоставляет разнообразную и обширную среду для тестирования моделей обнаружения объектов, отражая множество реальных сценариев применения, встречающихся в различных решениях Ultralytics.
Бенчмаркинг#
Бенчмаркинг набора данных — это оценка производительности моделей машинного обучения на конкретных наборах данных с использованием стандартизированных метрик. К распространённым метрикам относятся точность, средняя точность (mAP) и F1-мера. Подробнее о них читай в нашем руководстве по метрикам производительности YOLO.
Все результаты сохраняются в одном каталоге runs/<task>/multitrain/: для каждого набора данных выполняется дообучение в отдельном подкаталоге (со своим results.png), а метрики для каждого набора данных и усреднённые метрики записываются в multitrain_results.json вместе со столбчатой диаграммой multitrain_results.png. Вызов model.train() также возвращает словарь {dataset: metrics} для программного доступа.
Приведённый ниже скрипт загружает с Roboflow наборы данных Roboflow 100, перечисленные в datasets_links.txt, а затем дообучает одну базовую модель (например, YOLO26n) на всей коллекции за один вызов model.train(). Если передать список наборов данных, базовая модель последовательно дообучается на каждом из них, а результаты по всем наборам визуализируются автоматически.
import re
from pathlib import Path

from roboflow import Roboflow

from ultralytics import YOLO
from ultralytics.utils import ASSETS_URL, LOGGER, YAML
from ultralytics.utils.downloads import safe_download

# Download the RF100 datasets (requires a Roboflow API key)
rf = Roboflow(api_key="YOUR_ROBOFLOW_API_KEY")
safe_download(f"{ASSETS_URL}/datasets_links.txt")  # list of RF100 dataset links

datasets = []
for line in Path("datasets_links.txt").read_text().splitlines():
    try:
        _, _url, workspace, project, version = re.split("/+", line.strip())
        location = f"rf-100/{project}-{version}"
        rf.workspace(workspace).project(project).version(version).download("yolov8", location=location)
        yaml = Path(location) / "data.yaml"
        cfg = YAML.load(yaml)  # point train/val at the downloaded image folders
        cfg["train"], cfg["val"] = "train/images", "valid/images"
        YAML.save(yaml, cfg)
        datasets.append(str(yaml))
    except Exception as e:
        LOGGER.warning(f"Failed to prepare dataset from {line!r}: {e}")

# Fine-tune one base model across all RF100 datasets and visualize the cross-dataset results
model = YOLO("yolo26n.pt")
results = model.train(data=datasets, epochs=100, imgsz=640)  # {dataset: metrics}

# Per-dataset runs, multitrain_results.json (per-dataset + mean), and multitrain_results.png are saved
# together under runs/detect/multitrain. Read results in-memory or from the JSON for custom post-processing.
for dataset, metrics in results.items():
    if metrics:  # None if that dataset failed to train
print(f"{dataset}: mAP50-95 = {metrics['metrics/mAP50-95(B)']:.4f}")Применение#
Roboflow 100 незаменим для различных задач в области компьютерного зрения и глубокого обучения. Исследователи и инженеры могут использовать этот бенчмарк, чтобы:
- Оценивать производительность моделей обнаружения объектов в условиях нескольких предметных областей.
- Проверять адаптивность и устойчивость моделей в реальных сценариях, выходящих за рамки распространённых бенчмарков, таких как COCO или PASCAL VOC.
- Сравнивать возможности моделей обнаружения объектов на разнообразных наборах данных, включая специализированные области, например здравоохранение, аэрофотосъёмку и видеоигры.
- Сравнивать производительность моделей на разных архитектурах нейронных сетей и с разными методами оптимизации.
- Выявлять специфичные для предметной области задачи, для которых могут потребоваться специальные советы по обучению моделей или подходы к дообучению, например трансферное обучение.
Ищи идеи и вдохновение для практического применения в наших руководствах по практическим проектам или используй Ultralytics Platform для упрощения обучения моделей и их развёртывания.
Использование#
Набор данных Roboflow 100, включая метаданные и ссылки для скачивания, доступен в официальном репозитории Roboflow 100 на GitHub. Ты можешь получить доступ к набору данных и использовать его прямо оттуда для своих задач бенчмаркинга. После загрузки и подготовки наборов данных, как показано выше, модели Ultralytics можно дообучить на всей коллекции одним вызовом model.train(), передав список YAML-файлов наборов данных.
Примеры данных и аннотаций#
В Roboflow 100 собраны наборы данных с разнообразными изображениями, снятыми под разными углами и в разных предметных областях. Ниже приведены примеры аннотированных изображений из бенчмарка RF100, демонстрирующие разнообразие объектов и сцен. Такие методы, как аугментация данных, позволяют ещё больше повысить разнообразие данных при обучении.
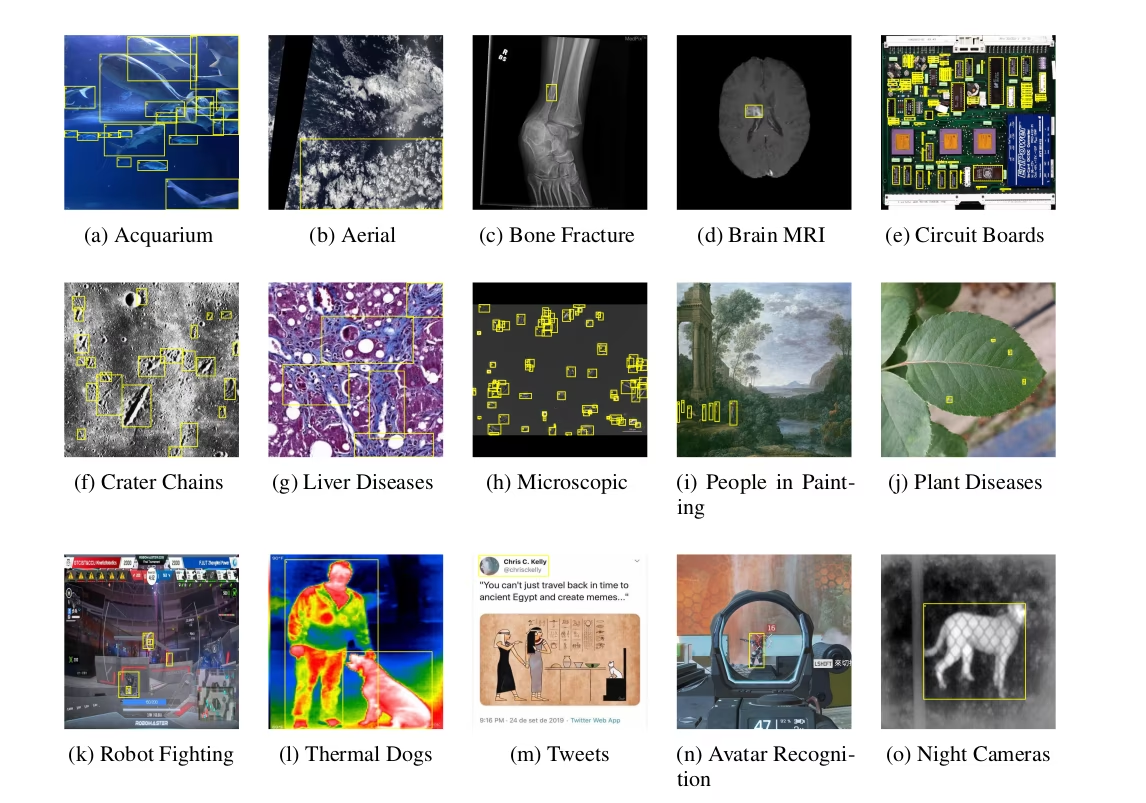
Разнообразие бенчмарка Roboflow 100 — значительный шаг вперёд по сравнению с традиционными бенчмарками, которые часто сосредоточены на оптимизации одной метрики в ограниченной предметной области. Такой комплексный подход помогает создавать более устойчивые и универсальные модели компьютерного зрения, способные хорошо работать во множестве различных сценариев.
Цитирование и благодарности#
Если ты используешь набор данных Roboflow 100 в исследовательской или практической работе, процитируй оригинальную статью:
@misc{rf100benchmark,
    Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz},
    Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark},
    Year = {2022},
    Eprint = {arXiv:2211.13523},
    url = {https://arxiv.org/abs/2211.13523}
}
Мы благодарим команду Roboflow и всех участников за значительный вклад в создание и поддержку набора данных Roboflow 100 — ценного ресурса для сообщества компьютерного зрения.
Если ты ищешь другие наборы данных для проектов по обнаружению объектов и машинному обучению, загляни в нашу обширную коллекцию наборов данных, где представлены и другие наборы данных для обнаружения объектов.
Часто задаваемые вопросы#
Набор данных Roboflow 100 — это бенчмарк для моделей обнаружения объектов. Он включает 100 разнообразных наборов данных из таких областей, как здравоохранение, аэрофотосъёмка и видеоигры. Его ценность в том, что он позволяет стандартизированно проверять адаптивность и устойчивость моделей в широком спектре реальных сценариев, выходя за рамки традиционных бенчмарков, часто ограниченных одной предметной областью.
Набор данных Roboflow 100 охватывает семь разнообразных областей, создающих уникальные задачи для моделей обнаружения объектов:
- Аэрофотосъёмка: 7 наборов данных (например, спутниковые снимки, виды с дронов).
- Видеоигры: 7 наборов данных (например, объекты из разных игровых миров).
- Микроскопия: 11 наборов данных (например, клетки, частицы).
- Подводный мир: 5 наборов данных (например, морские организмы, подводные объекты).
- Документы: 8 наборов данных (например, текстовые области, элементы форм).
- Электромагнитные данные: 12 наборов данных (например, радиолокационные сигнатуры, визуализация спектральных данных).
- Реальный мир: 50 наборов данных (широкая категория, включающая повседневные предметы, сцены, розничную торговлю и т. д.).
Такое разнообразие делает RF100 отличным ресурсом для оценки обобщающей способности моделей компьютерного зрения.
При использовании набора данных Roboflow 100 процитируй оригинальную статью, чтобы указать авторов. Рекомендуемая ссылка в формате BibTeX:
Цитата@misc{rf100benchmark, Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz}, Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark}, Year = {2022}, Eprint = {arXiv:2211.13523}, url = {https://arxiv.org/abs/2211.13523} }Чтобы узнать больше, загляни в нашу обширную коллекцию наборов данных или посмотри другие наборы данных для обнаружения объектов, совместимые с моделями Ultralytics.