Набор данных COCO-Seg
Набор данных COCO-Seg содержит маски сегментации экземпляров COCO (Common Objects in Context) — 118,287 обучающих и 5,000 валидационных изображений с масками-полигонами для 80 категорий объектов — в формате меток Ultralytics YOLO. В нем используются оригинальные изображения COCO и исходные аннотации сегментации, преобразованные для обучения YOLO. Это стандартный ресурс для исследователей и разработчиков, работающих над задачами сегментации экземпляров.
Предварительно обученные модели COCO-Seg#
| Модель | размер (пиксели) | mAPbox50-95 (e2e) | mAPmask50-95 (e2e) | Скорость CPU ONNX (мс) | Скорость T4 TensorRT10 (мс) | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-seg | 640 | 39.6 | 33.9 | 53.3 ± 0.5 | 2.1 ± 0.0 | 2.7 | 9.3 |
| YOLO26s-seg | 640 | 47.3 | 40.0 | 118.4 ± 0.9 | 3.3 ± 0.0 | 10.4 | 34.5 |
| YOLO26m-seg | 640 | 52.5 | 44.1 | 328.2 ± 2.4 | 6.7 ± 0.1 | 23.6 | 121.7 |
| YOLO26l-seg | 640 | 54.4 | 45.5 | 387.0 ± 3.7 | 8.0 ± 0.1 | 28.0 | 140.1 |
| YOLO26x-seg | 640 | 56.5 | 47.0 | 787.0 ± 6.8 | 16.4 ± 0.1 | 62.8 | 314.0 |
Основные особенности#
- COCO-Seg содержит маски сегментации экземпляров для 123 287 размеченных изображений COCO train2017/val2017 (118 287 для обучения + 5 000 для валидации) из более масштабного выпуска COCO объемом ~330 тыс. изображений.
- Набор данных включает те же 80 категорий объектов, что и исходный набор данных COCO.
- Аннотации содержат маски сегментации экземпляров в формате полигональных меток YOLO.
- COCO-Seg предоставляет стандартизированные метрики mAP и mAR для оценки качества сегментации экземпляров, позволяя эффективно сравнивать модели.
- Размер загрузки: ~20,3 ГБ при первом использовании (
train2017.zip+val2017.zip+ метки). Файлtest2017.zipразмером 7 ГБ не загружается автоматически, поскольку для этих изображений скрыты эталонные разметки и они нужны только для отправки результатов test-dev2017.
Структура набора данных#
Датасет COCO-Seg разделён на три подмножества:
- Train2017: 118 287 изображений для обучения моделей сегментации экземпляров.
- Val2017: 5 000 изображений для валидации при разработке модели.
- Test-dev2017: 20 288 из 40 670 изображений test2017 для тестирования и сравнения моделей. Эталонные аннотации для этого подмножества недоступны публично, поэтому для оценки качества предсказания нужно отправить на сервер оценки COCO.
Для небольших экспериментов смотри подмножества COCO128-Seg (128 изображений) и COCO8-Seg (8 изображений).
Применение#
COCO-Seg широко используется для обучения и оценки моделей глубокого обучения в задачах сегментации экземпляров, например для моделей YOLO. Большое число размеченных изображений, разнообразие категорий объектов и стандартизированные метрики оценки делают этот набор данных стандартным ресурсом для исследователей и специалистов в области компьютерного зрения. Полные аннотации COCO-Seg также можно просматривать и обрабатывать на платформе Ultralytics.
Файл YAML набора данных#
Для описания конфигурации датасета используется YAML-файл. В нём указаны пути к данным, классы и другая необходимая информация. Для датасета COCO-Seg файл coco.yaml размещён по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Использование#
Чтобы обучить модель YOLO26n-seg на датасете COCO-Seg в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-seg.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Примеры изображений и аннотаций#
В COCO-Seg представлены такие же разнообразные изображения, категории объектов и сложные сцены, как и в COCO, а маски сегментации экземпляров сохранены в формате меток YOLO. Ниже приведены примеры изображений из датасета и соответствующие им маски сегментации экземпляров:
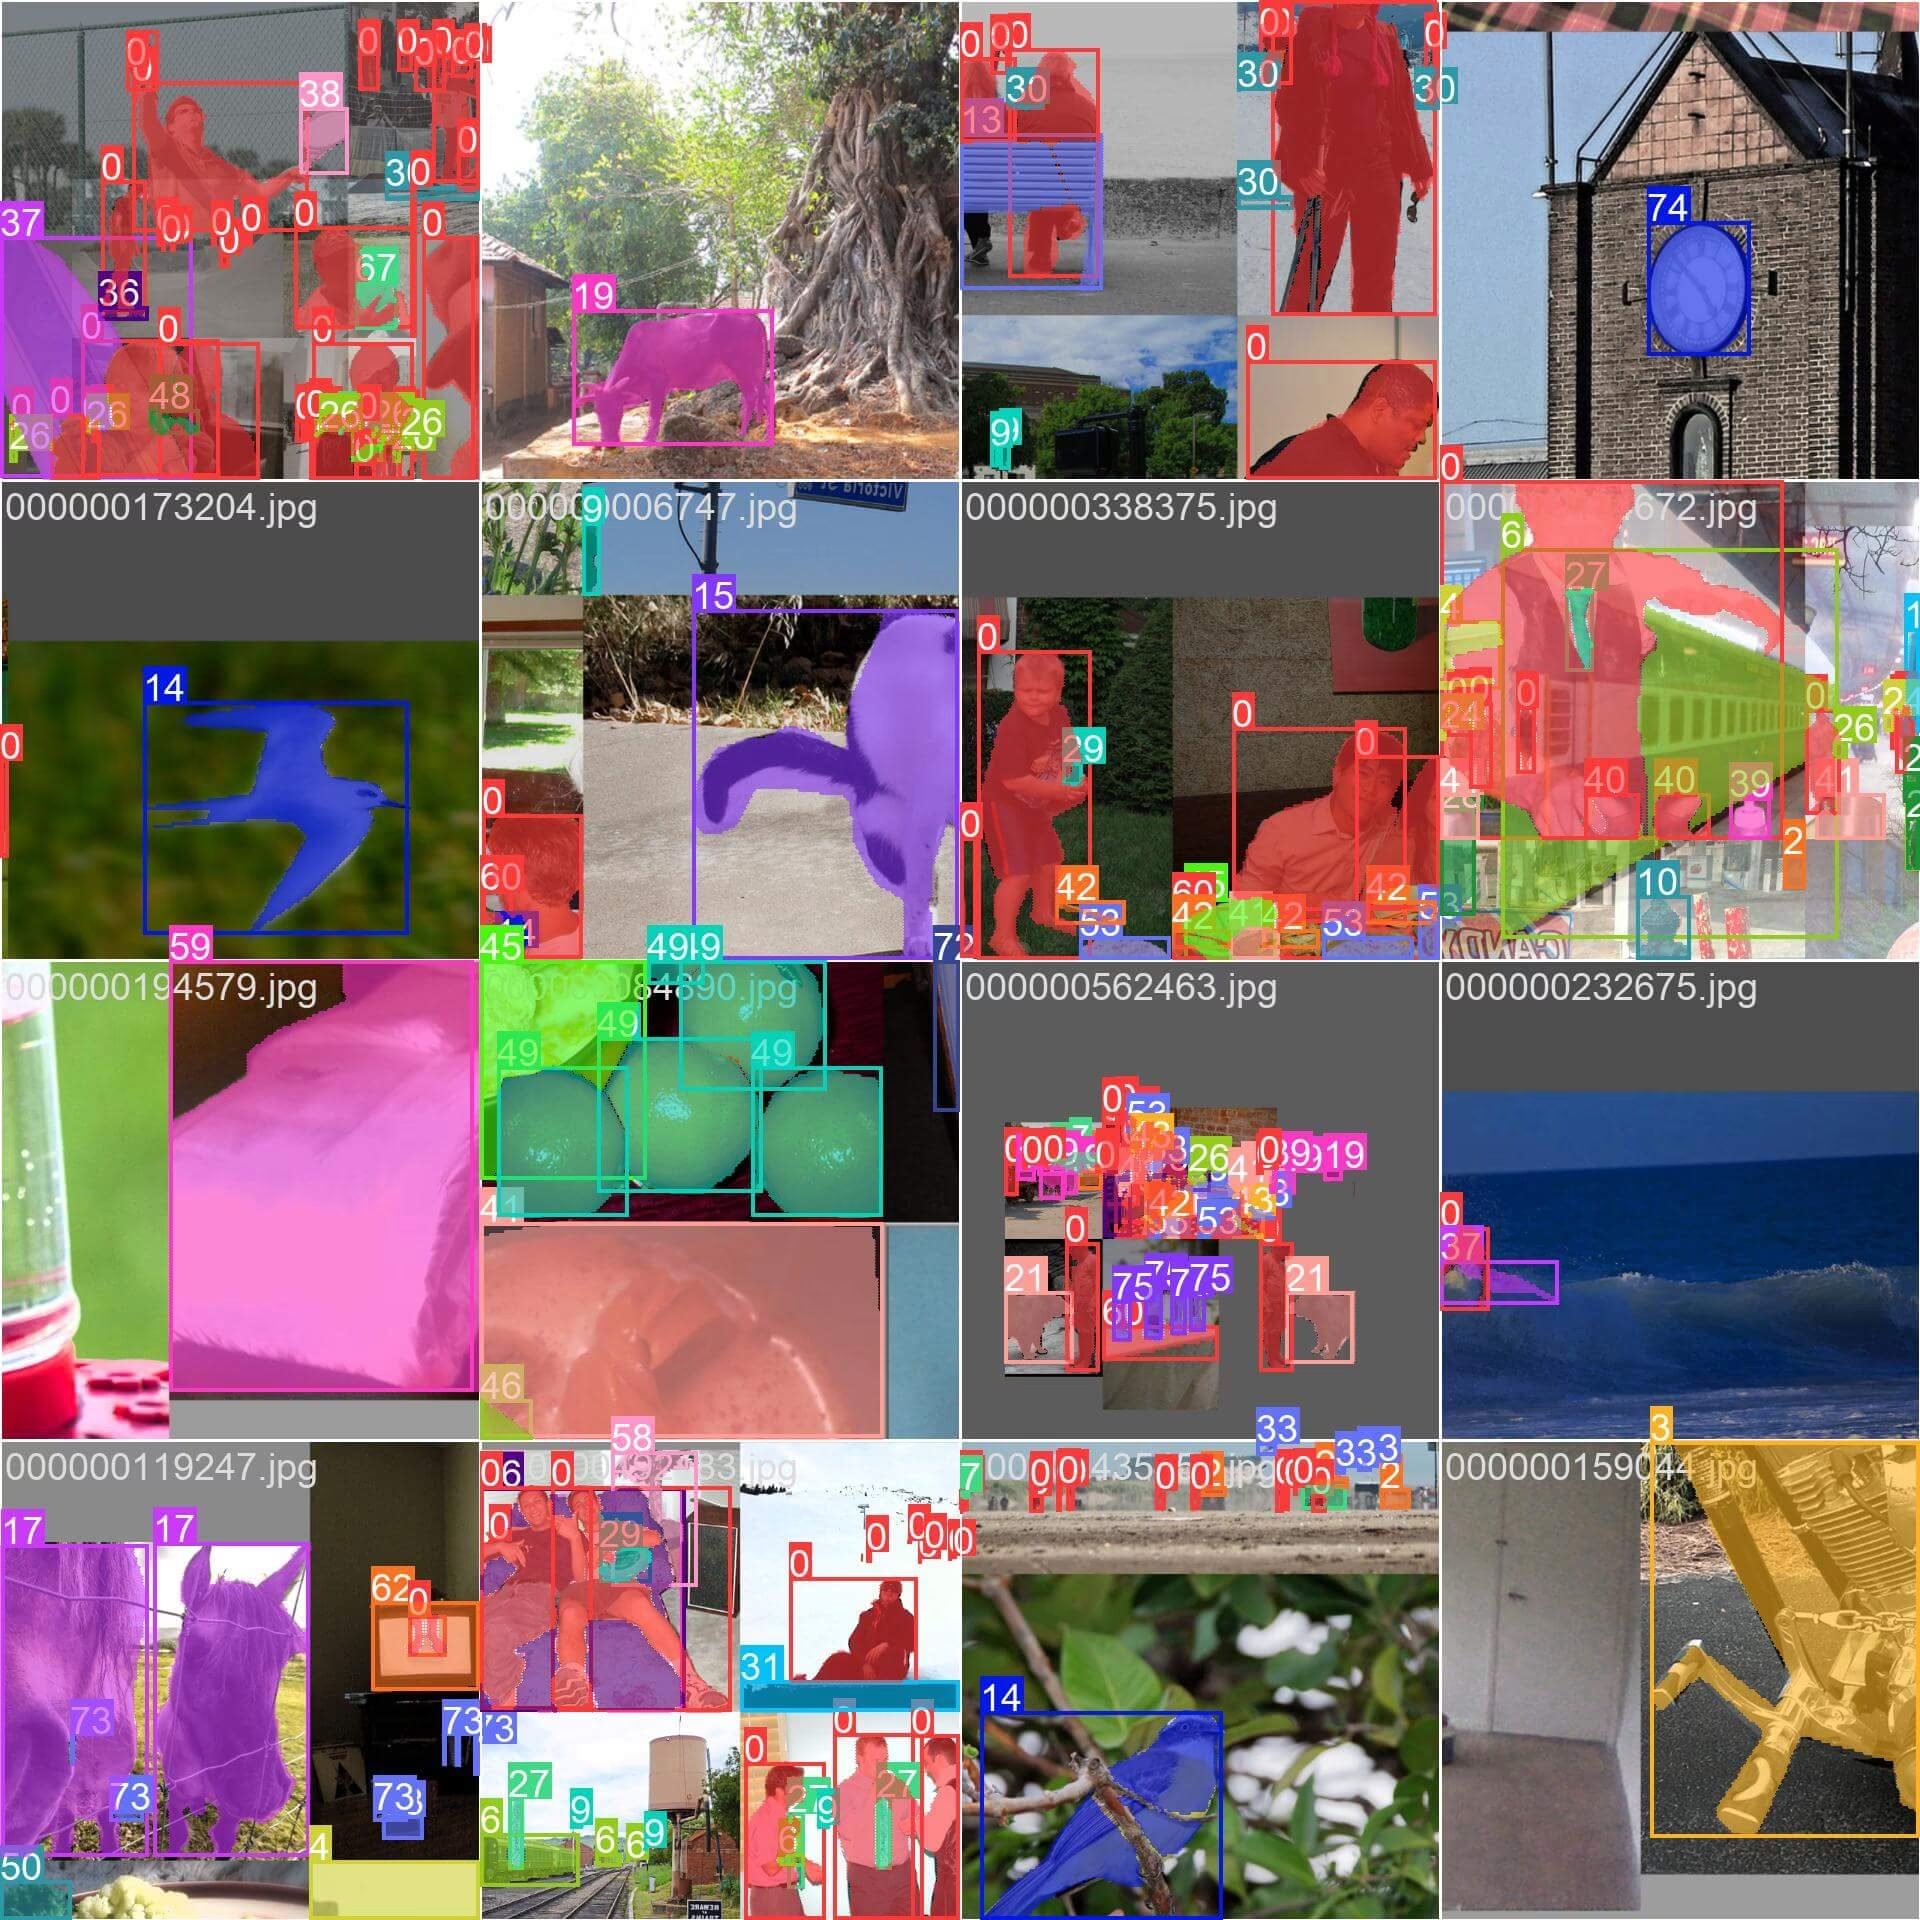
- Изображение-мозаика: на этом изображении показан обучающий батч, составленный из изображений датасета, объединённых в мозаику. Мозаика — это метод, используемый при обучении: несколько изображений объединяются в одно, чтобы увеличить разнообразие объектов и сцен в каждом обучающем батче. Это помогает модели обобщать данные для объектов разных размеров, соотношений сторон и контекстов.
Цитирование и благодарности#
Если ты используешь датасет COCO-Seg в исследованиях или разработке, укажи в цитировании оригинальную статью о COCO и отметь расширение COCO-Seg:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Мы выражаем благодарность консорциуму COCO за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения.
Часто задаваемые вопросы#
COCO-Seg — это упаковка исходных масок сегментации экземпляров COCO (Common Objects in Context) в формате Ultralytics YOLO для тех же 118,287 изображений train2017 и 5,000 изображений val2017. Исходные аннотации COCO уже содержат эти маски-полигоны для всех 80 категорий объектов; COCO-Seg преобразует их в формат меток YOLO, используемый для обучения сегментации экземпляров объектов.
Чтобы обучить модель YOLO26n-seg на датасете COCO-Seg в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода. Подробный список доступных аргументов обучения смотри на странице модели Обучение.
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-seg.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="coco.yaml", epochs=100, imgsz=640)Датасет COCO-Seg обладает несколькими ключевыми особенностями:
- Содержит маски сегментации экземпляров для 123 287 размеченных изображений COCO train2017/val2017 (118 287 train + 5 000 val).
- Содержит аннотации тех же 80 категорий объектов, что и исходный COCO.
- Маски сегментации экземпляров представлены в формате полигональных меток YOLO.
- Для задач сегментации экземпляров используются стандартизированные метрики оценки, такие как средняя точность (mAP) и средняя полнота (mAR).
Датасет COCO-Seg поддерживает несколько предварительно обученных моделей сегментации YOLO26 с разными показателями производительности. Ниже приведены доступные модели и их ключевые метрики:
Модель размер
(пиксели)mAPbox50-95
(e2e)mAPmask50-95
(e2e)Скорость
CPU ONNX
(мс)Скорость
T4 TensorRT10
(мс)параметры
(M)FLOPs
(B)YOLO26n-seg 640 39.6 33.9 53.3 ± 0.5 2.1 ± 0.0 2.7 9.3 YOLO26s-seg 640 47.3 40.0 118.4 ± 0.9 3.3 ± 0.0 10.4 34.5 YOLO26m-seg 640 52.5 44.1 328.2 ± 2.4 6.7 ± 0.1 23.6 121.7 YOLO26l-seg 640 54.4 45.5 387.0 ± 3.7 8.0 ± 0.1 28.0 140.1 YOLO26x-seg 640 56.5 47.0 787.0 ± 6.8 16.4 ± 0.1 62.8 314.0 В линейке есть модели от компактной YOLO26n-seg до более точной YOLO26x-seg. Они предлагают разные компромиссы между скоростью и точностью для различных требований приложений.
Датасет COCO-Seg разделён на три подмножества для решения конкретных задач обучения и оценки:
- Train2017: содержит 118 287 изображений, предназначенных преимущественно для обучения моделей сегментации экземпляров.
- Val2017: содержит 5,000 изображений, используемых для валидации в процессе обучения.
- Test-dev2017: содержит 20,288 из 40,670 тестовых изображений test2017, зарезервированных для тестирования и сравнения обученных моделей. Обрати внимание: эталонные аннотации для этой подвыборки недоступны публично, а результаты оценки отправляются на сервер оценки COCO.
Для небольших экспериментов можно также использовать датасет COCO128-Seg (128 изображений) или COCO8-Seg — компактную версию, содержащую всего 8 изображений из набора COCO train 2017.


Комментарии10
Задай вопрос, поделись результатами или помоги кому-нибудь.
liujieKermit
what the label format if I want to train my custom dataset, please give the solution step by step like label, train, val, export, predict
 Glenn JocherUltralytics(изменено)
@liujieKermit for custom segmentation training with YOLO26, follow these steps:
-
Label Format: Use YOLO segmentation format - one text file per image with class index and normalized polygon coordinates (minimum 3 points per object). Example:
<class> <x1> <y1> <x2> <y2> ... <xn> <yn> -
Dataset YAML: Create a YAML file (example
data.yaml):
path: /path/to/dataset train: images/train val: images/val names: 0: class1 1: class2- Train:
from ultralytics import YOLO model = YOLO('yolo26n-seg.pt') model.train(data='data.yaml', epochs=100, imgsz=640)- Export/Predict:
model.export(format='onnx')  # export
model.predict('image.jpg')  # predict
For full details see our Dataset Format Guide and Auto-Annotation Tools. For commercial use, review our license terms.
-
YingdiZhang
Thanks for the great work. I am new to YOLO and AI. How to download the COCO dataset? is just running python coco.yaml?
- Glenn JocherUltralytics(изменено)
@YingdiZhang to download the COCO dataset, you can run
yolo segment train data=coco.yamlin your terminal. This will automatically download the dataset for you. For more details, you can visit the Ultralytics documentation.
SacherTorte280
Dear developpers, I need to build a much simpler case where I'll only need <=5 labels, can I remove the others that i'll never use ?
 Paula DerrengerUltralytics(изменено)
@SacherTorte280 yes, you can customize the dataset to include only the labels you need. To do this, modify the
coco.yamlfile to include only the desired classes in thenamessection and adjust the dataset paths accordingly. Also make sure the class indices in your label files are remapped to match the newnames(0 to N-1) and remove labels of the dropped classes. This will allow you to train your model with a simplified set of labels. For more details on configuring the dataset, please refer to the COCO-Seg documentation.
MoAbbasid
i get a list out of index error when running convert_coco function please help
- Paula DerrengerUltralytics
Hi there! It looks like you're encountering a
list index out of rangeerror with theconvert_cocofunction. This can often happen if the script is trying to access an element that doesn't exist in a list. To help you resolve this issue, please ensure that:- The data paths in your
coco.yamlconfig file are correctly set and point to valid files. - The COCO dataset is correctly downloaded and structured as expected by the script.
If the paths and dataset structure are correct, it might be helpful to check if the specific segment of data causing the error is formatted correctly or missing elements.
Here's a quick check you can perform:
try:
    # Assuming convert_coco is called here
    convert_coco()
except IndexError as e:
    print("An index error occurred: ", e)
    # You can add more debugging information here to understand which part of the data is causing the problem
This snippet will catch the
IndexErrorand print it, potentially providing more insight on what's going wrong. If you need further assistance, please don't hesitate to share a snippet of the data or more details on the error! - The data paths in your
mohamed-ladjal
Greetings, I possess medical imagery depicting bone lesions. These images comprise 3D volumes of dimensions (256, 256, 128), with each volume containing 128 slices. Corresponding masks of identical dimensions are available. My objective is to either fine-tune or train a model using these slices to accurately segment the lesions mohamed mohamed.laadjel2019@gmail.com
- Glenn JocherUltralytics(изменено)
Hello Mohamed,
Great to hear about your project on segmenting bone lesions from medical imagery! For your 3D volumes, you can approach this by treating each slice as a separate 2D image for segmentation.
Given your setup, you might consider using our YOLO26-seg models, which are well-suited for segmentation tasks. Here’s a basic example of how you could set up your training with YOLO26:
from ultralytics import YOLO

# Load a pretrained segmentation model
model = YOLO('yolo26n-seg.pt')  # Choose the appropriate model size

# Prepare your dataset in a compatible format
# Ensure your dataset directory structure and annotations are correctly set up

# Train the model
results = model.train(data='your_dataset_config.yaml', epochs=100, imgsz=640)
Make sure your dataset is annotated similarly to how COCO-Seg annotations are structured, with masks corresponding to each slice. You might need to adjust the
your_dataset_config.yamlto correctly point to your training, validation, and test images along with their annotations.For more detailed guidance on preparing your dataset and annotations, you can refer to our documentation on COCO-Seg Dataset.
If you have any more questions or need further assistance, feel free to ask. Happy training! 🚀