Методы предварительной обработки размеченных данных для компьютерного зрения#
Предварительная обработка данных преобразует исходные размеченные изображения в чистые и согласованные входные данные, необходимые модели компьютерного зрения для эффективного обучения. В Ultralytics YOLO26 основные операции с пикселями — преобразование в RGB, масштабирование до [0, 1] и изменение размера — автоматически выполняются в конвейере обучения, поэтому остаётся правильно разделить датасет, сбалансировать классы и выбрать аугментации. В этом руководстве рассматриваются основные методы: изменение размера, нормализация, разделение датасета, аугментация данных и разведочный анализ данных (EDA).
Смотри: Как повысить точность модели в реальных сценариях с помощью предварительной обработки и аугментации данных 🚀
Этот этап следует за тем, как ты определил цели проекта и собрал и разметил данные, и находится в начале рабочего процесса проекта компьютерного зрения.
Почему предварительная обработка важна#
Предварительная обработка приводит данные к формату, который снижает вычислительную нагрузку и повышает качество модели. Она помогает устранить три распространённые проблемы исходных данных:
- Шум: Нерелевантные или случайные отклонения в данных.
- Несогласованность: Различия в размерах, форматах и качестве изображений.
- Дисбаланс: Неравномерное распределение классов или категорий в датасете.
Методы предварительной обработки#
Основные методы — изменение размера, нормализация, разделение датасета и аугментация. В YOLO26 первые два выполняются автоматически, а наиболее важны твои решения о разделении данных и аугментации.
Изменение размера изображений#
Многим моделям требуется единый размер входных данных, поэтому изменение размера приводит изображения к одному формату и снижает вычислительную сложность. Два распространённых метода интерполяции:
- Билинейная интерполяция: Сглаживает значения пикселей, вычисляя взвешенное среднее для четырёх ближайших пикселей.
- Интерполяция методом ближайшего соседа: Копирует значение ближайшего пикселя без усреднения. Этот метод быстрее, но изображение получается более пиксельным.
Такие библиотеки, как OpenCV и PIL (Pillow), предоставляют эти функции, но для YOLO26 обычно не нужно менять размер изображений вручную. Это делает аргумент imgsz. При обработке изображений по фиксированному квадратному шаблону валидация и инференс приводят их к входному размеру imgsz × imgsz, например 640 × 640, сохраняя соотношение сторон и добавляя серые поля (значение 114). Большие изображения уменьшаются, а маленькие не увеличиваются, если увеличение отключено. При стандартном режиме обучения вместо этого mosaic=1.0 размещает четыре изображения на увеличенном холсте и обрезает его до imgsz. Когда для последних эпох параметр close_mosaic отключает мозаику, изображения приводятся к нужному размеру с помощью полей, а затем всё равно случайным образом преобразуются, а не передаются без изменений. Для прямоугольных пакетов (rect=True) и multi_scale используются другие формы входных данных.
Нормализация значений пикселей#
Нормализация приводит значения пикселей к стандартному диапазону, помогая модели быстрее сходиться во время обучения. Два распространённых метода:
- Масштабирование min-max: Приводит значения пикселей к диапазону от 0 до 1.
- Нормализация по z-оценке: Масштабирует значения пикселей с учётом среднего значения и стандартного отклонения.
YOLO26 автоматически выполняет нормализацию в рамках конвейера предварительной обработки: преобразует изображения в RGB и масштабирует значения пикселей до диапазона [0, 1], разделив их на 255 (масштабирование min-max). По умолчанию YOLO не применяет нормализацию по среднему значению и стандартному отклонению, как в ImageNet (z-оценку), поэтому вручную нормализовать данные не нужно.
Разделение датасета#
Разделение данных на обучающую, валидационную и тестовую выборки позволяет оценить модель на ранее не встречавшихся данных и измерить её способность к обобщению. Часто используют такое соотношение: 70% для обучения, 20% для валидации и 10% для тестирования. Упростить этот процесс помогут инструменты вроде scikit-learn или TensorFlow.
При разделении данных учитывай следующие моменты:
- Сохраняй распределение классов: Убедись, что каждый класс представлен пропорционально в обучающей, валидационной и тестовой выборках.
- Балансируй классы: Если датасет несбалансирован, рассмотри увеличение числа примеров меньшинства или уменьшение числа примеров большинства — только в обучающей выборке.
Раздели датасет до применения аугментации и любой другой предварительной обработки, а преобразования применяй только к обучающей выборке. Если выполнить аугментацию до разделения, информация из валидационных или тестовых изображений повлияет на обучение. В результате оценки окажутся завышенными и резко упадут на реальных данных.
Аугментация датасета#
Аугментация данных искусственно увеличивает размер датасета, создавая изменённые версии существующих изображений. Она помогает уменьшить переобучение и улучшить способность модели к обобщению, а также даёт несколько преимуществ:
- Более устойчивые модели: Различия в освещении, ориентации и масштабе помогают модели противостоять искажениям, встречающимся в реальных условиях.
- Экономичность: Ты увеличиваешь обучающую выборку, не собирая и не размечая новые данные.
- Эффективное использование данных: Каждое размеченное изображение даёт несколько вариантов для обучения.
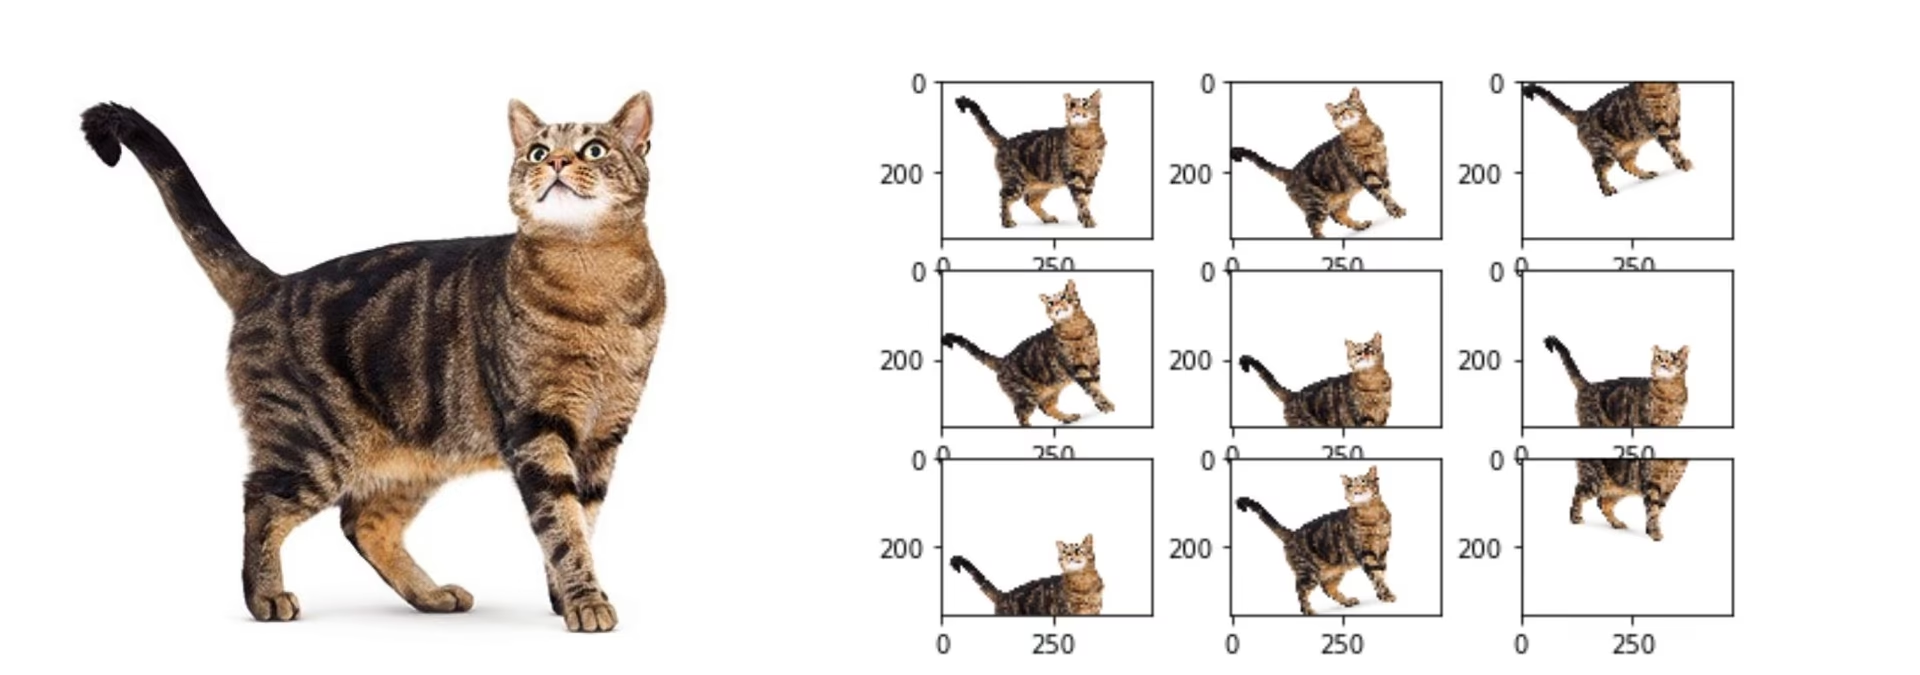
В YOLO26 интенсивность аугментации задаётся через аргументы обучения, передаваемые в model.train(), или соответствующие флаги CLI, а не через редактирование YAML-файла датасета, в котором указаны такие метаданные, как пути, названия классов и разделение данных. Единственное исключение — flip_idx: в YAML-файле датасета позы указывают этот параметр для сопоставления пар ключевых точек слева и справа. Если параметр отсутствует, YOLO полностью отключает fliplr и flipud. Встроенные методы аугментации:
- Мозаика, MixUp и CutMix (
mosaic,mixup,cutmix): Объединяют несколько изображений в один обучающий пример. - Отражения (
fliplr,flipud): Отражают изображения по горизонтали или вертикали. - Геометрические преобразования (
degrees,translate,scale,shear,perspective): Поворачивают, сдвигают, масштабируют и деформируют изображения. - Изменение цветов HSV (
hsv_h,hsv_s,hsv_v): Меняет оттенок, насыщенность и яркость. - Копирование и вставка (
copy_paste): Добавляет копии сегментированных объектов. По умолчанию они отражаются внутри того же изображения, но их можно взять из другого изображения с помощьюcopy_paste_mode=mixup. - Перестановка каналов (
bgr): Меняет порядок цветовых каналов с RGB на BGR. - Преобразования для классификации (
auto_augment,erasing): Применяют автоматическую политику аугментации и случайное удаление областей при обучении классификатора.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Аугментация настраивается с помощью аргументов обучения, а не YAML-файла датасета
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Полный список аргументов аугментации и их значений по умолчанию смотри в справочнике настроек аугментации и отдельном руководстве по аугментации данных YOLO. Если установлен пакет albumentations, YOLO также автоматически включает встроенные аугментации на базе Albumentations.
Пример: предварительная обработка данных для детекции транспортных средств#
Представь, что нужно обнаруживать и классифицировать транспортные средства на изображениях дорожного движения с помощью YOLO26. В качестве исходных данных есть изображения, размеченные ограничивающими рамками и метками. Вот как выглядит каждое решение по предварительной обработке:
- Изменение размера: Вручную ничего делать не нужно — во время обучения YOLO26 меняет размер до
imgsz. - Нормализация: Вручную ничего делать не нужно — YOLO26 автоматически масштабирует значения пикселей до
[0, 1]. - Разделение: Раздели датасет: 70% для обучения, 20% для валидации и 10% для тестирования. Сохраняй распределение классов во всех выборках.
- Аугментация: Задай аргументы обучения с учётом особенностей дорожных сцен — например,
fliplrдля независимости от направления,hsv_vдля имитации дневного и ночного освещения иmosaicдля изменения плотности объектов.
После этого датасет готов к разведочному анализу данных (EDA).
Разведочный анализ данных (EDA)#
EDA использует статистику и визуализации, чтобы выявлять закономерности и распределения в данных. Это помогает обнаружить такие проблемы, как дисбаланс классов и выбросы, до начала обучения.
Методы статистического EDA#
Статистический EDA начинается с расчёта базовых метрик — среднего значения, медианы, стандартного отклонения и диапазона — для таких характеристик, как распределение интенсивности пикселей. Эти метрики дают общее представление о качестве датасета и помогают заранее выявить отклонения.
Методы визуального EDA#
Визуализации показывают закономерности, которые не видны в сводной статистике, например дисбаланс классов и выбросы. Среди распространённых инструментов:
- Гистограммы и диаграммы размаха: Показывают распределение значений пикселей и помогают выявлять выбросы в интенсивности или распределении признаков.
- Столбчатые диаграммы: Показывают дисбаланс классов, сравнивая количество примеров для каждого класса.
- Диаграммы рассеяния: Помогают изучать взаимосвязи между признаками изображений или аннотациями.
- Тепловые карты: Показывают распределение интенсивности пикселей или пространственное распределение аннотаций на изображениях.
Платформа Ultralytics для EDA#
Чтобы выполнить EDA без программирования, загрузи датасет на платформу Ultralytics. Вкладка датасета Charts автоматически создаёт основные визуализации для EDA: распределение данных по выборкам, количество примеров в самых многочисленных классах, гистограммы ширины и высоты изображений и двумерные тепловые карты расположения аннотаций и размеров изображений. На вкладке Images можно просматривать данные в виде сетки, компактного списка или таблицы с наложенными аннотациями. Так легко находить ошибочно размеченные примеры и несбалансированные классы без написания кода.
Заключение#
Правильное разделение, нормализация и аугментация данных уменьшают шум и улучшают способность модели к обобщению, превращая набор исходных изображений в надёжную обучающую выборку. После предварительной обработки датасета следующий шаг — обучить модель. Если по ходу работы возникнут вопросы, обратись к сообществу в репозитории Ultralytics на GitHub или на сервере Ultralytics в Discord.
Часто задаваемые вопросы#
Предварительная обработка обеспечивает чистоту и согласованность данных, а также приводит их к формату, оптимальному для обучения. Такие этапы, как изменение размера, нормализация, аугментация и разделение датасета, устраняют шум, несогласованность и дисбаланс классов в исходных данных, снижают вычислительную нагрузку и повышают качество модели. Узнай, как предварительная обработка вписывается в общий рабочий процесс, в руководстве по этапам проекта компьютерного зрения.
Настраивай аугментацию с помощью аргументов обучения, а не YAML-файла датасета. Передавай в
model.train()(или указывай соответствующие флаги CLI) такие аргументы, какfliplr,mosaic,hsv_hиdegrees, чтобы задать вероятность и интенсивность каждого преобразования. Их описание приведено в настройках аугментации и руководстве по аугментации данных YOLO. Исключение — датасеты поз: сопоставление ключевых точекflip_idxуказывается в YAML-файле датасета, а без него отражения отключены.Два наиболее распространённых метода — масштабирование min-max (приведение значений пикселей к диапазону от 0 до 1) и нормализация по z-оценке (масштабирование с учётом среднего значения и стандартного отклонения). YOLO26 автоматически применяет масштабирование min-max: преобразует изображения в RGB и делит значения пикселей на 255. Поэтому вручную нормализовать данные не нужно. По умолчанию нормализация по z-оценке не применяется.
Часто данные разделяют так: 70% для обучения, 20% для валидации и 10% для тестирования. Сохраняй распределение классов во всех трёх выборках и избегай утечки данных: применяй аугментацию только к обучающей выборке и только после разделения. Инструменты вроде scikit-learn или TensorFlow эффективно выполняют разделение. Информацию о предварительной подготовке датасета смотри в руководстве по сбору и разметке данных.
Да. Аргумент
imgszзадаёт целевой размер входных данных, поэтому вручную ничего делать не нужно. При обработке изображений по фиксированному квадратному шаблону валидация и инференс приводят изображения к указанному размеру с помощью полей, сохраняя соотношение сторон; большие изображения уменьшаются, а маленькие не увеличиваются, если увеличение отключено. Во время обучения стандартная мозаичная аугментация достигает целевого размера, размещая четыре изображения на одном холсте и обрезая их. Для прямоугольных пакетов (rect=True) иmulti_scaleиспользуются другие формы входных данных. Подробности смотри в документации по обучению моделей.