Ultralytics YOLO26 trên NVIDIA Jetson với DeepStream SDK và TensorRT#
Xem: Cách sử dụng model Ultralytics YOLO26 với NVIDIA DeepStream trên Jetson Orin NX 🚀
Hướng dẫn toàn diện này trình bày chi tiết cách triển khai Ultralytics YOLO26 trên thiết bị NVIDIA Jetson bằng DeepStream SDK và TensorRT. Trong hướng dẫn này, chúng ta sử dụng TensorRT để tối đa hóa hiệu năng suy luận trên nền tảng Jetson.
Hướng dẫn này trình bày cách thực hiện cấu hình DeepStream cho YOLO26, hiệu chuẩn INT8, thiết lập đa luồng và kết quả benchmark.
Hướng dẫn này đã được kiểm thử trên NVIDIA Jetson Orin Nano Super Developer Kit chạy bản phát hành JetPack JP6.1, Seeed Studio reComputer J4012 dựa trên NVIDIA Jetson Orin NX 16GB chạy bản phát hành JetPack JP5.1.3 và Seeed Studio reComputer J1020 v2 dựa trên NVIDIA Jetson Nano 4GB chạy bản phát hành JetPack JP4.6.4. Hướng dẫn này dự kiến hoạt động trên toàn bộ dòng phần cứng NVIDIA Jetson, bao gồm cả các phiên bản mới nhất và đời cũ.
NVIDIA DeepStream là gì?#
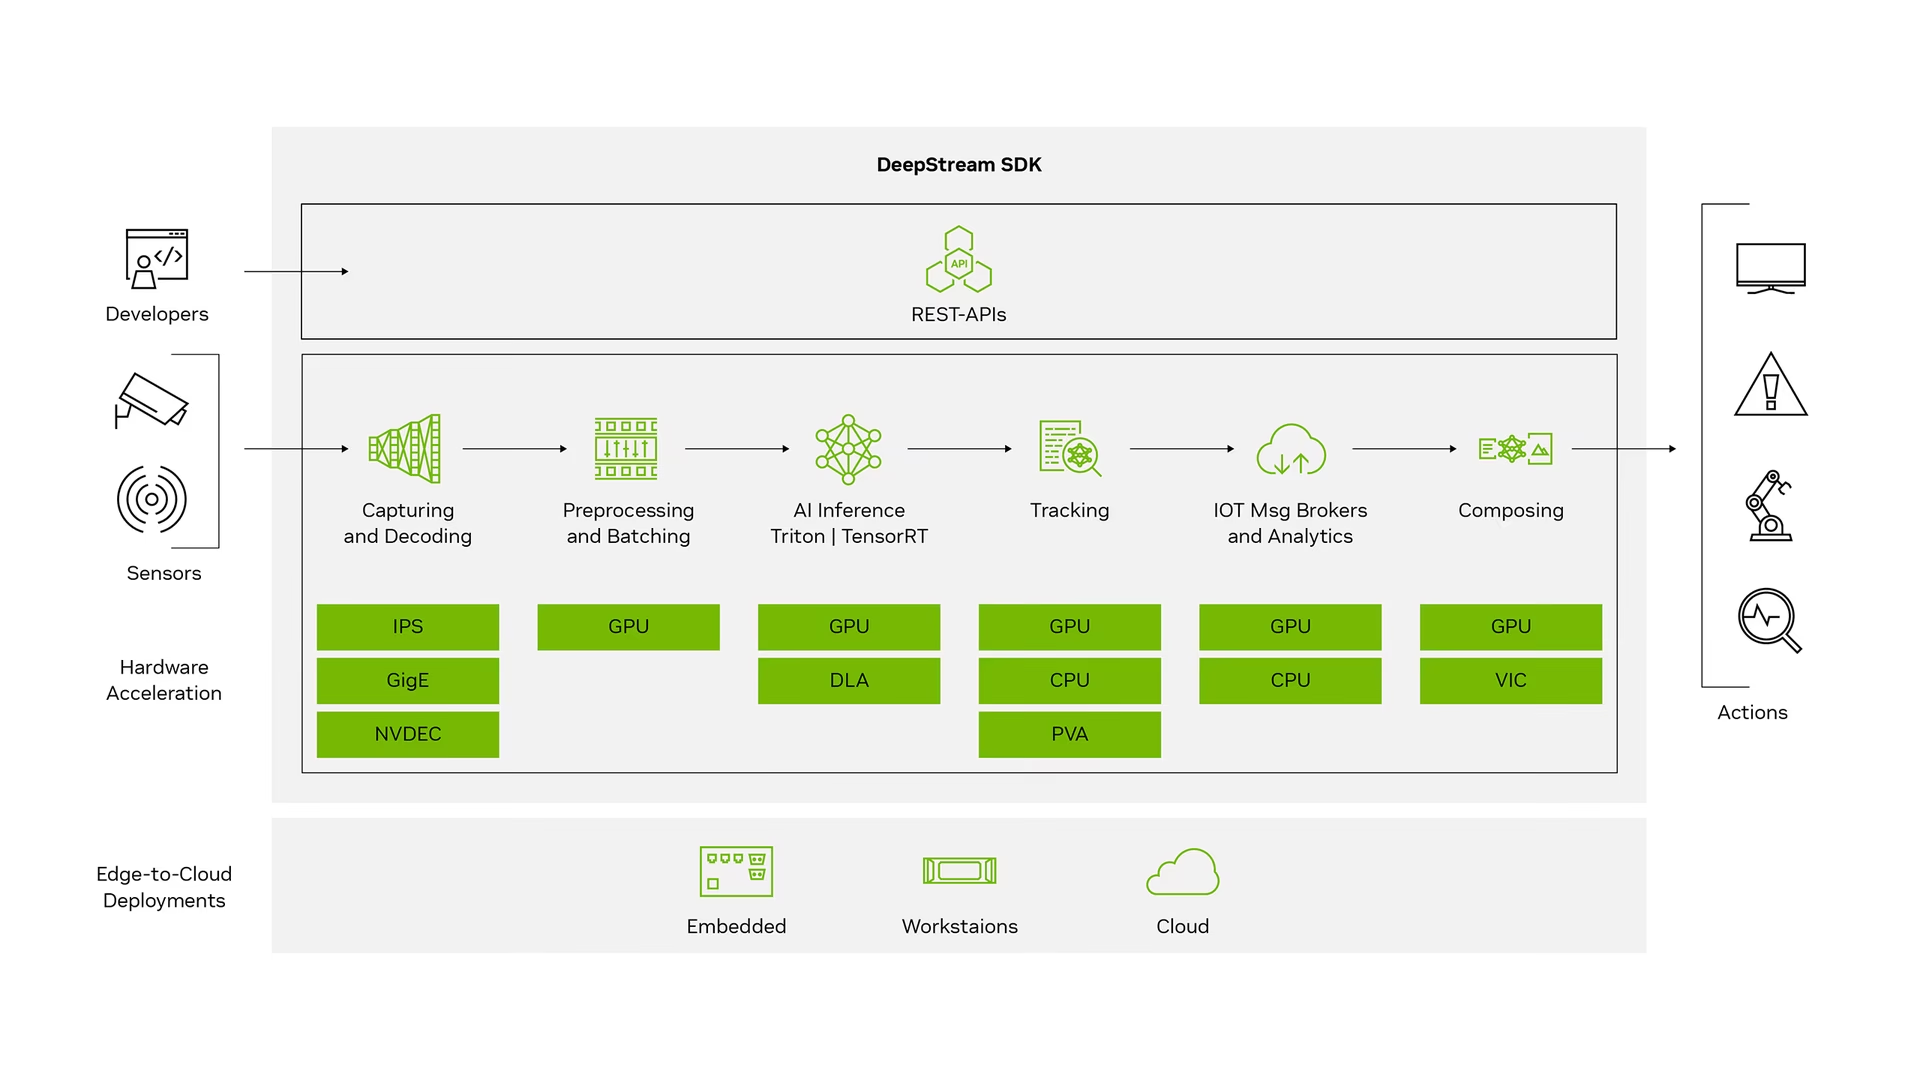
DeepStream SDK của NVIDIA là bộ công cụ phân tích luồng hoàn chỉnh dựa trên GStreamer, phục vụ xử lý đa cảm biến, video, âm thanh và hiểu hình ảnh bằng AI. Đây là lựa chọn lý tưởng cho các nhà phát triển vision AI, đối tác phần mềm, startup và OEM xây dựng ứng dụng và dịch vụ phân tích video thông minh (IVA). Giờ đây, bạn có thể tạo các pipeline xử lý luồng tích hợp mạng nơ-ron cùng những tác vụ xử lý phức tạp khác như tracking, mã hóa/giải mã video và kết xuất video. Các pipeline này hỗ trợ phân tích dữ liệu video, hình ảnh và cảm biến theo thời gian thực. Khả năng hỗ trợ đa nền tảng của DeepStream giúp bạn phát triển ứng dụng và dịch vụ vision AI nhanh hơn, dễ dàng hơn tại chỗ, ở biên và trên đám mây.
Điều kiện tiên quyết#
Trước khi bắt đầu làm theo hướng dẫn này:
- Truy cập tài liệu của chúng tôi, Hướng dẫn bắt đầu nhanh: NVIDIA Jetson với Ultralytics YOLO26, để thiết lập thiết bị NVIDIA Jetson với Ultralytics YOLO26
- Cài đặt DeepStream SDK tương thích với phiên bản JetPack
- Với JetPack 4.6.4, hãy cài đặt DeepStream 6.0.1
- Với JetPack 5.1.3, hãy cài đặt DeepStream 6.3
- Với JetPack 6.1, hãy cài đặt DeepStream 7.1
- Với JetPack 7.1, hãy cài đặt DeepStream 9.0
Trong hướng dẫn này, chúng tôi sử dụng phương pháp cài đặt DeepStream SDK bằng gói Debian trên thiết bị Jetson. Bạn cũng có thể truy cập DeepStream SDK trên Jetson (Đã lưu trữ) để dùng các phiên bản DeepStream cũ.
Cấu hình DeepStream cho YOLO26#
Ở đây, chúng tôi sử dụng repository GitHub marcoslucianops/DeepStream-Yolo, repository này hỗ trợ NVIDIA DeepStream SDK cho các model YOLO. Chúng tôi trân trọng những đóng góp của marcoslucianops!
-
Cài đặt Ultralytics cùng các dependency cần thiết
pip install ultralytics onnx onnxslim -
Clone repository DeepStream-Yolo
cd ~ git clone https://github.com/marcoslucianops/DeepStream-Yolo -
Tải model phát hiện Ultralytics YOLO26 (.pt) bạn chọn từ dự án YOLO26. Ở đây, chúng tôi sử dụng yolo26s.pt.
wget https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo26s.pt
Bạn cũng có thể sử dụng model YOLO26 được huấn luyện tùy chỉnh.
-
Chuyển đổi model sang ONNX và ghi file
labels.txtđể DeepStream đọc tên các classfrom ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # creates 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))
nms=False xuất head không dùng NMS, còn agnostic_nms=True giữ một class duy nhất cho mỗi detection để cluster-mode=4 (không gom cụm) trong cấu hình DeepStream không vẽ trùng một bounding box. Thêm imgsz=1280 để thay đổi kích thước suy luận (mặc định: 640), batch=4 để đặt batch size là 4 (batch được xuất có kích thước cố định, vì vậy phải khớp với batch-size trong cấu hình DeepStream) và opset=12 cho TensorRT 8.2 trở xuống (DeepStream 6.0.1 trở về trước). Xem các tham số xuất model để biết danh sách đầy đủ.
-
Sao chép file model
.onnxđược tạo và filelabels.txtvào thư mụcDeepStream-Yolocp yolo26s.onnx labels.txt ~/DeepStream-Yolo cd ~/DeepStream-Yolo -
Đặt phiên bản CUDA phù hợp với phiên bản JetPack đã cài đặt
Với JetPack 4.6.4:
export CUDA_VER=10.2Với JetPack 5.1.3:
export CUDA_VER=11.4Với JetPack 6.1:
export CUDA_VER=12.6Với JetPack 7.1:
export CUDA_VER=13.0 -
Biên dịch thư viện
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Chỉnh sửa file
config_infer_primary_yolo26.txttheo model của bạn (đối với YOLO26s có 80 class)[property] ... onnx-file=yolo26s.onnx ... num-detected-classes=80 ... parse-bbox-func-name=NvDsInferParseYolo ...
YOLO26 thay đổi kích thước đầu vào bằng cách padding ở giữa và chạy mà không dùng NMS. Để đạt độ chính xác tốt nhất, hãy thêm nội dung sau vào mục [property] của config_infer_primary_yolo26.txt:
[property]
...
maintain-aspect-ratio=1
symmetric-padding=1
cluster-mode=4
...-
Chỉnh sửa file
deepstream_app_config... [primary-gie] ... config-file=config_infer_primary_yolo26.txt -
Bạn cũng có thể thay đổi nguồn video trong file
deepstream_app_config. Ở đây, một file video mặc định được tải.... [source0] ... uri=file:///opt/nvidia/deepstream/deepstream/samples/streams/sample_1080p_h264.mp4
Chạy suy luận#
deepstream-app -c deepstream_app_config.txtQuá trình tạo file TensorRT engine trước khi bắt đầu suy luận sẽ mất nhiều thời gian. Vì vậy, hãy kiên nhẫn.
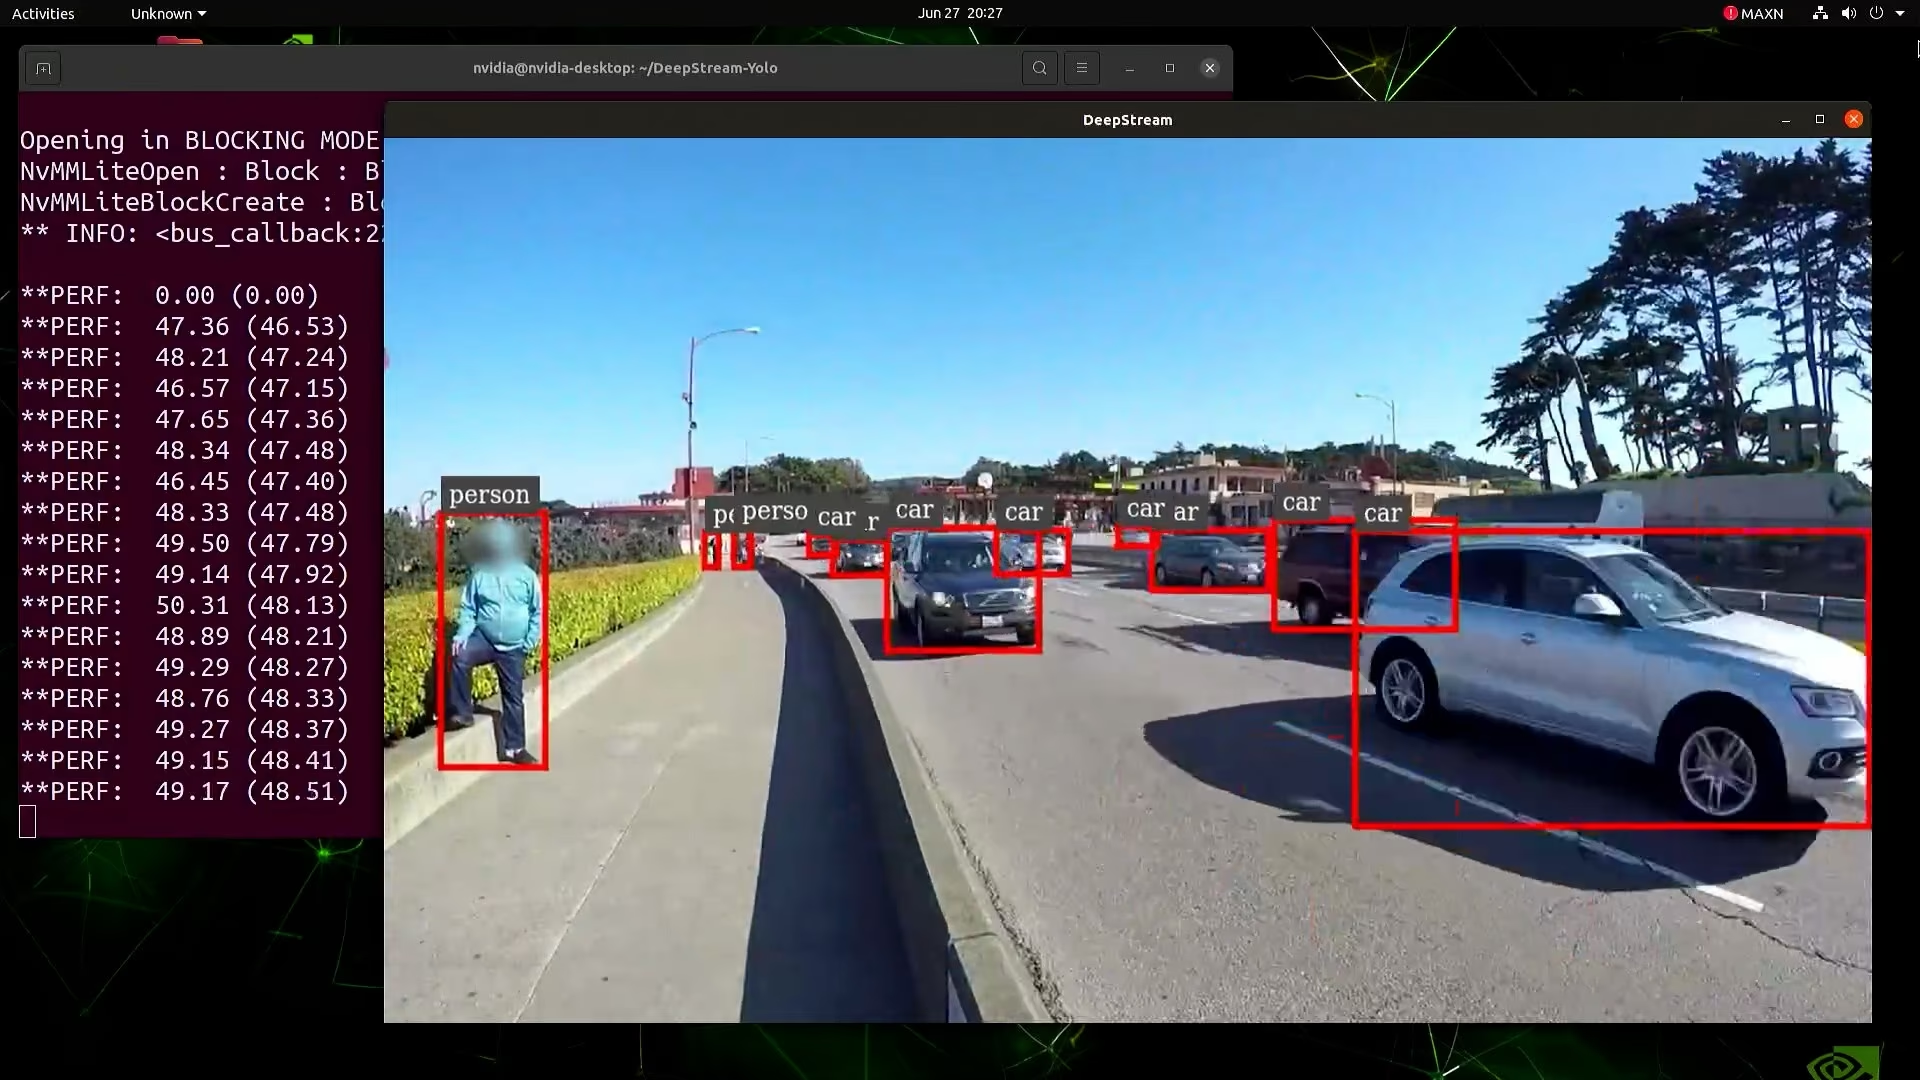
Nếu muốn chuyển đổi model sang độ chính xác FP16, chỉ cần đặt model-engine-file=model_b1_gpu0_fp16.engine và network-mode=2 bên trong config_infer_primary_yolo26.txt
Hiệu chuẩn INT8#
Nếu muốn sử dụng độ chính xác INT8 để suy luận, bạn cần làm theo các bước sau:
Hiện tại, INT8 không hoạt động với TensorRT 10.x. Phần này của hướng dẫn đã được kiểm thử với TensorRT 8.x và dự kiến sẽ hoạt động.
-
Đặt biến môi trường
OPENCVexport OPENCV=1 -
Biên dịch thư viện
make -C nvdsinfer_custom_impl_Yolo clean && make -C nvdsinfer_custom_impl_Yolo -
Đối với bộ dữ liệu COCO, hãy tải val2017, giải nén và chuyển vào thư mục
DeepStream-Yolo -
Tạo thư mục mới để chứa ảnh hiệu chuẩn
mkdir calibration -
Chạy lệnh sau để chọn ngẫu nhiên 1000 ảnh từ bộ dữ liệu COCO phục vụ hiệu chuẩn
for jpg in $(ls -1 val2017/*.jpg | sort -R | head -1000); do
  cp ${jpg} calibration/
done
NVIDIA khuyến nghị sử dụng ít nhất 500 ảnh để đạt độ chính xác tốt. Trong ví dụ này, 1000 ảnh được chọn để cải thiện độ chính xác (càng nhiều ảnh thì độ chính xác càng cao). Bạn có thể đặt số lượng bằng head -1000. Ví dụ: với 2000 ảnh, dùng head -2000. Quá trình này có thể mất nhiều thời gian.
-
Tạo file
calibration.txtchứa tất cả ảnh đã chọnrealpath calibration/*jpg > calibration.txt -
Thiết lập các biến môi trường
export INT8_CALIB_IMG_PATH=calibration.txt
export INT8_CALIB_BATCH_SIZE=1
Giá trị INT8_CALIB_BATCH_SIZE cao hơn sẽ giúp tăng độ chính xác và rút ngắn thời gian hiệu chuẩn. Hãy đặt giá trị này dựa trên bộ nhớ GPU.
-
Cập nhật file
config_infer_primary_yolo26.txtTừ
...
model-engine-file=model_b1_gpu0_fp32.engine
#int8-calib-file=calib.table
...
network-mode=0
...
Sang
...
model-engine-file=model_b1_gpu0_int8.engine
int8-calib-file=calib.table
...
network-mode=1
...
Chạy suy luận INT8#
Chạy cùng lệnh để xây dựng engine INT8 và bắt đầu suy luận:
deepstream-app -c deepstream_app_config.txtThiết lập MultiStream#
Xem: Cách chạy inference đa luồng với Ultralytics YOLO26 bằng NVIDIA DeepStream trên Jetson Orin 🚀
Để thiết lập nhiều luồng trong cùng một ứng dụng DeepStream, hãy thực hiện các thay đổi sau trong file deepstream_app_config.txt:
-
Thay đổi số hàng và cột để tạo bố cục lưới phù hợp với số luồng bạn muốn sử dụng. Ví dụ, với 4 luồng, có thể thêm 2 hàng và 2 cột.
[tiled-display] rows=2 columns=2 -
Thêm một nhóm
[sourceN]riêng cho mỗi luồng, mỗi nhóm cóurivànum-sources=1riêng.[source0] enable=1 type=3 uri=file:///path/to/video1.mp4 num-sources=1 [source1] enable=1 type=3 uri=file:///path/to/video2.mp4 num-sources=1 [source2] enable=1 type=3 uri=file:///path/to/video3.mp4 num-sources=1 [source3] enable=1 type=3 uri=file:///path/to/video4.mp4 num-sources=1
Chạy suy luận đa luồng#
Chạy cùng lệnh để khởi chạy tất cả luồng trong màn hình dạng lưới:
deepstream-app -c deepstream_app_config.txt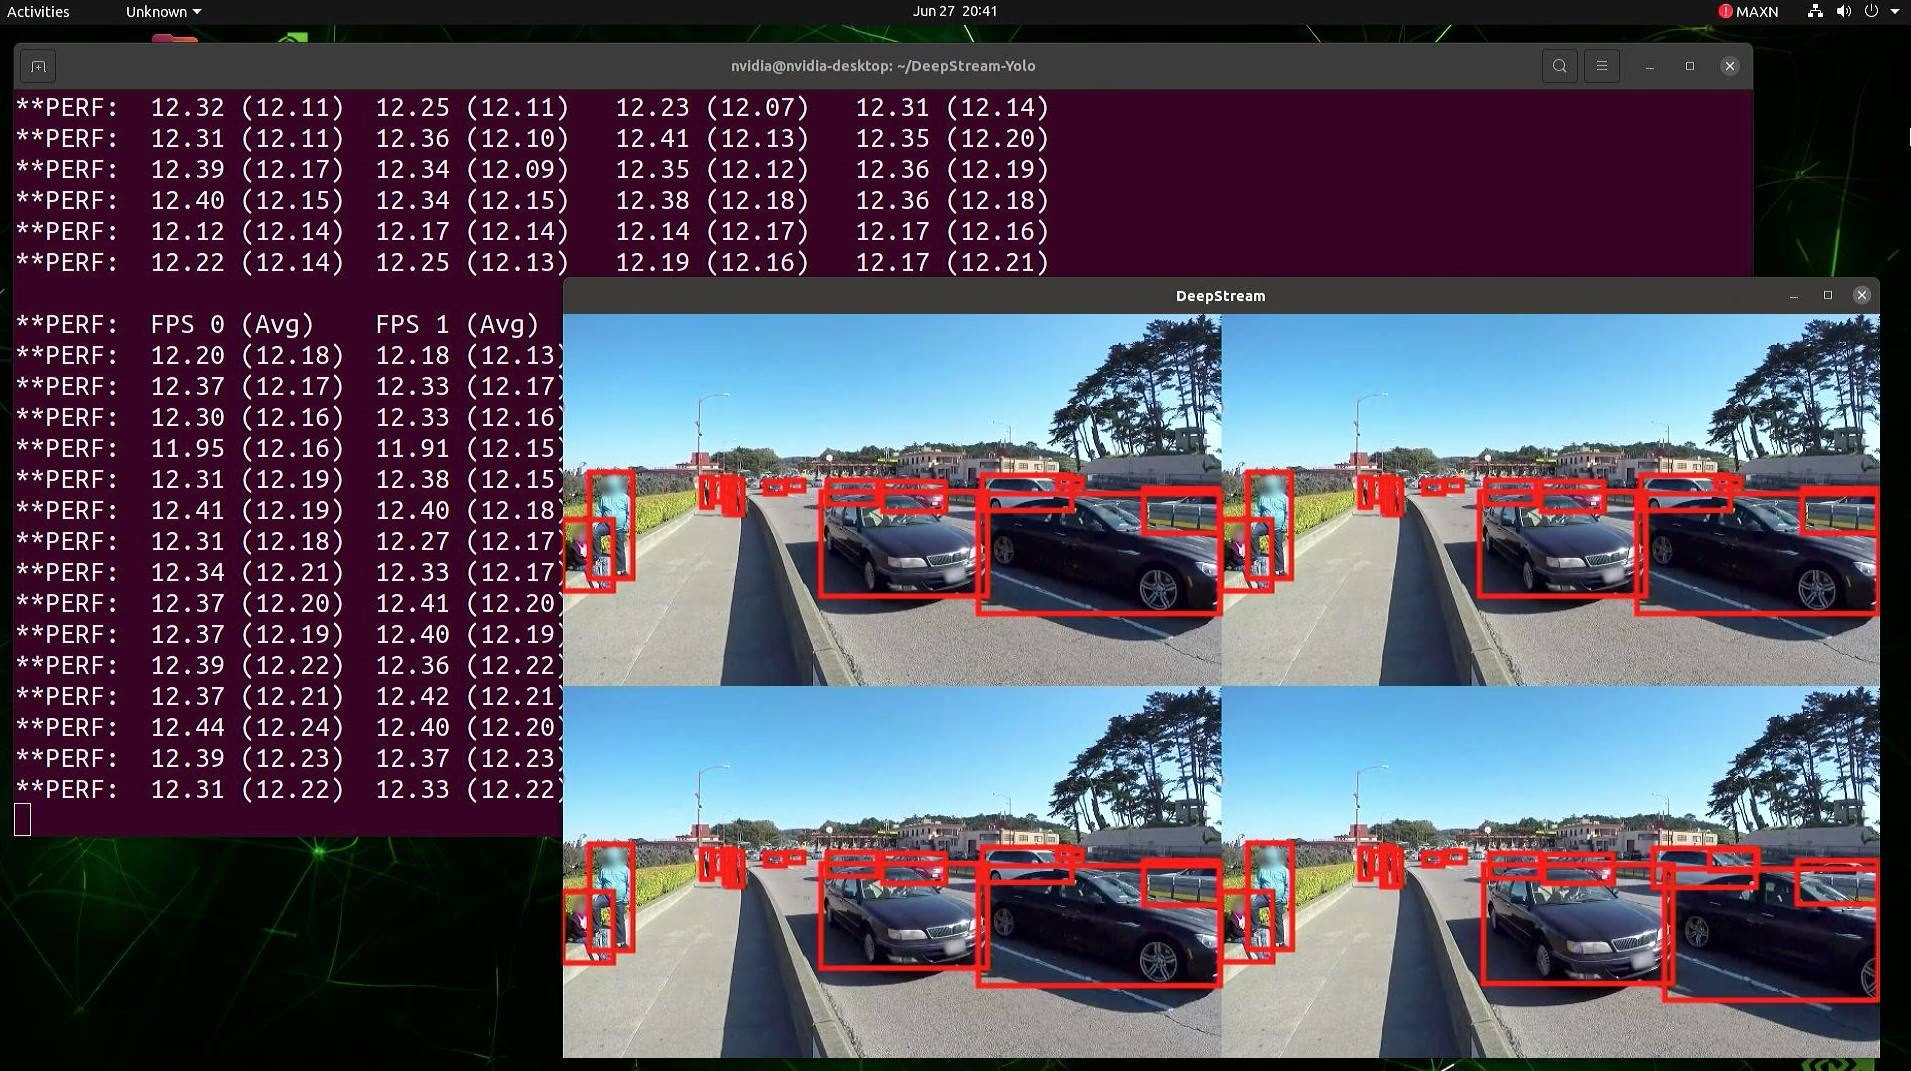
Kết quả benchmark#
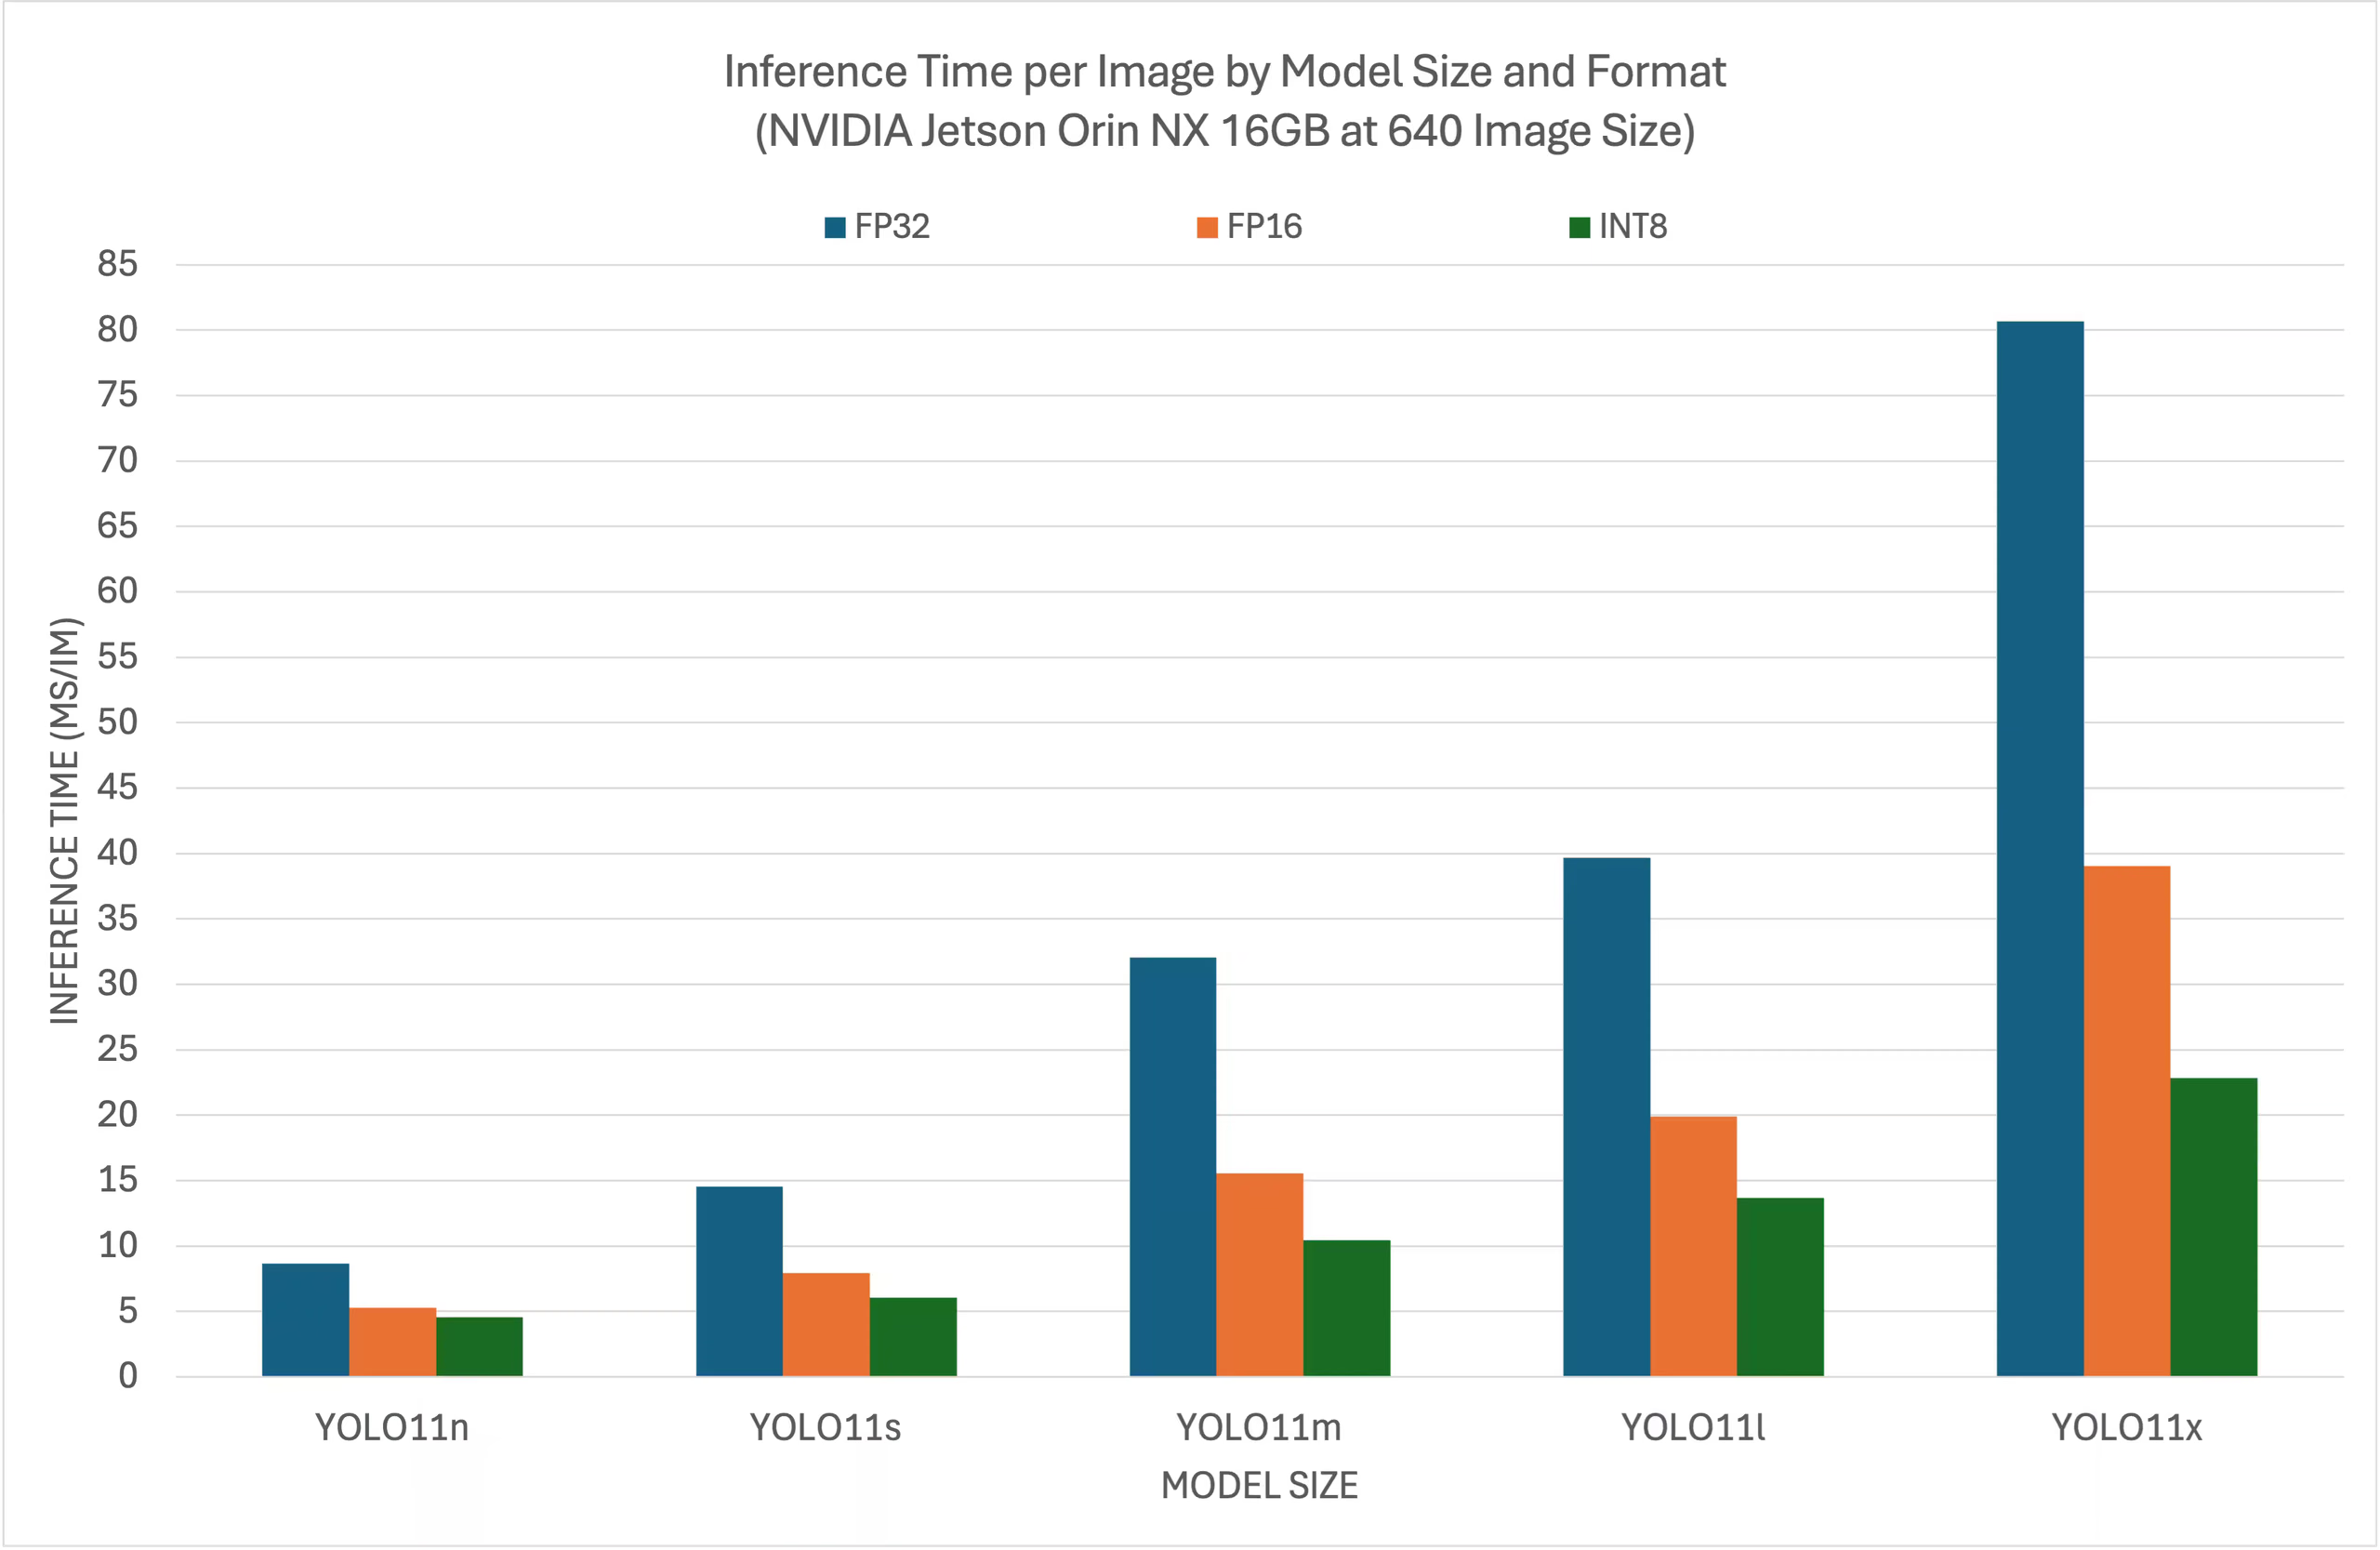
Các benchmark sau đây tóm tắt hiệu năng của các model YOLO11 ở những mức độ chính xác TensorRT khác nhau, với kích thước đầu vào 640x640 trên NVIDIA Jetson Orin NX 16GB. YOLO26 sử dụng cùng quy trình xuất model và suy luận DeepStream đã mô tả ở trên.
Biểu đồ so sánh#
Bảng so sánh chi tiết#
| Định dạng | Trạng thái | Thời gian suy luận (ms/ảnh) |
|---|---|---|
| TensorRT (FP32) | ✅ | 8.64 |
| TensorRT (FP16) | ✅ | 5.27 |
| TensorRT (INT8) | ✅ | 4.54 |
Lời cảm ơn#
Hướng dẫn này ban đầu được xây dựng bởi những người bạn của chúng tôi tại Seeed Studio, Lakshantha và Elaine.
Câu hỏi thường gặp#
Để thiết lập Ultralytics YOLO26 trên thiết bị NVIDIA Jetson, trước tiên bạn cần cài đặt DeepStream SDK tương thích với phiên bản JetPack. Làm theo hướng dẫn từng bước trong Hướng dẫn bắt đầu nhanh của chúng tôi để cấu hình NVIDIA Jetson cho việc triển khai YOLO26.
Sử dụng TensorRT với YOLO26 giúp tối ưu hóa model cho suy luận, giảm đáng kể độ trễ và cải thiện thông lượng trên các thiết bị NVIDIA Jetson. TensorRT cung cấp khả năng suy luận học sâu hiệu năng cao, độ trễ thấp thông qua hợp nhất layer, hiệu chuẩn độ chính xác và tự động tinh chỉnh kernel. Nhờ đó, model thực thi nhanh hơn và hiệu quả hơn, đặc biệt hữu ích cho các ứng dụng thời gian thực như phân tích video và máy tự hành.
Có, hướng dẫn triển khai Ultralytics YOLO26 với DeepStream SDK và TensorRT tương thích với toàn bộ dòng NVIDIA Jetson. Hướng dẫn bao gồm các thiết bị như Jetson Orin NX 16GB với JetPack 5.1.3 và Jetson Nano 4GB với JetPack 4.6.4. Tham khảo mục Cấu hình DeepStream cho YOLO26 để xem các bước chi tiết.
Xuất model bằng Ultralytics exporter với head không dùng NMS, sau đó ghi file
labels.txtđể DeepStream đọc tên các class:from ultralytics import YOLO model = YOLO("yolo26s.pt") model.export(format="onnx", nms=False, agnostic_nms=True) # creates 'yolo26s.onnx' with open("labels.txt", "w") as f: f.write("\n".join(model.names.values()))Thêm
opset=12cho TensorRT 8.2 trở xuống (DeepStream 6.0.1 trở về trước). Để biết thêm chi tiết về chuyển đổi model, hãy xem mục xuất model của chúng tôi.Để chạy suy luận INT8, hãy hiệu chuẩn model trên một tập ảnh đại diện và chuyển cấu hình DeepStream sang chế độ INT8. Tải ảnh COCO val2017, chọn khoảng 1000 ảnh để hiệu chuẩn, đặt các biến môi trường
INT8_CALIB_IMG_PATHvàINT8_CALIB_BATCH_SIZE, sau đó cập nhậtconfig_infer_primary_yolo26.txtvớimodel-engine-file=model_b1_gpu0_int8.engine,int8-calib-file=calib.tablevànetwork-mode=1. Xem mục Hiệu chuẩn INT8 để biết đầy đủ các bước. Hiện tại, INT8 yêu cầu TensorRT 8.x.Để xử lý nhiều luồng trong cùng một ứng dụng DeepStream, hãy chỉnh sửa file
deepstream_app_config.txtđể thêm lưới hiển thị dạng ô và liệt kê URI của từng nguồn. Đặtrowsvàcolumnsbên dưới[tiled-display]để tạo lưới, thêm một nhóm[sourceN]riêng cho mỗi luồng vớiurivànum-sources=1riêng, rồi điều chỉnh lưới cho phù hợp với số luồng. Xem mục Thiết lập MultiStream để biết ví dụ đầy đủ.Hiệu năng của các model YOLO11 trên NVIDIA Jetson Orin NX 16GB thay đổi tùy theo mức độ chính xác TensorRT. Ví dụ, các model YOLO11s đạt:
- Độ chính xác FP32: 14.53 ms/im, 68.8 FPS
- Độ chính xác FP16: 7.91 ms/im, 126 FPS
- Độ chính xác INT8: 6.05 ms/im, 165 FPS
Các benchmark này nhấn mạnh hiệu quả và năng lực khi sử dụng model YOLO11 được tối ưu hóa bằng TensorRT trên phần cứng NVIDIA Jetson. Để biết thêm chi tiết, hãy xem mục Kết quả benchmark.