Integration Amazon S3#
Integration Amazon S3 kết nối các bucket S3 của bạn với Ultralytics Platform. Ảnh vẫn nằm trong bucket của bạn — Platform lập chỉ mục tại chỗ để bạn có thể duyệt, chú thích và training model YOLO mà không cần tải bản sao lên.
Dataset Amazon S3 yêu cầu gói Pro hoặc Enterprise. Workspace miễn phí vẫn thấy integration và được nhắc nâng cấp khi kết nối. Dataset Amazon S3 hiện có vẫn được truy cập đầy đủ nếu gói đăng ký kết thúc — chỉ kết nối và import mới yêu cầu Pro.
Tạo IAM User chỉ có quyền đọc#
Platform chỉ đọc dữ liệu từ bộ lưu trữ của bạn — không bao giờ ghi, sửa đổi hoặc xóa đối tượng. Hãy dùng một IAM user chuyên biệt chỉ có quyền liệt kê và đọc — không bao giờ dùng thông tin xác thực root:
-
Trong AWS console, vào IAM > Users và tạo user không có quyền truy cập console.
-
Gắn policy chỉ cấp quyền liệt kê và đọc đối với các bucket bạn muốn kết nối:
{ "Version": "2012-10-17", "Statement": [ { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" }, { "Effect": "Allow", "Action": ["s3:ListBucket", "s3:GetObject"], "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"] } ] }s3:ListAllMyBucketslà tùy chọn — token này cho phép Platform tìm các bucket để bạn không phải nhập tên bucket. -
Mở tab Security credentials của user, tạo access key, rồi sao chép access key ID và secret access key.
Platform từ chối thông tin xác thực AWS tạm thời. Các khóa do AWS STS cấp — bao gồm mọi khóa bắt đầu bằng ASIA, thông tin xác thực phiên role và khóa IAM Identity Center — sẽ hết hạn khi dataset vẫn đang được kết nối, vì vậy cần dùng access key dài hạn của một IAM user chuyên biệt.
Kết nối với Platform#
- Vào Settings > Integrations và chọn Amazon S3 trong danh sách integration.
- Nhập access key ID, secret access key và region của bucket (ví dụ:
us-east-1). - Nhấp Find available buckets, rồi chọn các bucket cần kết nối. Nếu policy không cho phép khám phá bucket, hãy nhập thủ công tên một bucket đã biết.
- Nhấp vào Connect. Platform xác minh khả năng liệt kê và đọc từng bucket đã chọn trước khi lưu bất kỳ thông tin nào.
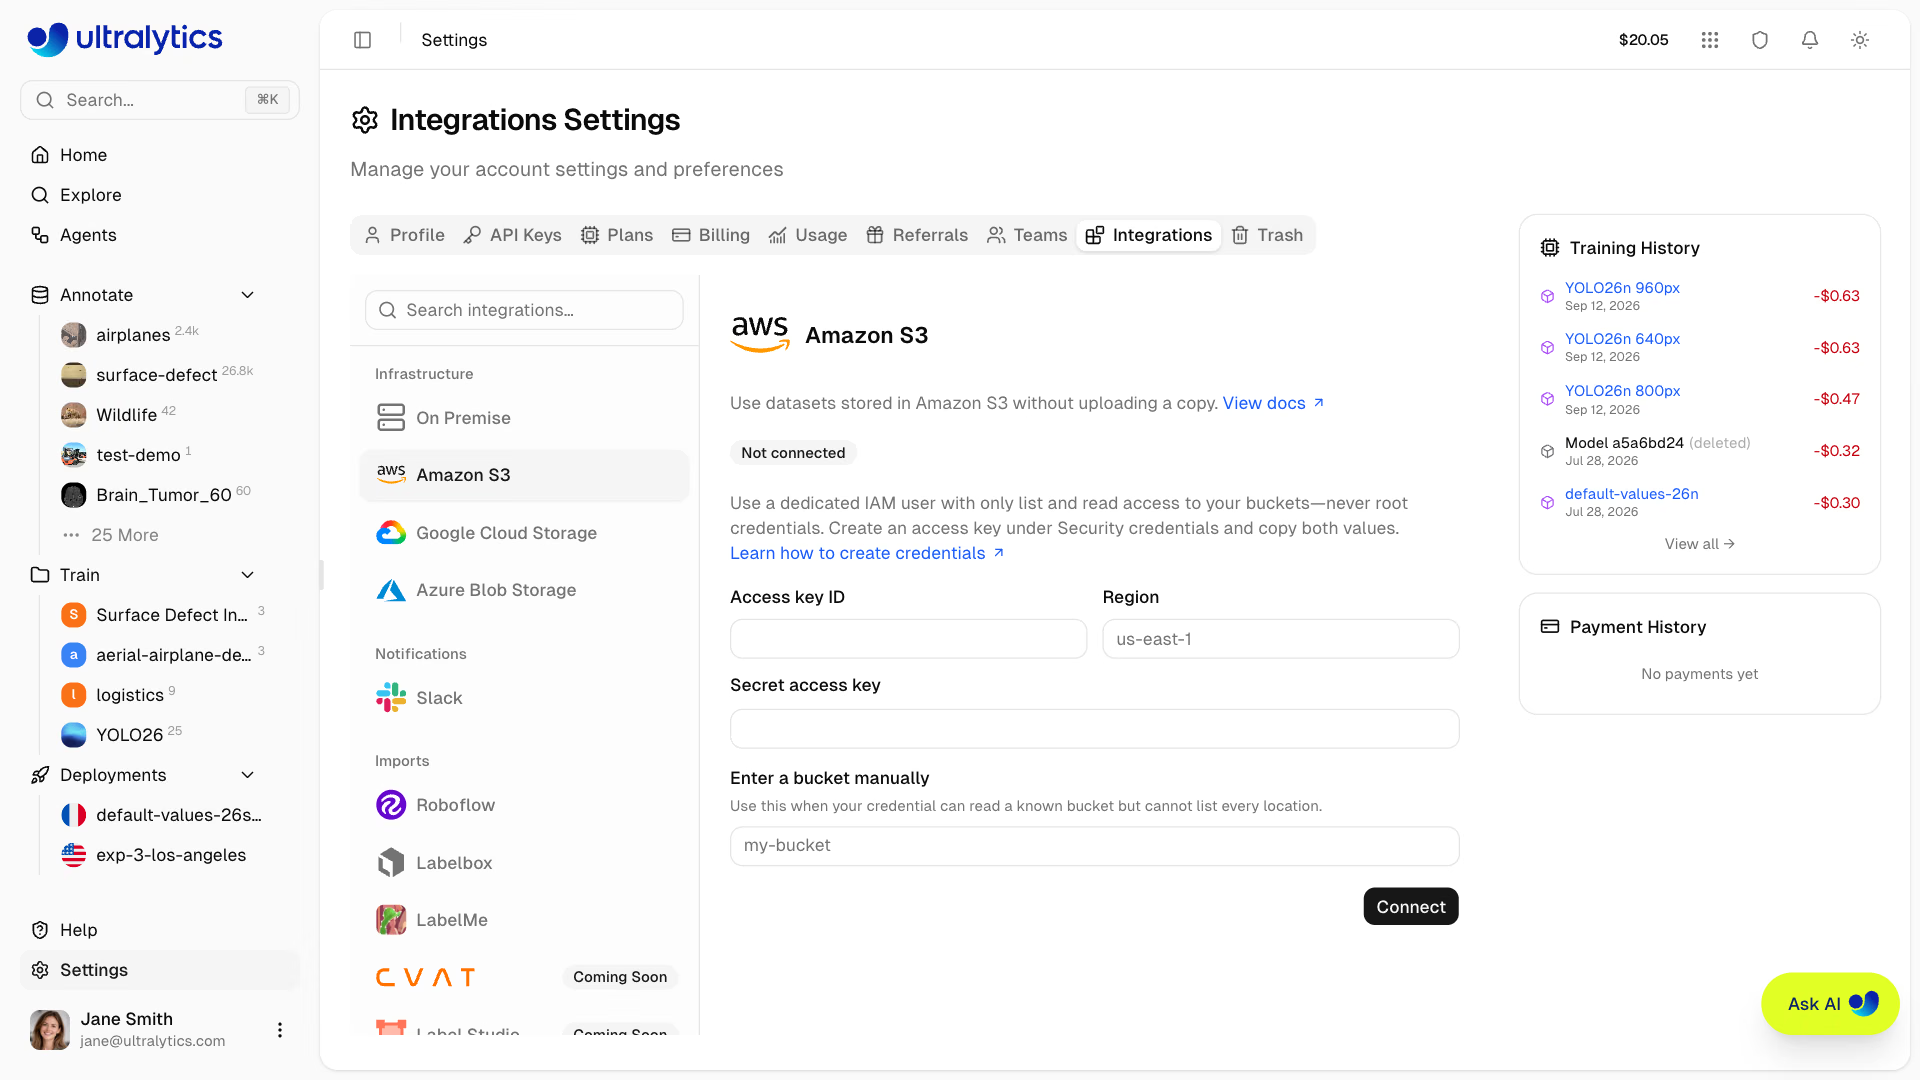
Bạn cần có vai trò admin hoặc owner của workspace để kết nối bộ lưu trữ đám mây. Mỗi lần, bạn có thể thêm tối đa 50 bucket; tính năng khám phá liệt kê tối đa 300 bucket mà khóa có thể truy cập.
Khi kết nối lại cùng IAM user sau này, các bucket mới sẽ được thêm vào integration hiện có. Thông tin xác thực đã lưu chỉ được thay thế khi thông tin mới vẫn có thể đọc tất cả bucket bạn đã kết nối. Nếu không thể đọc bucket nào, thông báo lỗi sẽ nêu tên bucket đó, kể cả các bucket đã kết nối trước đó bằng cùng IAM user.
Kết nối sẽ đọc các bucket trong region bạn nhập. Nếu các bucket nằm ở nhiều region, hãy tạo một kết nối cho mỗi region.
Thông tin xác thực được mã hóa khi lưu trữ bằng AES-256-GCM, không bao giờ được gửi lại trình duyệt và không bao giờ bị lộ cho workload training. Để thu hồi quyền truy cập, hãy vô hiệu hóa access key trong AWS IAM.
Tạo dataset từ bucket S3#
- Nhấp vào New Dataset rồi mở tab Cloud.
- Chọn một bucket đã kết nối rồi duyệt đến thư mục chứa dữ liệu của bạn.
- Xác nhận thư mục, điều chỉnh tên dataset rồi tạo dataset.
Platform liệt kê thư mục một lần rồi lập chỉ mục những gì tìm thấy:
- Ảnh — các object
.jpg,.jpeg,.png,.webpvà.avifđược lập chỉ mục; kích thước được đọc bằng các request có giới hạn. Platform không lưu thêm bản sao của ảnh nguồn. - Nhãn — các sidecar YOLO
.txtđược phân tích thành annotation trên Platform, khớp theo cấu trúc chuẩnimages/→labels/hoặc theo các file cùng thư mục. - Metadata — file YAML cung cấp tên class và hình dạng keypoint của pose, giống hệt như khi tải lên archive. Ưu tiên
data.yamlvàdata.ymlnếu thư mục chứa nhiều file. - Tác vụ — hệ thống xác định tác vụ bằng cách lấy mẫu các file nhãn, nhờ đó nhận diện thư mục segment, pose và OBB dựa trên cấu trúc nhãn thay vì tác vụ bạn chọn trong hộp thoại.
- Các tập dữ liệu — Tên thư mục
train,valvàtesttrong object key sẽ tự động gán các tập dữ liệu.
Sau đó, dataset hoạt động như mọi dataset khác: duyệt và gán nhãn, đặt ở chế độ công khai hoặc riêng tư, chia sẻ với team và huấn luyện bằng dịch vụ huấn luyện được quản lý. Ảnh gốc được truyền theo yêu cầu và ảnh đã lập chỉ mục không tính vào hạn mức lưu trữ trên Platform.
Mỗi lần import lập chỉ mục tối đa 500.000 đối tượng; mỗi tệp nhãn hoặc YAML có thể có kích thước tối đa 1 MB. Các bucket lớn hơn nên được chia thành nhiều dataset.
Mỗi ảnh đã lập chỉ mục được cố định với ETag của đối tượng S3 tương ứng, và Platform sẽ từ chối an toàn nếu đối tượng bị thay đổi. Hãy thêm đối tượng mới thay vì ghi đè đối tượng hiện có.
Import thất bại#
Nếu quá trình import thất bại — do thư mục trống, đường dẫn sai chính tả hoặc quyền truy cập bị thu hồi — dataset sẽ hiển thị lỗi trên trang của dataset. Editor có thể nhấp Retry import để khởi động lại bằng bucket và thư mục đã lưu, hoặc tạo dataset mới trỏ đến đường dẫn đã sửa.
Khi thử lại, hệ thống sẽ liệt kê lại thư mục thay vì tiếp tục từ điểm dừng: các đối tượng được thêm kể từ lần thử đầu tiên sẽ được lấy vào, còn các đối tượng không còn ở đó sẽ bị loại khỏi dataset.
Huấn luyện#
Quy trình training được quản lý hoạt động thông qua luồng training thông thường. Trong suốt thời gian chạy, training sử dụng các bản sao riêng của Platform từ những ảnh đã được cố định phiên bản; thông tin xác thực AWS của bạn không bao giờ bị lộ cho workload training.
Ngắt kết nối#
Ngắt kết nối sẽ xóa thông tin xác thực đã lưu mà không tác động đến bất kỳ nội dung nào trong AWS. Các dataset được tạo từ những bucket đó vẫn nằm trong workspace của bạn cùng với class, nhãn và chú thích, nhưng không thể tải, xem trước hoặc dùng ảnh để training cho đến khi kết nối lại cùng IAM user. Khi đã ngắt kết nối, bạn vẫn có thể đổi tên dataset, chỉnh sửa nhãn hoặc xóa dataset.
Để ngắt kết nối, vào Settings > Integrations, chọn Amazon S3, nhấp Disconnect bên cạnh thông tin xác thực rồi xác nhận. Khi mở một trong các dataset đó, bạn sẽ thấy Amazon S3 Disconnected cùng liên kết quay lại phần cài đặt này; dataset sẽ tự động hoạt động trở lại khi bạn kết nối lại.
Bạn cũng có thể ngắt kết nối bằng REST API, sử dụng ID integration do GET /api/integrations/buckets trả về:
curl -X DELETE \
  -H "Authorization: Bearer YOUR_API_KEY" \
  https://platform.ultralytics.com/api/integrations/buckets/INTEGRATION_ID
from ultralytics_platform import Platform
client = Platform() # reads ULTRALYTICS_API_KEY
integrations = client.storage_integrations.list()
client.storage_integrations.delete("INTEGRATION_ID")Thay vào đó, để thu hồi quyền truy cập từ phía nguồn, hãy vô hiệu hóa hoặc xóa access key trong AWS IAM.
Các giới hạn hiện tại#
Dataset dùng S3 hiện không hỗ trợ các tính năng cần bản sao ảnh do Platform quản lý: tự động gán nhãn, phân tích phân cụm, sao chép dataset và ảnh chụp phiên bản bất biến.
Khi xóa dataset dùng S3 hoặc từng ảnh riêng lẻ trong dataset, Platform chỉ xóa các tham chiếu của mình — các đối tượng của bạn không bị tác động.
Xem thêm các integration Google Cloud Storage và Azure Blob Storage.
Câu hỏi thường gặp#
Không. Platform chỉ liệt kê bucket một lần và lập chỉ mục kích thước ảnh cùng nhãn tìm thấy. Ảnh gốc được truyền theo yêu cầu để duyệt và chú thích; quy trình training được quản lý chỉ sử dụng bản sao riêng của Platform từ những ảnh đã cố định phiên bản trong suốt thời gian chạy. Ảnh đã lập chỉ mục không được tính vào dung lượng lưu trữ của bạn.
Dataset được lập chỉ mục một lần khi tạo. Các đối tượng mới sẽ không được đưa vào cho đến khi bạn tạo dataset mới hoặc thử lại một lần import thất bại; mỗi ảnh đã lập chỉ mục được cố định với phiên bản của ảnh đó, vì vậy nếu ghi đè một đối tượng, Platform sẽ từ chối an toàn ảnh đó. Hãy thêm đối tượng mới thay vì thay thế đối tượng hiện có.
Ngắt kết nối integration trong Settings > Integrations để xóa thông tin xác thực đã lưu, hoặc vô hiệu hóa hay xóa access key trong AWS IAM. Cả hai thao tác đều không tác động đến dữ liệu trong bucket của bạn.