Computer-Vision-Modelle testen#
Einführung#
Beim Testen eines trainierten Modells wird geprüft, wie es sich mit zuvor ungesehenen Daten aus der realen Welt schlägt – etwa mit bewegten, schlecht beleuchteten oder teilweise verdeckten Objekten statt mit sorgfältig zusammengestellten Benchmark-Daten. Während die Modellbewertung Metriken auf einem beschrifteten Datensatz ermittelt, überprüft das Testen, ob das erlernte Verhalten des Modells vor der Bereitstellung den Zielen deiner Anwendung entspricht. Dieser Leitfaden behandelt die Vorbereitung von Testdaten, das Testen von Ultralytics-YOLO26-Modellen sowie das Erkennen von Überanpassung, Unteranpassung und Datenlecks.
Ansehen: So testest du Machine-Learning-Modelle | Vermeide Datenlecks in der Computer Vision 🚀
Modelltesten im Vergleich zur Modellbewertung#
Modelltesten und Modellbewertung sind zwei unterschiedliche Schritte in einem Computer-Vision-Projekt. Bei der Bewertung wird die Leistung anhand von Metriken auf einem beschrifteten Datensatz gemessen; beim Testen wird geprüft, ob sich das erlernte Verhalten des Modells unter Bedingungen bewährt, die dem späteren Einsatz ähneln.
Angenommen, du hast ein Computer-Vision-Modell trainiert, das Katzen und Hunde erkennt, und möchtest es in einer Tierhandlung einsetzen, um die Tiere zu beobachten. In der Bewertungsphase verwendest du einen beschrifteten Datensatz, um Metriken wie Genauigkeit, Präzision und Recall zu berechnen. So könnte das Modell beispielsweise Katzen und Hunde in einem bestimmten Datensatz mit einer Genauigkeit von 98 % unterscheiden.
Nach der Bewertung testest du das Modell mit Bildern aus einer Tierhandlung, um zu sehen, wie gut es Katzen und Hunde unter vielfältigeren und realistischeren Bedingungen erkennt. Du prüfst, ob es Katzen und Hunde korrekt beschriften kann, wenn sie sich bewegen, unterschiedlich beleuchtet sind oder teilweise von Gegenständen wie Spielzeug oder Möbeln verdeckt werden. Beim Modelltesten wird geprüft, ob sich das Modell auch außerhalb der kontrollierten Bewertungsumgebung erwartungsgemäß verhält.
Vorbereitung auf das Modelltesten#
Datensätze für Computer Vision werden üblicherweise in Trainings- und Testdaten aufgeteilt, um reale Bedingungen nachzubilden: Die Trainingsdaten dienen dem Modell zum Lernen, während die Testdaten sein Verhalten anhand von Beispielen prüfen, die es noch nie gesehen hat. Die Ultralytics Platform bündelt die Organisation und Annotation von Datensätzen an einem Ort und erleichtert so den Aufbau eines beschrifteten Testsatzes.
- Realitätsnahe Darstellung: Die zuvor ungesehenen Testdaten sollten den Daten ähneln, mit denen das Modell nach seiner Bereitstellung arbeiten wird. So erhältst du ein realistisches Bild seiner Fähigkeiten.
- Ausreichende Größe: Der Testdatensatz muss groß genug sein, um verlässliche Erkenntnisse über die Leistung des Modells zu liefern.
Ein YOLO26-Modell testen#
Zum Testen eines trainierten YOLO26-Modells gehören zwei sich ergänzende Abläufe: die Validierung anhand eines beschrifteten Testsplits, um quantitative Metriken zu erhalten, und die Vorhersage für neue Bilder, um das Verhalten qualitativ zu prüfen.
Mit einem beschrifteten Testsplit validieren#
Der Validierungsmodus vergleicht die Vorhersagen des Modells mit den Ground-Truth-Beschriftungen und gibt bei Erkennungsmodellen Präzision, Recall, mAP50 und mAP50-95 aus. Außerdem speichert er visuelle Hilfsmittel wie eine Konfusionsmatrix und eine Präzisions-Recall-Kurve, mit denen du bestimmte Bereiche erkennen kannst, in denen die Leistung des Modells möglicherweise nicht ausreicht.
from ultralytics import YOLO

# Ein vortrainiertes Modell oder deinen eigenen trainierten Checkpoint laden, z. B. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Validieren; füge split="test" hinzu, wenn deine Dataset-YAML-Datei einen Testsplitt definiert
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Standardmäßig wird bei der Validierung der val-Split des Datensatzes verwendet. Um die Leistung anhand eines zurückgehaltenen Testsatzes zu messen, definiere einen test:-Split in deiner Dataset-YAML-Datei und übergib split="test".
Vorhersagen für neue Bilder erstellen#
Der Vorhersagemodus führt das Modell mit neuen, ungesehenen Daten aus, ohne dass Beschriftungen erforderlich sind. Er erzeugt keine Leistungsmetriken. Wenn du jedoch die annotierten Ergebnisse speicherst, kannst du das Verhalten des Modells anhand von Bildern aus der realen Welt überprüfen – zum Beispiel für einen ganzen Ordner mit Testbildern auf einmal.
from ultralytics import YOLO

# Ein vortrainiertes Modell oder deinen eigenen trainierten Checkpoint laden, z. B. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Vorhersagen für einen Ordner mit Testbildern erstellen und annotierte Ergebnisse speichern
results = model.predict(source="path/to/test_images", save=True)Um zu prüfen, ob YOLO26 für deine Anwendung geeignet ist, bevor du in ein eigenes Training investierst, führe den Vorhersagemodus mit einem vortrainierten Checkpoint und deinen eigenen Bildern aus. Die Modelle wurden auf Datensätzen wie COCO vortrainiert. Die Ergebnisse vermitteln daher einen schnellen Eindruck davon, wie gut das Modell in deinem konkreten Anwendungsfall abschneiden könnte.
Validierungs- und Vorhersagemodus im Vergleich#
| Modus | Zweck | Beschriftungen erforderlich | Ausgabe |
|---|---|---|---|
| Validierung | Leistung anhand der Ground Truth quantifizieren | Ja | Präzision, Recall, mAP50, mAP50-95, Konfusionsmatrix, PR-Kurven |
| Vorhersage | Modellverhalten anhand neuer, unbeschrifteter Daten überprüfen | Nein | Annotierte Bilder und Vorhersageergebnisse, keine Metriken |
Testergebnisse analysieren#
Wenn dir Vorhersagen und Metriken vorliegen, untersuche genauer, wo und warum das Modell versagt:
- Falsch klassifizierte Bilder: Ermittle und prüfe die Bilder, die das Modell falsch klassifiziert hat, um die Ursachen zu verstehen.
- Fehleranalyse: Führe eine gründliche Fehleranalyse durch, um die Fehlerarten (z. B. falsch positive gegenüber falsch negativen Ergebnissen) und ihre möglichen Ursachen zu verstehen.
- Verzerrungen und Fairness: Prüfe, ob die Vorhersagen des Modells Verzerrungen aufweisen. Stelle sicher, dass das Modell in verschiedenen Teilmengen der Daten gleich gut funktioniert, insbesondere wenn diese sensible Merkmale wie Herkunft, Geschlecht oder Alter umfassen.
Überanpassung und Unteranpassung beim maschinellen Lernen#
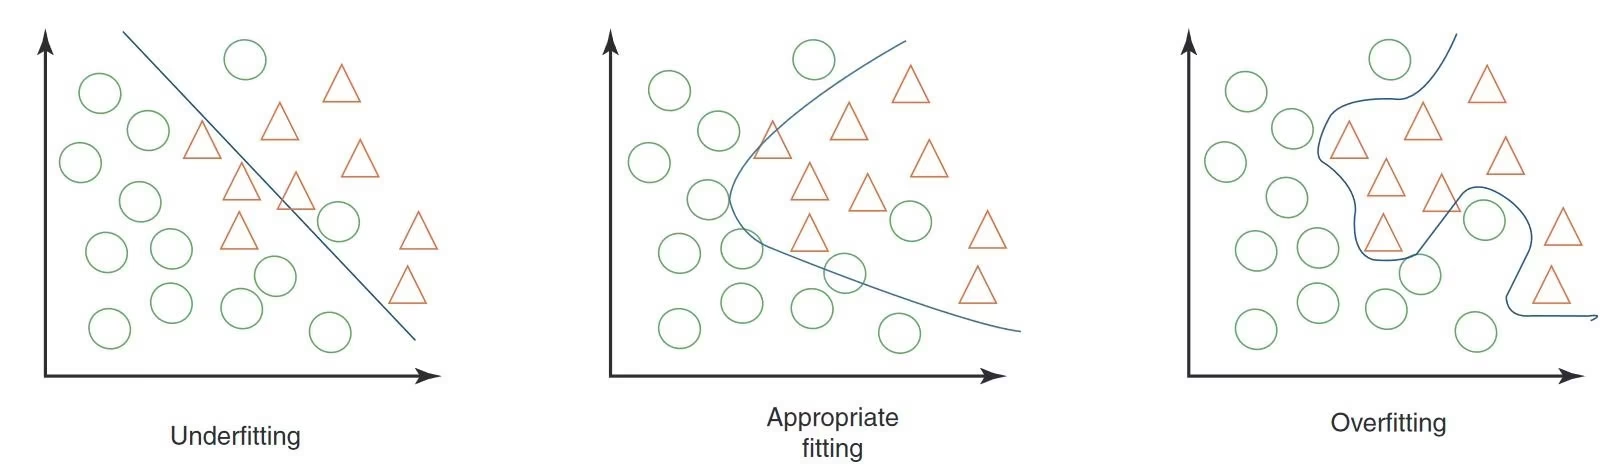
Beim Testen eines Modells für maschinelles Lernen, insbesondere im Bereich Computer Vision, solltest du auf Überanpassung und Unteranpassung achten. Diese Probleme können die Leistung deines Modells bei neuen Daten erheblich beeinträchtigen.
| Problem | Häufige Anzeichen | Mögliche Abhilfe |
|---|---|---|
| Überanpassung | Hohe Trainingsgenauigkeit, aber geringe Validierungsgenauigkeit; übermäßige Empfindlichkeit gegenüber kleinen Änderungen oder unwichtigen Details in Bildern | Wende Regularisierung wie Dropout an, vergrößere den Trainingsdatensatz oder vereinfache die Modellarchitektur. |
| Unteranpassung | Geringe Genauigkeit selbst beim Trainingssatz; das Modell erkennt offensichtliche Merkmale oder Objekte immer wieder nicht | Verwende ein komplexeres Modell, stelle mehr relevante Merkmale bereit oder erhöhe die Anzahl der Trainings-Epochen. |
Entscheidend ist, ein Gleichgewicht zu finden, damit das Modell sowohl auf Trainings- als auch auf Validierungsdatensätzen gut abschneidet. Wenn du Metriken regelmäßig überwachst und Vorhersagen während des Testens visuell prüfst, erkennst du, wenn das Modell in eine der beiden Richtungen abdriftet.
Datenlecks in der Computer Vision und wie du sie vermeidest#
Zu einem Datenleck kommt es, wenn versehentlich Informationen außerhalb des Trainingsdatensatzes zum Trainieren des Modells verwendet werden. Das Modell scheint während des Trainings möglicherweise sehr genau zu sein, schneidet bei neuen, ungesehenen Daten mit einem Datenleck jedoch schlecht ab.
Datenlecks sind oft schwer zu erkennen und entstehen häufig durch verborgene Verzerrungen in den Trainingsdaten:
| Art der Verzerrung | Typisches Erscheinungsbild |
|---|---|
| Kameraverzerrung | Unterschiedliche Blickwinkel, Beleuchtung, Schatten und Kamerabewegungen führen zu unerwünschten Mustern. |
| Einblendungsverzerrung | Logos, Zeitstempel oder andere Einblendungen in Bildern führen das Modell in die Irre. |
| Schriftart- und Objektverzerrung | Bestimmte Schriftarten oder Objekte, die häufig in bestimmten Klassen vorkommen, verzerren den Lernprozess des Modells. |
| Räumliche Verzerrung | Ungleichgewichte zwischen Vorder- und Hintergrund, bei der Verteilung von Bounding Boxes und bei Objektpositionen beeinflussen das Training. |
| Verzerrung durch Beschriftungen und Domänen | Falsche Labels oder Verschiebungen bei den Datentypen führen zu Datenleckagen |
So erkennst und vermeidest du Datenleckagen#
Um Datenleckagen zu erkennen, prüfe, ob die Ergebnisse des Modells überraschend gut sind, ob ein Merkmal deutlich wichtiger ist als andere, ob die Entscheidungen des Modells intuitiv nachvollziehbar sind und ob die Daten vor jeglicher Verarbeitung korrekt aufgeteilt wurden.
Um Datenleckagen zu verhindern, verwende einen vielfältigen Datensatz mit Bildern oder Videos von unterschiedlichen Kameras und aus verschiedenen Umgebungen und prüfe deine Daten sorgfältig auf verborgene Verzerrungen – etwa wenn alle positiven Beispiele zu einer bestimmten Tageszeit aufgenommen wurden. Wenn du Datenleckagen vermeidest, sind deine Computer-Vision-Modelle in realen Situationen zuverlässiger.
Was nach dem Testen des Modells kommt#
Nach dem Testen deines Modells hängen die nächsten Schritte von den Ergebnissen ab. Wenn dein Modell gute Ergebnisse erzielt, kannst du es in einer realen Umgebung einsetzen. Sind die Ergebnisse nicht zufriedenstellend, musst du Verbesserungen vornehmen. Dazu können die Fehleranalyse, das Sammeln weiterer Daten, die Verbesserung der Datenqualität, das Anpassen von Hyperparametern und das erneute Trainieren des Modells gehören.
Fazit#
Gründliche Tests – die Validierung anhand eines zurückgehaltenen Testdatensatzes, Vorhersagen auf realen Bildern sowie die Prüfung auf Overfitting und Datenleckagen – machen aus einem gut bewerteten Modell ein zuverlässiges Modell. Behebe die Probleme, die bei den Tests sichtbar werden, bevor du das Modell einsetzt. So ist es viel wahrscheinlicher, dass sich dein Modell in der Produktionsumgebung wie vorgesehen verhält. Wenn dabei Fragen aufkommen, wende dich an die Community im Ultralytics-GitHub-Repository oder auf dem Ultralytics-Discord-Server.
Häufig gestellte Fragen#
Bei der Modellbewertung wird die Leistung anhand von Kennzahlen auf einem beschrifteten Datensatz gemessen, während Modelltests prüfen, wie sich das Modell auf neuen, ungesehenen Daten verhält, die den Einsatzbedingungen ähneln. Bei der Bewertung werden anhand eines kontrollierten Datensatzes Werte wie Präzision und mAP ermittelt; Tests zeigen, ob das erlernte Verhalten auch bei wechselnden Lichtverhältnissen, Bewegungen oder Verdeckungen Bestand hat. Ein ausgearbeitetes Beispiel findest du unter Modelltests vs. Modellbewertung.
Verwende den Vorhersagemodus und übergib einen Ordnerpfad als
source– YOLO26 verarbeitet jedes Bild im Ordner und kann die annotierten Ergebnisse zur Überprüfung speichern. Im Vorhersagemodus werden keine Kennzahlen berechnet. Um die Leistung auf einem beschrifteten Datensatz zu quantifizieren, verwende stattdessen den Validierungsmodus. Beide Arbeitsabläufe werden unter So testest du ein YOLO26-Modell gezeigt.Bei Erkennungsmodellen gibt die Validierung Präzision, Trefferquote, mAP50 und mAP50-95 aus und speichert Diagramme, darunter eine Konfusionsmatrix und eine Präzisions-Trefferquote-Kurve. Um statt des standardmäßigen
val-Datensatzes einen eigenen Testsatz zu validieren, definieretest:in deiner Dataset-YAML-Datei und übergibsplit="test". Im Leitfaden zu Leistungskennzahlen erfährst du, wie du die einzelnen Kennzahlen interpretierst.Bei Overfitting kannst du Regularisierungstechniken wie Dropout anwenden, den Trainingsdatensatz vergrößern oder die Modellarchitektur vereinfachen. Bei Underfitting kannst du ein komplexeres Modell verwenden, relevantere Merkmale bereitstellen oder mit mehr Epochen trainieren. Die Anzeichen der beiden Probleme und die jeweiligen Lösungen sind unter Overfitting und Underfitting beim maschinellen Lernen zusammengefasst.
Vermute eine Datenleckage, wenn die Testergebnisse überraschend gut sind, ein einzelnes Merkmal die Vorhersagen dominiert oder die Entscheidungen des Modells intuitiv nicht nachvollziehbar sind. Vermeide Datenleckagen, indem du vielfältige Datensätze von unterschiedlichen Kameras und aus verschiedenen Umgebungen verwendest, die Daten auf verborgene Verzerrungen prüfst und sicherstellst, dass die Aufteilung in Trainings- und Testdaten vor jeglicher Verarbeitung erfolgt ist. Unter Datenleckagen in Computer Vision findest du die häufigsten Arten von Verzerrungen.
Entsprechen die Ergebnisse deinen Projektzielen, setze das Modell ein. Andernfalls verbessere es vor dem Einsatz. Dazu können die Fehleranalyse, das Sammeln vielfältigerer Daten, die Verbesserung der Datenqualität, das Optimieren von Hyperparametern und das erneute Trainieren gehören. Wiederhole die Tests nach jeder Änderung, um sicherzustellen, dass die Korrekturen funktioniert haben.